






Ajuste alternativo
Escolha o fluxo de trabalho antes do alvo mais difícil
ZenRows frequentemente aparece em uma lista curta quando uma equipe espera páginas públicas protegidas, sites pesados em JavaScript ou alvos sensíveis a proxies. Esse é um ponto de avaliação justo, mas não é toda a decisão de compra. Uma API de scraping também precisa ajudar a equipe a decidir qual perfil de solicitação é realmente necessário, qual formato de resposta o produto pode usar e quanto peso extra de entrega é justificado pelo alvo.
ScraperFly é construído para esse caminho prático. Comece com a menor solicitação útil, inspecione a fonte e as evidências renderizadas, e adicione renderização de navegador, esperas, cabeçalhos, sessões, direcionamento por país ou roteamento mais forte apenas quando eles melhorarem o resultado. O objetivo não é tornar cada raspagem pesada. O objetivo é obter dados confiáveis de páginas públicas com menos partes móveis e decisões de custo mais limpas.
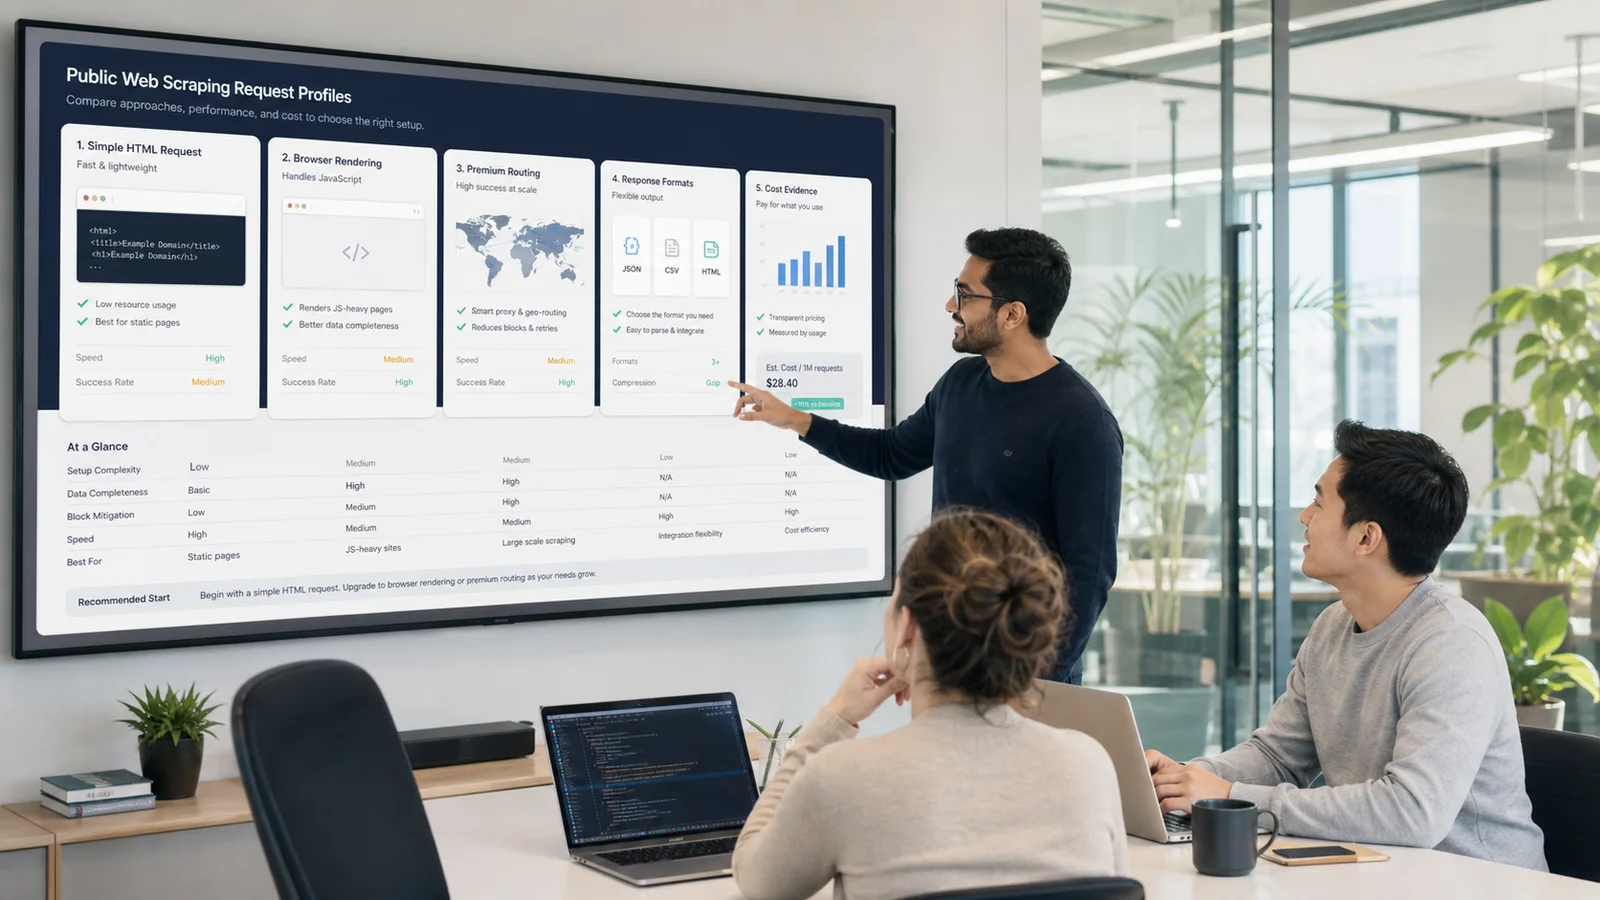
O que uma alternativa ao ZenRows deve provar primeiro?
Uma forte alternativa ao ZenRows deve provar que o alvo pode ser capturado com a solicitação mais leve que ainda retorna dados úteis. Isso parece simples, mas muda a forma como uma equipe avalia ferramentas. Em vez de começar com o modo de entrega mais difícil possível, a equipe começa perguntando o que a página realmente retorna, se o JavaScript altera o conteúdo útil e se o sistema downstream precisa de HTML, texto, Markdown, metadados JSON, uma captura de tela ou um PDF.
Isso é importante porque muitas páginas públicas não precisam de uma sessão de navegador completa. Algumas retornam marcação útil na primeira resposta. Outras precisam de renderização, mas apenas após uma breve espera ou apenas para modelos específicos. Algumas falhas apontam para cabeçalhos, cookies, contexto de país ou roteamento, em vez de uma configuração universal anti-bot. ScraperFly mantém essas escolhas visíveis para que a primeira solicitação funcional possa se tornar a solicitação de produção em vez de um experimento descartável.
Onde a avaliação geralmente se torna cara?
A parte cara do scraping raramente é a primeira busca bem-sucedida. O custo cresce quando cada página é tratada como difícil, cada resultado precisa de limpeza, cada falha é tentada novamente cegamente e cada conversão de formato se torna uma tarefa interna separada. Uma equipe pode resolver o problema de entrega e ainda perder tempo construindo filas de navegador, colas de parser, captura de tela, geração de PDF, regras de re-tentativa, registro e estimativas de cobrança em torno da API.
A vantagem do ScraperFly é o caminho de compra em torno dessas decisões. Créditos gratuitos suportam validação real do alvo. Créditos pay-as-you-go se ajustam a projetos irregulares. Créditos mensais fazem sentido uma vez que o volume recorrente é comprovado. Isso dá aos desenvolvedores e equipes de operações espaço para testar o comportamento da página antes de se comprometerem com um perfil de solicitação ou formato de plano que foi escolhido muito cedo.
| Área de decisão | Risco comum de avaliação | Caminho do ScraperFly |
|---|---|---|
| Primeira solicitação | Começar com um perfil pesado de navegador ou proxy antes de inspecionar a resposta da fonte. | Comece com uma solicitação leve de página pública, depois adicione controles apenas quando a resposta provar que eles importam. |
| Páginas JavaScript | Assumir que cada alvo precisa de renderização de navegador porque alguns alvos precisam. | Compare a saída bruta e renderizada, depois use renderização para modelos onde a execução do lado do cliente altera o resultado. |
| Formato de resposta | Capturar HTML com sucesso, mas ainda construir conversores antes que os dados possam se mover para baixo. | Escolha HTML, texto, Markdown, metadados JSON, capturas de tela ou PDFs com base no consumidor da resposta. |
| Falhas | Tentar novamente blocos, páginas vazias, timeouts e redirecionamentos sem entender o que mudou. | Use status, URL final, tipo de conteúdo, tamanho da resposta, estado renderizado e evidência de roteamento para decidir o próximo passo. |
| Modelo de compra | Comprometer-se com volume recorrente enquanto a dificuldade e a cadência do alvo ainda são incertas. | Comece grátis, compre créditos para trabalho irregular e passe para créditos mensais quando a carga de trabalho se tornar previsível. |
Como o ScraperFly mantém o fluxo de trabalho prático?
ScraperFly dá às equipes um lugar para definir a solicitação de captura em vez de forçar a entrega, saída e planejamento de custos em decisões separadas. A API pode buscar HTML fonte para páginas simples, renderizar JavaScript quando a página precisa de um navegador, manter o contexto da solicitação através de cabeçalhos ou sessões, usar direcionamento por país onde a geografia altera a resposta e retornar arquivos visuais quando QA ou conformidade precisam de prova de aparência.
A diferença importante é a contenção. Controles avançados são úteis quando resolvem um problema demonstrado. Eles são desperdício quando se tornam padrões. O fluxo de trabalho do ScraperFly incentiva as equipes a inspecionar o alvo primeiro, depois escolher o conjunto de controles que torna a resposta completa o suficiente para o próximo sistema.
Isso torna o ScraperFly especialmente útil para equipes de produto, equipes de dados e fluxos de trabalho de agentes que precisam de mais do que uma busca bruta, mas menos do que uma plataforma de scraping personalizada. Um backend pode chamar uma API, escolher um formato de resposta e mover o resultado para parsers, trabalhos de análise, sistemas de monitoramento, pipelines RAG, revisão de QA ou arquivos.
Quando a comparação com ZenRows ainda é errada?
Nem toda equipe que compara ZenRows está tomando a mesma decisão. Se o único requisito é uma camada de entrega anti-bot estreita para um tipo de alvo conhecido, a comparação pode girar em torno do comportamento de roteamento e taxa de sucesso nesse alvo. Se o requisito real é um fluxo de trabalho de captura de página pública repetível, a decisão é mais ampla: formatos de resposta, evidência de navegador, capturas de tela, PDFs, logs de solicitação, ergonomia do desenvolvedor e flexibilidade de cobrança são todos importantes.
É aí que o ScraperFly deve ser avaliado diretamente. Use o API Builder para testar um alvo real. Compare HTML fonte com saída renderizada através da API de renderização JavaScript. Escolha o menor formato de resposta que funcione na página de formatos de resposta. Então verifique preços com os controles de solicitação reais que seu fluxo de trabalho precisa.
| Pergunta | Por que isso importa | Melhor próxima ação |
|---|---|---|
| O HTML fonte já contém os dados úteis? | Capturas simples são mais fáceis de depurar e geralmente mais leves do que o trabalho de navegador. | Comece com HTML, depois renderize apenas se a página provar que está incompleta. |
| O produto precisa de conteúdo legível ou estrutura DOM? | HTML, texto, Markdown, metadados, capturas de tela e PDFs atendem a diferentes consumidores. | Escolha o formato de saída antes de construir código de parser ou conversor. |
| O alvo está falhando por causa da entrega ou do comportamento da página? | Um timeout, redirecionamento, página bloqueada, shell vazio ou resposta excessiva exigem diferentes trabalhos de recuperação. | Inspecione a evidência da resposta antes de escalar o roteamento ou tentar novamente a mesma solicitação. |
| O volume é previsível ainda? | Projetos iniciais frequentemente têm alvos irregulares, cadência desconhecida e perfis de solicitação em mudança. | Use créditos gratuitos e testes pay-as-you-go antes de mover o trabalho recorrente para créditos mensais. |
Por que escolher o ScraperFly como alternativa?
Escolha o ScraperFly quando a equipe quiser uma API de scraping que seja fácil de testar, cuidadosa com o peso da solicitação e útil após a captura da página. O ajuste mais forte não é uma promessa vaga de que cada alvo se torna fácil. É um modelo operacional mais limpo: prove o alvo, selecione os controles certos, receba a resposta no formato certo e escale apenas depois que o fluxo de trabalho for compreendido.
Isso dá aos compradores um caminho de menor risco do que se comprometer muito cedo com um perfil pesado ou um plano projetado em torno de suposições. Comece com a página real. Compare as evidências. Então decida se o ScraperFly deve capturar HTML bruto, HTML renderizado, texto limpo, Markdown, metadados JSON, capturas de tela ou PDFs para produção.















