






Fluxo de resposta JSON
Retorne o contexto da página como JSON sem fingir que todos os alvos têm o mesmo esquema
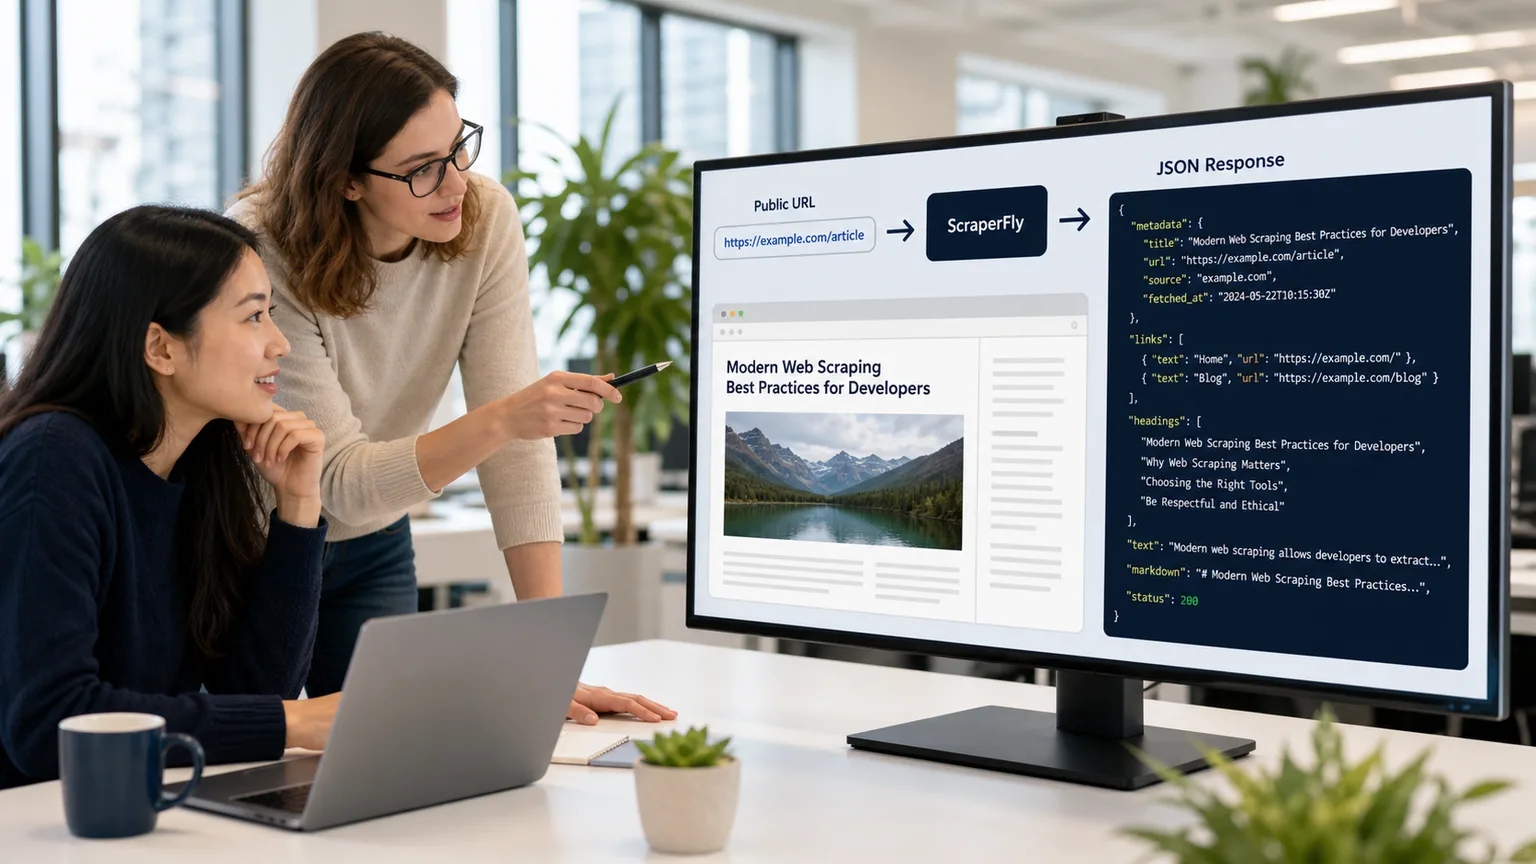
Um fluxo de trabalho de site para JSON é útil quando sua aplicação precisa de um envelope de resposta previsível em torno dos dados da página pública. ScraperFly ajuda os desenvolvedores a capturar a página, preservar evidências de solicitação e retornar contextos suportados, como metadados, links, cabeçalhos, texto, Markdown, status, URL final e detalhes da resposta.
A fronteira importante é a honestidade. ScraperFly pode preparar a resposta da página pública e facilitar a inspeção programática, mas seu produto ainda deve possuir a extração específica do alvo para campos personalizados, como preços, disponibilidade, classificações, nomes de autores ou entidades comerciais internas.
O que significa raspar um site para JSON?
Raspar um site para JSON significa buscar uma URL pública e retornar um contexto útil da página em uma resposta estruturada que sua aplicação pode ler. Em vez de entregar a cada sistema downstream um blob bruto de HTML, a resposta da API pode carregar metadados, links, cabeçalhos, texto legível, Markdown, status da solicitação, URL final, tipo de conteúdo e outras evidências de resposta em campos que são mais fáceis de registrar, inspecionar, comparar e direcionar.
Isso não torna cada site uma tabela de banco de dados limpa. Páginas públicas não compartilham um único esquema. Uma página de produto, artigo, listagem de diretório, página de resultados de pesquisa e página de documentação expõem todas estruturas diferentes. ScraperFly dá à sua equipe uma camada de captura estável e formas de resposta suportadas; seu parser ainda decide quais campos específicos do alvo são importantes para seu caso de uso.
Conclusão prática: use a saída de site para JSON para contexto da página e evidências de solicitação, depois adicione lógica de extração personalizada onde o esquema de negócios é específico para o alvo.
Quando o JSON é a forma de resposta certa?
JSON é a forma certa quando o consumidor é um serviço de backend, trabalhador de fila, trabalho de monitoramento, agente, pipeline de dados ou ferramenta interna que espera chaves previsíveis. Ajuda quando seu fluxo de trabalho precisa armazenar a URL final, status, metadados da página, links descobertos, cabeçalhos, texto, Markdown e diagnósticos ao lado do conteúdo capturado. Isso torna a depuração e o roteamento downstream mais simples porque a aplicação não precisa inferir cada detalhe de uma única string HTML.
HTML ainda é a melhor entrada primária quando seletores, atributos, estrutura de tabela, relacionamentos DOM ou estado incorporado são importantes. Texto e Markdown são frequentemente melhores quando o objetivo é busca, sumarização, classificação, revisão ou ingestão de IA. JSON é mais forte quando envolve essas saídas úteis com contexto rastreável.
| Forma de resposta | Use-a quando | O que evitar |
|---|---|---|
| Contexto JSON | Seu backend precisa de metadados, links, cabeçalhos, texto, Markdown e evidências de solicitação em campos previsíveis | Não trate JSON em nível de página como extração personalizada automática. |
| HTML bruto | Seu parser precisa de seletores, atributos, tabelas, links ou estrutura de fonte incorporada | Não converta para texto muito cedo se relacionamentos DOM forem importantes. |
| HTML renderizado | O conteúdo público útil aparece apenas após a execução do JavaScript | Não renderize cada página antes de provar que a resposta da fonte está incompleta. |
| Texto | Você precisa de conteúdo legível compacto para busca, indexação ou comparação simples | Não use texto simples quando relacionamentos estruturados da página forem necessários. |
| Markdown | Você quer cabeçalhos, listas e links legíveis para fluxos de trabalho de IA ou revisão | Não espere que o Markdown preserve cada seletor ou detalhe de layout. |
| Captura de tela ou PDF | Você precisa de prova visual, revisão de QA, saída de arquivo ou um registro legível por humanos | Não use arquivos visuais como a entrada principal do parser quando dados legíveis por máquina são suficientes. |
Quais campos JSON são úteis em fluxos de trabalho de produção?
JSON útil começa com rastreabilidade. Sua aplicação deve saber qual URL foi solicitada, onde a solicitação finalmente aterrissou, qual status foi retornado, qual tipo de conteúdo foi retornado e quão grande foi a resposta. Essa evidência ajuda a separar uma mudança real de alvo de um redirecionamento, resposta fina, página bloqueada, tempo limite ou formato não suportado.
O contexto da página vem a seguir. Metadados, títulos, descrições, cabeçalhos, dicas canônicas, links, texto limpo e Markdown podem ajudar um pipeline a decidir o que analisar, indexar, resumir, arquivar ou enviar para outro serviço. Para fluxos de trabalho de IA e RAG, metadados JSON mais Markdown podem ser mais fortes do que texto simples porque a resposta carrega conteúdo legível e contexto operacional juntos.
Campos específicos do alvo vêm depois disso. Se seu produto precisa de preço, SKU, autor, classificação, cargo, localização, data do evento ou disponibilidade, construa essa camada de extração em torno das páginas de destino que você realmente suporta. ScraperFly ajuda a buscar e preparar a resposta; seu aplicativo define o esquema de negócios.
Como as equipes devem testar a saída de site para JSON?
Comece com uma URL pública de destino no API Builder. Capture a resposta da fonte primeiro, inspecione o contexto retornado e confirme quais campos estão realmente presentes. Em seguida, compare formatos alternativos: HTML para trabalho de parser, texto ou Markdown para conteúdo legível, metadados JSON para diagnósticos e saída visual quando um revisor precisa de prova.
Se a página for pesada em JavaScript, compare a saída da fonte com o JavaScript rendering API ou o fluxo de trabalho da rendered HTML API. Renderizar vale a pena quando adiciona conteúdo que seu produto precisa. Se a renderização não melhorar a resposta, inspecione o tempo, redirecionamentos, contexto da solicitação ou comportamento do alvo antes de tentar novamente.
| Passo do teste | Pergunta a responder | Decisão que apoia |
|---|---|---|
| Buscar a URL pública | A resposta é bem-sucedida e aterrissa na URL final esperada? | Confirme que o alvo é acessível antes que o trabalho do parser comece. |
| Inspecionar HTML da fonte | A resposta inicial contém os campos ou conteúdo que você precisa? | Mantenha a solicitação leve quando a captura da fonte for suficiente. |
| Comparar formatos de saída | HTML, texto, Markdown ou contexto JSON é a melhor forma downstream? | Evite construir conversores em torno do formato errado. |
| Renderizar apenas se necessário | A execução do navegador adiciona conteúdo público significativo? | Use a renderização para lacunas reais de conteúdo, não como um imposto padrão. |
| Definir extração personalizada | Quais campos de negócios específicos do alvo seu aplicativo precisa? | Mantenha ScraperFly como a camada de captura e seu parser como a camada de esquema. |
Como o site para JSON difere de uma API de parser?
Uma API de parser geralmente implica que o serviço entende o esquema específico do alvo e retorna entidades personalizadas. Uma resposta de site para JSON é diferente. Ela fornece ao seu aplicativo contexto estruturado da página e evidências de captura para que seu próprio parser possa tomar melhores decisões. Essa distinção mantém o fluxo de trabalho confiável porque sites públicos variam demais para fingir que cada alvo pode ser reduzido ao mesmo objeto JSON.
Se sua equipe precisa de conteúdo legível e limpo, compare a parse website content API, HTML to text parser API e HTML to Markdown parser API. Se você precisa de parsing em nível DOM, comece a partir da HTML scraping API ou HTML parser API for web scraping workflows.
Como o ScraperFly mantém os fluxos de trabalho JSON práticos?
ScraperFly mantém o fluxo de trabalho prático permitindo que o mesmo caminho da API comece simples e adicione controles quando o alvo provar que são necessários. Uma página pública que retorna HTML de fonte útil pode permanecer leve. Uma página renderizada pelo cliente pode usar execução de navegador. Uma rota com necessidades de contexto público pode adicionar cabeçalhos, cookies, direcionamento de país ou sessões. Um fluxo de trabalho de revisão pode adicionar capturas de tela ou PDFs. Cada escolha deve melhorar a resposta, não apenas tornar a solicitação mais pesada.
Isso importa para custo e manutenibilidade. As equipes costumam sobrecarregar pipelines de site para JSON executando cada alvo em um navegador, convertendo tudo para o mesmo formato e depois descobrindo que o parser downstream ainda precisa de regras específicas do alvo. ScraperFly oferece os controles de captura, formatos de resposta e evidências para escolher um caminho menor primeiro. A página de preços e o calculador de custo de crédito da API de web scraping podem ajudar a estimar o impacto antes que o volume cresça.
Conclusão prática: o melhor fluxo de trabalho de site para JSON oferece aos desenvolvedores um envelope de resposta claro, mantém o peso da solicitação alinhado com o alvo e deixa a extração de negócios personalizada onde pertence: na lógica da aplicação.










