






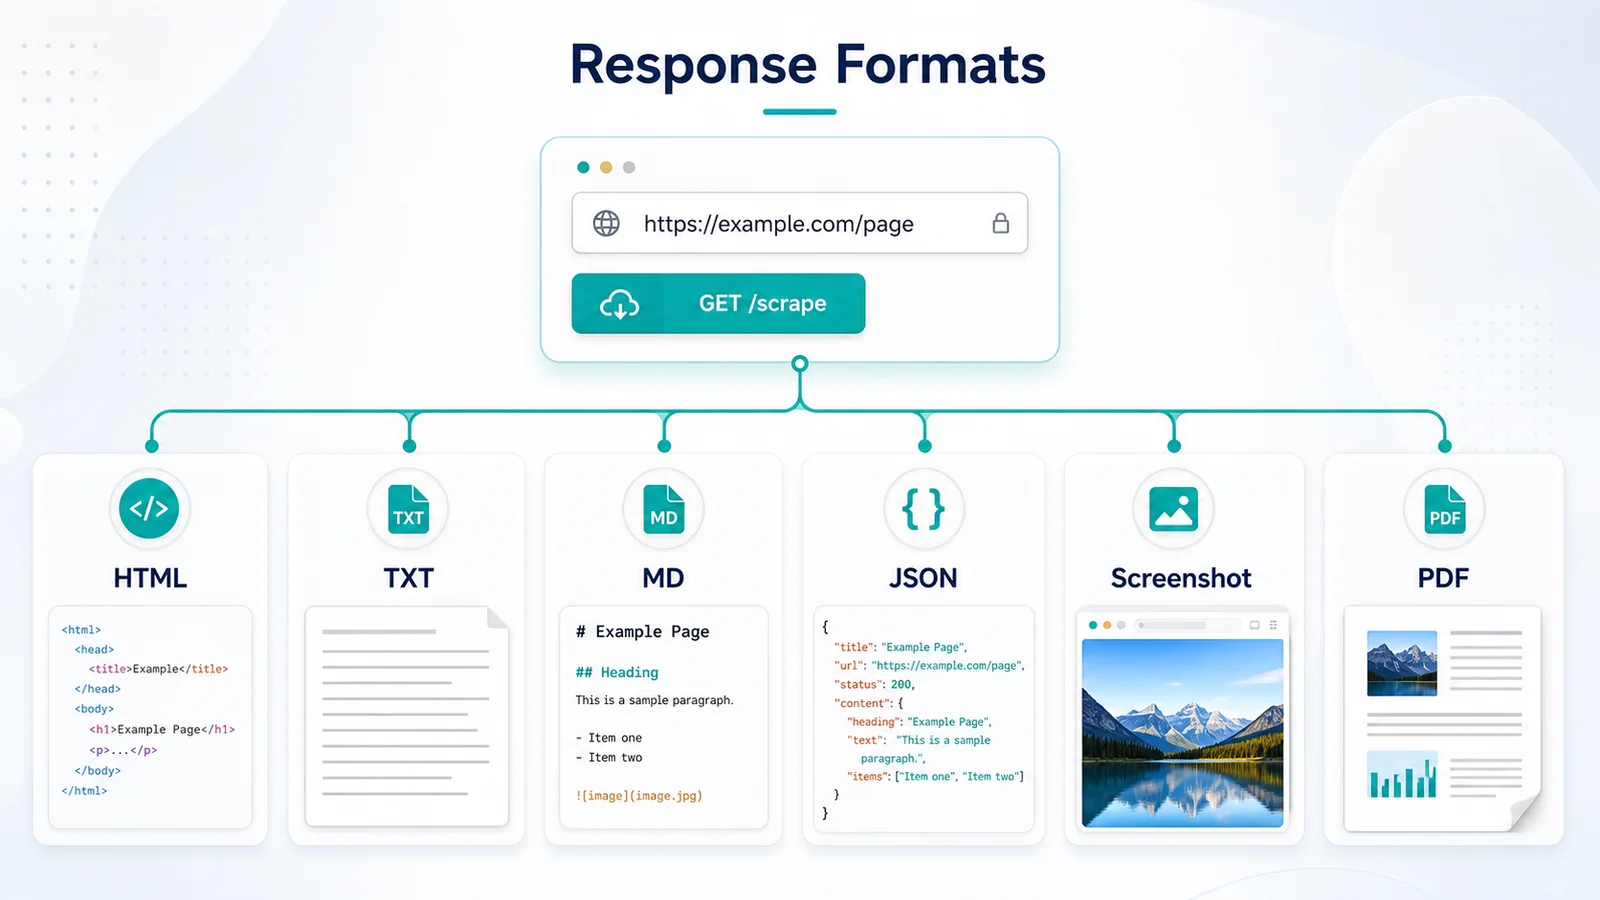
Os formatos de resposta da API de web scraping são as formas de saída retornadas após uma página pública ser capturada, incluindo HTML, texto, Markdown, metadados JSON, capturas de tela e PDFs. O formato certo depende da tarefa subsequente: análise de marcação, alimentação de um pipeline de IA, revisão de conteúdo, monitoramento de mudanças, arquivamento de evidências ou preservação de um registro visual.
Escolher a forma de resposta cedo evita limpeza desnecessária. Também ajuda as equipes a evitar construir conversores, ferramentas de captura de navegador e lógica de processamento antes de saber o que o produto realmente precisa.
ScraperFly permite que os desenvolvedores testem vários formatos de saída contra a mesma URL pública de destino. Isso torna a seleção de formato uma decisão de engenharia baseada em respostas reais, em vez de suposições.
Quais são os formatos de resposta da API de web scraping?
Um formato de resposta da API de web scraping define como uma página pública capturada é retornada para a aplicação cliente.
O alvo subjacente pode ser o mesmo, mas a resposta pode servir a fluxos de trabalho muito diferentes. O HTML preserva a estrutura da página. O texto remove a maior parte da marcação. O Markdown mantém uma estrutura legível para fluxos de trabalho de conteúdo. Os metadados JSON descrevem o contexto da solicitação e da página. Capturas de tela e PDFs preservam evidências visuais.
O formato é separado do método de captura. Uma página pode ser buscada através de uma solicitação HTTP normal ou renderizada em um navegador antes que a saída selecionada seja criada.
| Formato | Melhor para | Não ideal para | Exemplo de saída | Usuário subsequente |
|---|---|---|---|---|
| HTML bruto | Análise DOM, seletores, links, atributos | Ingestão de conteúdo limpo sem pré-processamento | Corpo da resposta HTML | Desenvolvedor backend |
| HTML renderizado | Conteúdo DOM gerado por JavaScript | Páginas estáticas que já contêm os dados necessários | HTML gerado pelo navegador | Engenheiro de scraping |
| Texto simples | Indexação de busca, análise leve, revisão simples | Fluxos de trabalho que precisam de cabeçalhos, links ou layout | Texto legível limpo | Equipe de dados ou busca |
| Markdown | Ingestão de IA/RAG, revisão editorial, documentação | Extração precisa de DOM | Cabeçalhos, parágrafos, listas, links | Equipe de produto de IA |
| Metadados JSON | Status, URL final, tipo de conteúdo, contexto da solicitação | Extração de campo arbitrário do alvo | Contexto de resposta estruturado | Engenheiro de plataforma |
| Captura de tela | QA visual, monitoramento, evidência de layout | Dados estruturados pesquisáveis | Artefato de imagem | Equipe de QA ou monitoramento |
| Arquivamento, aprovação, registros portáteis | Análise de conteúdo detalhada | Documento para download | Equipe de conformidade ou operações |
Resumo prático: trate o formato de saída como parte da arquitetura da aplicação, não como uma opção cosmética da API.
Por que o formato de resposta importa após uma página ser capturada?
A solicitação é apenas o começo de um fluxo de trabalho de scraping. A resposta ainda deve ser movida para um parser, índice de busca, pipeline de IA, sistema de monitoramento, arquivo ou interface de produto.
Uma escolha de formato ruim desloca o trabalho para baixo.
Por exemplo, enviar HTML bruto para um pipeline de ingestão de IA pode exigir remoção de boilerplate, filtragem de navegação, limpeza de links e normalização de conteúdo. Retornar texto simples para um parser pode remover as relações DOM necessárias para identificar preços, cabeçalhos, tabelas ou atributos de produtos.
O mesmo problema aparece em fluxos de trabalho visuais. Uma equipe que precisa de prova de como uma página apareceu pode capturar HTML primeiro, e depois manter trabalhadores separados do Playwright ou Puppeteer para gerar capturas de tela. Uma saída visual adequada pode remover essa camada extra.
A escolha do formato afeta:
- quanto a aplicação realiza limpeza;
- se a estrutura da página é preservada;
- quão facilmente os desenvolvedores podem depurar o resultado;
- se a resposta é adequada para processamento automatizado;
- quanto armazenamento e largura de banda o pipeline usa;
- se um conversor separado ou trabalhador de navegador é necessário.
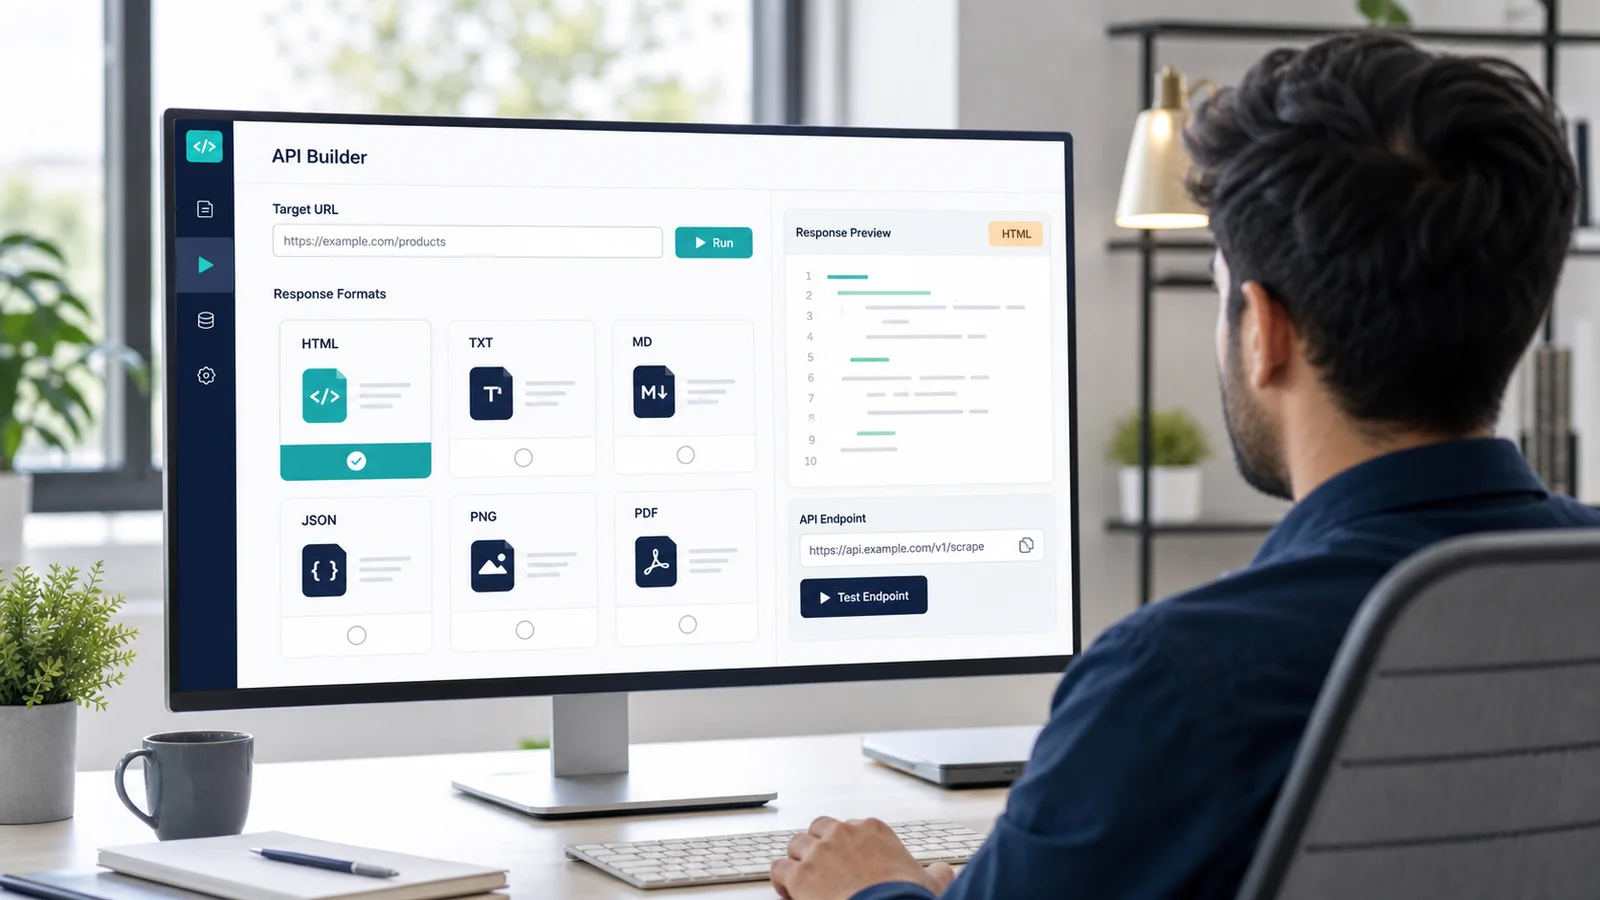
Antes de escrever código de transformação, teste o alvo através do API Builder. Compare o corpo da resposta, a estrutura do conteúdo, o tamanho e a usabilidade entre os formatos.
Resumo prático: escolha o formato antes de construir conversores, pois a limpeza subsequente pode custar mais tempo de engenharia do que a solicitação original.
Quando um fluxo de trabalho de scraping deve usar saída HTML?
HTML é o formato certo quando a aplicação precisa da estrutura original da página.
Um parser pode inspecionar tags, classes, atributos, cabeçalhos, links, tabelas, metadados incorporados e relações DOM. Isso torna o HTML adequado para lógica de extração personalizada onde a aplicação já sabe quais elementos importam.
Fluxos de trabalho HTML comuns incluem:
- extração de campos de produtos com seletores;
- descoberta de links para um crawler;
- análise de tabelas estruturadas;
- leitura de tags canônicas ou metadados;
- identificação de seções da página pela hierarquia DOM;
- armazenamento de marcação fonte para processamento posterior.
HTML bruto é a resposta inicial do servidor. Geralmente é o lugar mais leve para começar.
HTML renderizado é o DOM produzido após um navegador executar o JavaScript da página. Isso importa quando o conteúdo necessário não existe na resposta original.
| Pergunta | HTML bruto | HTML renderizado |
|---|---|---|
| De onde vem? | Resposta HTTP inicial | DOM gerado pelo navegador |
| O JavaScript é executado? | Não | Sim |
| Melhor para | Páginas estáticas e renderizadas pelo servidor | Aplicações renderizadas pelo cliente |
| Latência típica | Menor | Maior |
| Peso relativo da solicitação | Mais leve | Mais pesado |
| Principal risco | Conteúdo gerado pelo navegador ausente | Usar um navegador quando não é necessário |
| Método de validação | Pesquisar a resposta por conteúdo necessário | Comparar o DOM renderizado com HTML bruto |
HTML não é automaticamente melhor porque contém mais informações. Pode incluir navegação, scripts, estilos, código de rastreamento e elementos de página não relacionados. Esse ruído é aceitável quando um parser precisa de controle estrutural, mas ineficiente quando o objetivo é conteúdo legível.
Resumo prático: use HTML quando a estrutura DOM for uma entrada para sua lógica, e escolha HTML renderizado apenas quando o JavaScript criar o conteúdo que você precisa.
Quando texto e Markdown são melhores que HTML?
Texto e Markdown são úteis quando o fluxo de trabalho subsequente precisa de conteúdo legível da página em vez de controle total do DOM.
Texto simples remove a maior parte da marcação visual e estrutural. Funciona bem para análise de palavras-chave, indexação de busca, comparação de conteúdo, classificação simples e fluxos de trabalho onde cabeçalhos ou links não são essenciais.
Markdown preserva mais significado. Cabeçalhos, parágrafos, listas e links permanecem mais fáceis de interpretar do que seriam em texto plano. Isso muitas vezes torna o Markdown útil para:
- Preparação de documentos RAG;
- Ingestão de LLM;
- revisão editorial;
- importações de base de conhecimento;
- contexto de prompt;
- análise de documentação;
- migração de conteúdo.
Markdown não é um substituto para análise precisa de HTML. Se a aplicação deve identificar um preço de produto por um seletor específico, distinguir links de navegação de links de corpo, ou inspecionar atributos, HTML continua sendo a escolha mais segura.
A qualidade do Markdown também depende da página fonte. Páginas editoriais limpas geralmente convertem de forma mais previsível do que layouts altamente interativos, painéis, tabelas complexas ou páginas com conteúdo fragmentado.
| Fluxo de trabalho | Formato recomendado | Formato opcional | Por quê |
|---|---|---|---|
| Parser personalizado | HTML | Metadados JSON | Preserva seletores e relações DOM |
| Ingestão de IA/RAG | Markdown | Texto ou HTML | Preserva hierarquia legível e links |
| Indexação de busca | Texto | Markdown | Reduz a marcação e o ruído de processamento |
| Monitoramento de conteúdo | Texto ou HTML | Captura de tela | Suporta comparação de máquina e revisão visual |
| Revisão de QA | Captura de tela | HTML | Mostra a aparência renderizada com evidência de origem |
| Arquivo | HTML ou captura de tela | Cria um registro portátil | |
| Relatório | Texto ou Markdown | Captura de tela | Suporta resumos com contexto visual |
Um bom fluxo de trabalho de IA pode usar mais de um formato. O Markdown pode fornecer conteúdo legível, enquanto os metadados JSON registram a URL final, tipo de conteúdo, status e contexto de captura.
Resumo prático: use texto para conteúdo legível compacto, Markdown para estrutura de documento preservada, e HTML quando a extração depender do DOM.
O que as equipes devem esperar da saída de metadados JSON?
Os metadados JSON fornecem contexto estruturado sobre a captura e a resposta. Não transformam automaticamente cada página de destino em um esquema de negócios personalizado.
Metadados úteis podem incluir informações como:
- status da solicitação;
- URL de destino;
- URL final após redirecionamentos;
- tipo de conteúdo;
- tamanho da resposta;
- tempo ou contexto da solicitação;
- formato de resposta selecionado;
- detalhes de captura ou roteamento suportados pela API.
Essa estrutura é valiosa para registro, monitoramento, depuração e coordenação de processamento subsequente. Um pipeline pode usar metadados para decidir se o corpo deve ser analisado, armazenado, refeito ou rejeitado.
No entanto, os metadados JSON não devem ser confundidos com extração de esquema arbitrário.
Por exemplo, uma resposta JSON não significa necessariamente que a API identificará automaticamente cada nome de produto, preço, classificação, autor, empresa ou campo de artigo em qualquer site. A extração específica do alvo ainda requer lógica de parser, recursos de extração suportados ou uma camada de transformação separada.
Um padrão prático é combinar metadados com outra resposta:
- HTML mais metadados para fluxos de trabalho de parser;
- Markdown mais metadados para ingestão de IA;
- captura de tela mais metadados para evidência de QA;
- PDF mais metadados para registros de arquivamento.
Resumo prático: use metadados JSON para entender a solicitação e o contexto da página, não como uma suposição de que cada página se tornará um conjunto de dados estruturado personalizado.
Quando as capturas de tela e PDFs são a saída certa da API de scraping?
Capturas de tela e PDFs são apropriados quando a aparência visual é parte da evidência.
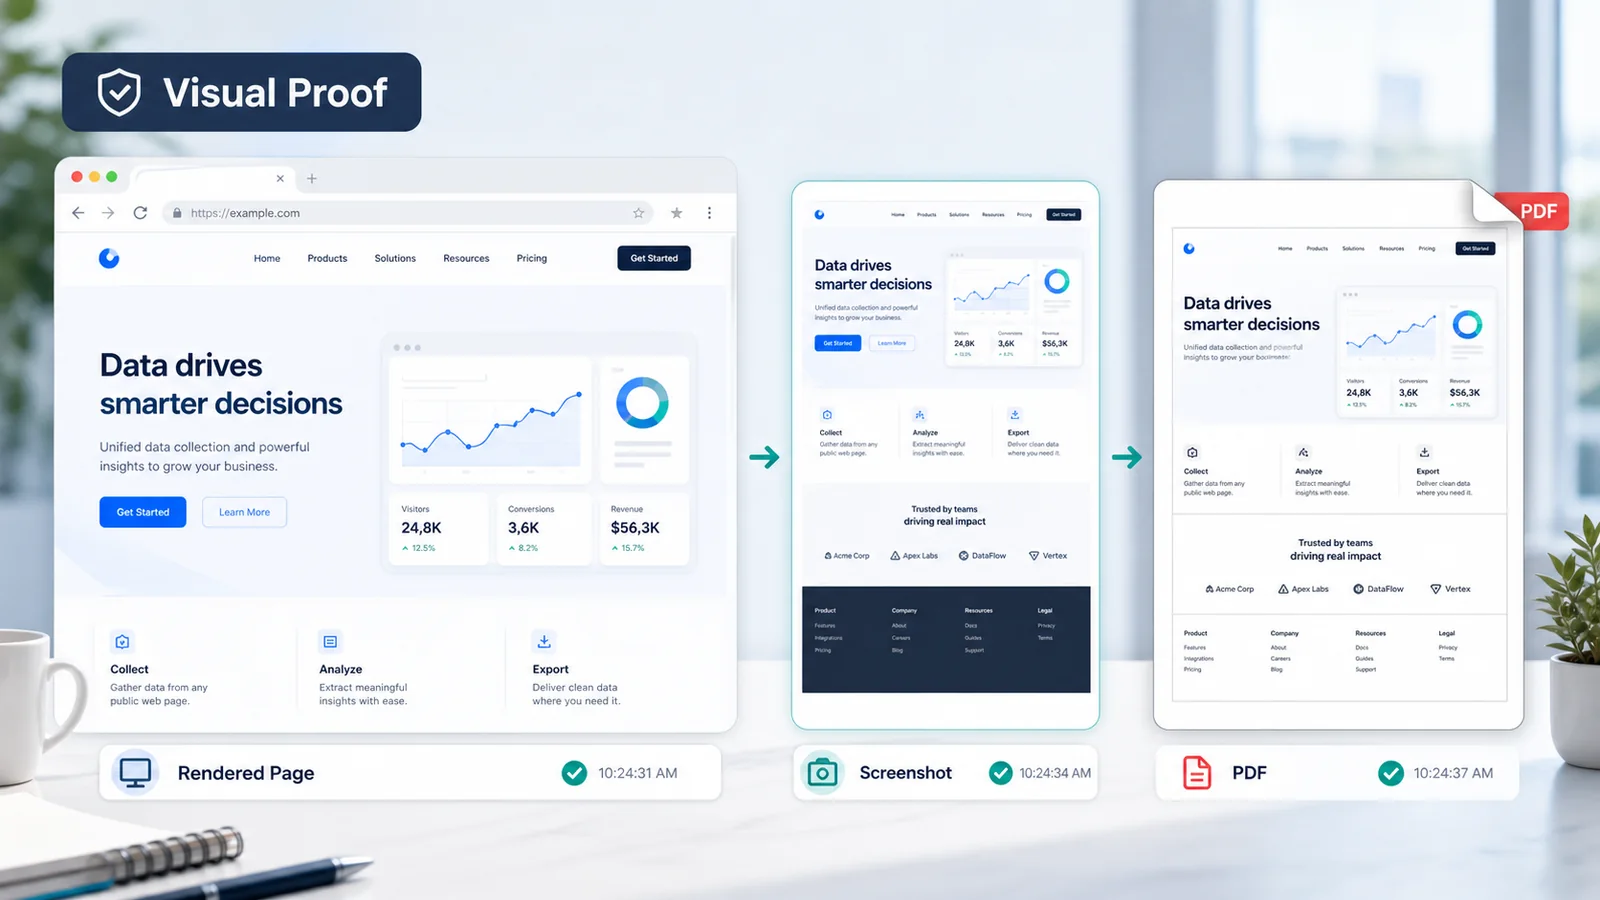
HTML e texto podem mostrar qual conteúdo foi retornado, mas podem não provar como o navegador exibiu a página. Uma captura de tela pode capturar layout, erros visíveis, telas de consentimento, componentes ausentes, mudanças responsivas ou apresentação específica de região.
Capturas de tela são úteis para:
- monitoramento de regressão visual;
- QA de página renderizada;
- verificação de layout;
- revisão de campanha e página de destino;
- reprodução de problemas;
- fluxos de trabalho de aprovação humana.
PDFs são melhores quando o resultado deve ser armazenado, compartilhado, impresso, revisado ou mantido como um artefato semelhante a um documento. Eles podem suportar arquivamento, revisão de conformidade, aprovação e manutenção de registros operacionais.
| Formato de evidência | Melhor uso | Principal vantagem | Principal limitação |
|---|---|---|---|
| Captura de tela | QA visual e evidência de estado da página | Mostra o que apareceu na viewport | Não é conveniente para busca estruturada |
| Arquivamento, revisão e registros portáteis | Preserva um artefato semelhante a um documento | Maior e mais difícil de analisar | |
| HTML | Evidência de origem e DOM | Estrutura legível por máquina | Pode não corresponder à aparência visual final |
| Texto ou Markdown | Evidência de conteúdo | Fácil de pesquisar e analisar | Perde layout visual |
A saída visual deve complementar dados legíveis por máquina, não substituí-los. Um fluxo de monitoramento pode comparar HTML ou texto automaticamente e gerar uma captura de tela apenas quando uma mudança significativa for detectada.
Capturas de tela e PDFs também são mais pesados do que texto simples ou HTML bruto. Revise as opções de crédito atuais em Preços antes de gerar artefatos visuais para cada solicitação.
Resumo prático: escolha capturas de tela para estado visual e PDFs para registros portáteis, mantendo HTML ou texto quando o sistema também precisar de evidência legível por máquina.
Como a renderização JavaScript muda a qualidade do formato de resposta?
A renderização JavaScript melhora a qualidade da saída apenas quando o alvo depende da execução do navegador.
Uma resposta HTTP bruta pode conter um artigo completo, página de produto ou página de documentação. Nesse caso, a renderização adiciona latência e peso à solicitação sem melhorar o formato selecionado.
Outras páginas retornam um shell de aplicação e carregam conteúdo após o navegador iniciar. Uma resposta de Markdown ou captura de tela criada antes que esse conteúdo apareça pode estar incompleta. A renderização permite que o navegador construa o DOM antes que o ScraperFly produza a saída solicitada.
Sinais comuns de que a renderização pode ser necessária incluem:
- o HTML bruto não contém texto visível da página;
- listas ou tabelas aparecem apenas após o carregamento da página;
- frameworks do lado do cliente inserem o conteúdo principal;
- uma captura de tela mostra um shell vazio;
- o alvo carrega dados através de solicitações em segundo plano;
- componentes atrasados requerem uma espera controlada.
Não assuma que a saída de Markdown, captura de tela ou PDF requer automaticamente renderização. A decisão deve vir do comportamento do alvo.
Teste a página sem renderização primeiro. Pesquise o conteúdo necessário. Em seguida, compare a resposta com uma solicitação habilitada para navegador usando a API de renderização JavaScript.
Resumo prático: a renderização melhora um formato apenas quando a execução do navegador muda o conteúdo do qual esse formato é construído.
Um formato de produção deve ser selecionado a partir da necessidade subsequente para trás.
Use este processo de decisão:
- Defina o consumidor. Identifique se a resposta vai para um parser, LLM, índice de busca, revisor de QA, arquivo ou sistema de monitoramento.
- Defina a evidência necessária. Decida se o fluxo de trabalho precisa de estrutura DOM, conteúdo legível, contexto da solicitação, aparência visual ou um registro portátil.
- Teste a captura bruta primeiro. Confirme se o conteúdo necessário existe sem renderização do navegador.
- Compare formatos em um alvo. Avalie HTML, texto, Markdown, metadados ou saída visual usando a mesma URL pública.
- Meça a limpeza. Escolha a resposta que requer a transformação personalizada menos confiável.
- Verifique o tamanho e peso da resposta. Evite armazenar ou gerar mais dados do que a aplicação usa.
- Documente o perfil da solicitação. Registre o formato escolhido, configuração de renderização, esperas, roteamento, cabeçalhos e saída esperada.
O formato selecionado pode diferir por grupo de destino. Páginas editoriais podem se adequar ao Markdown, páginas de comércio eletrônico podem exigir HTML, e monitoramento visual pode combinar texto com capturas de tela.
Um perfil de resposta global é conveniente, mas raramente é ótimo para uma carga de trabalho de produção mista.
Resumo prático: escolha formatos por classe de fluxo de trabalho, valide-os em alvos representativos e registre o perfil de solicitação comprovado antes de escalar.
Como os formatos de resposta afetam custo e peso da solicitação?
Os formatos de resposta afetam largura de banda, armazenamento, tempo de processamento e créditos da API.
Uma resposta básica em HTML ou texto geralmente é mais leve do que uma captura de tela renderizada pelo navegador ou PDF. A diferença se torna importante em volume de produção.
| Perfil de saída | Peso relativo | Custo é justificado quando | Evitar quando |
|---|---|---|---|
| HTML bruto | Leve | DOM ou marcação fonte é necessário | Apenas conteúdo legível é necessário |
| Texto simples | Leve | Processamento de conteúdo compacto é o objetivo | Estrutura e links importam |
| Markdown | Leve a moderado | Fluxos de trabalho de IA ou editoriais se beneficiam da hierarquia | Extração precisa de DOM é necessária |
| Metadados JSON | Leve | O contexto da solicitação suporta operações | É esperado substituir a análise |
| HTML renderizado | Maior | JavaScript cria conteúdo necessário | HTML bruto já está completo |
| Captura de tela | Maior | Prova visual ou QA é necessária | Cada solicitação é processada apenas por máquina |
| Maior | Um registro arquivado portátil é necessário | O artefato nunca é revisado ou mantido |
O controle de custo deve começar com alvos representativos. Agrupe solicitações por formato e necessidade de renderização em vez de precificar cada URL como se exigisse o perfil mais pesado.
Os créditos do ScraperFly tornam possível conectar o peso da solicitação aos controles habilitados. As equipes podem começar com um teste gratuito, comparar formatos e estimar a carga de trabalho real usando o calculador de custo de crédito da API de web scraping.
Resumo prático: reserve saídas renderizadas e baseadas em arquivos para fluxos de trabalho que utilizam suas evidências extras.
Quais erros as equipes devem evitar ao escolher a saída da API de scraping?
O erro mais comum é escolher um formato familiar em vez do formato que o produto precisa.
Evite esses padrões:
Enviar HTML em todos os lugares. A marcação bruta adiciona limpeza desnecessária a pipelines de conteúdo e IA.
Usar texto para extração precisa. Texto simples remove relações DOM das quais os parsers podem depender.
Assumir que Markdown é perfeito para cada página. Tabelas complexas, componentes interativos e layouts incomuns podem não converter de forma limpa.
Tratar metadados JSON como extração personalizada. O contexto de solicitação estruturado não é o mesmo que um esquema de negócios específico do alvo.
Gerar capturas de tela para fluxos de trabalho apenas de máquina. Arquivos visuais adicionam peso, mas fornecem pouco valor quando nenhum sistema humano ou de comparação visual os utiliza.
Usar PDF como entrada para parser. PDFs são registros úteis, mas raramente são a fonte mais eficiente para extração estruturada.
Renderizar cada solicitação. A execução do navegador deve resolver uma lacuna de conteúdo demonstrada.
Construir conversores antes de testar formatos. Uma equipe pode passar dias reproduzindo uma saída que a API já pode retornar.
Usar um formato para cada alvo. Diferentes tipos de página e consumidores subsequentes frequentemente precisam de perfis diferentes.
Teste páginas representativas através do API Builder, compare a saída e escolha com base na usabilidade em vez da popularidade do formato.
Resumo prático: valide a resposta com seu verdadeiro consumidor subsequente antes de comprometer a arquitetura de produção.
PERGUNTAS DO COMPRADOR
Perguntas comuns antes de escolher um formato de resposta
Responda perguntas de avaliação prática sobre HTML, texto, Markdown, metadados JSON, capturas de tela, PDFs, renderização, peso da solicitação e usabilidade em produção.
FAQ DE SAÍDAMarkdown, texto e pipelines de IA
Escolha saída legível quando o consumidor for busca, RAG, revisão editorial ou análise de conteúdo leve.
Markdown é sempre o melhor formato para um pipeline de IA ou RAG?
Não. O Markdown é útil quando cabeçalhos, listas e links melhoram o contexto do documento. Texto simples pode ser melhor para processamento compacto, enquanto HTML pode ser necessário quando o conteúdo deve primeiro ser selecionado de elementos DOM específicos.
Uma aplicação pode usar diferentes formatos de resposta para diferentes alvos?
Sim. Uma aplicação de produção pode classificar alvos por fluxo de trabalho. Páginas de documentação podem usar Markdown, páginas de produtos podem usar HTML e alvos de monitoramento visual podem usar capturas de tela.
HTML mais contexto de resposta
Use contexto estruturado para depurar, roteirizar e registrar solicitações sem fingir que metadados são um extrator personalizado.
Uma API de scraping pode retornar HTML e metadados para o mesmo fluxo de trabalho?
Sim, um fluxo de trabalho pode usar o conteúdo da página junto com o contexto da resposta. HTML suporta análise, enquanto metadados podem registrar o status, URL final, tipo de conteúdo, tamanho da resposta e outros detalhes da solicitação suportados pela API.
A saída JSON extrai automaticamente produtos ou campos de artigo?
Não. Os metadados JSON descrevem a captura ou resposta. Não devem ser interpretados como extração automática de campos arbitrários, como preços, autores, classificações ou atributos de produtos.
Capturas de tela, PDFs e saída renderizada
Adicione artefatos visuais quando revisão, arquivamento ou evidência de aparência importam, não para cada solicitação apenas de máquina.
As capturas de tela devem ser geradas para cada página monitorada?
Normalmente não. HTML ou texto legível por máquina são melhores para comparação automatizada. Capturas de tela são mais valiosas quando uma mudança requer confirmação visual, revisão humana ou evidência de layout.
Qual é a diferença entre HTML renderizado e uma captura de tela?
HTML renderizado contém o DOM após a execução do navegador e permanece adequado para análise. Uma captura de tela é uma imagem mostrando como a página apareceu visualmente. Os dois formatos respondem a perguntas diferentes.
Quando um fluxo de trabalho de scraping deve usar saída PDF?
Use PDF quando a página capturada deve se tornar um documento portátil para revisão, aprovação, arquivamento ou manutenção de registros. Use HTML, texto ou Markdown quando o processamento automatizado for o principal requisito.
Testando antes da integração
Compare os formatos em alvos representativos antes que a equipe construa conversores ou escale um perfil pesado.
Como os desenvolvedores devem comparar formatos antes da integração?
Execute a mesma URL de alvo representativa através do API Builder usando vários formatos. Compare estrutura, conteúdo ausente, tamanho da resposta, necessidades de renderização, requisitos de limpeza e usabilidade subsequente antes de selecionar o perfil de produção.
Teste a forma de resposta antes de comprometer a arquitetura
Um pipeline de scraping se torna mais fácil de manter quando a API retorna a forma que o produto pode usar imediatamente.
ScraperFly permite que as equipes capturem páginas públicas como HTML, texto, Markdown, metadados JSON, capturas de tela ou PDFs através de um modelo de solicitação. Comece com um alvo representativo, compare formatos no API Builder, habilite a renderização do navegador apenas quando a página exigir, e mantenha saídas visuais para fluxos de trabalho que utilizam evidências visuais.
O melhor formato de resposta não é o que tem mais dados. É aquele que remove processamento desnecessário enquanto preserva as evidências que sua aplicação precisa.









