






Markup pronto para parser
Capture HTML confiável antes que as regras de extração dependam disso
Um parser HTML é tão confiável quanto a fonte da página que recebe. Se a solicitação retornar uma estrutura fina, um redirecionamento, um fallback bloqueado ou markup que aparece apenas após a execução do JavaScript, seletores e regras de extração podem falhar mesmo quando o parser em si está correto.
ScraperFly oferece às equipes um ponto de partida mais limpo: busque páginas públicas como HTML bruto quando a markup já estiver presente, mude para HTML renderizado quando o DOM útil for construído pelo navegador e preserve evidências de resposta para que as decisões de parsing sejam baseadas no estado real da página.
O que é uma API de parser HTML para web scraping?
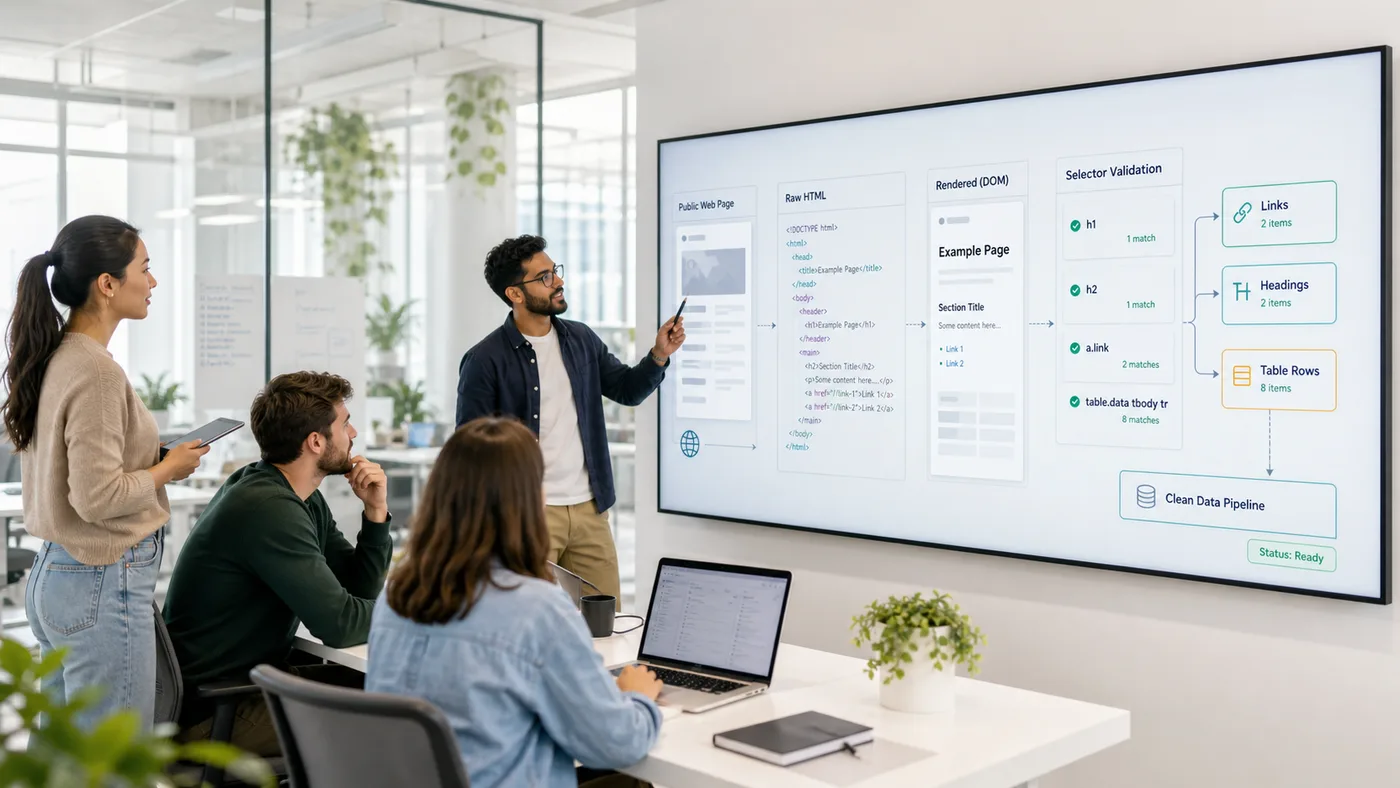
Um fluxo de trabalho de API de parser HTML começa recuperando uma página pública e fornecendo à sua aplicação uma markup que pode ser inspecionada. O parser então extrai links, cabeçalhos, tabelas, metadados, cartões de produtos, seções de artigos, paginação, dados incorporados ou outros elementos da página dessa fonte capturada.
O desafio prático não é apenas o parsing. É capturar a versão certa da página antes que o parsing comece. Alguns alvos expõem uma markup útil na resposta HTML inicial. Outros enviam uma estrutura de aplicativo vazia e constroem o DOM no navegador. Alguns retornam uma página diferente dependendo de cabeçalhos, cookies, região ou roteamento. ScraperFly lida com essa camada de captura para que seu parser possa trabalhar a partir de uma resposta verificada em vez de uma cola frágil do navegador.
Quando o parser deve usar HTML bruto ou HTML renderizado?
HTML bruto é o melhor ponto de partida quando o alvo envia uma markup útil imediatamente. É mais leve, mais rápido de inspecionar e mais fácil de comparar entre amostras. HTML renderizado é útil quando a fonte inicial contém apenas um contêiner de rota, script de hidratação, nós de espaço reservado ou conteúdo carregado tardiamente que aparece após a execução do navegador.
A decisão deve ser por alvo, não global. Se cada URL for forçada a passar por um navegador por padrão, o fluxo de trabalho se torna mais pesado antes que a equipe saiba se a renderização melhora a fonte capturada. Um padrão melhor é buscar o HTML da fonte primeiro, compará-lo com os campos esperados e, em seguida, habilitar a renderização apenas para páginas onde o parser não consegue ver a markup necessária.
| Entrada do parser | Use quando | Principal vantagem | Verificação importante |
|---|---|---|---|
| HTML bruto | A resposta inicial contém os links, campos, tabelas ou blocos de conteúdo. | Leve e fácil de depurar. | Confirme se a markup está presente antes de escrever seletores. |
| HTML renderizado | O JavaScript constrói o DOM útil após o carregamento da resposta da fonte. | Captura o estado da página construída pelo navegador. | Use renderização apenas quando mudar a resposta. |
| Texto ou Markdown | O fluxo de trabalho a jusante precisa de conteúdo legível em vez de relações de DOM. | Entrada mais limpa para revisão de conteúdo, pesquisa e fluxos de trabalho de IA. | Não use quando seletores ou atributos importam. |
| Metadados JSON | A aplicação precisa de contexto de resposta para registro, QA ou decisões de roteamento. | Expõe evidências operacionais em torno da captura. | Complementa o parsing; não substitui regras de extração específicas do alvo. |
O que as equipes devem validar antes de escalar regras de parser?
As regras de parser muitas vezes parecem estáveis em uma amostra e depois quebram em um conjunto de URLs. A solução é validar a forma da resposta antes da escala: certifique-se de que as mesmas seções existem, os links esperados estão presentes, as tabelas mantêm uma estrutura previsível, a paginação é visível e a resposta não redirecionou silenciosamente para um tipo de página diferente.
ScraperFly ajuda mantendo os controles de solicitação visíveis. Você pode comparar a saída bruta e renderizada, preservar a URL final e o status, inspecionar o tamanho da resposta e usar capturas de tela quando a prova visual é importante. Isso torna as falhas de seletores mais fáceis de diagnosticar: o parser pode dizer se o alvo mudou, a markup se moveu, o JavaScript foi necessário ou a captura retornou a página errada.
| Ponto de validação | Por que isso importa | Ação segura para o parser |
|---|---|---|
| Contêiner esperado | O parser precisa de uma seção estável para começar. | Verifique se o HTML bruto ou renderizado contém o contêiner. |
| Links e paginação | Muitas varreduras falham quando os links da próxima página estão ausentes ou transformados. | Verifique hrefs e controles de página entre amostras. |
| Tabelas e listas | Os dados podem mudar de colunas, rótulos ou aninhamento entre modelos. | Compare a estrutura antes de mapear campos. |
| Status e URL final | Um parser pode receber uma parede de login, página de redirecionamento ou bloqueio suave. | Registre evidências de resposta com cada resultado analisado. |
| Formato da resposta | Parsing de DOM, ingestão de texto e QA visual precisam de saídas diferentes. | Escolha HTML, texto, Markdown, JSON, captura de tela ou PDF com base no consumidor. |
Onde o ScraperFly se encaixa em um pipeline de parsing HTML?
ScraperFly fica antes do seu parser. Sua aplicação envia uma URL alvo e um perfil de solicitação, e então recebe uma forma de resposta que seu pipeline pode usar: HTML bruto para parsing de origem, HTML renderizado para páginas construídas pelo navegador, texto limpo ou Markdown para fluxos de trabalho de conteúdo, metadados JSON para diagnósticos, ou capturas de tela e PDFs para evidências visuais.
Essa separação é valiosa. Sua equipe mantém o controle sobre seletores, regras de extração, validação, armazenamento e lógica de negócios. ScraperFly lida com a camada de busca, renderização do navegador quando realmente necessário, contexto de sessão e cabeçalho, opções de roteamento e formatos de resposta. O resultado é uma fronteira mais limpa entre "obter a fonte da página certa" e "extrair os dados que nos importam."
Para uma visão mais ampla dos formatos de saída suportados, compare os formatos de resposta da API de web scraping. Para testar um perfil de solicitação antes de escrever código de produção, use o API Builder público.
Como as equipes podem manter o parsing HTML estável em produção?
O parsing em produção precisa de evidências, não apenas seletores. Armazene a URL alvo, URL final, status, tipo de conteúdo, tamanho da resposta, configuração de renderização, controles de tempo e formato de saída escolhido com cada captura. Esses campos facilitam muito a separação de erros de parser de mudanças de alvo, problemas de entrega e lacunas de renderização de JavaScript.
Quando o parser começa a perder campos, evite reescrever a lógica de extração imediatamente. Primeiro, inspecione se a markup capturada ainda contém a fonte esperada. Se contiver, atualize o parser. Se não contiver, ajuste o perfil de solicitação: renderize a página, aguarde o conteúdo tardio, preserve o estado da sessão, adicione cabeçalhos legítimos, escolha roteamento de país ou use entrega mais forte para alvos que provem que precisam disso.
Como isso torna o scraping mais barato de operar?
O parsing HTML se torna caro quando as equipes usam o perfil de solicitação mais pesado para cada página. ScraperFly suporta um caminho mais prático: comece com captura de HTML leve, inspecione se a markup contém dados úteis e, em seguida, adicione renderização do navegador, esperas, sessões, cabeçalhos, direcionamento de país, roteamento premium, capturas de tela ou PDFs apenas quando o alvo provar que esses controles melhoram o resultado.
Isso é especialmente útil para projetos com alvos mistos. Páginas públicas simples podem permanecer em capturas simples. Páginas pesadas em JavaScript podem usar HTML renderizado. Páginas que precisam de prova podem adicionar saída de captura de tela ou PDF. Projetos irregulares podem usar créditos pay-as-you-go, enquanto cargas de trabalho de produção previsíveis podem mudar para créditos mensais quando o padrão estiver claro. A página de preços explica esse caminho em detalhes.







