






ScraperFlyAPI de dados web pronta para IA

developer api

API de Web Scraping em Node.js para captura de páginas públicas

Use ScraperFly como a camada de captura para fluxos de trabalho de scraping em Node.js: teste uma URL pública, escolha HTML, texto, Markdown, metadados JSON, captura de tela ou saída em PDF, adicione renderização, sessões, cabeçalhos ou controle de roteamento apenas quando o alvo precisar deles, e então mova a resposta através de trabalhadores, filas, agentes ou serviços de backend.

Fluxo de trabalho do backend

Mantenha o Node.js focado na orquestração enquanto o ScraperFly cuida da captura

Node.js é um lugar natural para trabalhos de backend, filas, rotas de API, agentes, painéis e fluxos de trabalho orientados a eventos. Não deve se tornar uma plataforma de navegador personalizada antes que sua equipe saiba se a resposta da página pública é utilizável.

ScraperFly oferece aos serviços Node.js uma camada de captura limpa: busque uma URL pública, escolha HTML, texto, Markdown, metadados JSON, captura de tela ou saída em PDF, e adicione renderização, sessões, cabeçalhos, roteamento por país, esperas ou entrega mais forte apenas quando o alvo provar que esses controles melhoram o resultado.
fetch ou axiostrabalhadoresfilas
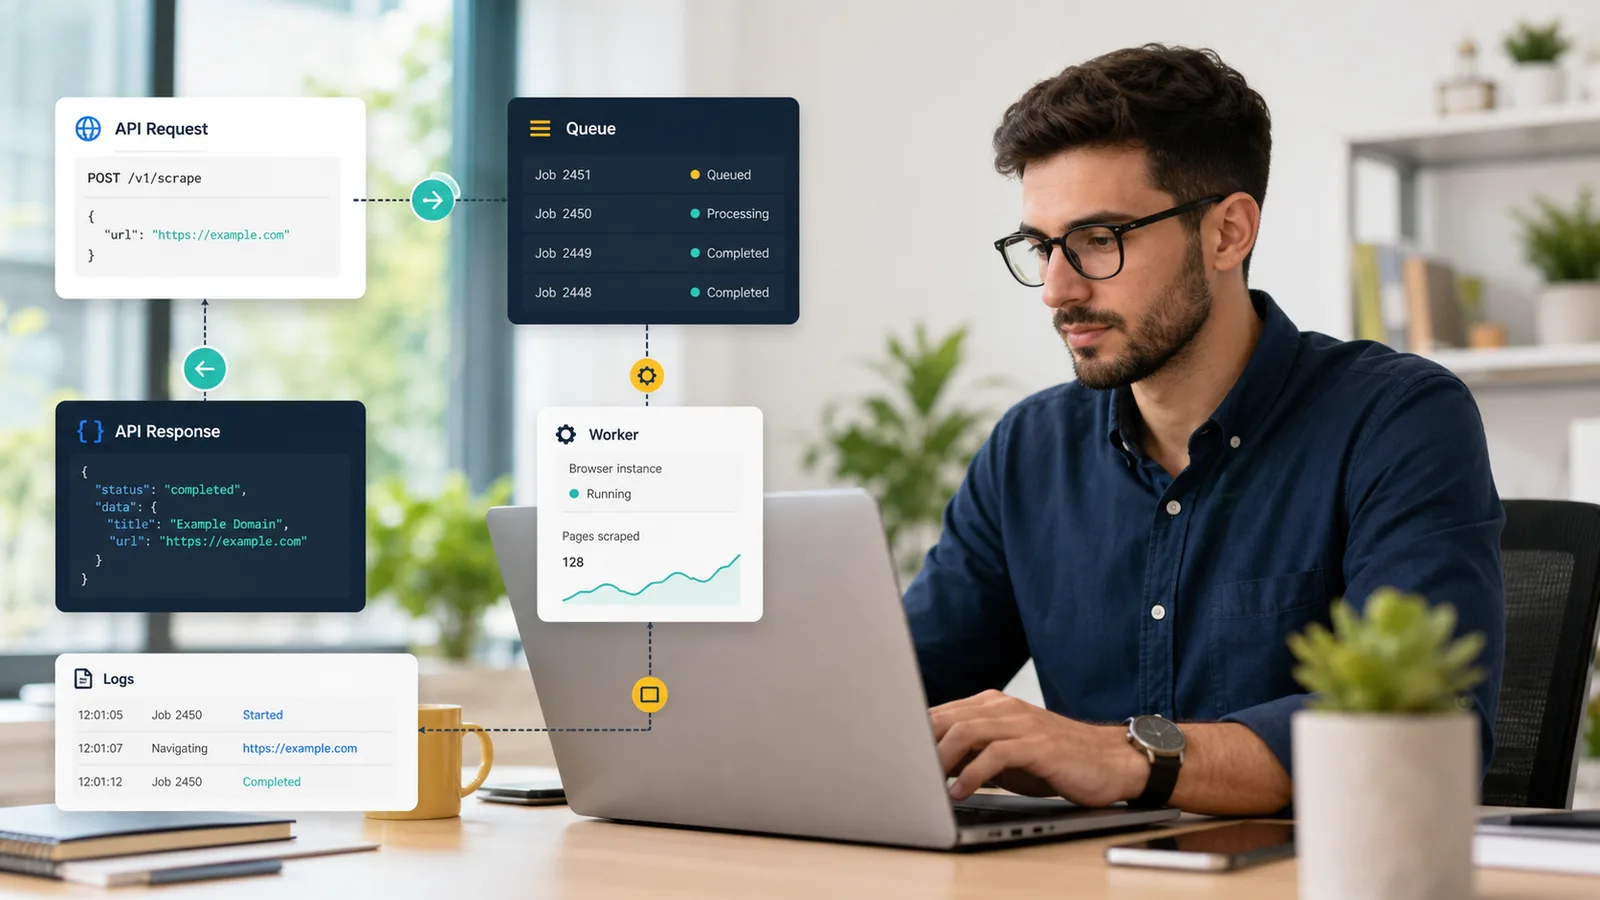
Desenvolvedor executando um fluxo de trabalho de backend em Node.js com solicitações de API de web scraping, trabalhos em fila e logs de resposta

Como funciona uma API de web scraping em Node.js?

Um fluxo de trabalho de API de web scraping em Node.js envia uma URL de destino pública e opções de solicitação de um serviço de backend para uma camada de captura hospedada. A API recupera a página, aplica controles de renderização ou roteamento quando necessário, e retorna uma resposta que sua aplicação Node.js pode processar. Seu código permanece responsável pela análise, validação, comportamento da fila, armazenamento, alertas e lógica do produto.

Essa fronteira mantém o backend mais fácil de manter. Em vez de misturar automação de navegador, manipulação de proxy, tentativas, conversão de resposta e extração de campos em um único serviço, o aplicativo Node.js pode chamar uma superfície de solicitação e manter o resto do pipeline explícito. Um trabalhador pode capturar uma página, inspecionar status e metadados, analisar os campos que precisa e empurrar o resultado para um banco de dados ou sistema downstream.

Resumo prático: use o ScraperFly para captura confiável de páginas públicas e deixe o Node.js controlar o fluxo de trabalho específico da aplicação em torno da resposta.

O que a primeira solicitação de scraping em Node.js deve provar?

A primeira solicitação deve provar a página de destino e o formato da resposta antes que o código se torne reutilizável. Envie uma URL representativa, mantenha o perfil da solicitação leve e inspecione o resultado. Verifique a URL final, status, tipo de conteúdo, tamanho da resposta, corpo e se os campos que seu analisador precisa estão presentes. Se o HTML de origem já contiver o conteúdo útil, o backend pode permanecer simples. Se a página for um shell de aplicativo ou faltar campos importantes, compare a saída renderizada antes de transformar cada trabalho em uma solicitação de navegador.

Isso é importante porque as equipes de Node.js costumam se mover rapidamente de um teste bem-sucedido para uma fila ou trabalhador. Se a primeira solicitação estiver sobrecarregada com renderização, roteamento premium, longas esperas ou saída visual, esse perfil caro pode se tornar o padrão antes que alguém saiba qual opção realmente importava. Um fluxo de trabalho melhor prova um tipo de página de cada vez e mantém cada controle vinculado a evidências.

Verificação do backend O que prova O que o trabalho em Node.js deve fazer a seguir
Resposta de origem Se o HTML bruto contém os campos úteis Mantenha o trabalho leve quando a captura de origem for suficiente.
Resposta renderizada Se o JavaScript altera o conteúdo Ative a renderização apenas para templates que precisam de execução no navegador.
Metadados da resposta Status, URL final, tipo de conteúdo, tamanho e evidência da solicitação Armazene com logs de trabalho antes de analisar ou tentar novamente.
Formato de saída Se o consumidor downstream precisa de marcação, conteúdo legível, metadados ou prova visual Escolha a forma da resposta antes de construir conversores.
Tipo de falha Se o problema é entrada, autenticação, comportamento do alvo, limite de taxa, rede ou renderização Corrija a configuração, tente novamente com backoff ou escale deliberadamente.

Qual formato de resposta o Node.js deve solicitar?

O melhor formato é aquele que seu backend pode usar sem limpeza extra. HTML é útil quando o analisador precisa de estrutura DOM, links, atributos, tabelas ou metadados incorporados. HTML renderizado é útil quando a execução do navegador cria o DOM final. Texto e Markdown são melhores quando o fluxo de trabalho precisa de conteúdo legível para pesquisa, resumos, contexto de agente, ingestão RAG ou revisão de conteúdo. Metadados JSON são úteis para logs e decisões operacionais. Capturas de tela e PDFs são melhores para QA, aprovações, monitoramento, arquivos ou prova visual.

Não escolha HTML em todos os lugares apenas porque é familiar. Um serviço Node.js que alimenta um LLM pode se beneficiar do Markdown. Um trabalhador de monitoramento pode precisar de metadados mais uma captura de tela. Um analisador pode precisar de HTML bruto para seletores. Um arquivo de conformidade pode precisar de saída em PDF. Teste a forma da resposta cedo para que o serviço não cresça uma camada de conversor que a API pode evitar.

Para a decisão de formato mais profunda, use o guia de formatos de resposta da API de web scraping antes de codificar seu modelo de backend.

Consumidor Node.js Formato a testar Por que se encaixa Fique atento a
Serviço de análise HTML ou HTML renderizado Preserva seletores, links, atributos e relacionamentos DOM Requer extração e validação específicas do alvo.
Trabalhador de busca ou IA Texto ou Markdown Conteúdo legível mais limpo com menos ruído de layout Pode não preservar estrutura suficiente para extração precisa de campos.
Monitoramento de fila Metadados JSON Deixa status, URL final, tamanho da resposta e tipo de conteúdo visíveis Não substitui a análise dos dados do alvo em si.
QA ou aprovações Captura de tela Mostra como a página pública renderizada parecia Mais pesada do que a saída legível por máquina.
Arquivo ou registro de revisão PDF Cria um documento visual portátil Menos conveniente para análise automatizada.

Quando um serviço Node.js deve habilitar renderização, sessões, cabeçalhos ou roteamento?

Ative controles quando evidências do alvo mostrarem uma necessidade real. Use renderização JavaScript quando o HTML de origem estiver incompleto e conteúdo útil aparecer após a execução do navegador. Use cabeçalhos quando um alvo público esperar um contexto de solicitação legítimo, como idioma, tipo de conteúdo aceito ou comportamento de referer. Use sessões quando solicitações relacionadas dependerem de cookies ou estado compartilhados. Use roteamento por país quando o conteúdo público mudar por região, moeda, idioma, disponibilidade ou comportamento de redirecionamento. Use roteamento mais forte quando amostras repetidas mostrarem que o caminho simples não pode recuperar uma resposta utilizável.

Essas opções não devem viver como padrões silenciosos em um helper compartilhado. Uma fila de backend pode processar muitos tipos de páginas, e nem todos eles merecem o mesmo perfil de solicitação. Mantenha perfis explícitos: páginas estáticas, páginas pesadas em JavaScript, páginas regionais, fluxos com estado e trabalhos de prova visual devem ser separados o suficiente para que custo e falhas permaneçam compreensíveis.

Para páginas construídas em navegador, revise a API de renderização JavaScript. Para estado compartilhado, use a API de sessões. Para contexto de solicitação, veja cabeçalhos personalizados. Para decisões de caminho de entrega, compare a página da API de scraping com proxy rotativo.

Como os trabalhadores Node.js devem lidar com falhas de scraping?

Os trabalhadores Node.js precisam de falhas que possam ser tratadas. Uma URL malformada, chave inválida, formato não suportado ou opção de arquivo incompatível deve parar o trabalho e apontar para a configuração. Um timeout, limite de taxa, upstream 5xx, problema de conexão, surpresa de redirecionamento, shell HTML fino ou timeout de renderização devem ser registrados com o perfil da solicitação e tratados com uma tentativa limitada ou um teste de captura diferente. Trate cada falha como evidência, não apenas como uma string de exceção.

Isso é especialmente importante em filas. Um único perfil ruim pode se multiplicar em centenas de trabalhos se a lógica de tentativa for muito ampla. Armazene metadados de resposta ao lado de cada resultado de trabalho: status, URL final, tipo de conteúdo, tamanho da resposta, formato de saída, escolha de renderização, escolha de roteamento, tempo de espera e contagem de tentativas. Quando falhas se agrupam por tipo de alvo, a equipe pode corrigir o perfil em vez de adivinhar dentro do código da aplicação.

A seção reutilizável de tratamento de erros abaixo expande esses grupos, mas a regra do backend é simples: pare erros de configuração, tente novamente falhas temporárias com cuidado e escale apenas quando amostras repetidas justifiquem a solicitação mais pesada.

Como as filas de scraping em Node.js podem permanecer previsíveis?

Filas previsíveis começam com classificação de páginas. Separe trabalhos de HTML simples de páginas renderizadas, fluxos dependentes de sessão, alvos regionais, casos de roteamento premium, capturas de tela e arquivos PDF. Cada classe deve ter seu próprio perfil de solicitação, expectativa de concorrência, comportamento de tentativa e registro. Isso mantém um pequeno scrape de herdar o custo do alvo mais pesado no sistema.

O modelo de crédito do ScraperFly suporta esse estilo de trabalho porque as equipes podem testar pequenos, manter projetos desiguais em créditos pay-as-you-go e mover cargas de trabalho recorrentes para créditos mensais quando o volume se torna claro. O passo importante é saber quais perfis seus alvos reais exigem antes de aumentar a concorrência.

Use preços após amostrar URLs reais, não antes. A estimativa correta depende de se seus trabalhos são principalmente HTML bruto, HTML renderizado, fluxos baseados em sessão, rotas premium, arquivos visuais ou uma mistura.

O que o Node.js deve controlar após a captura?

Node.js deve controlar o fluxo de trabalho que é único para seu produto: filas, trabalhadores, tentativas, módulos de análise, regras de validação, deduplicação, armazenamento, webhooks, alertas, painéis e integrações downstream. ScraperFly deve controlar a camada de captura de páginas públicas: entrega de solicitações, renderização quando necessário, sessões, cabeçalhos, roteamento, formatos de resposta, capturas de tela, PDFs e evidência de resposta.

Essa fronteira dá ao backend um contrato estável. Se a análise falhar, inspecione a resposta capturada e atualize os seletores. Se a captura falhar, ajuste o perfil da solicitação. Se a fila crescer, ajuste a concorrência e as classes de trabalho sem reescrever a infraestrutura do navegador. O serviço permanece chato no melhor sentido: entradas claras, saídas claras e menos partes móveis ocultas.

Onde uma equipe Node.js deve começar?

Comece com um alvo público real no API Builder ou cURL, depois mova a solicitação comprovada para o Node.js. Teste HTML bruto primeiro, compare a saída renderizada quando o conteúdo estiver faltando, escolha o formato de resposta que seu backend pode usar e registre metadados suficientes para explicar falhas futuras.

Depois que o primeiro tipo de página funcionar, adicione lotes deliberadamente. Mantenha os perfis de solicitação visíveis no código, evite um único helper "heavy scrape" global e deixe a fila escalar em torno de evidências de respostas reais.


Fluxo de trabalho Node.js

Construa uma solicitação ScraperFly que se integre perfeitamente a um backend Node.js

Comece com uma solicitação de API comprovada, depois leve a mesma URL, formato, renderização, roteamento, cabeçalhos e escolhas de sessão para um serviço Node.js sem reescrever o fluxo de trabalho de scraping do zero.

JS
Pronto para o backend

Prototipe a solicitação antes de adicionar código da aplicação

Use o API Builder ou cURL primeiro, depois mova a forma exata da solicitação para fetch, Axios, filas ou trabalhadores.

fetchaxiostrabalhadores
OUT
Saída útil

Retorne o formato que seu pipeline Node.js espera

Escolha HTML para análise, texto ou Markdown para sistemas de conteúdo, metadados JSON para manipulação estruturada, ou arquivos visuais para revisão.

htmltextomarkdownjson
OPS
Controles de produção

Mantenha as opções de entrega visíveis no código

Renderização, sessões, cabeçalhos, roteamento por país, roteamento premium, esperas e tentativas permanecem explícitos, para que a depuração permaneça prática.

renderizarsessõestentativas

Controles de solicitação Node.js para manter explícito

url

A página de destino pública passada do seu trabalho Node.js.

format

A forma de saída que seu parser, fila, agente ou pipeline de dados espera.

render

Renderização de navegador para conteúdo construído no frontend.

premium

Roteamento mais forte quando a entrega simples não retorna uma resposta utilizável.

exemplo de cURL

Gere Markdown com a mesma forma de solicitação que você pode mover para produção

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Antes de codificar

Mapeie o comportamento do alvo antes de codificar um perfil de scraping Node.js

Um scraper Node.js confiável começa com evidências de destino: disponibilidade de HTML bruto, renderização de JavaScript, redirecionamentos, tamanho da resposta, cabeçalhos, sessões, diferenças entre países e requisitos de saída.

Resposta HTML bruta mapeada para dados visíveis da página
01

Disponibilidade de HTML bruto

Verifique se os campos que você precisa já estão presentes na primeira resposta HTML.

Melhor primeiro teste para páginas simples, artigos, documentos, listagens e detalhes de produtos.

Comparação antes e depois da renderização do JavaScript
02

Dependência de JavaScript

Compare HTML bruto com o DOM renderizado ou captura de tela antes de ativar a renderização do navegador.

Use renderização quando o HTML bruto é apenas uma casca e scripts criam o conteúdo útil.

Cookies, consentimento, sessão e contexto de acesso para scraping
03

Estado e contexto de acesso

Identifique se cookies, consentimento, limites de login, paginação ou o mesmo estado do visitante afetam a resposta.

Use sessões e cabeçalhos quando a continuidade muda os dados que você recebe.

Variações de conteúdo regional entre países e rotas
04

Variação geo/conteúdo

Teste se país, idioma, moeda, inventário, SERP, anúncios ou reputação da rota mudam o resultado.

Use roteamento geo ou premium apenas quando o alvo provar que a resposta varia por rota.

Verificações antes de escrever o código de integração

Onde está o campo alvo?

Verifique se o campo existe no HTML bruto, DOM renderizado, uma chamada de API, dados estruturados, um arquivo ou um estado de interação posterior.

O que muda na resposta?

Amostre algumas URLs e compare status, URL final, comprimento do conteúdo, redirecionamentos, estados vazios e diferenças nos resultados visíveis.

Qual contexto é necessário?

Marque qualquer dependência de consentimento, localidade, cookies, cabeçalhos, limite de autenticação, paginação, filtros ou solicitações anteriores.

Como é a falha?

Defina os sinais para respostas bloqueadas, parciais, obsoletas, redirecionadas, vazias, com tempo esgotado ou com região incompatível antes de escalar.

Como as evidências de destino mudam a solicitação Node.js

Modo de busca

A disponibilidade de HTML bruto decide se a primeira solicitação pode permanecer simples ou precisa de renderização, esperas, capturas de tela ou extração.

Contexto da solicitação

Os requisitos de estado decidem se é necessário adicionar cabeçalhos, cookies, sessões, manuseio de consentimento ou um perfil de visitante estável.

Escolha de roteamento

Descobertas geográficas e de reputação decidem se o roteamento padrão é suficiente ou se uma rota de país/premium é justificada.

Regras de validação

Estados de falha conhecidos se tornam verificações para novas tentativas, escalonamento, revisão de QA e decisão de quando um perfil mais leve ainda está completo.

Tratamento de erros

Transforme falhas de scraping em soluções

Todo fluxo de trabalho de dados da web eventualmente encontra uma resposta ruim: uma URL ausente, uma chave inválida, uma estrutura HTML vazia, um alvo 403, um limite de taxa, um tempo limite de renderização, uma captura de PDF quebrada ou um payload JSON que não contém os campos que seu produto esperava. ScraperFly é construído para tornar esses momentos diagnosticáveis. Você inspeciona o status HTTP, o código de erro estável, o perfil de solicitação e o artefato retornado, então escolhe o próximo movimento útil mais barato: corrigir a solicitação, adicionar créditos, desacelerar, tentar novamente com backoff, habilitar renderização, mudar de país, usar roteamento premium, preservar cabeçalhos ou validar a saída antes de escalar.

Formato de erro estávelDecisões de tentativa novamenteEscalação consciente de custosValidação de saída
Desenvolvedor revisando código e parâmetros de solicitação da API em um laptop

01 / Configuração de solicitação e acesso

Corrija os erros de solicitação primeiro

Algumas falhas não são problemas de destino. Elas ocorrem antes que o ScraperFly possa fazer uma tentativa de entrega significativa: uma URL ausente ou malformada, um formato de saída não suportado, um tipo de arquivo visual incompatível, uma chave de API ausente, uma chave inválida ou uma chave que foi pausada ou desativada. Esses erros são sinais de configuração, não sinais de nova tentativa: pare o fluxo de trabalho, aponte para o desenvolvedor o campo exato que precisa de correção e mantenha os créditos focados em testes reais de destino em vez de entradas ruins repetidas.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Valide a URL e a codificação antes de enviar um lote.
  • Use saídas suportadas: HTML, texto, Markdown, JSON, captura de tela ou PDF.
  • Combine tipos de arquivo de captura de tela com saída de imagem e tipo de arquivo PDF com saída PDF.
  • Trate chaves de API ausentes ou inválidas como trabalho de configuração, não como trabalho de nova tentativa.
Painel de negócios com gráficos, documentos e planejamento de uso em uma mesa

02 / Créditos, limites e concorrência

Separe limites de falhas

Uma carga de trabalho pode falhar porque a conta não tem créditos utilizáveis, o limite do plano mensal foi atingido ou a concorrência é muito agressiva para o plano atual e a mistura de destinos. O ScraperFly torna esses limites visíveis como sinais operacionais, não como falhas de raspagem misteriosas. Isso mantém a decisão de compra prática: comece grátis, teste o destino, compre créditos pay-as-you-go para trabalhos irregulares, mude para créditos mensais quando o volume se tornar previsível e use backoff quando a pressão de solicitação for o verdadeiro problema.

usage_limit_reachedrate_limitedcreditsbackoff
  • Use o status da conta para verificar os créditos restantes antes de grandes execuções.
  • Tente limites de taxa com backoff em vez de aumentar a pressão imediatamente.
  • Mantenha projetos pontuais no modelo pay-as-you-go quando o volume for irregular.
  • Mova trabalhos recorrentes previsíveis para créditos mensais quando o padrão estiver comprovado.
Sala de servidores representando caminhos de entrega, roteamento e infraestrutura de rede

03 / Entrega alvo e rede

Encontre falhas de entrega primeiro

Muitas plataformas de scraping colapsam problemas de entrega em uma falha de solicitação vaga. Em produção, isso não é suficiente. A equipe precisa saber se a solicitação expirou, se o alvo upstream retornou um erro temporário do servidor, se a conexão falhou, se a resposta foi muito grande, se os redirecionamentos foram para algum lugar inesperado, ou se a página retornou como um HTML pequeno sem conteúdo útil. O ScraperFly transforma essas falhas em evidências de entrega: tente primeiro o perfil leve, compare status e tamanho da resposta, e então decida se a próxima solicitação precisa de backoff, outro caminho, proxy premium, direcionamento por país, ou uma captura mais restrita.

timeout5xxredirecionamentosresposta_muito_grande
  • Tente novamente falhas temporárias de rede e upstream com uma política de backoff controlada.
  • Compare URL final, status, tipo de conteúdo e tamanho da resposta entre amostras.
  • Escalone o roteamento apenas quando a resposta provar que o caminho simples é instável.
  • Trate respostas excessivas como um problema de escopo antes de escalar o mesmo perfil.
Tela de segurança digital representando sinais de anti-bot e acesso protegido

04 / Anti-bot, geo e bloqueios de acesso

Leia os blocos antes da escalada

Uma tela de erro 403, 401, 429, CAPTCHA, desafio WAF, parede de login, loop de consentimento ou incompatibilidade específica de região não é apenas um erro; é uma pista sobre o que o site espera do visitante. Concorrentes frequentemente empurram as equipes para um perfil padrão mais pesado, mas isso pode queimar orçamento sem provar a solução. O caminho melhor da ScraperFly é a escalada baseada em evidências: preserve cabeçalhos realistas quando o contexto importa, use sessões quando a continuidade muda a resposta, habilite renderização quando o conteúdo útil é construído pelo navegador e escolha roteamento premium ou por país quando a reputação ou geografia muda o resultado.

403429CAPTCHAincompatibilidade de país
  • Use roteamento premium quando a reputação do IP for o gargalo comprovado.
  • Use segmentação por país quando idioma, moeda, inventário ou resultados de busca mudam por mercado.
  • Use cabeçalhos, cookies e sessões quando o estado do visitante muda a resposta.
  • Reduza a concorrência e adicione backoff quando solicitações repetidas acionam a limitação do alvo.
Desenvolvedor preparando código e artefatos de saída em um laptop

05 / Qualidade de renderização e saída

Envie artefatos utilizáveis

Um status 200 não é a mesma coisa que um scrape utilizável. O HTML bruto pode ser uma shell de aplicativo vazia, Markdown pode perder o artigo principal, JSON pode faltar metadados esperados, texto pode incluir ruído, capturas de tela podem estar em branco, e a saída em PDF ou imagem pode falhar se a etapa do navegador expirar. A ScraperFly é valiosa porque a mesma solicitação de API pode passar de HTML bruto para DOM renderizado, texto limpo, Markdown, JSON, captura de tela ou PDF, e então ser verificada contra o artefato que seu produto realmente precisa. Isso reduz código de cola, importações falhadas e execuções em lote caras que apenas descobrem saída ruim depois do fato.

render_timeoutbrowser_render_failedcampos JSONsaída em PDF/imagem
  • Habilite a renderização quando o HTML bruto for apenas uma shell e o conteúdo útil aparecer após o JavaScript.
  • Valide texto, Markdown e JSON em relação aos campos esperados antes de agrupar.
  • Use captura de tela ou saída em PDF quando prova visual ou evidência de auditoria são importantes.
  • Trate artefatos em branco ou parciais como falhas de qualidade, mesmo quando o status HTTP é bem-sucedido.
Ajuste do ScraperFly

Recuperação de erro mais limpa

ScraperFly ajuda equipes a decidir o que corrigir, o que tentar novamente e o que escalar sem transformar cada raspagem no perfil de solicitação mais caro.

Formato de erro estável

Use o status HTTP e o código de erro juntos para que a lógica da aplicação possa escolher entre corrigir a entrada, atualizar credenciais, desacelerar, tentar novamente ou escalar a entrega.

Tente novamente apenas quando ajudar

Falhas de rede, limites de taxa e erros temporários do servidor podem usar backoff. URLs inválidas, formatos não suportados e chaves ruins devem ser corrigidos uma vez.

Escalação consciente de custos

Comece com o perfil de solicitação leve, depois adicione renderização, roteamento premium, país, sessões, cabeçalhos, esperas ou captura visual apenas quando a falha provar isso.

Valide a saída antes de escalar

Confirme o artefato real que seu produto precisa: HTML, texto, Markdown, JSON, captura de tela ou PDF, antes de copiar o mesmo perfil em um grande conjunto de URLs.

Trabalhadores conscientes de custo

Mantenha as filas de scraping Node.js eficientes começando com a solicitação de trabalho mais leve

O volume da fila pode magnificar pequenas escolhas de solicitação. Valide o perfil simples primeiro, depois adicione renderização de navegador, roteamento premium, sessões ou saída visual apenas onde melhoram os resultados.

Um pedido HTML leve retornando uma resposta simples
01

Fetch básico

Use um fetch básico quando o HTML público já contém os campos que você precisa.

Perfil de pedido mais leve; mantenha-o quando a resposta estiver completa.

Renderização JavaScript produzindo um DOM completo
02

Renderização

Use renderização quando o HTML bruto é uma casca e o JavaScript completa a página.

Perfil mais pesado; use-o apenas quando a saída do navegador alterar o resultado.

Várias solicitações preservando cookies e estado do visitante
03

Sessão com estado

Use sessões quando cookies, consentimento, local ou paginação alterarem a resposta.

Perfil de estado mais pesado; preserve-o apenas quando a continuidade for importante.

Roteamento de solicitações através de rotas geográficas e de maior qualidade
04

Roteamento e geo premium

Use roteamento premium ou geográfico apenas quando a origem, país, reputação ou conteúdo regional alterarem o resultado.

Perfil de roteamento mais pesado; aplique-o apenas a alvos que provem que precisam.

O que torna os trabalhos de scraping Node.js mais pesados

Mais trabalho de infraestrutura

Renderização de navegador, escolhas de roteamento e esperas mais longas significam que a plataforma precisa fazer mais do que retornar uma simples resposta.

Mais incerteza no alvo

Redirecionamentos, estados vazios, limites de taxa e páginas de desafio frequentemente requerem opções de entrega mais robustas ou tentativas novamente.

Mais estado a preservar

Cookies, sessões, consentimento e fluxos de múltiplas páginas adicionam partes móveis que um fetch sem estado simples não possui.

Mais evidências a retornar

Capturas de tela, PDFs, saída renderizada e artefatos de resposta mais ricos são úteis, mas são mais pesados do que HTML simples.

Como manter os trabalhos de backend previsíveis

Amostre antes de escalar

Teste um pequeno conjunto de URLs primeiro e agrupe alvos pelo perfil mais leve que retorna dados completos.

Não renderize por padrão

Inspecione o HTML bruto antes de ativar a renderização. Muitas páginas públicas já contêm os dados que você precisa.

Escalone com base em evidências

Suba apenas quando a resposta mostrar conteúdo ausente, dependência de estado, variação geográfica ou problemas de roteamento.

Meça resultados úteis

Otimize em torno de registros válidos entregues, não no volume bruto de solicitações. Um perfil mais leve é melhor apenas quando permanece completo.

Perguntas sobre Node.js

Perguntas comuns sobre scraping web com Node.js usando ScraperFly

Respostas práticas para equipes de backend decidindo como chamar o ScraperFly a partir do Node.js, escolher formatos de resposta, controlar a renderização e manter as filas previsíveis.

FAQ do Node
Backend

Chamando a API

Node.js pode tratar o ScraperFly como um serviço de captura de página pública estável.

Posso usar o ScraperFly a partir do Node.js?

Sim. Backends em Node.js podem chamar o ScraperFly com fetch, Axios ou outro cliente HTTP e processar a resposta no código da aplicação.

Devo começar em código ou no API Builder?

Comece com o API Builder ou cURL quando possível. Uma vez que a resposta esteja comprovada, mova o mesmo perfil de solicitação para o Node.js.

Formatos

Escolhendo a saída

O melhor formato depende do consumidor do backend.

Quais formatos os workflows em Node.js podem solicitar?

Workflows em Node.js podem solicitar HTML, HTML renderizado, texto, Markdown, metadados JSON, capturas de tela ou PDFs, dependendo do caso de uso subsequente.

O ScraperFly substitui meu código de parser?

Não. O ScraperFly captura páginas públicas e formata as respostas. A análise de campos, validação, armazenamento e lógica de negócios permanecem no seu aplicativo Node.js.

Controles

Renderização e contexto

Use controles mais pesados apenas quando as evidências do alvo os suportarem.

As solicitações do Node.js podem ativar a renderização?

Sim. Ative a renderização quando o conteúdo da página pública for construído por JavaScript e estiver ausente do HTML bruto.

Posso usar sessões e cabeçalhos?

Sim. Use sessões para estado compartilhado e cabeçalhos para contexto de solicitação legítimo quando a resposta do alvo depender deles.

Filas

Trabalhos de produção

As filas de backend precisam de perfis de solicitação que permaneçam visíveis e testáveis.

Como um trabalhador Node.js deve tentar novamente solicitações falhadas?

Tente limites temporários, erros de rede e falhas upstream com retrocesso limitado. Pare e corrija URLs malformadas, formatos não suportados ou problemas de autenticação.

Como posso manter o custo da fila previsível?

Classifique os tipos de página e mantenha HTML bruto, páginas renderizadas, sessões, roteamento, capturas de tela e PDFs em perfis de solicitação separados em vez de um padrão pesado.










