






ScraperFlyAPI de dados web pronta para IA

developer api

API de Web Scraping para dados públicos prontos para produção

ScraperFly oferece aos desenvolvedores uma camada de API prática para dados públicos da web: comece com solicitações HTML rápidas, mude para texto limpo, Markdown, metadados JSON, capturas de tela ou PDFs, e adicione renderização, sessões, cabeçalhos, roteamento por país ou roteamento premium apenas quando o alvo provar que precisa deles.

Camada principal da API

Construa o perfil de solicitação antes que seu produto dependa dos dados

Uma API de web scraping oferece ao seu produto uma maneira confiável de buscar páginas da web públicas, inspecionar a resposta e retornar uma saída utilizável sem precisar possuir cada parte móvel da infraestrutura de scraping. Sua equipe envia uma URL alvo e um perfil de solicitação claro. ScraperFly cuida da camada de captura e, em seguida, retorna HTML, texto, Markdown, metadados JSON, capturas de tela ou PDFs no formato que seu fluxo de trabalho pode usar.

A vantagem prática é o controle. Uma página simples deve permanecer uma solicitação HTML leve. Uma página JavaScript pode ser renderizada quando o conteúdo útil está ausente do HTML de origem. Um alvo difícil pode adicionar sessões, cabeçalhos, roteamento por país ou entrega premium após a resposta provar que esses controles são necessários. Esse caminho mantém os testes mais baratos, o comportamento de produção mais fácil de explicar e o tempo de engenharia focado no produto em vez de manutenção de navegador e proxy.
perfil de solicitaçãoformatos de respostaescalonamento controlado
Desenvolvedor testando uma solicitação de API de web scraping com controles de formato de resposta

O que uma API de web scraping realmente substitui?

Uma API de web scraping substitui a infraestrutura de captura em torno da recuperação de páginas públicas. Sem ela, uma equipe muitas vezes precisa manter clientes HTTP, trabalhadores de navegador, pools de proxy, lógica de repetição, regras de tempo limite, encaminhamento de cabeçalhos, estado de sessão, conversores de saída, captura de tela, geração de PDF, logs e monitoramento em torno de cada alvo. Esse trabalho pode ser útil para uma plataforma muito especializada, mas raramente é o valor central do produto que precisa dos dados.

ScraperFly move essa camada operacional para trás de uma superfície de API. A aplicação ainda possui o que importa a jusante: escolher alvos, analisar campos, validar a qualidade dos dados, armazenar registros, comparar mudanças, gerar alertas ou alimentar sistemas de IA e análise. ScraperFly se concentra em obter uma resposta de página pública em uma forma confiável para que o próximo sistema comece a partir de evidências em vez de uma captura caseira frágil.

Conclusão prática: use uma API de web scraping quando seu produto precisar de evidências de páginas públicas, não de outra plataforma interna para trabalho de navegador, proxy, repetição e conversão.

Como deve ser construída a primeira solicitação?

A primeira solicitação deve ser intencionalmente entediante. Envie a URL pública, peça a menor saída útil e inspecione o resultado. Se o HTML de origem contiver o conteúdo que seu analisador precisa, mantenha a solicitação simples. Se a página retornar apenas uma casca de aplicativo fina, marcação vazia ou conteúdo que aparece após a execução do JavaScript do frontend, ative a renderização para esse alvo. Se a resposta mudar por idioma, estado de consentimento, localização ou etapas anteriores, então avalie cabeçalhos, cookies, sessões ou roteamento por país.

Essa é a mesma lógica refletida no bloco de construtor de solicitações da página abaixo: construa uma solicitação confiável, depois adicione controles apenas quando o alvo provar que precisa deles. O objetivo não é esconder recursos avançados. O objetivo é manter cada recurso vinculado a uma razão. A renderização resolve conteúdo criado pelo navegador. Sessões preservam o estado entre solicitações relacionadas. Cabeçalhos carregam contexto de solicitação legítimo. Roteamento premium ou por país ajuda quando a evidência de entrega mostra que o caminho padrão não é suficiente. Capturas de tela e PDFs criam provas visuais quando a saída legível por máquina sozinha não pode contar toda a história.

Decisão de solicitação Comece com Adicione mais quando Por que isso importa
Captura básica de página pública URL mais saída HTML HTML de origem está incompleto ou inutilizável Mantém o primeiro teste rápido, barato e fácil de depurar.
Conteúdo criado por JavaScript Comparação de HTML bruto O navegador altera o conteúdo útil A renderização se torna um controle baseado em evidências, não um imposto padrão.
Páginas com estado ou regionais Solicitação simples com metadados de resposta Idioma, cookies, estado de rota ou localização mudam a resposta Sessões, cabeçalhos e roteamento permanecem ligados ao comportamento do alvo.
Fluxos de trabalho de revisão, QA ou arquivamento Saída legível por máquina Alguém precisa de prova de como a página parecia Capturas de tela e PDFs complementam dados analisáveis em vez de substituí-los.

Qual formato de resposta a API deve retornar?

O melhor formato de resposta é aquele que seu próximo sistema pode usar com a menor limpeza. HTML é adequado quando seletores, tabelas, links, atributos ou relacionamentos DOM importam. HTML renderizado é útil quando o JavaScript do frontend cria a marcação que seu analisador precisa. Texto é mais leve quando o fluxo de trabalho só precisa de conteúdo de página legível. Markdown ajuda IA, RAG, sumarização, documentação e fluxos de trabalho de revisão porque cabeçalhos e links permanecem mais fáceis de entender do que texto simples.

Metadados JSON são úteis para contexto operacional: status, URL final, tipo de conteúdo, tempo e detalhes da resposta que ajudam logs e depuração. Não substitui a extração personalizada. Capturas de tela e PDFs servem a um trabalho diferente: evidência visual. Eles ajudam com monitoramento, QA, revisão de conformidade, aprovações e arquivos, mas são mais pesados e geralmente menos convenientes para análise de máquina.
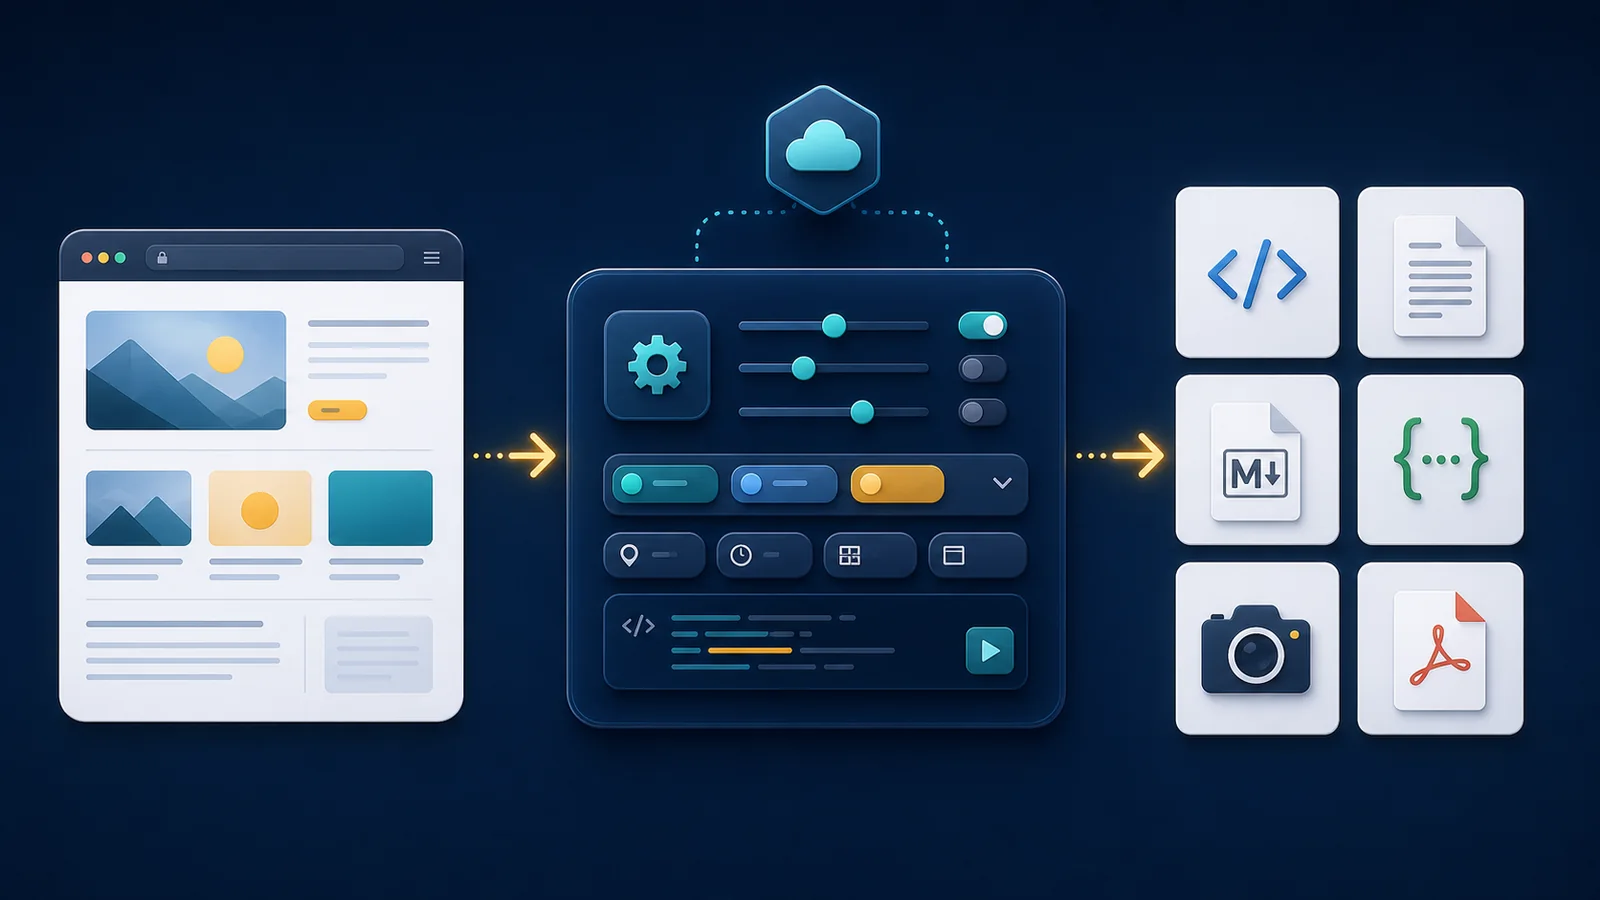
Diagrama mostrando uma URL alvo, controles de solicitação do ScraperFly e formatos de resposta suportados
Uma solicitação prática do ScraperFly começa com a URL pública alvo, depois adiciona apenas os controles e formatos de saída que o fluxo de trabalho a jusante realmente precisa.
Saída Mais adequado para Principal vantagem Compensação
HTML bruto ou renderizado Análise DOM, seletores, tabelas, links Preserva estrutura e relacionamentos de página Requer lógica de analisador e limpeza a jusante
Texto Busca, indexação, análise leve Compacto e fácil de processar Remove a maior parte do contexto estrutural
Markdown IA, RAG, resumos, revisão de conteúdo Mantém cabeçalhos, listas e links legíveis Não é ideal para extração precisa de DOM
Metadados JSON Registro, diagnósticos, roteamento de fluxo de trabalho Torna a evidência da solicitação mais fácil de inspecionar Não substitui a extração de campo específica do alvo
Captura de tela ou PDF QA, monitoramento, aprovações, arquivos Mostra como a página renderizada parecia Mais pesado e menos conveniente para análise

Quando a renderização, sessões, cabeçalhos e roteamento por proxy importam?

Controles avançados importam quando resolvem um problema específico do alvo. A renderização do navegador importa quando os dados são criados após a execução do JavaScript. Esperas importam quando o navegador carrega o estado correto tarde. Cabeçalhos importam quando o alvo público espera um contexto legítimo, como idioma, tipo de conteúdo, referenciador ou um padrão específico de agente do usuário. Sessões importam quando solicitações relacionadas dependem de cookies compartilhados ou estado de rota. O roteamento por país importa quando o conteúdo público muda por localização, moeda, disponibilidade ou regulamentação. O roteamento premium importa quando a evidência de resposta mostra que a entrega padrão não está retornando uma página utilizável.

Essa ordem é importante. Habilitar tudo de uma vez pode tornar uma solicitação mais cara, mais lenta e mais difícil de diagnosticar. Um fluxo de trabalho melhor é testar páginas representativas, comparar o tamanho e o conteúdo da resposta, inspecionar a URL final e o status e, em seguida, escolher o menor perfil de solicitação que produza de forma confiável o artefato necessário. Isso também torna a recuperação de produção mais clara: se um alvo começar a retornar um redirecionamento, tempo limite, casca vazia ou tipo de conteúdo inesperado, a equipe sabe qual parte do perfil de solicitação revisar.

Conclusão prática: adicione renderização, sessões, cabeçalhos, roteamento ou saída visual quando a resposta provar que eles melhoram a qualidade da captura, não porque estão disponíveis.

Como o ScraperFly mantém o caminho de compra de baixo risco?

Um projeto de scraping muitas vezes começa incerto. A equipe pode não saber se o alvo é estático, pesado em JavaScript, sensível à localização, dependente de sessão ou difícil de entregar. Trancar esse trabalho em uma infraestrutura pesada ou em um grande plano recorrente antes de testar o alvo cria risco. O ScraperFly está posicionado para um caminho mais simples: comece com créditos gratuitos, valide páginas reais, compre créditos quando um projeto precisar deles e passe para créditos mensais quando a demanda recorrente estiver clara.

Esse modelo se encaixa no fluxo de trabalho técnico. Uma solicitação leve deve permanecer leve. Uma solicitação renderizada ou roteada mais pesada deve ser usada quando criar valor. Arquivos visuais devem ser gerados quando alguém precisa de prova visual. O API Builder suporta a mesma lógica de compra porque permite que a equipe inspecione uma solicitação real antes de escrever código de ligação ou escalar lotes. O controle de custos não é apenas uma preocupação de preços; é um hábito de design de solicitação.

O que deve permanecer a jusante da API de scraping?

ScraperFly não deve ser enquadrado como um extrator mágico que transforma cada página pública em um conjunto de dados perfeito. A API captura a saída da página pública e fornece controles para renderização, roteamento, sessões, cabeçalhos, formatos e evidência visual. Seu produto ainda decide o que os dados significam. Mapeamento de campos, normalização de entidades, deduplicação, verificações de qualidade, alertas, pontuação, armazenamento e lógica de negócios permanecem a jusante, onde pertencem.

Esse limite torna o produto mais confiável. Uma API de web scraping deve ajudar um desenvolvedor a obter evidências de fonte confiáveis e, em seguida, permitir que a aplicação aplique suas próprias regras. Isso é especialmente importante para IA, monitoramento, análise e fluxos de trabalho de automação, onde evidências de fonte ruins podem levar a resumos ruins, alertas falsos, registros duplicados ou tentativas caras.
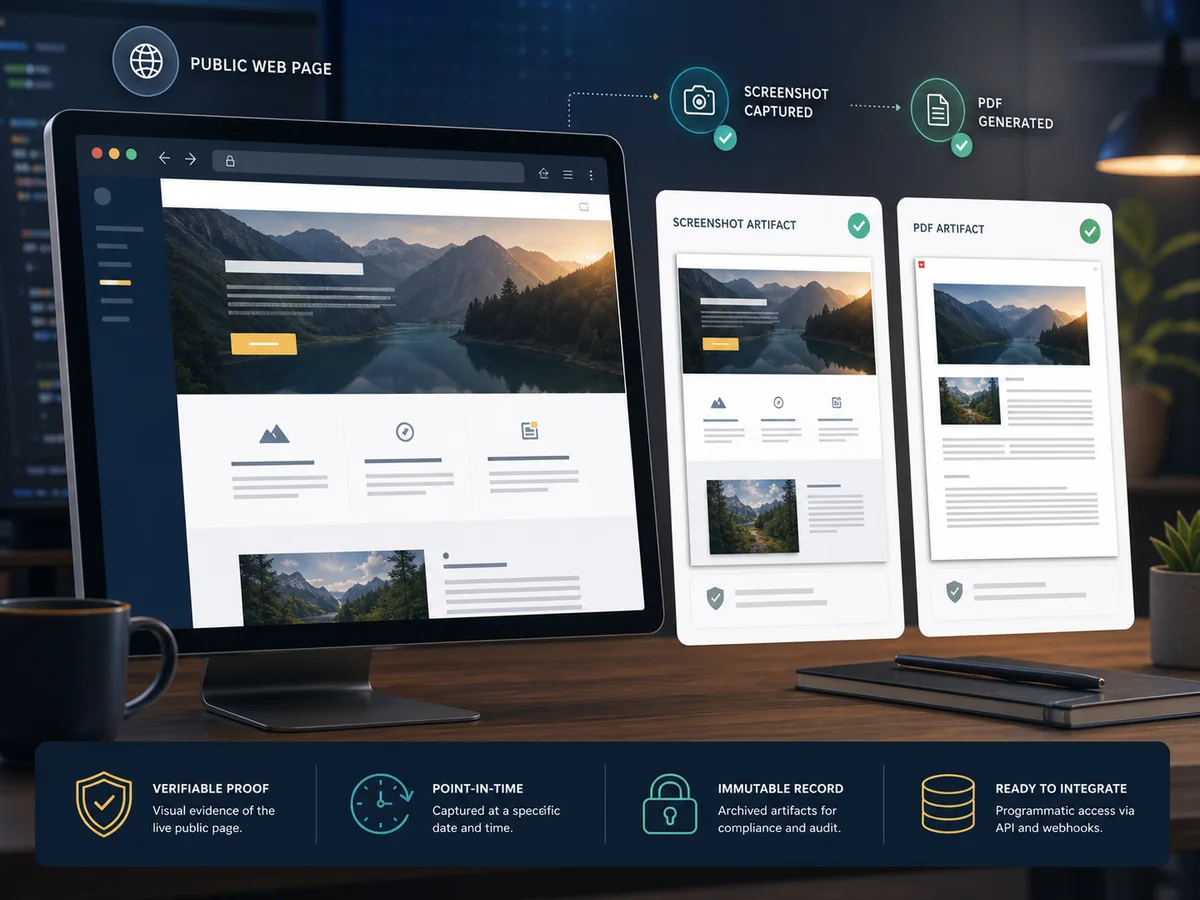
Captura de tela e PDF usados como prova visual para uma página da web pública
Saídas visuais são melhor usadas como prova revisável ao lado de HTML, texto, Markdown ou metadados legíveis por máquina.

Para onde uma equipe deve ir após entender os conceitos básicos?

O próximo passo é construir uma solicitação real, não uma arquitetura teórica. Use o API Builder para testar uma URL pública, comparar formatos de saída e decidir se a página precisa de renderização, sessões, cabeçalhos, roteamento ou captura visual. Se a principal questão for a forma da saída, revise a página formatos de resposta da API de web scraping. Se a página for pesada em JavaScript, compare o resultado com as orientações da API de renderização JavaScript. Se o estado for importante entre solicitações, a página API de sessões explica quando o contexto compartilhado é útil.

Uma vez que o perfil de solicitação esteja comprovado, mova-o para o backend, trabalhador, agente, analisador, monitor ou fluxo de trabalho de arquivo que precisa dos dados. Essa é a promessa central do ScraperFly: uma camada de API prática para dados públicos da web, com controles que permanecem visíveis desde o primeiro teste até a produção.


Fluxo de trabalho do desenvolvedor

Construa uma solicitação de API de web scraping confiável, e adicione controles apenas quando o alvo provar que precisa deles

Comece com uma captura limpa de URL pública, inspecione a resposta e adicione renderização, sessões, cabeçalhos, roteamento por país, proxies premium ou formatos de saída mais ricos apenas quando o alvo provar que são necessários.

GET
Solicitação canônica

Comece com a URL alvo

Envie uma URL pública através de uma superfície de API e mantenha a primeira solicitação fácil de inspecionar antes de adicionar controles mais pesados.

urlformatorenderizar
CTX
Contexto da solicitação

Adicione contexto quando a evidência exigir

Use cabeçalhos, cookies, sessões, esperas e roteamento por país como decisões explícitas ligadas à resposta que você vê.

cabeçalhossessõespaís
OUT
Saída utilizável

Retorne os dados na forma que seu aplicativo precisa

Escolha HTML, texto, Markdown, metadados JSON, capturas de tela ou PDFs para que o próximo sistema receba evidências úteis.

htmlmarkdownjsonpdf

Controles principais a serem explicados nesta página

url

A página pública que o ScraperFly busca, renderiza, converte ou captura.

format

A forma da resposta: HTML, texto, Markdown, JSON, captura de tela ou PDF.

render

Ative a renderização do navegador apenas quando o JavaScript criar o conteúdo.

premium

Escalone o roteamento apenas quando a resposta do alvo provar que a entrega simples não é suficiente.

exemplo de cURL

Gere Markdown com a mesma forma de solicitação que você pode mover para produção

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Alvo primeiro

Mapeie o comportamento da página antes de escolher o perfil de scraping

Diagnostique o alvo antes de escolher um perfil de scraping. HTML estático, conteúdo renderizado em JavaScript, comportamento de sessão, cabeçalhos, geografia, saída de arquivo e tamanho da resposta alteram a forma correta da solicitação.

Resposta HTML bruta mapeada para dados visíveis da página
01

Disponibilidade de HTML bruto

Verifique se os campos que você precisa já estão presentes na primeira resposta HTML.

Melhor primeiro teste para páginas simples, artigos, documentos, listagens e detalhes de produtos.

Comparação antes e depois da renderização do JavaScript
02

Dependência de JavaScript

Compare HTML bruto com o DOM renderizado ou captura de tela antes de ativar a renderização do navegador.

Use renderização quando o HTML bruto é apenas uma casca e scripts criam o conteúdo útil.

Cookies, consentimento, sessão e contexto de acesso para scraping
03

Estado e contexto de acesso

Identifique se cookies, consentimento, limites de login, paginação ou o mesmo estado do visitante afetam a resposta.

Use sessões e cabeçalhos quando a continuidade muda os dados que você recebe.

Variações de conteúdo regional entre países e rotas
04

Variação geo/conteúdo

Teste se país, idioma, moeda, inventário, SERP, anúncios ou reputação da rota mudam o resultado.

Use roteamento geo ou premium apenas quando o alvo provar que a resposta varia por rota.

Perguntas a serem respondidas antes de escalar

Onde está o campo alvo?

Verifique se o campo existe no HTML bruto, DOM renderizado, uma chamada de API, dados estruturados, um arquivo ou um estado de interação posterior.

O que muda na resposta?

Amostre algumas URLs e compare status, URL final, comprimento do conteúdo, redirecionamentos, estados vazios e diferenças nos resultados visíveis.

Qual contexto é necessário?

Marque qualquer dependência de consentimento, localidade, cookies, cabeçalhos, limite de autenticação, paginação, filtros ou solicitações anteriores.

Como é a falha?

Defina os sinais para respostas bloqueadas, parciais, obsoletas, redirecionadas, vazias, com tempo esgotado ou com região incompatível antes de escalar.

Como essas respostas mudam a solicitação

Modo de busca

A disponibilidade de HTML bruto decide se a primeira solicitação pode permanecer simples ou precisa de renderização, esperas, capturas de tela ou extração.

Contexto da solicitação

Os requisitos de estado decidem se é necessário adicionar cabeçalhos, cookies, sessões, manuseio de consentimento ou um perfil de visitante estável.

Escolha de roteamento

Descobertas geográficas e de reputação decidem se o roteamento padrão é suficiente ou se uma rota de país/premium é justificada.

Regras de validação

Estados de falha conhecidos se tornam verificações para novas tentativas, escalonamento, revisão de QA e decisão de quando um perfil mais leve ainda está completo.

Controle de custos

Mantenha solicitações simples leves e pague pela entrega mais pesada apenas quando isso criar valor

HTML bruto mantém a base leve. Renderização, roteamento premium e formatos de resposta mais ricos são atualizações deliberadas quando tornam o fluxo de trabalho a jusante mais rápido, limpo ou mais confiável.

Um pedido HTML leve retornando uma resposta simples
01

Fetch básico

Use um fetch básico quando o HTML público já contém os campos que você precisa.

Perfil de pedido mais leve; mantenha-o quando a resposta estiver completa.

Renderização JavaScript produzindo um DOM completo
02

Renderização

Use renderização quando o HTML bruto é uma casca e o JavaScript completa a página.

Perfil mais pesado; use-o apenas quando a saída do navegador alterar o resultado.

Várias solicitações preservando cookies e estado do visitante
03

Sessão com estado

Use sessões quando cookies, consentimento, local ou paginação alterarem a resposta.

Perfil de estado mais pesado; preserve-o apenas quando a continuidade for importante.

Roteamento de solicitações através de rotas geográficas e de maior qualidade
04

Roteamento e geo premium

Use roteamento premium ou geográfico apenas quando a origem, país, reputação ou conteúdo regional alterarem o resultado.

Perfil de roteamento mais pesado; aplique-o apenas a alvos que provem que precisam.

O que geralmente muda o peso do crédito

Mais trabalho de infraestrutura

Renderização de navegador, escolhas de roteamento e esperas mais longas significam que a plataforma precisa fazer mais do que retornar uma simples resposta.

Mais incerteza no alvo

Redirecionamentos, estados vazios, limites de taxa e páginas de desafio frequentemente requerem opções de entrega mais robustas ou tentativas novamente.

Mais estado a preservar

Cookies, sessões, consentimento e fluxos de múltiplas páginas adicionam partes móveis que um fetch sem estado simples não possui.

Mais evidências a retornar

Capturas de tela, PDFs, saída renderizada e artefatos de resposta mais ricos são úteis, mas são mais pesados do que HTML simples.

Como manter a primeira execução prática

Amostre antes de escalar

Teste um pequeno conjunto de URLs primeiro e agrupe alvos pelo perfil mais leve que retorna dados completos.

Não renderize por padrão

Inspecione o HTML bruto antes de ativar a renderização. Muitas páginas públicas já contêm os dados que você precisa.

Escalone com base em evidências

Suba apenas quando a resposta mostrar conteúdo ausente, dependência de estado, variação geográfica ou problemas de roteamento.

Meça resultados úteis

Otimize em torno de registros válidos entregues, não no volume bruto de solicitações. Um perfil mais leve é melhor apenas quando permanece completo.

Tratamento de erros

Transforme falhas de scraping em soluções

Todo fluxo de trabalho de dados da web eventualmente encontra uma resposta ruim: uma URL ausente, uma chave inválida, uma estrutura HTML vazia, um alvo 403, um limite de taxa, um tempo limite de renderização, uma captura de PDF quebrada ou um payload JSON que não contém os campos que seu produto esperava. ScraperFly é construído para tornar esses momentos diagnosticáveis. Você inspeciona o status HTTP, o código de erro estável, o perfil de solicitação e o artefato retornado, então escolhe o próximo movimento útil mais barato: corrigir a solicitação, adicionar créditos, desacelerar, tentar novamente com backoff, habilitar renderização, mudar de país, usar roteamento premium, preservar cabeçalhos ou validar a saída antes de escalar.

Formato de erro estávelDecisões de tentativa novamenteEscalação consciente de custosValidação de saída
Desenvolvedor revisando código e parâmetros de solicitação da API em um laptop

01 / Configuração de solicitação e acesso

Corrija os erros de solicitação primeiro

Algumas falhas não são problemas de destino. Elas ocorrem antes que o ScraperFly possa fazer uma tentativa de entrega significativa: uma URL ausente ou malformada, um formato de saída não suportado, um tipo de arquivo visual incompatível, uma chave de API ausente, uma chave inválida ou uma chave que foi pausada ou desativada. Esses erros são sinais de configuração, não sinais de nova tentativa: pare o fluxo de trabalho, aponte para o desenvolvedor o campo exato que precisa de correção e mantenha os créditos focados em testes reais de destino em vez de entradas ruins repetidas.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Valide a URL e a codificação antes de enviar um lote.
  • Use saídas suportadas: HTML, texto, Markdown, JSON, captura de tela ou PDF.
  • Combine tipos de arquivo de captura de tela com saída de imagem e tipo de arquivo PDF com saída PDF.
  • Trate chaves de API ausentes ou inválidas como trabalho de configuração, não como trabalho de nova tentativa.
Painel de negócios com gráficos, documentos e planejamento de uso em uma mesa

02 / Créditos, limites e concorrência

Separe limites de falhas

Uma carga de trabalho pode falhar porque a conta não tem créditos utilizáveis, o limite do plano mensal foi atingido ou a concorrência é muito agressiva para o plano atual e a mistura de destinos. O ScraperFly torna esses limites visíveis como sinais operacionais, não como falhas de raspagem misteriosas. Isso mantém a decisão de compra prática: comece grátis, teste o destino, compre créditos pay-as-you-go para trabalhos irregulares, mude para créditos mensais quando o volume se tornar previsível e use backoff quando a pressão de solicitação for o verdadeiro problema.

usage_limit_reachedrate_limitedcreditsbackoff
  • Use o status da conta para verificar os créditos restantes antes de grandes execuções.
  • Tente limites de taxa com backoff em vez de aumentar a pressão imediatamente.
  • Mantenha projetos pontuais no modelo pay-as-you-go quando o volume for irregular.
  • Mova trabalhos recorrentes previsíveis para créditos mensais quando o padrão estiver comprovado.
Sala de servidores representando caminhos de entrega, roteamento e infraestrutura de rede

03 / Entrega alvo e rede

Encontre falhas de entrega primeiro

Muitas plataformas de scraping colapsam problemas de entrega em uma falha de solicitação vaga. Em produção, isso não é suficiente. A equipe precisa saber se a solicitação expirou, se o alvo upstream retornou um erro temporário do servidor, se a conexão falhou, se a resposta foi muito grande, se os redirecionamentos foram para algum lugar inesperado, ou se a página retornou como um HTML pequeno sem conteúdo útil. O ScraperFly transforma essas falhas em evidências de entrega: tente primeiro o perfil leve, compare status e tamanho da resposta, e então decida se a próxima solicitação precisa de backoff, outro caminho, proxy premium, direcionamento por país, ou uma captura mais restrita.

timeout5xxredirecionamentosresposta_muito_grande
  • Tente novamente falhas temporárias de rede e upstream com uma política de backoff controlada.
  • Compare URL final, status, tipo de conteúdo e tamanho da resposta entre amostras.
  • Escalone o roteamento apenas quando a resposta provar que o caminho simples é instável.
  • Trate respostas excessivas como um problema de escopo antes de escalar o mesmo perfil.
Tela de segurança digital representando sinais de anti-bot e acesso protegido

04 / Anti-bot, geo e bloqueios de acesso

Leia os blocos antes da escalada

Uma tela de erro 403, 401, 429, CAPTCHA, desafio WAF, parede de login, loop de consentimento ou incompatibilidade específica de região não é apenas um erro; é uma pista sobre o que o site espera do visitante. Concorrentes frequentemente empurram as equipes para um perfil padrão mais pesado, mas isso pode queimar orçamento sem provar a solução. O caminho melhor da ScraperFly é a escalada baseada em evidências: preserve cabeçalhos realistas quando o contexto importa, use sessões quando a continuidade muda a resposta, habilite renderização quando o conteúdo útil é construído pelo navegador e escolha roteamento premium ou por país quando a reputação ou geografia muda o resultado.

403429CAPTCHAincompatibilidade de país
  • Use roteamento premium quando a reputação do IP for o gargalo comprovado.
  • Use segmentação por país quando idioma, moeda, inventário ou resultados de busca mudam por mercado.
  • Use cabeçalhos, cookies e sessões quando o estado do visitante muda a resposta.
  • Reduza a concorrência e adicione backoff quando solicitações repetidas acionam a limitação do alvo.
Desenvolvedor preparando código e artefatos de saída em um laptop

05 / Qualidade de renderização e saída

Envie artefatos utilizáveis

Um status 200 não é a mesma coisa que um scrape utilizável. O HTML bruto pode ser uma shell de aplicativo vazia, Markdown pode perder o artigo principal, JSON pode faltar metadados esperados, texto pode incluir ruído, capturas de tela podem estar em branco, e a saída em PDF ou imagem pode falhar se a etapa do navegador expirar. A ScraperFly é valiosa porque a mesma solicitação de API pode passar de HTML bruto para DOM renderizado, texto limpo, Markdown, JSON, captura de tela ou PDF, e então ser verificada contra o artefato que seu produto realmente precisa. Isso reduz código de cola, importações falhadas e execuções em lote caras que apenas descobrem saída ruim depois do fato.

render_timeoutbrowser_render_failedcampos JSONsaída em PDF/imagem
  • Habilite a renderização quando o HTML bruto for apenas uma shell e o conteúdo útil aparecer após o JavaScript.
  • Valide texto, Markdown e JSON em relação aos campos esperados antes de agrupar.
  • Use captura de tela ou saída em PDF quando prova visual ou evidência de auditoria são importantes.
  • Trate artefatos em branco ou parciais como falhas de qualidade, mesmo quando o status HTTP é bem-sucedido.
Ajuste do ScraperFly

Recuperação de erro mais limpa

ScraperFly ajuda equipes a decidir o que corrigir, o que tentar novamente e o que escalar sem transformar cada raspagem no perfil de solicitação mais caro.

Formato de erro estável

Use o status HTTP e o código de erro juntos para que a lógica da aplicação possa escolher entre corrigir a entrada, atualizar credenciais, desacelerar, tentar novamente ou escalar a entrega.

Tente novamente apenas quando ajudar

Falhas de rede, limites de taxa e erros temporários do servidor podem usar backoff. URLs inválidas, formatos não suportados e chaves ruins devem ser corrigidos uma vez.

Escalação consciente de custos

Comece com o perfil de solicitação leve, depois adicione renderização, roteamento premium, país, sessões, cabeçalhos, esperas ou captura visual apenas quando a falha provar isso.

Valide a saída antes de escalar

Confirme o artefato real que seu produto precisa: HTML, texto, Markdown, JSON, captura de tela ou PDF, antes de copiar o mesmo perfil em um grande conjunto de URLs.

Perguntas do comprador

Perguntas comuns antes de escolher uma API de raspagem da web

Responda às perguntas de avaliação prática sobre formatos de solicitação, renderização JavaScript, proxies, sessões, créditos e fluxos de trabalho de páginas públicas suportadas.

FAQ de avaliação
Solicitações

Fazendo solicitações à API

Para desenvolvedores conectando ScraperFly a agentes, trabalhos, serviços de backend ou testes rápidos.

O que eu envio para ScraperFly?

Envie uma URL alvo mais o formato de saída que você precisa. A API pode retornar HTML, texto limpo, Markdown, JSON, capturas de tela ou PDFs, dependendo das opções de solicitação.

Devo usar GET ou POST?

Ambos podem produzir o mesmo resultado de scraping. GET é conveniente para parâmetros de consulta simples; POST é melhor quando você deseja um corpo JSON claro ou opções de solicitação mais longas.

Posso testar uma solicitação antes de codificar?

Sim. O API Builder gera o endpoint, corpo JSON, parâmetros de consulta e exemplos de código, e depois permite que você envie uma solicitação ao vivo do painel.

Saída

HTML, texto, Markdown e JSON

Escolha a menor saída que seu produto realmente precisa.

Quando devo usar texto limpo?

Use texto limpo quando você precisar de conteúdo de página legível para resumos, classificação, indexação de busca ou prompts de LLM sem marcação de layout.

Para que serve a saída JSON?

JSON é útil quando você quer metadados estruturados, cabeçalhos, links, texto e Markdown em uma única resposta que é mais fácil de inspecionar programaticamente.

Markdown é diferente de texto limpo?

Markdown mantém mais estrutura de conteúdo, como cabeçalhos e listas. Texto limpo é mais plano e melhor quando a formatação é menos importante.

Renderização

Páginas JavaScript

Use renderização de navegador apenas quando a página de destino precisar.

Quando eu ativo render=true?

Ative a renderização para SPAs, páginas de produtos injetadas por JavaScript, conteúdo carregado sob demanda ou páginas onde o HTML fonte não contém os dados que você precisa.

A renderização sempre custa mais?

Sim, o trabalho do navegador é mais pesado do que uma busca HTML básica. Comece sem renderização, depois ative apenas para alvos que realmente exigem a execução de JavaScript.

Posso controlar as dimensões da viewport e o tempo de espera?

Sim. Solicitações de captura de tela e PDF podem usar dimensões de viewport e opções de espera de renderização para que a página capturada tenha tempo de se estabilizar.

Roteamento

Proxies e localização

Roteie solicitações através de pools padrão ou premium quando o comportamento do alvo mudar.

Quando eu preciso de roteamento de proxy premium?

Use roteamento premium para alvos mais rigorosos, taxas de bloqueio mais altas, respostas instáveis ou páginas que se comportam de maneira diferente sob o tráfego normal de datacenter.

Posso solicitar um país?

Sim. Adicione uma opção de país quando o conteúdo alvo depende de localização, moeda, idioma, disponibilidade ou redirecionamentos regionais.

As sessões são suportadas?

Fluxos de trabalho estilo sessão podem reutilizar o contexto entre solicitações relacionadas quando a continuidade é importante para paginação, mudanças de localidade ou scraping em várias etapas.

Arquivos

Capturas de tela e PDFs

Capture páginas renderizadas quando um artefato visual é a saída necessária.

O ScraperFly pode retornar uma captura de tela?

Sim. A saída de captura de tela captura a página renderizada como um arquivo de imagem, incluindo conteúdo renderizado em JavaScript quando a renderização está habilitada.

O ScraperFly pode gerar um PDF?

Sim. A saída em PDF é útil para recibos, relatórios, arquivos, instantâneas de conformidade e páginas que precisam ser salvas como um documento.

Onde os arquivos gerados aparecem?

Usuários registrados no painel podem salvar e baixar artefatos gerados dos logs de solicitações quando a solicitação produz um arquivo para download.

Créditos

Custos e créditos

Créditos rastreiam o trabalho de entrega em vez de infraestrutura ociosa.

Quantos créditos um pedido usa?

Um pedido simples em HTML, texto, Markdown ou JSON geralmente usa menos créditos. Renderização, roteamento premium, capturas de tela e PDFs usam mais porque requerem um trabalho de entrega mais pesado.

Os créditos pay-as-you-go expiram?

Os créditos pay-as-you-go permanecem disponíveis até que você os use. Eles são uma boa opção para cargas de trabalho irregulares ou projetos que não precisam de um plano mensal.

Os créditos de assinatura são acumulados?

Sim. Os créditos do plano mensal se renovam todo mês e os créditos não utilizados são acumulados. Se o pagamento falhar após as tentativas do Stripe, a conta volta para o Pay as you go.

Segurança

Chaves, cabeçalhos e segurança

Mantenha as credenciais em seu backend e encaminhe apenas os cabeçalhos que você pretende usar.

Onde devo armazenar minha chave da API?

Armazene a chave da API no lado do servidor ou em um ambiente confiável. Evite expor chaves de produção em pacotes frontend públicos ou páginas estáticas.

Posso encaminhar cabeçalhos de solicitação?

Sim, cabeçalhos selecionados como user-agent, accept-language, cookie e referer podem ser encaminhados quando um alvo espera um contexto de solicitação realista.

O ScraperFly contorna controles de acesso privados?

Não. É projetado para buscar páginas da web públicas e páginas que você tem permissão para acessar, não para contornar autenticação ou sistemas privados.

Cobrança

Planos, registros e faturas

Use o painel para entender o que aconteceu e por que os créditos mudaram.

Onde posso inspecionar o uso?

O painel registra logs de solicitações, alterações de saldo de crédito, formatos de saída, roteamento de proxy, durações e eventos de cobrança para que você possa auditar o uso.

Posso baixar faturas?

Transações pagas incluem dados de fatura quando o Stripe os fornece, então PDFs de fatura podem ser abertos a partir do log financeiro.

Como gerencio uma assinatura?

Usuários assinantes podem abrir o portal do cliente para alterar detalhes de pagamento, revisar faturas ou cancelar. Usuários gratuitos e de pagamento conforme o uso podem ir para Preços em vez disso.










