






Evidência SERP
Capture a página de resultados antes que sua lógica de classificação a pontue
ScraperFly fornece às equipes de SEO, análise e visibilidade de mercado uma camada de captura confiável para páginas de resultados de busca públicas. A API recupera as evidências da página que seu próprio pipeline de rastreamento de classificação precisa: consulta, mercado, idioma, contexto do dispositivo, URLs de resultados, trechos, anúncios, pacotes locais, módulos de Perguntas Frequentes, timestamps e o estado da resposta por trás de cada amostra.
Isso mantém a fronteira limpa. ScraperFly não substitui um rastreador de classificação, banco de dados de palavras-chave, painel de SEO ou suíte de alertas. Ele ajuda você a capturar evidências públicas de SERP de forma consistente, então seu próprio sistema decide como analisar posições, armazenar histórico, comparar concorrentes e relatar mudanças.
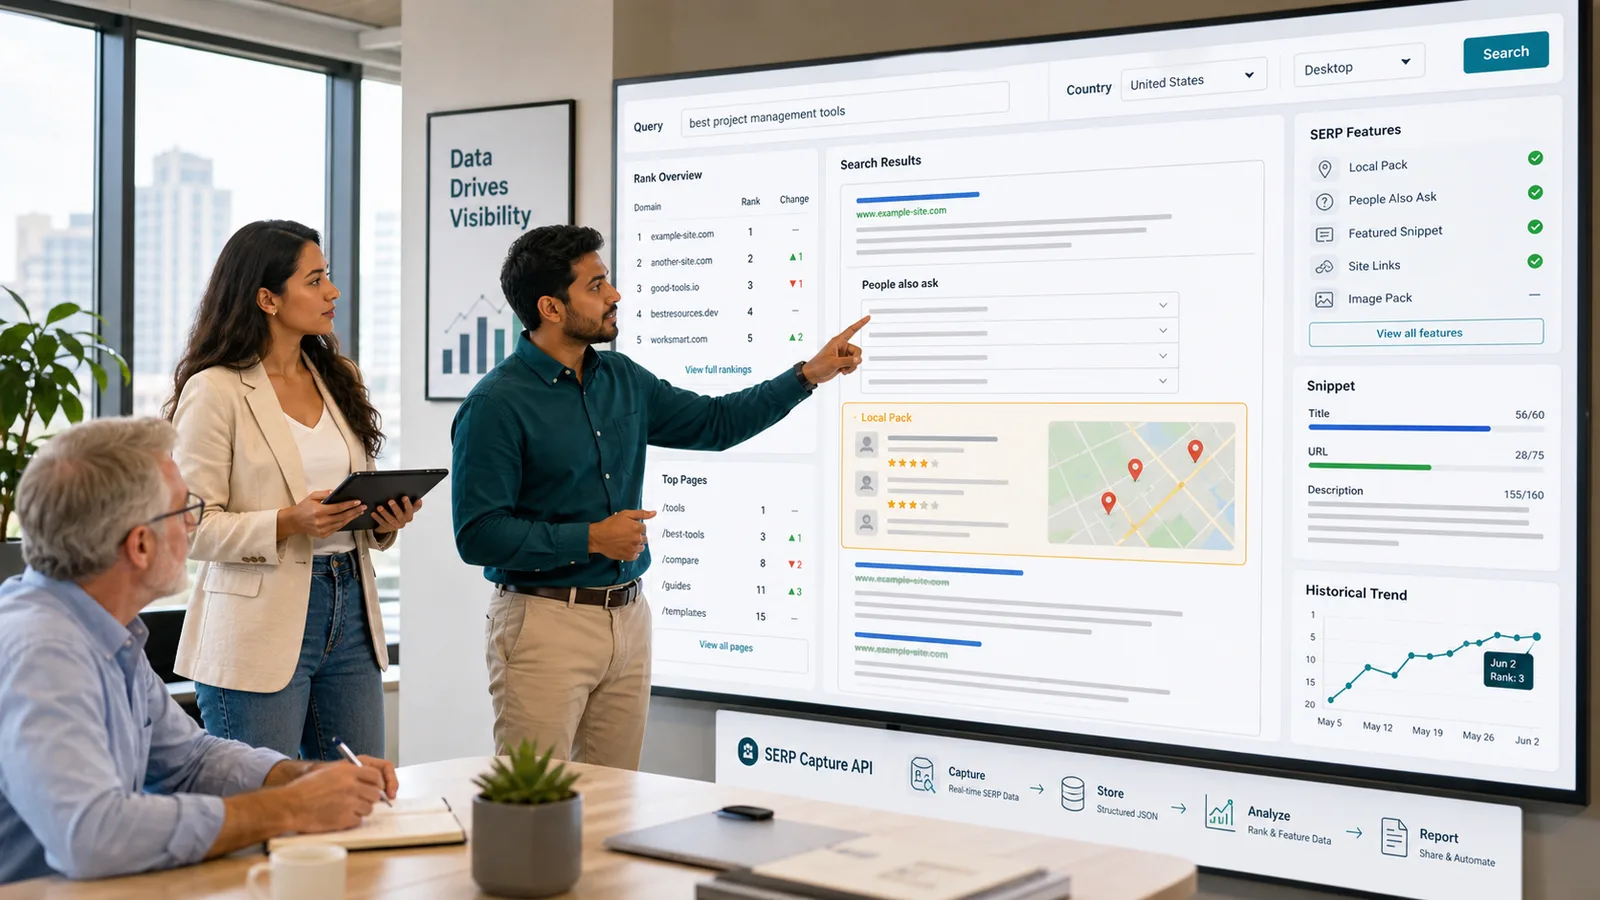
O que é uma API de captura de dados de rastreamento de classificação SERP?
Uma API de captura de dados de rastreamento de classificação SERP busca páginas de resultados de busca públicas para que um sistema de SEO a jusante possa analisar classificações, recursos de resultados, trechos, URLs e mudanças ao longo do tempo. A API faz o trabalho de captura: ela envia a solicitação de SERP pública, aplica os controles de entrega corretos, escolhe um formato de resposta utilizável e retorna evidências que seu próprio analisador, armazém ou camada de relatório pode avaliar.
O valor está na repetibilidade. O rastreamento de classificação só é confiável quando a mesma consulta é capturada com o mesmo mercado, idioma, dispositivo, roteamento e suposições de renderização. Se essas suposições mudarem silenciosamente, um movimento de classificação pode ser causado pelo perfil da solicitação em vez da página de resultados real.
Resumo prático: capture a SERP como evidência primeiro; calcule a classificação, a propriedade de recursos e o status de relatório no sistema que possui suas regras de SEO.
O que um fluxo de trabalho de rastreamento de classificação SERP deve capturar?
Um número de classificação sozinho não é suficiente. Páginas de resultados modernas misturam links orgânicos, anúncios, trechos em destaque, pacotes locais, pacotes de imagens, resultados de vídeo, links de site, módulos de Perguntas Frequentes, módulos de notícias, blocos de mapa, unidades de compras e outros recursos visíveis. Um resultado pode manter a mesma posição orgânica enquanto perde visibilidade porque um novo recurso o move para baixo na página. Outro resultado pode ganhar visibilidade porque possui um trecho ou aparece dentro de um módulo local.
Para cada amostra, preserve a consulta, a URL pública da SERP, o país, o idioma, o contexto do dispositivo, o timestamp, a URL final, a URL do resultado, o título, o trecho, a posição, o tipo de recurso e a evidência da resposta. Para movimentos de alto valor, a prova visual ajuda um humano a confirmar se o layout da página corresponde ao resultado analisado.
| Evidência | Por que é importante | Saída do ScraperFly a considerar |
|---|---|---|
| Consulta e mercado | A classificação não tem sentido sem país, idioma e contexto de busca | Roteamento de país, cabeçalhos selecionados, metadados de resposta |
| URL de resultado orgânico | Conecta mudanças de posição à página classificada | HTML ou HTML renderizado para analisadores |
| Título e trecho | Explica o que os buscadores viram, não apenas onde a URL foi classificada | HTML, texto ou Markdown |
| Recursos SERP | Anúncios, trechos, PAA, pacotes locais e imagens mudam a oportunidade visível | HTML mais captura de tela para amostras importantes |
| URL final e status | Ajuda a diagnosticar redirecionamentos, bloqueios, páginas de resultados ausentes e mudanças de alvo | Metadados JSON e diagnósticos de solicitação |
| Prova de layout visual | Suporta auditorias, relatórios para clientes e revisão manual de mudanças de alto impacto | Captura de tela ou PDF |
Por que o contexto SERP é tão importante?
Os resultados de busca podem mudar por país, cidade, idioma, classe de dispositivo, tempo, sinais de personalização, ortografia da consulta, layout da interface e mistura de recursos de resultados. Uma página de resultado pública capturada de um mercado pode não corresponder à página vista em outro. Um resultado de desktop pode não corresponder ao mobile. Um pacote local pode tornar a mesma posição orgânica menos visível. Um trecho em destaque pode mover a atenção acima dos links azuis tradicionais.
É por isso que a captura de SERP deve ser explícita sobre o contexto. Se seu pipeline rastreia classificações de desktop dos Estados Unidos, mantenha esse perfil de solicitação estável. Se você comparar mercados locais, defina cada mercado separadamente. Se um grupo de consultas precisar de capturas de tela porque a visibilidade do layout importa, reserve a captura visual para esse grupo em vez de transformar cada palavra-chave em uma solicitação visual pesada.
Use segmentação por país, cabeçalhos selecionados, sessões ou renderização apenas quando o conjunto de amostras provar que esses controles são necessários para evidências públicas de SERP comparáveis.
Quando o rastreamento de classificação deve usar renderização ou entrega mais forte?
Algumas páginas SERP são analisáveis a partir do HTML fonte. Outras requerem execução de navegador, temporização, roteamento mais forte ou captura visual para preservar o estado útil do resultado. A resposta certa não é habilitar todos os controles pesados por padrão. Comece com consultas representativas, inspecione a página retornada e classifique quais grupos de consultas precisam de qual perfil de solicitação.
A renderização pode ajudar quando os módulos de resultado são montados após a execução do frontend. Roteamento mais forte pode ajudar quando capturas de busca repetidas retornam entrega instável, bloqueios, redirecionamentos ou páginas incompletas. Capturas de tela ajudam quando o layout visível, anúncios, trechos, pacotes locais ou entradas de relatório contestadas precisam de revisão humana.
Para decisões específicas de navegador, use a API de renderização JavaScript e os guias da API de scraping de navegador sem cabeça. Para decisões de acesso e escalonamento, mantenha o bloco anti-bot reutilizável abaixo como a lista de verificação operacional.
Como as equipes devem escolher o formato de resposta?
Escolha o formato de resposta pelo uso a jusante. HTML é geralmente o melhor ponto de partida para analisadores de classificação porque preserva a estrutura do resultado, URLs, títulos, trechos, módulos e relacionamentos de marcação. Texto ou Markdown podem ajudar analistas a revisar o que a página diz. Metadados JSON suportam depuração. Capturas de tela e PDFs preservam a página visível quando a evidência de layout importa.
Um pipeline de rastreamento de classificação maduro pode usar mais de uma saída. Verificações de rotina podem analisar HTML. Mudanças de alto impacto podem anexar capturas de tela. Fluxos de trabalho de QA podem arquivar PDFs. Trabalhos de investigação podem comparar metadados de resposta, URL final, status e tamanho da resposta quando uma consulta de repente perde todos os resultados.
| Necessidade de rastreamento de classificação | Captura recomendada | Por que funciona | Quando evitar |
|---|---|---|---|
| Análise de posição rotineira | HTML ou HTML renderizado | Preserva a estrutura do resultado, URLs, trechos e blocos de recursos | Quando o fluxo de trabalho só precisa de resumos legíveis por humanos |
| QA de palavras-chave e revisão de analistas | Texto ou Markdown | Torna a cópia do resultado mais fácil de escanear e comparar | Quando a estrutura do DOM dirige o analisador |
| Diagnósticos de falha | Metadados JSON | Mostra status, URL final, tipo de conteúdo, tamanho e contexto da solicitação | Quando tratado como o resultado classificado em si |
| Prova voltada para o cliente | Captura de tela | Mostra o layout visível da SERP e a colocação de recursos | Para cada verificação rotineira quando a análise automática é suficiente |
| Arquivo de auditoria | Criando um registro revisável de uma página de resultado pública capturada | Quando dados históricos leves são suficientes |
Como o rastreamento de classificação SERP pode permanecer acessível?
O rastreamento de classificação se torna caro quando cada palavra-chave, mercado e dispositivo usa o perfil de solicitação mais pesado. Uma consulta de marca pequena em um mercado pode precisar de uma captura HTML simples. Uma consulta local competitiva pode precisar de roteamento por país e capturas de tela. Uma página de resultado volátil pode precisar de entrega mais forte. Um layout pesado em JavaScript pode precisar de renderização. Tratar todos esses como um único perfil desperdiça orçamento e torna as falhas mais difíceis de entender.
Classifique as consultas antes de escalar. Agrupe-as por mercado, dispositivo, complexidade de layout, importância de recursos e requisitos de prova. Mantenha verificações de baixo risco leves e adicione captura visual ou baseada em navegador apenas onde isso muda a decisão. Isso se encaixa no modelo de crédito do ScraperFly: comece com amostras, prove o perfil de solicitação e depois mova verificações recorrentes para um plano previsível quando a carga de trabalho estiver clara.
Use o API Builder para testes de perfil e a página de preços quando souber a mistura de HTML, renderização, roteamento, capturas de tela e PDFs.
Quais erros tornam o rastreamento de classificação ruidoso?
O rastreamento de classificação ruidoso geralmente vem da comparação de amostras que não foram capturadas da mesma forma. Uma consulta capturada de um mercado não deve ser comparada com uma amostra posterior de outro mercado, a menos que essa comparação seja intencional. Um resultado de desktop não deve ser misturado com mobile. Uma captura de HTML bruto não deve ser comparada com uma amostra renderizada, localizada e apoiada por captura de tela como se o método de captura não tivesse mudado.
Outro erro é relatar uma classificação sem o contexto do recurso SERP. Um resultado na posição três abaixo de anúncios, pacote local e um trecho em destaque não tem a mesma visibilidade que a posição três em uma página mais simples. Preserve evidências de recurso suficientes para explicar o que a classificação significa.
Resumo prático: mudanças de classificação só são úteis quando o contexto da consulta, o perfil de captura e os recursos visíveis da SERP são estáveis o suficiente para comparar.
Onde uma equipe deve começar?
Comece com um pequeno conjunto de consultas representativas. Inclua termos de marca, termos competitivos, termos locais e termos com muitos recursos, se forem importantes para seu mercado. Capture a SERP pública com um perfil leve primeiro. Inspecione se o HTML contém os dados do resultado. Adicione contexto de país, renderização, roteamento mais forte, capturas de tela ou PDFs apenas onde a evidência exigir.
Uma vez que o perfil de solicitação esteja comprovado, conecte a saída do ScraperFly ao seu analisador, histórico de classificação, armazém, painel, alertas ou fluxo de trabalho de relatórios. ScraperFly permanece a camada de captura; seu sistema de SEO permanece a fonte da lógica de classificação e interpretação de negócios.









































