






Докази SERP
Захоплюйте сторінку результатів до того, як ваша логіка ранжування оцінить її
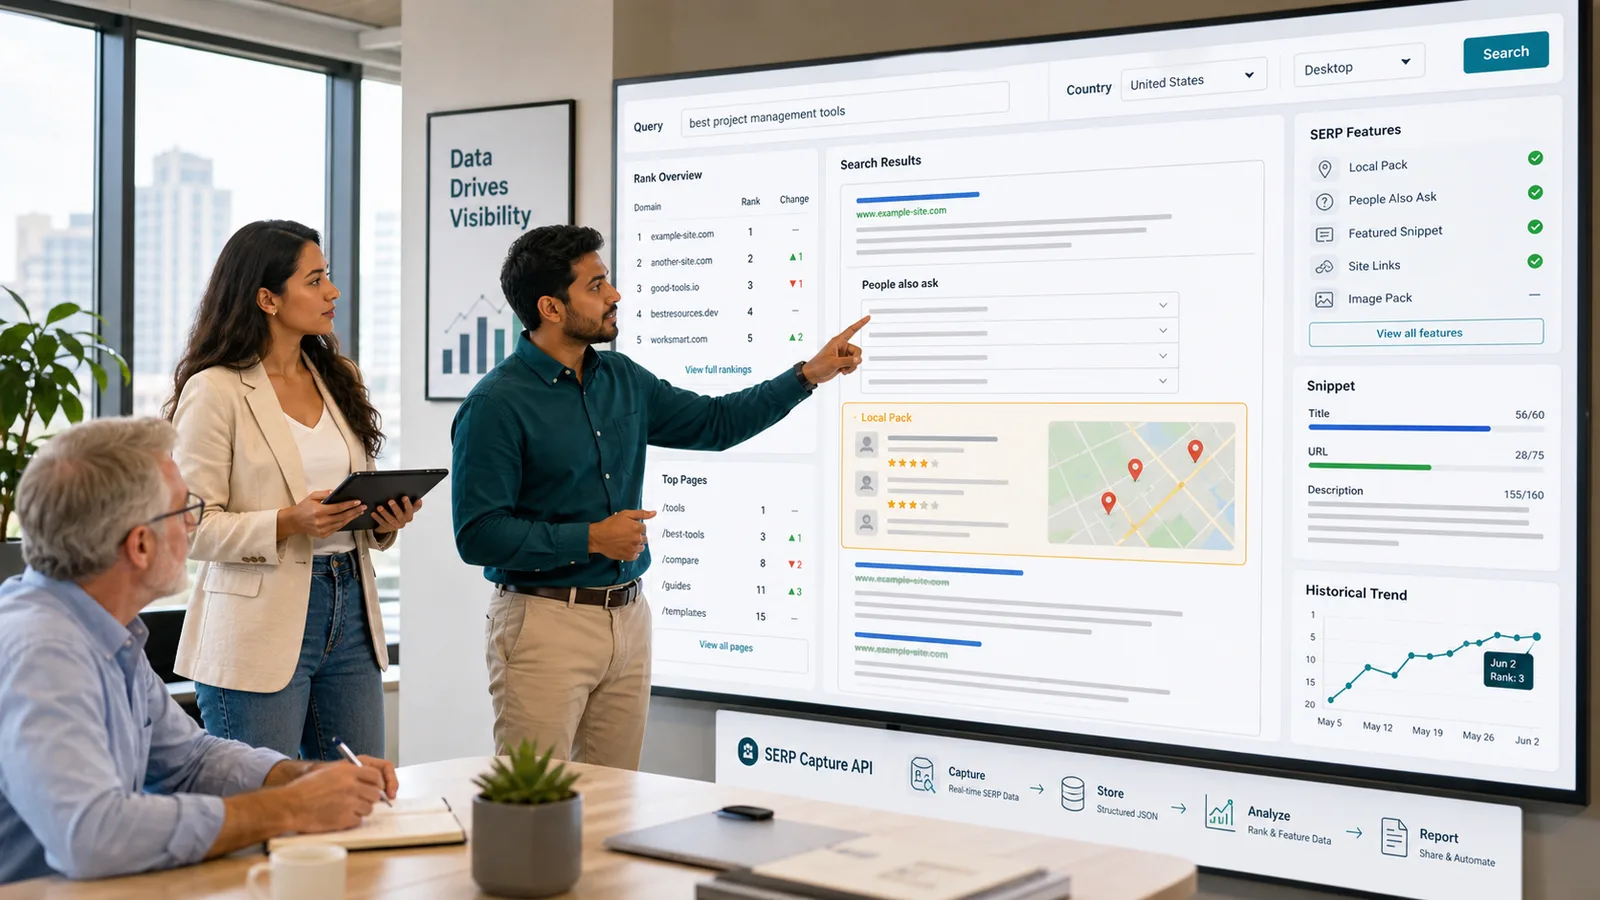
ScraperFly надає командам SEO, аналітики та ринкової видимості надійний шар захоплення для публічних сторінок результатів пошуку. API отримує доказ сторінки, який потрібен вашій власній системі відстеження ранжування: запит, ринок, мова, контекст пристрою, URL-адреси результатів, фрагменти, оголошення, локальні пакети, модулі «Люди також запитують», часові мітки та стан відповіді за кожним зразком.
Це дозволяє зберігати межі чистими. ScraperFly не замінює трекер ранжування, базу даних ключових слів, панель SEO або систему сповіщень. Він допомагає вам послідовно захоплювати публічні докази SERP, а потім ваша власна система вирішує, як аналізувати позиції, зберігати історію, порівнювати конкурентів і звітувати про зміни.
Що таке API для захоплення даних про відстеження ранжування SERP?
API для захоплення даних про відстеження ранжування SERP отримує публічні сторінки результатів пошуку, щоб система SEO нижнього рівня могла аналізувати ранжування, функції результатів, фрагменти, URL-адреси та зміни з часом. API виконує роботу з захоплення: він надсилає публічний запит SERP, застосовує правильні контролі доставки, вибирає зручний формат відповіді та повертає докази, які ваша власна система парсера, складу або звітності може оцінити.
Цінність полягає в повторюваності. Відстеження ранжування є надійним лише тоді, коли один і той же запит захоплюється з одним і тим же ринком, мовою, пристроєм, маршрутизацією та припущеннями про рендеринг. Якщо ці припущення змінюються без попередження, зміна ранжування може бути викликана профілем запиту, а не фактичною сторінкою результатів.
Практичний висновок: спочатку захоплюйте SERP як доказ; розраховуйте ранжування, володіння функціями та статус звітності в системі, яка має ваші правила SEO.
Що повинно захоплюватися в робочому процесі відстеження ранжування SERP?
Один номер ранжування недостатній. Сучасні сторінки результатів поєднують органічні посилання, оголошення, виділені фрагменти, локальні пакети, пакети зображень, відео результати, сайдлінки, модулі «Люди також запитують», новинні модулі, блоки карт, одиниці покупок та інші видимі функції. Результат може займати ту ж органічну позицію, втрачаючи видимість, оскільки нова функція перемістила його нижче на сторінці. Інший результат може отримати видимість, оскільки він володіє фрагментом або з'являється в локальному модулі.
Для кожного зразка зберігайте запит, публічний URL-адресу SERP, країну, мову, контекст пристрою, часову мітку, фінальну URL-адресу, URL-адресу результату, заголовок, фрагмент, позицію, тип функції та докази відповіді. Для важливих рухів візуальне підтвердження допомагає людині підтвердити, чи відповідає макет сторінки проаналізованому результату.
| Докази | Чому це важливо | Вихід ScraperFly, який слід врахувати |
|---|---|---|
| Запит і ринок | Ранг не має сенсу без країни, мови та контексту пошуку | Маршрутизація країни, вибрані заголовки, метадані відповіді |
| URL-адреса органічного результату | З'єднує зміни позицій з ранжованою сторінкою | HTML або відрендерений HTML для парсерів |
| Заголовок і фрагмент | Пояснює, що бачили шукачі, а не лише де ранжувалася URL-адреса | HTML, текст або Markdown |
| Функції SERP | Оголошення, фрагменти, PAA, локальні пакети та зображення змінюють видиму можливість | HTML плюс скріншот для важливих зразків |
| Фінальна URL-адреса та статус | Допомагає діагностувати перенаправлення, блокування, відсутні сторінки результатів та зміни цілей | JSON метадані та діагностика запитів |
| Візуальне підтвердження макету | Підтримує аудити, звітування для клієнтів та ручний перегляд змін з великим впливом | Скріншот або PDF |
Чому контекст SERP має таке велике значення?
Результати пошуку можуть змінюватися залежно від країни, міста, мови, класу пристрою, часу, сигналів персоналізації, написання запиту, макету інтерфейсу та змішування функцій результатів. Публічна сторінка результатів, захоплена з одного ринку, може не відповідати сторінці, яку видно в іншому. Результат для настільного комп'ютера може не відповідати мобільному. Локальний пакет може зробити ту ж органічну позицію менш видимою. Виділений фрагмент може перемістити увагу вище традиційних синіх посилань.
Ось чому захоплення SERP повинно бути чітким щодо контексту. Якщо ваша система відстежує ранжування настільних комп'ютерів у Сполучених Штатах, зберігайте цей профіль запиту стабільним. Якщо ви порівнюєте локальні ринки, визначте кожен ринок окремо. Якщо групі запитів потрібні скріншоти, оскільки видимість макету має значення, зарезервуйте візуальне захоплення для цієї групи, а не перетворюйте кожне ключове слово на важкий візуальний запит.
Використовуйте цільове націлювання за країною, вибрані заголовки, сесії або рендеринг лише тоді, коли набір зразків доводить, що ці контролі потрібні для порівнянних публічних доказів SERP.
Коли відстеження ранжування повинно використовувати рендеринг або більш сильну доставку?
Деякі сторінки SERP можна аналізувати з вихідного HTML. Інші вимагають виконання браузера, часу, більш сильної маршрутизації або візуального захоплення, щоб зберегти корисний стан результату. Правильна відповідь полягає не в тому, щоб за замовчуванням активувати всі важкі контролі. Почніть з репрезентативних запитів, перевірте повернуту сторінку та класифікуйте, які групи запитів потребують якого профілю запиту.
Рендеринг може допомогти, коли модулі результатів збираються після виконання на фронтенді. Сильніша маршрутизація може допомогти, коли повторні захоплення пошуку повертають нестабільну доставку, блоки, перенаправлення або неповні сторінки. Скріншоти допомагають, коли видимий макет, оголошення, фрагменти, локальні пакети або спірні записи звітів потребують ручного перегляду.
Для рішень, специфічних для браузера, використовуйте API рендерингу JavaScript та API для скрапінгу безголового браузера. Для рішень щодо доступу та ескалації зберігайте повторно використовуваний блок анти-бота нижче як оперативний контрольний список.
Як команди повинні вибирати формат відповіді?
Виберіть формат відповіді залежно від подальшого використання. HTML зазвичай є найкращою відправною точкою для парсерів ранжування, оскільки він зберігає структуру результату, URL-адреси, заголовки, фрагменти, модулі та зв'язки розмітки. Текст або Markdown можуть допомогти аналітикам переглядати, що говорить сторінка. JSON метадані підтримують налагодження. Скріншоти та PDF зберігають видиму сторінку, коли докази макету мають значення.
Доросла система відстеження ранжування може використовувати більше ніж один вихід. Рутинні перевірки можуть аналізувати HTML. Зміни з великим впливом можуть прикріплювати скріншоти. QA робочі процеси можуть архівувати PDF. Дослідницькі завдання можуть порівнювати метадані відповіді, фінальну URL-адресу, статус та розмір відповіді, коли запит раптово втрачає всі результати.
| Потреба в відстеженні ранжування | Рекомендоване захоплення | Чому це працює | Коли цього слід уникати |
|---|---|---|---|
| Рутинне парсування позицій | HTML або відрендерений HTML | Зберігає структуру результату, URL-адреси, фрагменти та блоки функцій | Коли робочий процес потребує лише зручних для читання підсумків |
| QA ключових слів та перегляд аналітиків | Текст або Markdown | Полегшує сканування та порівняння копії результату | Коли структура DOM керує парсером |
| Діагностика збоїв | JSON метадані | Показує статус, фінальну URL-адресу, тип вмісту, розмір та контекст запиту | Коли розглядається як сам ранжований результат |
| Докази для клієнтів | Скріншот | Показує видимий макет SERP та розміщення функцій | Для кожної рутинної перевірки, коли машинного парсингу достатньо |
| Архів аудиту | Створює запис, який можна переглядати, захопленої публічної сторінки результатів | Коли легкі історичні дані достатні |
Як відстеження ранжування SERP може залишатися доступним?
Відстеження ранжування стає дорогим, коли кожне ключове слово, ринок і пристрій використовують найважчий профіль запиту. Простий запит для невеликого бренду в одному ринку може вимагати простого захоплення HTML. Конкурентний локальний запит може вимагати маршрутизації за країною та скріншотів. Нестабільна сторінка результатів може вимагати більш сильної доставки. Макет з великою кількістю JavaScript може вимагати рендерингу. Розглядати все це як один профіль марно витрачає бюджет і ускладнює розуміння збоїв.
Класифікуйте запити перед масштабуванням. Групуйте їх за ринком, пристроєм, складністю макету, важливістю функцій та вимогами до доказів. Зберігайте перевірки з низьким ризиком легкими, і додавайте візуальне або браузерне захоплення лише там, де це змінює рішення. Це відповідає моделі кредитування ScraperFly: почніть з зразків, підтверджуйте профіль запиту, а потім перемістіть повторювані перевірки до передбачуваного плану, коли обсяг роботи зрозумілий.
Використовуйте API Builder для тестування профілю та сторінку цін, коли ви знаєте суміш HTML, рендерингу, маршрутизації, скріншотів та PDF.
Які помилки роблять відстеження ранжування шумним?
Шумне відстеження ранжування часто виникає через порівняння зразків, які не були захоплені однаково. Запит, захоплений з одного ринку, не повинен порівнюватися з пізнішим зразком з іншого ринку, якщо це порівняння не є навмисним. Результат для настільного комп'ютера не повинен змішуватися з мобільним. Сировинне захоплення HTML не повинно порівнюватися з відрендерованим, локалізованим, зразком, що підтримується скріншотом, так ніби метод захоплення не змінився.
Ще одна помилка полягає в тому, що звітують про ранг без контексту функцій SERP. Результат на позиції три під оголошеннями, локальним пакетом та виділеним фрагментом не має такої ж видимості, як позиція три на простішій сторінці. Зберігайте достатньо доказів функцій, щоб пояснити, що означає ранг.
Практичний висновок: зміни рангу є корисними лише тоді, коли контекст запиту, профіль захоплення та видимі функції SERP є достатньо стабільними для порівняння.
З чого повинна почати команда?
Почніть з невеликого набору репрезентативних запитів. Включайте брендові терміни, конкурентні терміни, локальні терміни та терміни з великою кількістю функцій, якщо вони важливі для вашого ринку. Спочатку захоплюйте публічний SERP з легким профілем. Перевірте, чи містить HTML дані результату. Додавайте контекст країни, рендеринг, більш сильну маршрутизацію, скріншоти або PDF лише там, де докази вимагають їх.
Якщо профіль запиту підтверджено, підключіть вихід ScraperFly до вашого парсера, історії ранжування, складу, панелі, системи сповіщень або робочого процесу звітності. ScraperFly залишається шаром захоплення; ваша система SEO залишається джерелом логіки ранжування та бізнес-інтерпретації.









































