






ScraperFlyAPI веб-даних для AI

use cases

API для витягування даних продуктів з публічних сторінок продуктів

ScraperFly надає командам з продуктів, електронної комерції та каталогів надійний шар захоплення для публічних сторінок продуктів. Поверніть дані, зручні для парсера, перед тим, як системи нижнього рівня відобразять поля, нормалізують продукти, зіставлять SKU та збагачуватимуть каталоги.

Докази продукту

Захопіть сторінку продукту до того, як ваша логіка каталогу відобразить поля

Проекти з витягування даних про продукти не зазнають невдачі лише тому, що парсер пропустив селектор. Вони зазнають невдачі, коли шар захоплення повертає часткову сторінку, регіональний варіант, заблоковану відповідь, порожню оболонку JavaScript або візуальний стан, який ніхто не перевірив перед масштабуванням. ScraperFly надає командам з продуктів, електронної комерції та даних чистіший перший крок: захопити публічну сторінку продукту в форматі, який ваша система може насправді перевірити.

Використовуйте вихідний HTML, коли сторінка вже містить корисні поля, відрендерений HTML, коли код на стороні клієнта формує фінальний стан продукту, текст або Markdown, коли людські та AI робочі процеси потребують читабельного контенту, JSON метадані, коли важливі докази запиту, та скріншоти або PDF, коли QA потребує візуального підтвердження. Ваша логіка каталогу все ще відповідає за відображення полів, нормалізацію, відповідність SKU, видалення дублікатів та рішення щодо таксономії.
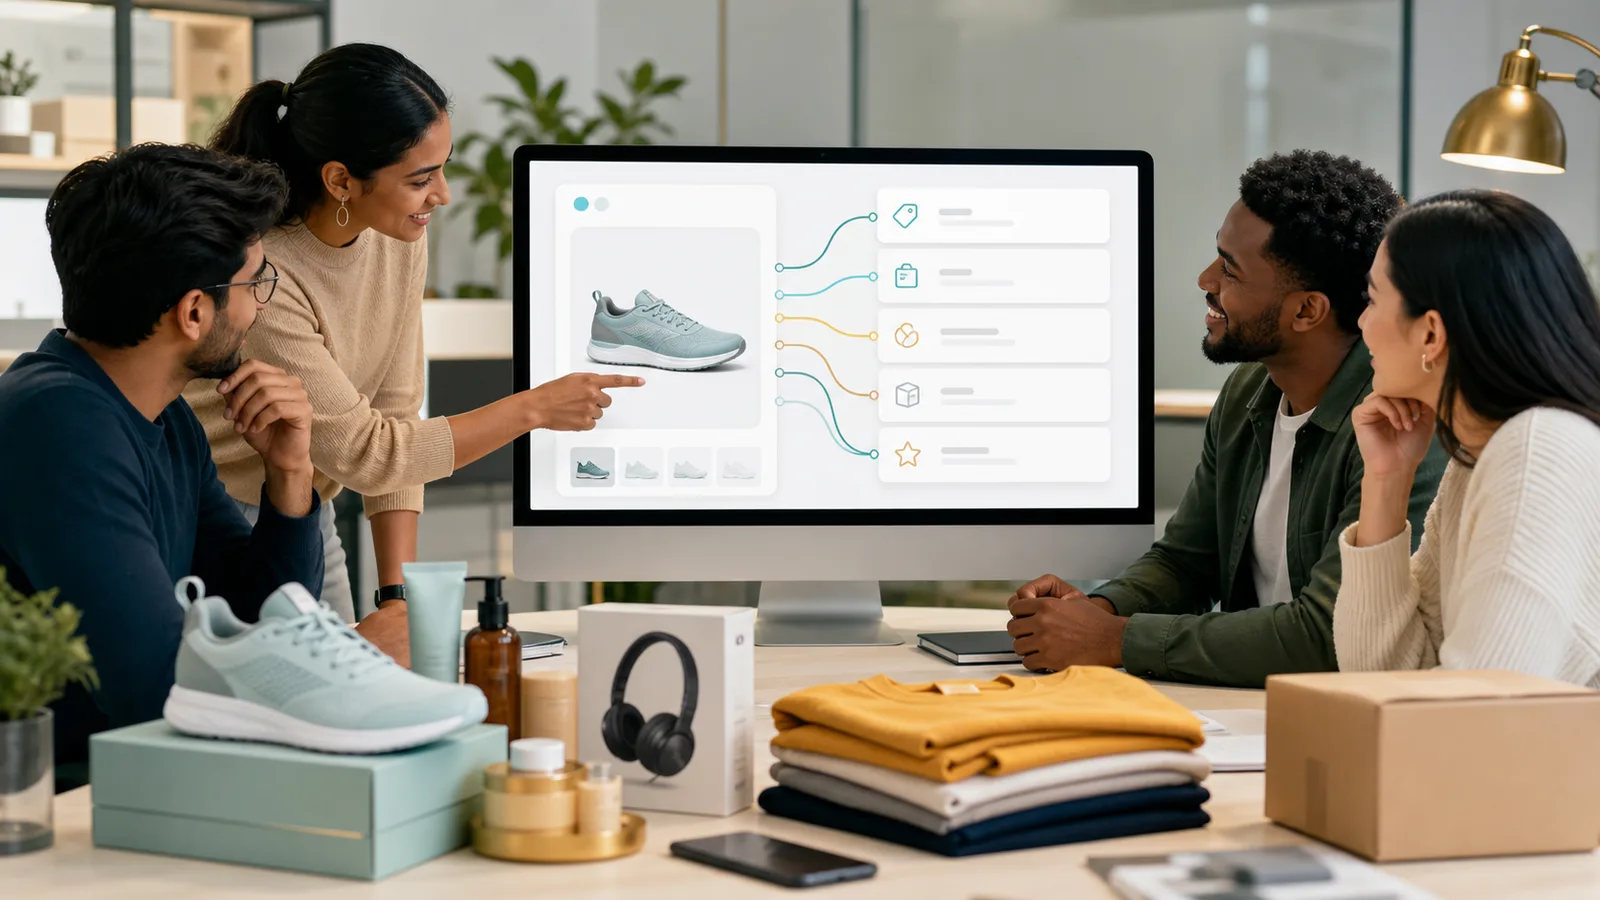
поля продуктуваріантидокази джерела
Команда каталогу переглядає захоплені докази публічної сторінки продукту перед відображенням полів продукту

Що таке API для витягування даних про продукти?

API для витягування даних про продукти - це шар запитів для захоплення публічних сторінок продуктів, щоб інша система могла перетворити докази сторінки на структуровані записи продуктів. Крок захоплення може повернути сирий HTML, відрендерений HTML, чистий текст, Markdown, метадані відповіді, скріншоти або PDF. Крок витягування на наступному етапі потім відображає ці докази в заголовки, бренди, SKU, ціни, доступність, варіанти, зображення, описи, специфікації, деталі продавця, відгуки, хлібні крихти та сигнали категорій.

Ця відмінність важлива. ScraperFly не позиціонується тут як магічний нормалізатор каталогу продуктів. Він надає вашому конвеєру докази на рівні сторінки, необхідні для створення надійних правил витягування та перегляду невдач. Це часто відсутній шар між крихким парсером і підтримуваним робочим процесом даних про продукти.

Практичний висновок: розглядайте ScraperFly як шар захоплення та доказів, а потім дозвольте вашій системі даних про продукти займатися відображенням полів, нормалізацією та правилами каталогу.

Які поля продукту повинні захоплювати команди?

Сторінки продуктів рідко відкривають кожне поле в одному акуратному місці. Заголовок може бути видимим у розмітці, ціна може бути відрендерована після JavaScript, варіанти можуть бути всередині вбудованих даних, запаси можуть залежати від регіону, а галереї зображень можуть поводитися по-різному в різних шаблонах. Перед написанням логіки витягування визначте, які поля важливі та який вихід дає найкращі докази для кожної групи полів.

Група полів Приклади Чому це важливо Вихід, який слід врахувати
Ідентичність продукту Заголовок, бренд, SKU, модель, GTIN, канонічна URL Ці поля закріплюють відповідність, видалення дублікатів, збагачення та оновлення каталогу. HTML, відрендерений HTML, JSON метадані
Комерційний стан Ціна, валюта, знижка, запас, доставка, продавець Ці поля часто змінюються залежно від регіону, сесії, варіанту або шаблону сторінки. Відрендерений HTML, скріншот, метадані
Варіанти Розмір, колір, комплект, кількість упаковки, вибраний варіант Логіка варіантів вирішує, чи одна URL представляє один продукт або багато записів. HTML, відрендерений HTML, скріншот
Контент Опис, пункти, специфікації, інгредієнти, розміри Читабельний контент живить пошук, збагачення, порівняння та QA робочі процеси. Markdown, текст, HTML
Візуальне підтвердження Галерея зображень, макет сторінки, значки, видима ціна, мітка доступності Людський перегляд потребує підтвердження, коли поля оскаржуються або візуально представлені. Скріншот, PDF

Чому сторінки продуктів потребують валідації джерела?

Витягування продуктів стає дорогим, коли команди пишуть правила парсера, перш ніж зрозуміти джерело сторінки. Публічна сторінка продукту може змінюватися залежно від категорії, продавця на ринку, доступності, стану куки, макету пристрою, мови, регіону або фронтенд-фреймворку. Вона також може повернути статус 200 з частковою сторінкою, екраном згоди, тимчасово порожньою оболонкою продукту або шаблоном, який виглядає схожим, але зберігає важливі поля десь ще.

Валідація джерела зберігає цей ризик видимим. Захопіть репрезентативний набір URL-адрес продуктів перед масштабуванням. Порівняйте сирий та відрендерений вихід. Перевірте фінальний URL, тип контенту, розмір відповіді та чи присутні цільові поля. Якщо поле відсутнє, вирішіть, чи захоплення неповне, цільовий варіант недоступний, регіон змінився, чи парсер шукає не в тому місці.

Це робить наступний крок практичним, а не дорогим. Ви можете додати JavaScript рендеринг лише для шаблонів продуктів, які потребують виконання браузера, зберігайте прості сторінки на HTML-скрапінгу, і резервуйте візуальні файли для QA, а не генеруйте скріншоти для кожного запиту, що виконується лише машиною.

Як команди повинні вибирати формат виходу?

Правильний формат залежить від того, хто споживає докази продукту. Парсер на основі селекторів потребує структури. Робочий процес збагачення контенту може віддати перевагу Markdown. Аналітику QA можуть знадобитися скріншоти. Моніторингова система може потребувати метаданих, фінальних URL, розміру відповіді та доказів статусу. Використання одного формату для кожного джерела продукту зазвичай створює додаткову роботу з очищення в іншій частині конвеєра.

Потреба на наступному етапі Найкращий формат захоплення Чому це працює На що звернути увагу
Витягування полів за допомогою селекторів Сирий або відрендерений HTML Зберігає структуру DOM, атрибути, посилання, таблиці та вбудовані дані. Не рендерити, якщо вихідний HTML вже має поля.
Опис продуктів та пункти Текст або Markdown Зменшує шум макету та надає читабельний контент для перегляду або AI робочих процесів. Може видалити зв'язки DOM, необхідні для точного витягування.
Діагностика запитів JSON метадані Показує операційні докази, такі як статус, фінальний URL, тип контенту та контекст відповіді. Метадані не замінюють витягування полів, специфічних для продукту.
QA та візуальне підтвердження Скріншот або PDF Зберігає, як виглядала сторінка продукту для людського перегляду або аудиторських записів. Візуальні файли важчі і не ідеальні як вхідні дані для парсера.
Збагачення каталогу HTML плюс Markdown або текст Поєднує структуровані докази сторінки з читабельним текстом для подальшої обробки. Зберігайте робочий процес зрозумілим, щоб кожен формат мав визначеного споживача.

Коли витягування продуктів повинно використовувати рендеринг, сесії або маршрутизацію?

Почніть з найменшого запиту, який повертає повні докази продукту. Додайте рендеринг, коли поля продукту з'являються лише після виконання браузера. Додайте затримки, коли відрендерена сторінка потребує часу для завантаження важливих розділів. Додайте заголовки, коли мова, тип контенту, агент користувача або інший дозволений контекст запиту змінює відповідь. Додайте сесії, коли пов'язані запити залежать від спільного стану, такого як вибір варіанту або безперервність у потоці продукту.

Використовуйте націлювання на країну, коли деталі продукту варіюються залежно від місця, валюти, мови, доступності, регіональних перенаправлень або поведінки місцевих продавців. Використовуйте більш сильну маршрутизацію, коли стандартна доставка неодноразово повертає заблоковані, неповні або нестабільні відповіді. Кожен контроль повинен відповідати конкретному спостереженню з цільового об'єкта, а не ставати глобальним за замовчуванням.

Для рішень, пов'язаних з контролем запитів, перегляньте кастомні заголовки, сесії та націлювання на країну. Мета полягає в тому, щоб зберегти прості сторінки продуктів доступними, надаючи складнішим джерелам навмисний шлях оновлення.

Що повинно залишитися на наступному етапі від ScraperFly?

Витягування продуктів не закінчується на захопленні. Ваша система на наступному етапі все ще повинна вирішити, як нормалізувати назви, відповідати SKU, об'єднувати варіанти, вирішувати дублікати продуктів, відображати категорії, перевіряти валюти, обробляти одиниці, ранжувати впевненість, зберігати медіа та узгоджувати суперечливі дані продавців. Це бізнес-правила, а не просто контролі скрапінгу.

Збереження цієї межі чіткою робить сторінку легшою для роботи. ScraperFly отримує публічні сторінки продуктів і повертає докази в корисних форматах. Ваш парсер, шар збагачення каталогу, PIM, моніторингова система або сховище даних потім перетворює ці докази на модель продукту, яка потрібна вашому бізнесу. Це розділення уникає надмірних обіцянок і робить невдачі легшими для налагодження: чи була сторінка захоплена неправильно, чи потрібно було відрегулювати правило витягування на наступному етапі?

З чого повинна почати команда продукту?

Почніть з невеликого набору зразків: одна проста сторінка продукту, одна сторінка з великою кількістю варіантів, одна сторінка без запасів, один шаблон, специфічний для категорії, і одне джерело, яке може вимагати рендерингу або контексту місця. Протестуйте кожну URL в API Builder, порівняйте формати виходу та вирішіть, який профіль запиту виробляє повні докази з найменшими витратами.

Якщо профіль захоплення підтверджено, масштабуйте по шарам. Зберігайте сирий HTML для сторінок, які відкривають поля в вихідній розмітці, додавайте відрендерений HTML лише там, де JavaScript змінює результат, і використовуйте скріншоти або PDF лише там, де людський перегляд потребує візуального підтвердження. Якщо робочий процес включає зміни цін або доступності з часом, з'єднайте цю сторінку з моніторингом цін і перегляньте ціни перед тим, як перетворити невеликі тести на повторювані виробничі завдання.


01 / Схема витягу

Підтвердіть форму відповіді в одному API-відправнику, перш ніж масштабувати скрапінг на тисячах URL-адрес

Перед великим експортом виконайте один реальний запит ScraperFly в Postman, Insomnia, Hoppscotch, Bruno, Thunder Client, curl або будь-якому API-відправнику, який ваша команда вже використовує. Додайте API-ключ, цільову URL-адресу, метод, формат виходу та параметри доставки, а потім порівняйте очікуваний результат з отриманою відповіддю. Якщо зразок повертається як неправильний артефакт, відсутні поля, заблокований контент, порожній HTML або невідповідність для конкретного регіону, налаштуйте HTML, текст, Markdown, PDF, JSON, рендеринг, країну, преміум-проксі, заголовки, сесії, затримки або повтори, поки відповідь не буде готова стати профілем партії.

Один перевірений запитОчікуване проти отриманогоФормат підтвердженоГотовий до масштабування
Чистий відправник API запитів з API ключем, методом, URL, форматом виходу та контролем відправки

01 / Відправник запитів

Почніть в інструменті, який ваша команда вже використовує для тестування API

Відкрийте Postman, Insomnia, Hoppscotch, Bruno, Thunder Client, curl або будь-який відправник, який може виконувати GET, POST та PUT запити. Суть не в інструменті; суть у тому, щоб виконати точний профіль запиту один раз, перш ніж він стане пакетним завданням.

PostmanInsomniaHoppscotchBrunoThunder Clientcurl
Очікуваний результат у порівнянні з отриманим результатом, поки формат виходу, преміум-проксі, країна та налаштування рендерингу налаштовані

02 / Очікуване vs отримане

Налаштуйте запит, поки отриманий вихід не відповідатиме очікуваному результату

Перемикайтеся між HTML, чистим текстом, Markdown, PDF, JSON або знімком екрана та перевіряйте, що повертається. Якщо відповідь неповна, налаштуйте рендеринг, преміум-проксі, країну, заголовки, сесії, затримки або повтори, поки зразок не дасть артефакт даних, необхідний для вашого робочого процесу.

  • Чи відповідає тип вмісту робочому процесу?
  • Чи присутні та читабельні обов'язкові поля?
  • Чи змінює країна або преміум-проксі результат?
  • Чи виробляє рендеринг відсутній вміст сторінки?
Валідований зразок запиту, що масштабується в файли, записи бази даних та результати автоматизації

03 / Масштабувати лише після підтвердження

Перетворіть валідований зразок на повторюваний профіль витягування

Якщо одна URL-адреса повертає правильний артефакт, використовуйте ті ж налаштування запиту для більшого набору URL-адрес. Це дозволяє зберігати пакетні завдання, прив'язані до відомого профілю, замість того, щоб виявляти помилки формату, маршрутизації або рендерингу після тисяч запитів.

Експорт пакетівЗаписи бази данихАвтоматизаціїДокази QA
Підходить ScraperFly

Один перевірений профіль для експорту в продукцію

Перевірте одну ціль, налаштуйте параметри доставки, а потім повторно використовуйте цей профіль для партій, експорту та автоматизацій.

Тестування, зручне для відправника

Використовуйте той же кінцевий пункт з Postman, Insomnia, Hoppscotch, Bruno, Thunder Client, curl, бекенд-коду або запланованих завдань.

Вибір виходу, що має значення

Поверніть HTML, чистий текст, Markdown, PDF, JSON, скріншоти та метадані в залежності від того, що споживає подальший робочий процес.

Контроль доставки за потреби

Додайте рендеринг, країну, преміум-проксі, заголовки, сесії, затримки та повтори, коли зразок відповіді підтверджує, що вони потрібні.

Масштабування з відомого запиту

Перейдіть від однієї перевіреної відповіді до партій, експорту, бази даних та автоматизацій з меншими сюрпризами.

Робочий процес даних про продукти

Захоплюйте докази продукту, яким можуть довіряти каталоги, монітори та інструменти дослідження на наступному етапі

ScraperFly допомагає командам збирати публічні сторінки продуктів, перевіряти форму відповіді та вибирати HTML, текст, Markdown, JSON-орієнтовані метадані, скріншоти або PDF залежно від того, як дані будуть переглядатися та нормалізуватися.

Комерція

Перетворюйте публічні комерційні сторінки на інтелект у сфері цін і запасів

Відстежуйте ціни конкурентів, зміни запасів, продавців, пропозиції на ринку, тарифи на подорожі та зміни в каталогах до того, як вони вплинуть на дохід.

Ноутбук з аналітичними графіками для моніторингу цін
Комерція

Моніторинг цін в електронній комерції

Слідкуйте за цінами конкурентів, знижками, статусом запасів, умовами доставки та рухом продавців, щоб команди з ціноутворення могли реагувати до того, як зміни на ринку стануть невидимими.

Useful fields: ціна, знижка, запас, продавець, доставка

Людина, що переглядає продукти на смартфоні
Комерція

Збагачення каталогу продуктів

Заповнюйте відсутні назви, описи, специфікації, зображення, варіанти та ідентифікатори з публічних сторінок продуктів та каталогів виробників.

Useful fields: назва, опис, технічні характеристики, зображення, SKU

Великий складський прохід, що представляє операції на ринку
Комерція

Інтелект продавців на ринку

Порівняйте присутність продавців, моделі виконання, глибину асортименту, рейтинги та зміни пропозицій на різних ринках.

Useful fields: продавець, рейтинг, пропозиція, виконання, асортимент

Складський працівник, що організовує полиці з інвентарем
Комерція

Відстеження інвентарю та доступності

Виявляйте нестачу товарів, доступність збору, регіональний інвентар, обіцянки доставки та прогалини в доступності продуктів до того, як це зроблять клієнти.

Useful fields: запас, регіон, збір, доставка, мітка часу

Особа з покупками перевіряє смартфон
Комерція

Захист бренду

Знайдіть несанкціонованих продавців, підозрілі ціни, сигнали підробки, неправильні заяви про продукти та ризикові оголошення на публічних ринках.

Useful fields: продавець, ціна, заяви, зображення, ринок

Зайнята сцена ресторану та гостинності на вулиці
Комерція

Моніторинг подорожей та гостинності

Збирайте інформацію про наявність номерів, ціни, зручності, умови скасування, сигнали місцевого попиту та контекст відгуків на різних платформах бронювання.

Useful fields: ціна, наявність, зручності, політика, рейтинг

Телефон, що показує інтерфейс онлайн-шопінгу
Комерція

Оголошення та відстеження вживаних товарів

Моніторте нові оголошення, запитувані ціни, активність продавців, стан товару, місцезнаходження та вік оголошення на ринках перепродажу.

Useful fields: перелік, ціна, стан, продавець, місцезнаходження

Ноутбук, що показує фінансові графіки та аналітику
Комерція

Порівняння цін та перепризначення

Перетворюйте знімки цін конкурентів на дані для перепризначення, прогалини в асортименті, сповіщення про маржу та звіти про ринкову позицію.

Useful fields: конкурент, ціна, ранг, наявність, зміна

Зростання

Знайдіть сигнали попиту до того, як вони з'являться у вашій власній аналітиці

Моніторте результати пошуку, рекламу, сторінки конкурентів, бізнес-довідники, активність найму та сигнали попиту, щоб побачити, куди переміщується увага.

Ноутбук, що відображає інформаційну панель аналітики для моніторингу SEO
Зростання

Моніторинг SERP та SEO

Відстежуйте ранжування, фрагменти, рекламу, локальні пакети, мову, пристрій та гео-відмінності, щоб бачити, як змінюється видимість у реальному пошуковому середовищі.

Useful fields: ранг, URL, фрагмент, реклама, гео

Ноутбук відкритий на новинній або контентній сторінці
Зростання

Моніторинг контенту конкурентів

Слідкуйте за змінами на сторінці, заголовками, CTA, схемою, внутрішніми посиланнями та інвентаризацією контенту без очікування на ручні аудити.

Useful fields: заголовок, CTA, схема, посилання, оновлений текст

Руки тримають телефон з контентом соціальних мереж
Зростання

Інтелект реклами

Збирайте публічні рекламні тексти, креативні шаблони, цільові сторінки, регіони, час та активність рекламодавців для дослідження кампаній.

Useful fields: текст, креатив, цільова сторінка, регіон, дата

Бізнесмени обмінюються документами в офісі
Зростання

Генерація лідів та збагачення компаній

Створюйте списки акаунтів та збагачуйте записи компаній доменами, місцезнаходженнями, галузями, публічними контактами, сигналами найму та технологічними підказками.

Useful fields: компанія, домен, галузь, місцезнаходження, сигнали

Магазин кави в маленькому місцевому магазині
Зростання

Дані місцевого бізнес-довідника

Збирайте імена, категорії, адреси, години роботи, вебсайти, рейтинги та кількість відгуків з публічних довідкових сторінок.

Useful fields: ім'я, категорія, адреса, години, рейтинг

Офісні працівники, які переглядають професійні документи
Зростання

Аналітика ринку праці

Відстежуйте назви посад, навички, діапазони зарплат, рівень старшинства, політики віддаленої роботи та швидкість найму на кар'єрних сторінках та сайтах з вакансіями.

Useful fields: назва, зарплата, навички, місцезнаходження, рівень старшинства

Голос

Перетворюйте публічні розмови на сигнали продукту та репутації

Збирайте відгуки, згадки в медіа, обговорення в спільнотах, публічні пости та сигнали творців, щоб зрозуміти, що говорять клієнти та ринки.

Особа, яка читає газету, працюючи на ноутбуці
Голос

Моніторинг новин та медіа

Збирайте статті, авторів, дати, теми, сутності, посилання та метадані джерел для робочих процесів репутації, досліджень та сповіщень.

Useful fields: назва, автор, дата, джерело, суб'єкти

Люди, які разом купують і перевіряють смартфон
Голос

Відстеження відгуків та настроїв

Збирайте тенденції оцінок, теми скарг, патерни похвали, відповіді бізнесу та контекст продукту-локації з публічних відгуків.

Useful fields: рейтинг, відгук, тема, відповідь, дата

Людина, яка переглядає додаток соціальних мереж на смартфоні
Голос

Моніторинг соціальних та публічних веб-ресурсів

Моніторте публічні пости, залучення, хештеги, часові мітки та контекст профілю, де це дозволяє політика та доступ до джерел.

Useful fields: пост, залучення, хештег, профіль, час

Особа читає новинні статті в кімнаті
Голос

Інтелект спільноти та форумів

Знайдіть повторювані запитання, скарги, запити на функції та проблемну мову з публічних спільнот і форумів підтримки.

Useful fields: запитання, тема, скарга, кількість відповідей, дата

Робочий простір з ноутбуком, кавою та газетою
Голос

Виявлення творців та впливових осіб

Створюйте списки виявлення з публічних профільних сторінок, тем контенту, сигналів аудиторії, частоти публікацій та сигналів співпраці.

Useful fields: профіль, тема, сигнал аудиторії, частота, посилання

Записи

Зробіть публічні записи та оголошення легшими для моніторингу в масштабах

Витягніть тендери, юридичні повідомлення, подання, фінансові дані та оголошення про нерухомість у джерельні набори даних, які команди можуть шукати, порівнювати та переглядати.

Професіонали, які обмінюються бізнес-документами
Записи

Державні закупівлі та тендери

Відстежуйте покупців, бюджети, терміни, вимоги, вкладення, нагороди та зміни на порталах тендерів та публічних оголошеннях.

Useful fields: покупець, бюджет, термін, вимоги, нагорода

Професіонали, які обговорюють юридичні документи в офісі
Записи

Регуляторний та юридичний моніторинг

Моніторте оголошення, публічні реєстри, дати набрання чинності, версії документів, задіяні суб'єкти та зміни, що стосуються відповідності.

Useful fields: оголошення, суб'єкт, дата, документ, статус

Професіонали, які переглядають фінансові документи
Записи

Фінансові та публічні ринкові дослідження

Збирайте подання, розкриття, таблиці, новини, метадані інструментів та публічний фінансовий контекст для дослідницьких pipeline.

Useful fields: подання, таблиця, емітент, дата, метрика

Ключі від будинків та готівка для даних ринку нерухомості
Записи

Списки нерухомості та дані ринку

Відстежуйте ціни на списки, адреси, атрибути власності, деталі агентів, статус, історію та контекст району.

Useful fields: ціна, адреса, ліжка, агент, статус

Продукти даних

Створюйте продуктові дані з веб-сторінок, а не з дампів сторінок

Очищайте, нормалізуйте, перевіряйте, збагачуйте, порівнюйте та доставляйте публічні веб-дані в бази даних, інформаційні панелі, сповіщення та LLM pipeline.

Екран ноутбука з кодом програмування
Продукти даних

Потоки веб-даних, готові до LLM

Перетворюйте публічні сторінки на чистий текст, Markdown, частини, метадані, цитати та сигнали свіжості для отримання або робочих процесів моделей.

Useful fields: чистий текст, Markdown, частина, URL джерела, мітка часу

Серверні стійки дата-центру для робочих процесів бази даних
Продукти даних

Структуроване вилучення в базу даних

Перетворюйте HTML, PDF, таблиці та текст сторінок на типізовані записи, які можна зберігати, запитувати, об'єднувати та перевіряти пізніше.

Useful fields: JSON, тип, джерело, схема, ID запису

Ноутбук з інтерфейсом кодування та аналізу даних
Продукти даних

Виявлення змін та сповіщення

Порівнюйте знімки та сповіщайте команди, коли змінюються ціни, запаси, рейтинг, вміст, статус або регуляторна мова.

Useful fields: попереднє значення, нове значення, дельта, поріг, сповіщення

Екран комп'ютера з кольоровим кодом і даними
Продукти даних

Збагачення та нормалізація сутностей

Нормалізуйте ідентифікатори продуктів, назви компаній, локації, людей, категорії, одиниці, валюти та відображення таксономії.

Useful fields: суб'єкт, канонічний ID, категорія, одиниця, довіра

Крупний план серверного стелажа з синіми індикаторами
Продукти даних

Валідація якості даних

Перевірте обов'язкові поля, типи даних, діапазони, дублікати, джерела доказів та підозрілі записи перед подальшим використанням.

Useful fields: обов'язкове поле, тип, діапазон, доказ, довіра

Ноутбук з редактором коду для звітності даних
Продукти даних

Звіти та панелі інформації

Заповнюйте BI панелі, ринкові звіти, операційні картки оцінок та регулярні аналізи веб-даними, які оновлюються за розкладом.

Useful fields: метрика, вимір, період, джерело, оновлення

Чому ScraperFly

Приймайте рішення про витягування на основі реальних доказів сторінки, а не припущень

Вихідний HTML, відрендерений HTML, читабельний контент, метадані та візуальні докази допомагають відрізнити відсутні дані про продукти від прогалин парсера, регіональних варіантів або заблокованих відповідей.

  • Заповнюйте прогалини, залишені APIБагато джерел відкривають корисні публічні сторінки, але немає повного API для точних полів, гео, фільтрів або історій, які потрібні команді.
  • Моніторинг змін з часомРегулярні збори створюють історію цін, контенту, доступності, рейтингів, відгуків, повідомлень та руху на ринку.
  • Порівняти між джереламиЗбирання даних робить можливим порівняння між сайтами, коли ринки, каталоги, портали та видавці структурують дані по-різному.
  • Створити придатні записиКорисний вихід - це не вивантаження сторінки; це джерельний, з позначкою часу, нормалізований запис, якому можуть довіряти системи нижнього рівня.
Найкраще підходить

Корисно для збагачення каталогу, дослідження продуктів, відстеження цін, моніторингу запасів та аналізу ринку

Команди можуть почати з кількох джерел, перевірити якість полів і додати важчі контролі запитів лише там, де сторінки продуктів їх потребують.

Один API для різних джерел

Використовуйте один і той же шаблон інтеграції для магазинів, сторінок пошуку, каталогів, документів, публічних списків та конвеєрів даних.

Контроль доставки за потреби

Рендеринг, сесії, заголовки, гео та маршрутизація проксі можуть бути додані для цілей, які їх потребують, без перебудови робочого процесу.

Вихід, що підтримує подальшу обробку

HTML, скріншоти, чистий текст, Markdown та структуровані шляхи витягування допомагають командам переходити від отримання сторінок до придатних записів.

Менше інфраструктури для скрейпінгу, якою потрібно володіти

Команди можуть зосередитися на полях, валідації, свіжості та бізнес-логіці, а не на флотах браузерів, маршрутизації крайових випадків та повторних спробах.

Поведение джерела продукту

Перевірте варіанти, шаблони, JavaScript та правила ринку перед масштабуванням витягування

Сторінки продуктів можуть варіюватися залежно від категорії, продавця, регіону, запасу, мови, пристрою, стану куки та рендерингу фронтенду. Вибір реальних цілей зменшує крихку логіку витягування.

Сирова HTML-відповідь, відображена на видимих даних сторінки
01

Доступність сирого HTML

Перевірте, чи поля, які вам потрібні, вже присутні в першій HTML-відповіді.

Найкращий перший тест для простих сторінок, статей, документів, списків та деталей продуктів.

Порівняння до і після рендерингу JavaScript
02

Залежність від JavaScript

Порівняйте сирий HTML з відрендереним DOM або скріншотом перед увімкненням рендерингу браузера.

Використовуйте рендеринг, коли сирий HTML є лише оболонкою, а скрипти створюють корисний контент.

Куки, згода, контекст сесії та доступу для скрапінгу
03

Стан і контекст доступу

Визначте, чи впливають куки, згода, межі входу, пагінація або той самий стан відвідувача на відповідь.

Використовуйте сесії та заголовки, коли безперервність змінює дані, які ви отримуєте.

Регіональні варіації контенту в різних країнах і маршрутах
04

Гео/варіація контенту

Перевірте, чи змінюють країна, мова, валюта, інвентар, SERP, реклама або репутація маршруту результат.

Використовуйте гео- або преміум-маршрути лише тоді, коли ціль підтверджує, що відповідь змінюється залежно від маршруту.

Перевірки перед витягуванням даних про продукти

Де знаходиться цільове поле?

Знайдіть, чи існує поле в сирому HTML, відрендереному DOM, виклику API, структурованих даних, файлі або пізнішому стані взаємодії.

Що змінює відповідь?

Виберіть кілька URL-адрес і порівняйте статус, фінальну URL-адресу, довжину вмісту, перенаправлення, порожні стани та видимі відмінності результатів.

Який контекст потрібен?

Позначте будь-яку залежність від згоди, локалі, куків, заголовків, межі аутентифікації, пагінації, фільтрів або попередніх запитів.

Як виглядає невдача?

Визначте сигнали для заблокованих, часткових, застарілих, перенаправлених, порожніх, з тайм-аутом або регіонально невідповідних відповідей перед масштабуванням.

Як сторінки продуктів змінюють налаштування витягування

Режим отримання

Доступність сирого HTML визначає, чи може перший запит залишатися простим або потребує рендерингу, очікувань, скріншотів або витягування.

Контекст запиту

Вимоги до стану визначають, чи потрібно додавати заголовки, куки, сесії, обробку згоди або стабільний профіль відвідувача.

Вибір маршруту

Гео та репутаційні дані визначають, чи достатньо стандартного маршруту або виправданий маршрут країни/преміум.

Правила валідації

Відомі стани невдачі стають перевірками для повторних спроб, ескалації, перевірки якості та визначення, коли легший профіль все ще є повним.

Конструктор запитів на продукти

Створюйте запити на витягування продуктів з правильним виходом для кожного джерела

Використовуйте HTML для парсерів на рівні полів, текст або Markdown для читабельних описів, метадані, орієнтовані на JSON, для збагачення, а також скріншоти або PDF, коли потрібно підтвердити стан сторінки.

SKU
Поля

Збирайте факти про продукт, які мають значення

Назви, SKU, бренди, ціни, стани запасів, варіанти, зображення, описи, характеристики, відгуки та деталі продавців потребують валідації джерела перед тим, як стати полями каталогу.

SKUцінаваріанти
DOM
Форма джерела

Порівняйте джерело та відрендерений контент перед написанням правил

Дані про продукт можуть бути в розмітці, скриптах, відрендереному DOM, метаданих або повторюваних візуальних компонентах. Порівняйте виходи перед тим, як закріпити логіку парсера.

htmlрендерингметадані
QA
Підтвердження

Використовуйте візуальне захоплення, коли для витягування потрібна людська впевненість

Скріншоти та PDF допомагають рецензентам перевіряти сторінки продуктів, відображення цін, стани запасів, вибір варіантів, значки та макет сторінки, коли машинозчитувані докази недостатні.

скріншотpdfвідгук

Елементи управління, які формують витягування даних продукту

url

Публічна сторінка продукту, категорії або ринку, що захоплюється.

format

Форма виходу для витягування, збагачення, перевірки або візуального підтвердження.

render

Виконання в браузері, коли дані продукту з'являються після JavaScript.

premium

Сильніший маршрутизація для джерел продуктів, які чинять опір простому захопленню.

приклад cURL

Генеруйте Markdown з тією ж формою запиту, яку ви можете перенести в продукцію

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Обробка помилок

Перетворіть збої в скрапінгу на виправлення

Кожен робочий процес веб-даних зрештою стикається з поганою відповіддю: відсутній URL, недійсний ключ, порожня HTML оболонка, ціль 403, обмеження швидкості, тайм-аут рендерингу, зламане захоплення PDF або JSON навантаження, яке не містить полів, які очікував ваш продукт. ScraperFly створено для того, щоб ці моменти були діагностованими. Ви перевіряєте HTTP статус, стабільний код помилки, профіль запиту та повернутий артефакт, а потім вибираєте найдешевший корисний наступний крок: виправити запит, додати кредити, уповільнити, повторити з відкатом, увімкнути рендеринг, змінити країну, використовувати преміум маршрутизацію, зберегти заголовки або валідувати вихід перед масштабуванням.

Стабільна форма помилкиРішення про повторенняЕскалація з урахуванням витратВалідація виходу
Розробник переглядає код та параметри запиту API на ноутбуці

01 / Налаштування запиту та доступ

Спочатку виправте помилки запиту

Деякі збої не є проблемами цільового запиту. Вони відбуваються до того, як ScraperFly зможе зробити значну спробу доставки: відсутня або неправильно сформована URL-адреса, непідтримуваний формат виводу, несумісний тип візуального файлу, відсутній API-ключ, недійсний ключ або ключ, який було призупинено або вимкнено. Ці помилки є сигналами конфігурації, а не сигналами повторної спроби: зупиніть робочий процес, вкажіть розробнику точне поле, яке потребує виправлення, і зосередьте кредити на реальних цільових тестах замість повторних неправильних введень.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Перевірте URL-адресу та кодування перед відправкою партії.
  • Використовуйте підтримувані формати виводу: HTML, текст, Markdown, JSON, скріншот або PDF.
  • Відповідайте типам файлів скріншотів типам зображень виводу та типу файлу PDF типу виводу PDF.
  • Розглядайте відсутні або недійсні API-ключі як конфігураційну роботу, а не роботу з повторними спробами.
Бізнес-дашборд з графіками, документами та плануванням використання на столі

02 / Кредити, ліміти та паралельність

Відокремте ліміти від збоїв

Робоче навантаження може зазнати невдачі, оскільки на рахунку немає доступних кредитів, досягнуто ліміту місячного плану або одночасність занадто агресивна для поточного плану та цільового міксу. ScraperFly робить ці обмеження видимими як операційні сигнали, а не таємничі збої при скануванні. Це робить рішення про покупку практичним: почніть безкоштовно, протестуйте ціль, купуйте кредити за принципом pay-as-you-go для нерівномірних завдань, переходьте на місячні кредити, коли обсяг стає передбачуваним, і використовуйте зниження навантаження, коли тиск запитів є реальною проблемою.

usage_limit_reachedrate_limitedcreditsbackoff
  • Використовуйте статус облікового запису, щоб перевірити залишкові кредити перед великими запитами.
  • Повторюйте ліміти запитів з backoff замість того, щоб відразу збільшувати навантаження.
  • Тримайте одноразові проекти на оплаті за фактом, коли обсяг нерівномірний.
  • Перенесіть передбачувану повторювану роботу на щомісячні кредити, коли шаблон доведено.
Серверна кімната, що представляє шляхи доставки, маршрутизацію та мережеву інфраструктуру

03 / Цільова доставка та мережа

Спочатку знайдіть збої доставки

Багато платформ для скрапінгу об'єднують проблеми доставки в невизначений збій запиту. У виробництві цього недостатньо. Команда повинна знати, чи вичерпався час запиту, чи повернулася тимчасова помилка сервера з цільового ресурсу, чи з'єднання не вдалося, чи відповідь була занадто великою, чи перенаправлення пішли кудись не туди, чи повернулася сторінка як маленький HTML без корисного контенту. ScraperFly перетворює ці збої на докази доставки: спочатку спробуйте легкий профіль, порівняйте статус і розмір відповіді, а потім виріште, чи потрібно наступному запиту backoff, інший маршрут, преміум-проксі, цільова країна або більш вузьке захоплення.

timeout5xxперенаправленняresponse_too_large
  • Повторюйте тимчасові мережеві та верхні збої з контрольованою політикою backoff.
  • Порівняйте фінальний URL, статус, тип контенту та розмір відповіді між зразками.
  • Ескалюйте маршрутизацію лише тоді, коли відповідь доводить, що простий шлях нестабільний.
  • Розглядайте надмірні відповіді як проблему обсягу перед масштабуванням того ж профілю.
Екран цифрової безпеки, що представляє сигнали захисту від ботів та захищеного доступу

04 / Захист від ботів, гео та блоки доступу

Читати блоки перед ескалацією

Екран цільового 403, 401, 429, CAPTCHA, WAF challenge, стіна входу, цикл згоди або регіональна невідповідність - це не просто помилка; це підказка про те, що сайт очікує від відвідувача. Конкуренти часто підштовхують команди до важчого профілю за замовчуванням, але це може витратити бюджет без доведення виправлення. Кращий шлях ScraperFly - це ескалація на основі доказів: зберігайте реалістичні заголовки, коли контекст має значення, використовуйте сесії, коли безперервність змінює відповідь, увімкніть рендеринг, коли корисний контент створюється браузером, і вибирайте преміум або країнову маршрутизацію, коли репутація або географія змінюють результат.

403429CAPTCHAневідповідність країни
  • Використовуйте преміум маршрутизацію, коли репутація IP є доведеним вузьким місцем.
  • Використовуйте цільову маршрутизацію за країною, коли мова, валюта, інвентар або результати пошуку змінюються в залежності від ринку.
  • Використовуйте заголовки, куки та сесії, коли стан відвідувача змінює відповідь.
  • Зменшуйте одночасність і додавайте затримку, коли повторні запити викликають обмеження цілі.
Розробник готує код та артефакти виходу на ноутбуці

05 / Якість рендерингу та виходу

Відправляйте придатні артефакти

Статус 200 не є тим самим, що й придатний скрап. Сирий HTML може бути порожньою оболонкою програми, Markdown може пропустити основну статтю, JSON може не містити очікуваних метаданих, текст може містити шум, скріншоти можуть бути порожніми, а вихід PDF або зображення може зазнати невдачі, якщо крок браузера вичерпає час. ScraperFly є цінним, оскільки той самий запит API може переходити від сирого HTML до відрендереного DOM, чистого тексту, Markdown, JSON, скріншота або PDF, а потім перевірятися на відповідність артефакту, який насправді потрібен вашому продукту. Це зменшує кількість коду для з'єднання, невдалі імпорти та дорогі пакетні запуски, які виявляють поганий вихід лише після факту.

render_timeoutbrowser_render_failedполя JSONвихід PDF/зображення
  • Увімкніть рендеринг, коли сирий HTML є лише оболонкою, а корисний контент з'являється після JavaScript.
  • Перевірте текст, Markdown та JSON на відповідність очікуваним полям перед пакетною обробкою.
  • Використовуйте знімок екрану або PDF-формат, коли важливі візуальні докази або аудиторські свідчення.
  • Розглядайте порожні або часткові артефакти як невдачі якості, навіть коли статус HTTP успішний.
Підходить ScraperFly

Чистіша відновлення помилок

ScraperFly допомагає командам вирішити, що виправити, що повторити, а що ескалувати, не перетворюючи кожен запит на найдорожчий профіль запиту.

Стабільна форма помилки

Використовуйте HTTP статус і код помилки разом, щоб логіка програми могла вибрати між виправленням введення, оновленням облікових даних, уповільненням, повторенням або ескалацією доставки.

Повторюйте лише тоді, коли це допомагає

Мережеві збої, обмеження швидкості та тимчасові помилки сервера можуть використовувати відкат. Неправильні URL, непідтримувані формати та погані ключі слід виправити один раз.

Ескалація з урахуванням витрат

Почніть з легкого профілю запиту, а потім додавайте рендеринг, преміум маршрутизацію, країну, сесії, заголовки, затримки або візуальне захоплення лише тоді, коли невдача це підтверджує.

Валідація виходу перед масштабуванням

Підтвердіть реальний артефакт, який потрібен вашому продукту: HTML, текст, Markdown, JSON, скріншот або PDF, перш ніж копіювати той самий профіль на великий набір URL.

Часті запитання про продукти

Загальні питання про робочі процеси витягування даних продуктів

Витягування продуктів працює найкраще, коли команди перевіряють якість полів, поведінку джерела, формат виходу та потреби в підтвердженні перед масштабуванням по категоріях, магазинах або ринках.

Відповіді на запитання про продукти
Поля

Обсяг даних про продукт

Визначте, які факти про продукт важливі перед масштабуванням захоплення.

Чи нормалізує ScraperFly поля продуктів автоматично?

Ні. ScraperFly захоплює докази публічної сторінки. Витягування полів, нормалізація, відповідність SKU, картографування таксономії та моделювання каталогу належать до вашої системи даних про продукти.

Які поля продуктів може підтримувати робочий процес?

Команди зазвичай перевіряють заголовки, бренди, SKU, ціни, запаси, варіанти, описи, специфікації, зображення, деталі продавця, відгуки, хлібні крихти та сигнали категорій, коли ці поля присутні на захопленій сторінці.

Вихід

Вибір формату захоплення

Використовуйте формат, який найкраще підходить споживачу доказів.

Чи повинно витягування продуктів починатися з HTML?

Зазвичай так. Сирий HTML є найменш важким першим тестом, коли поля продуктів вже присутні в вихідному розмітці. Відрендерений HTML корисний, коли JavaScript формує стан продукту.

Коли корисні скріншоти або PDF?

Використовуйте візуальні файли, коли QA, відповідність або людський перегляд потребують доказів того, як виглядала сторінка продукту, включаючи видиму ціну, етикетки запасу, значки або вибір варіантів.

Поведение

Обробка варіацій сторінки продукту

Сторінки продуктів можуть змінюватися в залежності від шаблону, регіону, стану або продавця.

Чому поля продуктів зникають між зразками?

Поля можуть змінюватися через варіанти, правила продавця, регіон, стан запасу, макет пристрою, куки, таймінг JavaScript або відмінності в шаблонах. Порівняйте сирі та відрендерені виходи перед зміною правил парсера.

Коли мені слід використовувати сесії або таргетинг за країною?

Використовуйте сесії, коли пов'язані запити залежать від спільного стану. Використовуйте таргетинг за країною, коли ціна, доступність, мова, перенаправлення або поведінка продавця змінюються в залежності від місця.

Масштабування

Від зразкових сторінок до виробництва

Масштабуйте лише після того, як джерело доказів і вага запиту стануть зрозумілими.

Як мені перевірити робочий процес витягування продуктів?

Тестуйте репрезентативні сторінки продуктів, порівнюйте результати, підтверджуйте необхідні поля, перевіряйте помилки та документуйте, які контролі потрібні для кожного джерела або шаблону перед масштабуванням.

Як мені зберегти витрати на витягування продуктів передбачуваними?

Залишайте прості сторінки на сирому HTML, активуйте рендеринг лише там, де це змінює захоплений результат, і залишайте скріншоти, PDF, преміум маршрути або тривалі очікування для джерел, які доводять, що вони їх потребують.

































