






ScraperFlyAPI веб-даних для AI

developer api

HTML Parser API для веб-скрапінгу вихідних сторінок

Парсинг HTML працює найкраще, коли шар захоплення повертає правильне джерело. ScraperFly допомагає командам отримувати публічні сторінки у вигляді сирого HTML, коли присутній розмітка, або відрендереного HTML, коли JavaScript формує DOM, щоб подальші парсери могли працювати з перевіреними доказами відповіді.

Розмітка, готова до парсера

Отримуйте надійний HTML перед тим, як правила витягування залежать від нього

Парсер HTML настільки ж надійний, як і вихідний код сторінки, яку він отримує. Якщо запит повертає тонку оболонку, перенаправлення, заблоковану альтернативу або розмітку, яка з'являється лише після виконання JavaScript, селектори та правила витягування можуть не спрацювати, навіть якщо сам парсер правильний.

ScraperFly надає командам чистішу точку відліку: отримуйте публічні сторінки як сирий HTML, коли розмітка вже присутня, переходьте на відрендерений HTML, коли корисний DOM створюється браузером, і зберігайте докази відповіді, щоб рішення про парсинг базувалися на фактичному стані сторінки.
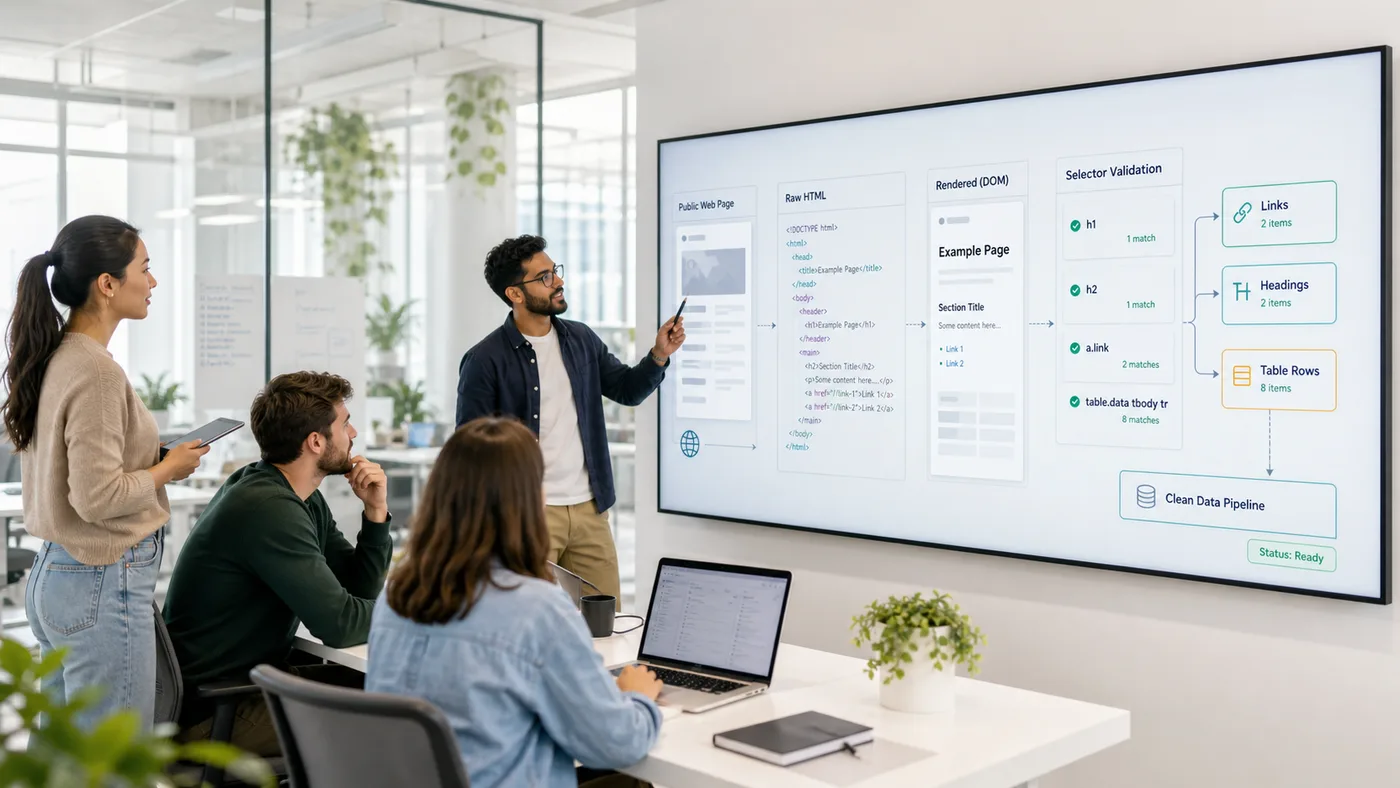
сирий HTML відрендерений DOM перевірки селекторів вхідні дані парсера
Інженерна команда перевіряє захоплений HTML перед правилами парсера для веб-скрапінгу

Що таке API парсера HTML для веб-скрапінгу?

Процес роботи API парсера HTML починається з отримання публічної сторінки та надання вашому додатку розмітки, яку він може перевірити. Парсер потім витягує посилання, заголовки, таблиці, метадані, картки продуктів, секції статей, пагінацію, вбудовані дані або інші елементи сторінки з цього захопленого джерела.

Практична проблема полягає не лише в парсингу. Це захоплення правильної версії сторінки перед початком парсингу. Деякі цілі відкривають корисну розмітку у початковій HTML-відповіді. Інші надсилають порожню оболонку програми та створюють DOM у браузері. Деякі повертають іншу сторінку в залежності від заголовків, куків, регіону або маршрутизації. ScraperFly обробляє цей шар захоплення, щоб ваш парсер міг працювати з перевіреною відповіддю, а не з крихкою клеєм браузера.

Практична порада: зберігайте правила витягування у власному конвеєрі, але дозвольте API надавати джерело доказів, на яких ці правила залежать.

Коли парсеру слід використовувати сирий HTML або відрендерений HTML?

Сирий HTML є найкращою відправною точкою, коли ціль надсилає корисну розмітку відразу. Він легший, швидший для перевірки та простіший для порівняння між зразками. Відрендерений HTML корисний, коли початкове джерело містить лише контейнер маршруту, скрипт гідратації, вузли-заповнювачі або контент, що завантажується пізніше, який з'являється після виконання браузера.

Рішення має бути специфічним для цілі, а не глобальним. Якщо кожна URL-адреса за замовчуванням проходить через браузер, робочий процес стає важчим, перш ніж команда дізнається, чи покращує рендеринг захоплене джерело. Кращим підходом є спочатку отримати HTML-джерело, порівняти його з очікуваними полями, а потім увімкнути рендеринг лише для сторінок, де парсер не може бачити потрібну розмітку.

Вхідні дані парсера Використовуйте, коли Головна перевага Важлива перевірка
Сирий HTML Початкова відповідь містить посилання, поля, таблиці або блоки контенту. Легкий і простий для налагодження. Підтверджуйте, що розмітка присутня перед написанням селекторів.
Відрендерений HTML JavaScript створює корисний DOM після завантаження відповіді джерела. Фіксує стан сторінки, створеної браузером. Використовуйте рендеринг лише тоді, коли він змінює відповідь.
Текст або Markdown Наступний робочий процес потребує читабельного контенту, а не відносин DOM. Чистіший вхід для перегляду контенту, пошуку та AI-робочих процесів. Не використовуйте, коли селектори або атрибути мають значення.
JSON метадані Додаток потребує контексту відповіді для ведення журналу, QA або рішень маршрутизації. Відкриває оперативні докази навколо захоплення. Це доповнює парсинг; це не замінює специфічні для цілі правила витягування.

Що команди повинні перевірити перед масштабуванням правил парсера?

Правила парсера часто виглядають стабільними на одному зразку, а потім ламаються на наборі URL. Виправлення полягає в перевірці форми відповіді перед масштабуванням: переконайтеся, що ті ж секції існують, очікувані посилання присутні, таблиці зберігають передбачувану структуру, пагінація видима, і відповідь не перенаправилася безшумно на інший тип сторінки.

ScraperFly допомагає, зберігаючи контролі запиту видимими. Ви можете порівнювати сирий і відрендерений вихід, зберігати фінальну URL-адресу та статус, перевіряти розмір відповіді та використовувати скріншоти, коли візуальні докази мають значення. Це робить невдачі селекторів легшими для діагностики: парсер може визначити, чи змінилася ціль, чи перемістилася розмітка, чи був потрібен JavaScript, або чи повернулося захоплення неправильною сторінкою.

Точка перевірки Чому це важливо Дія, безпечна для парсера
Очікуваний контейнер Парсеру потрібна стабільна секція для початку. Перевірте, чи містить сирий або відрендерений HTML контейнер.
Посилання та пагінація Багато сканувань зазнають невдачі, коли посилання на наступну сторінку відсутні або трансформуються. Перевірте href та елементи управління сторінками на зразках.
Таблиці та списки Дані можуть змінювати стовпці, мітки або вкладення між шаблонами. Порівняйте структуру перед відображенням полів.
Статус та фінальна URL Парсер може отримати стіну входу, сторінку перенаправлення або м'яку блокаду. Записуйте докази відповіді з кожним розібраним результатом.
Формат відповіді Парсинг DOM, споживання тексту та візуальний QA потребують різних виходів. Виберіть HTML, текст, Markdown, JSON, скріншот або PDF залежно від споживача.

Де ScraperFly вписується в конвеєр парсингу HTML?

ScraperFly знаходиться перед вашим парсером. Ваш додаток надсилає цільову URL-адресу та профіль запиту, а потім отримує форму відповіді, яку може використовувати ваш конвеєр: сирий HTML для парсингу джерела, відрендерений HTML для сторінок, створених браузером, чистий текст або Markdown для робочих процесів контенту, JSON метадані для діагностики або скріншоти та PDF для візуальних доказів.

Ця роздільність є цінною. Ваша команда зберігає контроль над селекторами, правилами витягування, валідацією, зберіганням та бізнес-логікою. ScraperFly обробляє шар отримання, рендеринг браузера, коли це дійсно потрібно, контекст сесії та заголовків, варіанти маршрутизації та формати відповіді. Результат - це чистіша межа між "отримати правильне джерело сторінки" та "витягнути дані, які нас цікавлять".

Для більш широкого огляду підтримуваних виходів порівняйте формати відповідей API для веб-скрапінгу. Щоб протестувати профіль запиту перед написанням виробничого коду, використовуйте публічний API Builder.

Як команди можуть підтримувати стабільність парсингу HTML у виробництві?

Парсинг у виробництві потребує доказів, а не лише селекторів. Зберігайте цільову URL-адресу, фінальну URL-адресу, статус, тип контенту, розмір відповіді, налаштування рендерингу, контроль часу та обраний формат виходу з кожним захопленням. Ці поля значно полегшують розділення помилок парсера від змін цілі, проблем доставки та прогалин у рендерингу JavaScript.

Коли парсер починає пропускати поля, уникайте негайного переписування логіки витягування. Спочатку перевірте, чи містить захоплена розмітка все ще очікуване джерело. Якщо так, оновіть парсер. Якщо ні, відкоригуйте профіль запиту: рендеруйте сторінку, чекайте на пізній контент, зберігайте стан сесії, додавайте легітимні заголовки, вибирайте маршрутизацію за країною або використовуйте більш потужну доставку для цілей, які доводять, що їм це потрібно.

Практична порада: найсильніший робочий процес парсера починається з доказів джерела, а потім змінює правила витягування лише після перевірки шару захоплення.

Як це робить скрапінг дешевшим у експлуатації?

Парсинг HTML стає дорогим, коли команди використовують найважчий профіль запиту для кожної сторінки. ScraperFly підтримує більш практичний шлях: починайте з легкого захоплення HTML, перевіряйте, чи містить розмітка корисні дані, а потім додавайте рендеринг браузера, затримки, сесії, заголовки, цільову маршрутизацію, преміум маршрутизацію, скріншоти або PDF лише тоді, коли ціль доводить, що ці контролі покращують результат.

Це особливо корисно для проектів з різними цілями. Простим публічним сторінкам можна залишити прості захоплення. Сторінки з великою кількістю JavaScript можуть використовувати відрендерений HTML. Сторінки, які потребують доказів, можуть додати вихід у вигляді скріншота або PDF. Нерівномірні проекти можуть використовувати кредити за принципом "плати, коли користуєшся", тоді як передбачувані виробничі навантаження можуть перейти на щомісячні кредити, коли шаблон стає зрозумілим. Сторінка цін детально пояснює цей шлях.


Процес роботи HTML парсера

Отримайте надійний HTML, перш ніж ваш парсер залежатиме від структури сторінки

Парсер настільки ж хороший, як і розмітка, яку він отримує. ScraperFly захоплює сирий або відрендерений HTML з публічних сторінок, щоб селектори, правила парсингу та подальше витягування могли починатися з перевіреної відповіді.

HTML
Розмітка спочатку

Захоплюйте структуру сторінки, яка потрібна вашому парсеру

Отримуйте HTML-джерело для простих сторінок або відрендерений HTML, коли JavaScript створює DOM, який читає ваш парсер.

format=htmlrender=falserender=true
DOM
Доказ селектора

Перевіряйте селектори на реальних відповідях

Порівнюйте захоплений HTML з полями, які ваш парсер очікує, перед масштабуванням на набір URL.

селекториполязразки
SAFE
Ескалація

Ескалювати доставку лише тоді, коли відсутній розмітка

Заголовки, сесії, маршрутизація за країною, рендеринг або преміум маршрутизація стають контрольованими змінами замість стандартних витрат.

заголовкисесіїпреміум

Контроль запитів для HTML, готового до парсера

url

Публічна сторінка, розмітка якої стає вхідними даними для парсера.

format=html

Форма відповіді для сирого або відрендереного HTML.

render

Увімкніть, коли корисний DOM з'являється після виконання JavaScript.

headers

Додайте контекст запиту, коли цільова відповідь змінюється за сигналом клієнта.

приклад cURL

Генеруйте Markdown з тією ж формою запиту, яку ви можете перенести в продукцію

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Вимоги до розмітки

Перевірте, чи достатньо сирого HTML, чи потрібне рендеринг браузера

Деякі публічні сторінки містять корисні дані в сирому HTML; інші відправляють оболонку і створюють контент у браузері. Раннє відстеження цієї різниці зберігає роботу парсера легшою та більш передбачуваною.

Сирова HTML-відповідь, відображена на видимих даних сторінки
01

Доступність сирого HTML

Перевірте, чи поля, які вам потрібні, вже присутні в першій HTML-відповіді.

Найкращий перший тест для простих сторінок, статей, документів, списків та деталей продуктів.

Порівняння до і після рендерингу JavaScript
02

Залежність від JavaScript

Порівняйте сирий HTML з відрендереним DOM або скріншотом перед увімкненням рендерингу браузера.

Використовуйте рендеринг, коли сирий HTML є лише оболонкою, а скрипти створюють корисний контент.

Куки, згода, контекст сесії та доступу для скрапінгу
03

Стан і контекст доступу

Визначте, чи впливають куки, згода, межі входу, пагінація або той самий стан відвідувача на відповідь.

Використовуйте сесії та заголовки, коли безперервність змінює дані, які ви отримуєте.

Регіональні варіації контенту в різних країнах і маршрутах
04

Гео/варіація контенту

Перевірте, чи змінюють країна, мова, валюта, інвентар, SERP, реклама або репутація маршруту результат.

Використовуйте гео- або преміум-маршрути лише тоді, коли ціль підтверджує, що відповідь змінюється залежно від маршруту.

Запитання перед вибором вхідних даних парсера

Де знаходиться цільове поле?

Знайдіть, чи існує поле в сирому HTML, відрендереному DOM, виклику API, структурованих даних, файлі або пізнішому стані взаємодії.

Що змінює відповідь?

Виберіть кілька URL-адрес і порівняйте статус, фінальну URL-адресу, довжину вмісту, перенаправлення, порожні стани та видимі відмінності результатів.

Який контекст потрібен?

Позначте будь-яку залежність від згоди, локалі, куків, заголовків, межі аутентифікації, пагінації, фільтрів або попередніх запитів.

Як виглядає невдача?

Визначте сигнали для заблокованих, часткових, застарілих, перенаправлених, порожніх, з тайм-аутом або регіонально невідповідних відповідей перед масштабуванням.

Як поведінка цілі змінює запит парсера

Режим отримання

Доступність сирого HTML визначає, чи може перший запит залишатися простим або потребує рендерингу, очікувань, скріншотів або витягування.

Контекст запиту

Вимоги до стану визначають, чи потрібно додавати заголовки, куки, сесії, обробку згоди або стабільний профіль відвідувача.

Вибір маршруту

Гео та репутаційні дані визначають, чи достатньо стандартного маршруту або виправданий маршрут країни/преміум.

Правила валідації

Відомі стани невдачі стають перевірками для повторних спроб, ескалації, перевірки якості та визначення, коли легший профіль все ще є повним.

Контроль витрат парсера

Тримайте прості входи парсера легкими і підвищуйте лише тоді, коли розмітка відсутня.

Сирийний HTML часто достатній для простих завдань парсера. Рендеринг, затримки, сесії, заголовки, скріншоти, PDF-файли та більш складна маршрутизація належать до цілей, які доводять, що їм потрібно більше, ніж просто захоплення джерела.

Легкий HTML-запит, що повертає просту відповідь
01

Базовий запит

Використовуйте базовий запит, коли публічний HTML вже містить необхідні вам поля.

Найлегший профіль запиту; зберігайте його, коли відповідь завершена.

Рендеринг JavaScript, що створює повний DOM
02

Рендеринг

Використовуйте рендеринг, коли сирий HTML є оболонкою, а JavaScript завершує сторінку.

Важчий профіль; використовуйте його лише тоді, коли вихід браузера змінює результат.

Кілька запитів з збереженням куків та стану відвідувача
03

Станова сесія

Використовуйте сесії, коли куки, згода, локалізація або пагінація змінюють відповідь.

Важчий профіль стану; зберігайте його лише тоді, коли важлива безперервність.

Маршрутизація запитів через гео та маршрути вищої якості
04

Преміум маршрутизація та гео

Використовуйте преміум маршрутизацію або гео лише тоді, коли походження, країна, репутація або регіональний контент змінюють результат.

Найважчий профіль маршрутизації; застосовуйте його лише до цілей, які доводять, що вони його потребують.

Що робить захоплення, готове до парсера, важчим

Більше роботи з інфраструктурою

Рендеринг браузера, вибір маршрутизації та довші очікування означають, що платформа повинна виконувати більше, ніж просто повертати просту відповідь.

Більша невизначеність цілі

Редиректи, порожні стани, обмеження швидкості та сторінки викликів часто вимагають більш потужних варіантів доставки або повторних спроб.

Більше стану для збереження

Cookies, сесії, згода та багатосторінкові потоки додають рухомі частини, яких немає у простому безстатевому запиті.

Більше доказів для повернення

Скріншоти, PDF, рендерений вихід та багатші артефакти відповіді корисні, але вони важчі за простий HTML.

Як зберегти передбачуваність запусків парсингу

Вибірка перед масштабуванням

Спочатку протестуйте невелику вибірку URL та групуйте цілі за найменшим профілем, який повертає повні дані.

Не рендерити за замовчуванням

Перевірте сирий HTML перед увімкненням рендерингу. Багато публічних сторінок вже містять необхідні вам дані.

Ескалація за доказами

Підвищуйте лише тоді, коли відповідь показує відсутній контент, залежність стану, гео варіацію або проблеми з маршрутизацією.

Вимірюйте корисні результати

Оптимізуйте навколо дійсних записів, що доставляються, а не сирого обсягу запитів. Легший профіль найкращий лише тоді, коли він залишається повним.

HTML PARSER FAQ

Загальні питання про робочі процеси API парсера HTML

Практичні відповіді для розробників, які вирішують, як захоплювати, перевіряти та парсити публічну розмітку сторінок, не роблячи кожен запит важчим, ніж потрібно.

Швидкі відповіді
BOUNDARY

Що обробляє ScraperFly

Чи пише ScraperFly мої правила парсера?

ScraperFly захоплює джерело сторінки та докази відповіді. Ваш додаток контролює селектори, правила витягування, валідацію та зберігання.

Що повертає format=html?

Він повертає HTML з запиту до публічної сторінки. Залежно від профілю запиту, це може бути сирий HTML або рендерений HTML після виконання в браузері.

RENDERING

Сирий або рендерений HTML

Чи повинен кожен запит парсера рендерити JavaScript?

Ні. Почніть з сирого HTML і рендеріть лише тоді, коли корисний DOM відсутній у відповіді джерела.

Як я можу дізнатися, що сирий HTML достатній?

Перевірте захоплений розмітку на наявність посилань, заголовків, таблиць, метаданих або контейнерів, які очікує ваш парсер.

VALIDATION

Довіра парсера

Чому селектори ламаються після одного використання?

Цілі можуть змінювати шаблони, перенаправляти, блокувати або по-різному відображати контент. Зберігайте докази відповіді разом з результатами парсера, щоб відокремити зміни джерела від помилок правил.

Чи слід мені використовувати текст або Markdown замість HTML?

Використовуйте текст або Markdown, коли метою є читабельний контент. Використовуйте HTML, коли важливі відносини DOM, атрибути, посилання, таблиці або селектори.

COST

Ефективні запити

Як я можу зберегти доступність парсингу?

Використовуйте сирий HTML для простих сторінок, а потім додавайте рендеринг, затримки, сесії, заголовки, маршрутизацію за країною або преміум маршрутизацію лише тоді, коли цільова відповідь підтверджує, що це необхідно.

Чи можуть скріншоти допомогти в робочому процесі HTML парсера?

Скріншоти корисні для QA та візуальних доказів, але зазвичай вони доповнюють докази парсера, а не замінюють HTML-вхід.





