






Основний шар API
Сформуйте профіль запиту, перш ніж ваш продукт залежатиме від даних
API для веб-скрапінгу надає вашому продукту надійний спосіб отримувати публічні веб-сторінки, перевіряти відповідь і повертати корисний вихід, не володіючи всіма частинами інфраструктури скрапінгу. Ваша команда надсилає цільовий URL та чіткий профіль запиту. ScraperFly обробляє шар захоплення, а потім повертає HTML, текст, Markdown, JSON-метадані, скріншоти або PDF у формі, яку може використовувати ваш робочий процес.
Практична перевага полягає в контролі. Проста сторінка повинна залишатися легким HTML-запитом. Сторінка JavaScript може бути відрендерена, коли корисний контент відсутній у вихідному HTML. Складна ціль може додати сесії, заголовки, маршрутизацію по країнам або преміум-доставку після того, як відповідь підтвердить, що ці контролі потрібні. Цей шлях зберігає тестування дешевшим, поведінку в продукції легше пояснити, а час інженерів зосереджений на продукті, а не на обслуговуванні браузера та проксі.
Що насправді замінює API для веб-скрапінгу?
API для веб-скрапінгу замінює інфраструктуру захоплення навколо отримання публічних сторінок. Без нього команда часто повинна підтримувати HTTP-клієнти, браузерні робітники, проксі-пули, логіку повторних спроб, правила тайм-ауту, пересилання заголовків, стан сесії, конвертери виходу, захоплення скріншотів, генерацію PDF, журнали та моніторинг навколо кожної цілі. Ця робота може бути корисною для дуже спеціалізованої платформи, але рідко є основною цінністю продукту, якому потрібні дані.
ScraperFly переміщує цей операційний шар за одну API-поверхню. Додаток все ще володіє тим, що важливо в подальшому: вибір цілей, парсинг полів, перевірка якості даних, зберігання записів, порівняння змін, генерація сповіщень або підживлення систем AI та аналітики. ScraperFly зосереджується на отриманні відповіді з публічної сторінки в надійну форму, щоб наступна система починала з доказів, а не з крихкого саморобного отримання.
Практична порада: використовуйте API для веб-скрапінгу, коли вашому продукту потрібні докази публічної сторінки, а не ще одна внутрішня платформа для роботи з браузером, проксі, повторними спробами та конвертацією.
Як слід будувати перший запит?
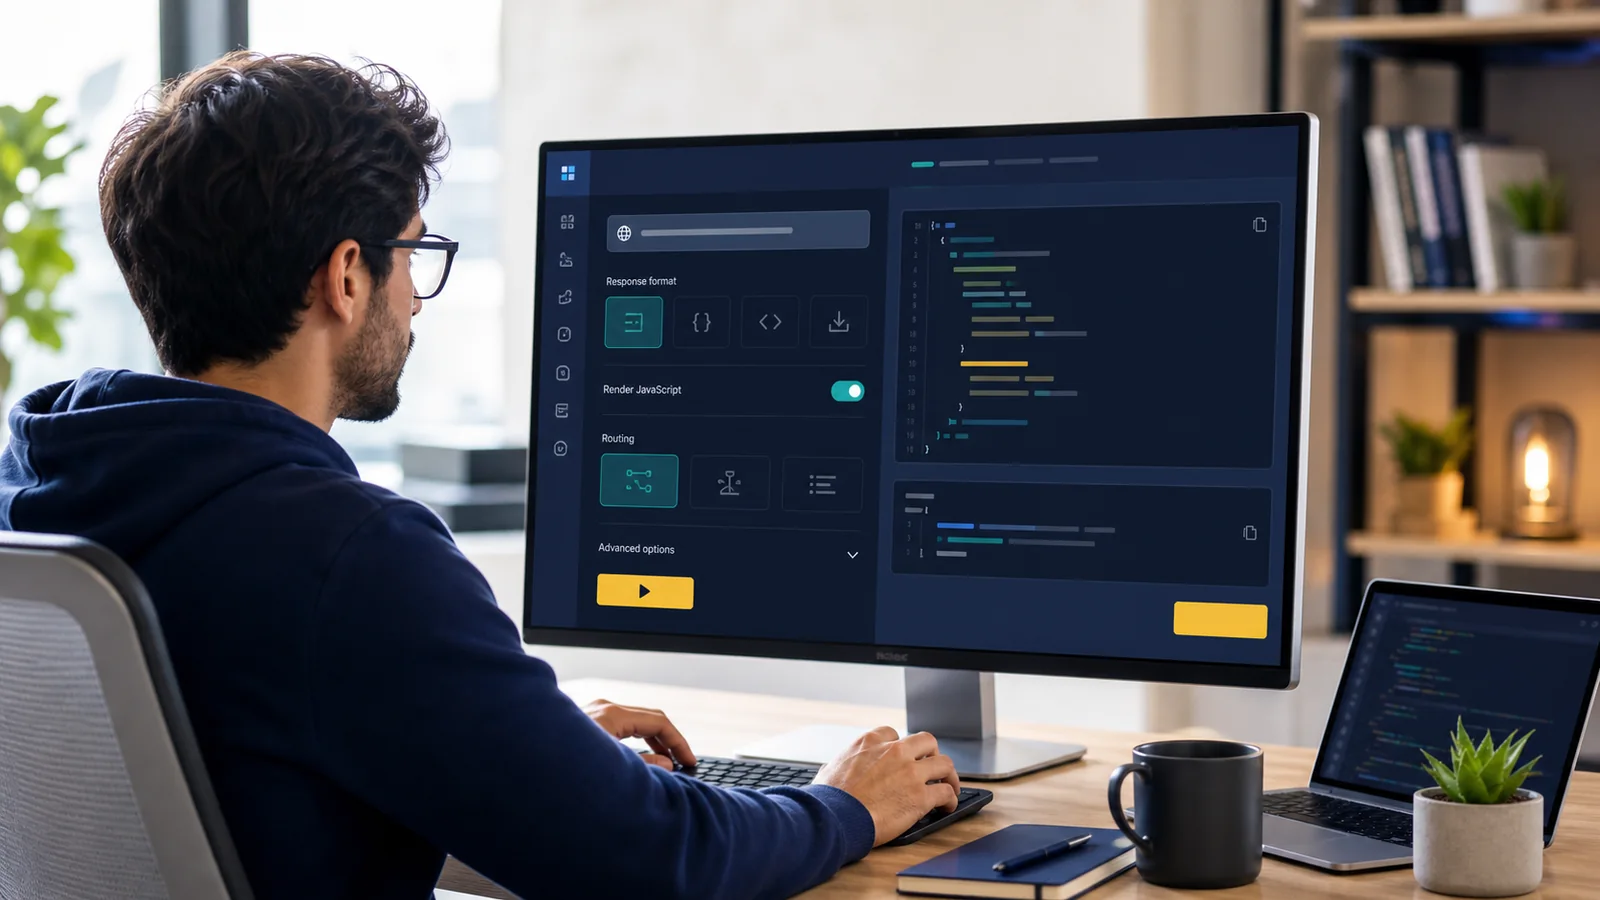
Перший запит повинен бути навмисно нудним. Надішліть публічний URL, запитайте про найменший корисний вихід і перевірте результат. Якщо вихідний HTML містить контент, який потрібен вашому парсеру, зберігайте запит простим. Якщо сторінка повертає лише тонку оболонку програми, порожній розмітку або контент, який з'являється після виконання JavaScript на фронтенді, увімкніть рендеринг для цієї цілі. Якщо відповідь змінюється залежно від мови, стану згоди, місця розташування або попередніх кроків, оцініть заголовки, куки, сесії або маршрутизацію по країнам.
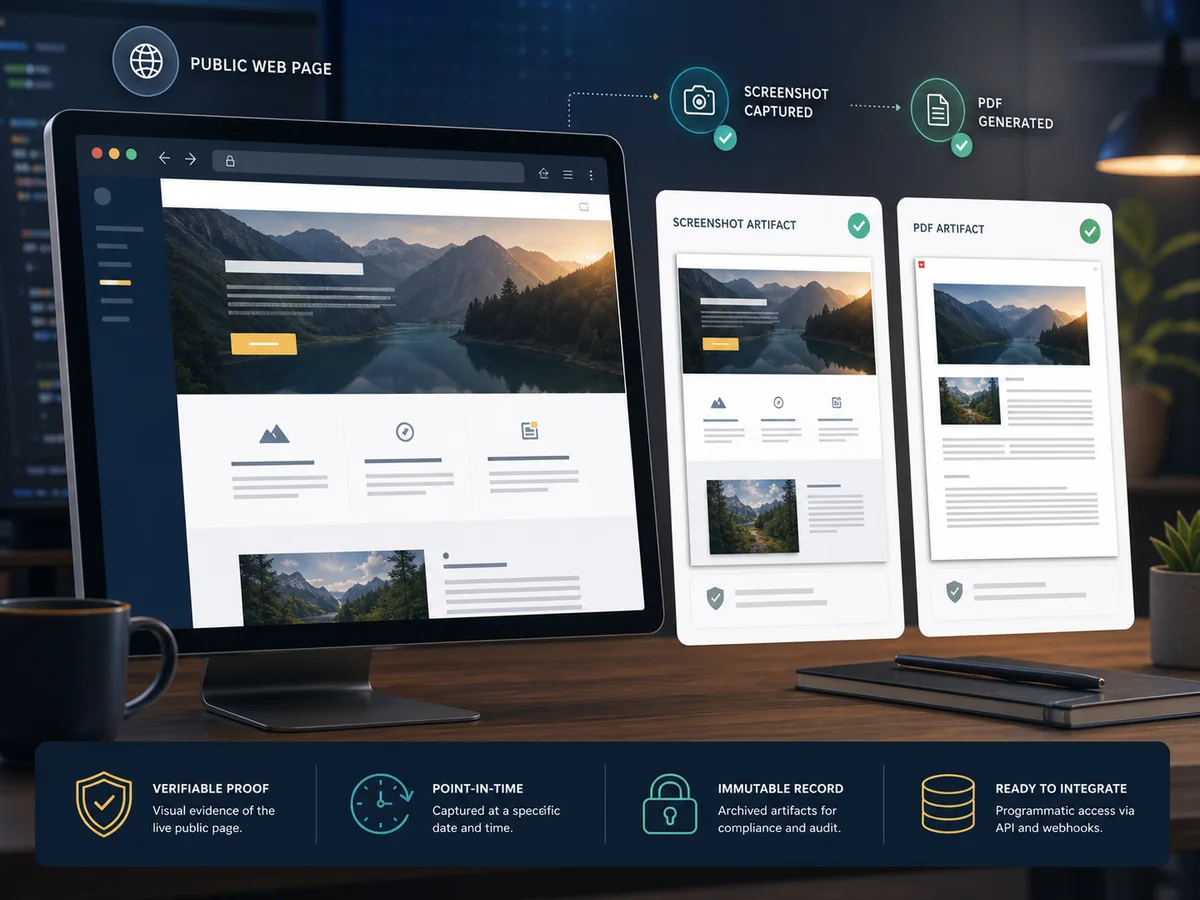
Це та ж логіка, що відображена в блоці конструктора запитів на сторінці нижче: створіть один надійний запит, а потім додавайте контролі лише тоді, коли ціль підтверджує, що вони потрібні. Суть не в тому, щоб приховати розширені функції. Суть у тому, щоб кожна функція була прив'язана до причини. Рендеринг вирішує проблеми, створені браузером. Сесії зберігають стан між пов'язаними запитами. Заголовки несуть легітимний контекст запиту. Преміум або маршрутизація по країнах допомагають, коли докази доставки показують, що стандартний шлях недостатній. Скріншоти та PDF створюють візуальні докази, коли вихід, зчитуваний машиною, сам по собі не може розповісти всю історію.
| Рішення запиту | Почати з | Додати більше, коли | Чому це важливо |
|---|---|---|---|
| Основне захоплення публічної сторінки | URL плюс HTML вихід | Вихідний HTML неповний або непридатний | Зберігає перший тест швидким, дешевим і легким для налагодження. |
| Контент, створений JavaScript | Порівняння сирого HTML | Браузер змінює корисний контент | Рендеринг стає контролем на основі доказів, а не стандартним податком. |
| Стан або регіональні сторінки | Простий запит з метаданими відповіді | Мова, куки, стан маршруту або місце розташування змінюють відповідь | Сесії, заголовки та маршрутизація залишаються прив'язаними до поведінки цілі. |
| Робочі процеси перевірки, QA або архівування | Вихід, зчитуваний машиною | Комусь потрібні докази того, як виглядала сторінка | Скріншоти та PDF доповнюють парсовані дані, а не замінюють їх. |
Який формат відповіді повинен повертати API?
Найкращий формат відповіді - це той, який ваша наступна система може використовувати з найменшими витратами на очищення. HTML підходить, коли важливі селектори, таблиці, посилання, атрибути або відносини DOM. Відрендерений HTML корисний, коли JavaScript на фронтенді створює розмітку, яка потрібна вашому парсеру. Текст легший, коли робочий процес потребує лише читабельного контенту сторінки. Markdown допомагає AI, RAG, узагальненню, документації та робочим процесам перевірки, оскільки заголовки та посилання залишаються легшими для розуміння, ніж простий текст.
JSON-метадані корисні для операційного контексту: статус, фінальний URL, тип контенту, час та деталі відповіді, які допомагають журналам та налагодженню. Це не замінює спеціальне витягування. Скріншоти та PDF виконують іншу роботу: візуальні докази. Вони допомагають з моніторингом, QA, перевіркою відповідності, затвердженнями та архівами, але вони важчі і зазвичай менш зручні для машинного парсингу.
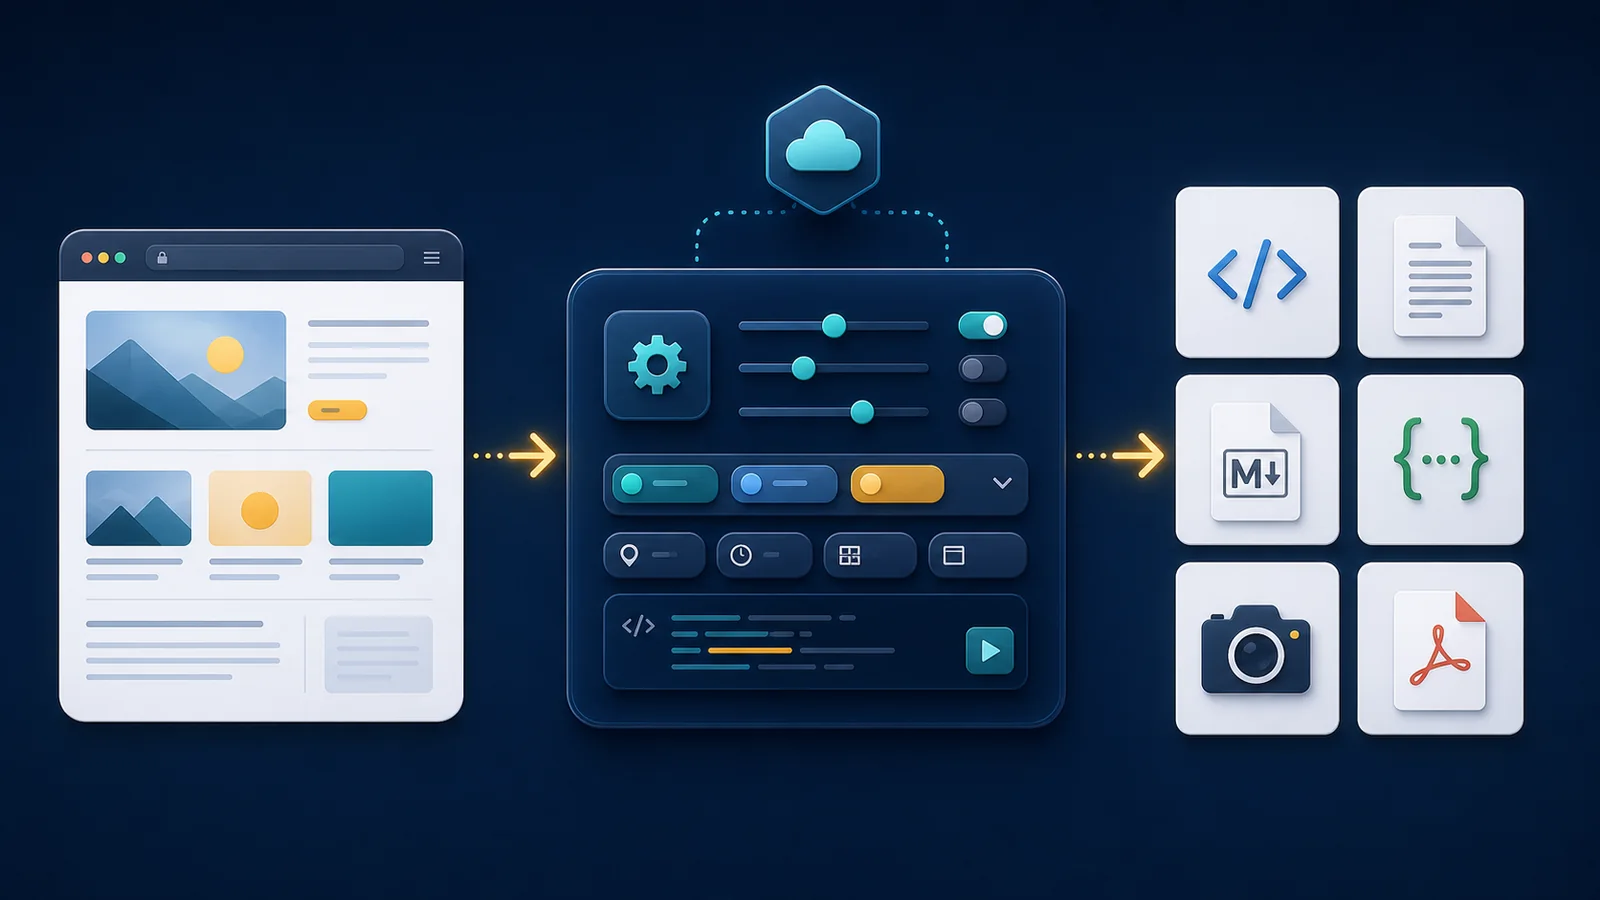
| Вихід | Найкраще підходить для | Основна перевага | Компроміс |
|---|---|---|---|
| Сирий або відрендерений HTML | Парсинг DOM, селектори, таблиці, посилання | Зберігає структуру та відносини сторінки | Вимагає логіки парсера та очищення в подальшому |
| Текст | Пошук, індексація, легкий аналіз | Компактний та легкий для обробки | Видаляє більшість структурного контексту |
| Markdown | AI, RAG, резюме, перевірка контенту | Зберігає читабельні заголовки, списки та посилання | Не ідеально підходить для точного витягування DOM |
| JSON-метадані | Журналювання, діагностика, маршрутизація робочого процесу | Спрощує перевірку доказів запиту | Не замінює витягування полів, специфічних для цілі |
| Скріншот або PDF | QA, моніторинг, затвердження, архіви | Показує, як виглядала відрендерена сторінка | Важчі та менш зручні для парсингу |
Коли важливі рендеринг, сесії, заголовки та маршрутизація проксі?
Розширені контролі важливі, коли вони вирішують конкретну проблему цілі. Рендеринг браузера важливий, коли дані створюються після виконання JavaScript. Затримки важливі, коли браузер завантажує правильний стан пізно. Заголовки важливі, коли публічна ціль очікує легітимний контекст, такий як мова, тип контенту, реферер або конкретний шаблон user-agent. Сесії важливі, коли пов'язані запити залежать від спільних куків або стану маршруту. Маршрутизація по країнах важлива, коли публічний контент змінюється залежно від місця розташування, валюти, доступності або регулювання. Преміум-маршрутизація важлива, коли докази відповіді показують, що стандартна доставка не повертає придатну сторінку.
Цей порядок важливий. Увімкнення всього відразу може зробити запит дорожчим, повільнішим і важчим для діагностики. Кращий робочий процес - це тестування репрезентативних сторінок, порівняння розміру та вмісту відповіді, перевірка фінального URL та статусу, а потім вибір найменшого профілю запиту, який надійно виробляє потрібний артефакт. Це також робить відновлення в продукції зрозумілішим: якщо ціль починає повертати перенаправлення, тайм-аут, порожню оболонку або несподіваний тип контенту, команда знає, яку частину профілю запиту потрібно переглянути.
Практична порада: додавайте рендеринг, сесії, заголовки, маршрутизацію або візуальний вихід, коли відповідь підтверджує, що вони покращують якість захоплення, а не тому, що вони доступні.
Як ScraperFly знижує ризик на шляху покупки?
Проект зі скрапінгу часто починається з невизначеності. Команда може не знати, чи ціль статична, насичена JavaScript, чутлива до місця розташування, залежна від сесій або важка для доставки. Закріплення цієї роботи в важкій інфраструктурі або великому повторюваному плані перед тестуванням цілі створює ризик. ScraperFly позиціонується для простішого шляху: почніть з безкоштовних кредитів, перевірте реальні сторінки, купуйте кредити, коли проект потребує їх, і переходьте на щомісячні кредити, коли повторюваний попит стає зрозумілим.
Ця модель підходить для технічного робочого процесу. Легкий запит повинен залишатися легким. Важчий відрендерений або маршрутизований запит слід використовувати, коли він створює цінність. Візуальні файли повинні генеруватися, коли комусь потрібні візуальні докази. Конструктор API підтримує ту ж логіку покупки, оскільки дозволяє команді перевіряти реальний запит перед написанням коду з'єднання або масштабуванням партій. Контроль витрат - це не лише питання ціноутворення; це звичка проектування запитів.
Що повинно залишитися внизу від API для скрапінгу?
ScraperFly не слід розглядати як магічний екстрактор, який перетворює кожну публічну сторінку на ідеальний набір даних. API захоплює вихід публічної сторінки та надає контролі для рендерингу, маршрутизації, сесій, заголовків, форматів та візуальних доказів. Ваш продукт все ще вирішує, що означають дані. Відображення полів, нормалізація сутностей, видалення дублікатів, перевірки якості, сповіщення, оцінка, зберігання та бізнес-логіка залишаються внизу, де їм і місце.
Ця межа робить продукт більш надійним. API для веб-скрапінгу повинен допомагати розробнику отримувати надійні джерела доказів, а потім дозволяти додатку застосовувати свої власні правила. Це особливо важливо для AI, моніторингу, аналітики та автоматизаційних робочих процесів, де погані джерела доказів можуть призвести до поганих резюме, хибних сповіщень, дублікатів записів або дорогих повторних спроб.
Куди повинна йти команда після розуміння основ?
Наступний крок - створити реальний запит, а не теоретичну архітектуру. Використовуйте Конструктор API, щоб протестувати публічний URL, порівняти формати виходу та вирішити, чи потрібен рендеринг, сесії, заголовки, маршрутизація або візуальне захоплення. Якщо основне питання - форма виходу, перегляньте сторінку форматів відповіді API для веб-скрапінгу. Якщо сторінка насичена JavaScript, порівняйте результат з рекомендаціями API для рендерингу JavaScript. Якщо стан важливий між запитами, сторінка API сесій пояснює, коли спільний контекст є корисним.
Якщо профіль запиту підтверджено, перемістіть його в бекенд, робітник, агента, парсер, монітор або архівний робочий процес, який потребує даних. Це основна обіцянка ScraperFly: один практичний шар API для публічних веб-даних з контролями, які залишаються видимими з першого тесту до виробництва.












