






JSON відповідь робочого процесу
Поверніть контекст сторінки у форматі JSON без припущення, що кожна ціль має однакову схему
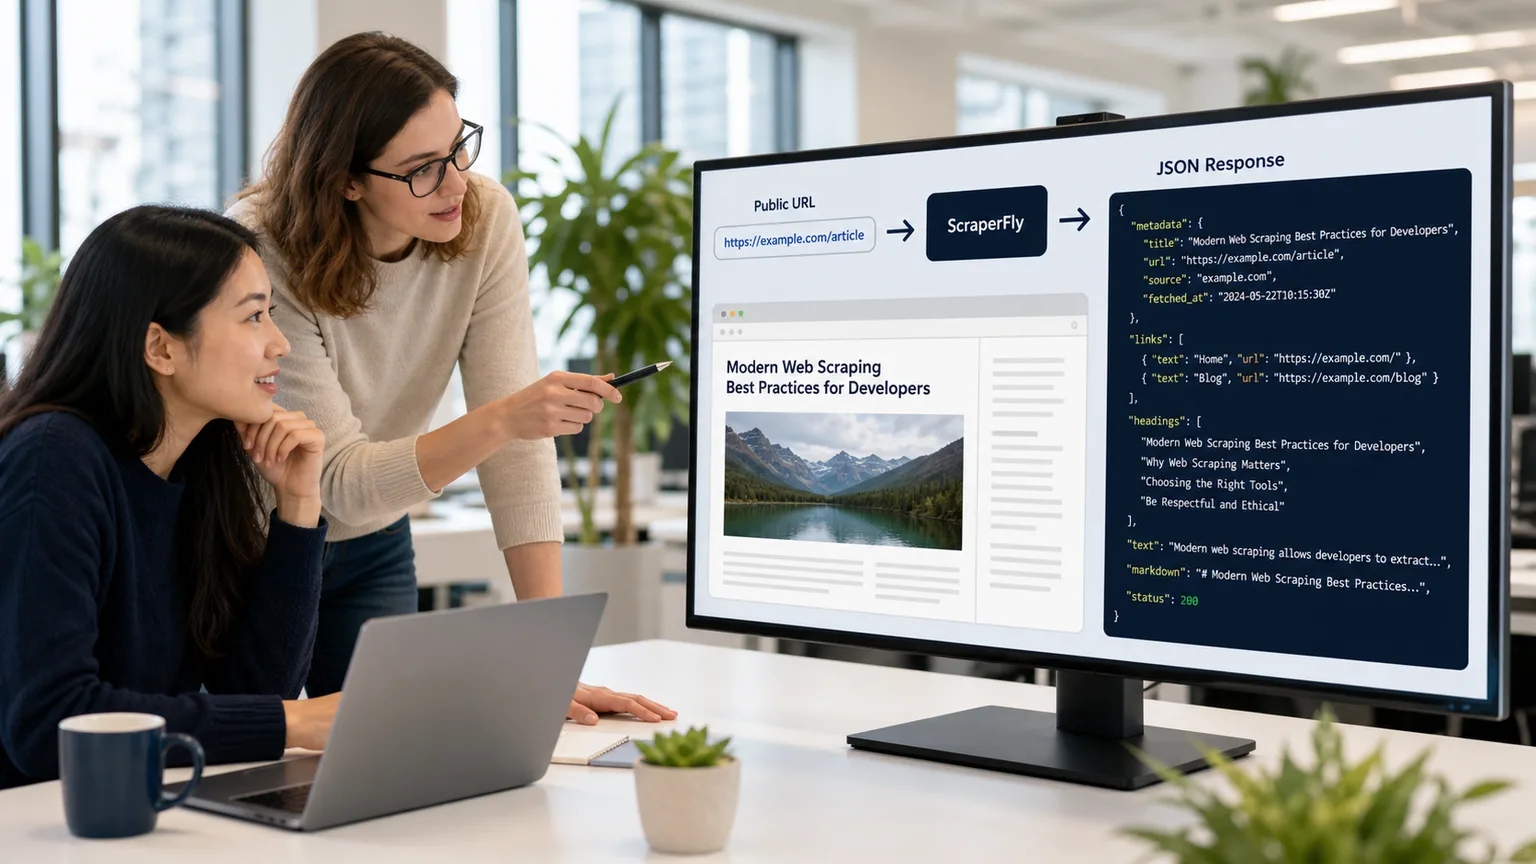
Робочий процес з веб-сайту в JSON корисний, коли вашій програмі потрібен передбачуваний обгортка відповіді навколо публічних даних сторінки. ScraperFly допомагає розробникам захоплювати сторінку, зберігати докази запиту та повертати підтримуваний контекст, такий як метадані, посилання, заголовки, текст, Markdown, статус, фінальна URL-адреса та деталі відповіді.
Важливою межею є чесність. ScraperFly може підготувати відповідь публічної сторінки та спростити програмну перевірку, але ваш продукт все ще повинен володіти специфічним для цілі витягуванням для кастомних полів, таких як ціни, доступність, рейтинги, імена авторів або внутрішні бізнес-одиниці.
Що означає витягувати веб-сайт у JSON?
Витягування веб-сайту у JSON означає отримання публічної URL-адреси та повернення корисного контексту сторінки у структурованій відповіді, яку ваша програма може прочитати. Замість того, щоб передавати кожній системі нижнього рівня сирий об'єкт HTML, відповідь API може містити метадані, посилання, заголовки, читабельний текст, Markdown, статус запиту, фінальну URL-адресу, тип контенту та інші докази відповіді в полях, які легше реєструвати, перевіряти, порівнювати та маршрутизувати.
Це не робить кожен веб-сайт чистою таблицею бази даних. Публічні сторінки не мають однієї схеми. Сторінка продукту, стаття, список каталогів, сторінка результатів пошуку та сторінка документації всі мають різні структури. ScraperFly надає вашій команді стабільний шар захоплення та підтримувані форми відповіді; ваш парсер все ще вирішує, які специфічні для цілі поля важливі для вашого випадку використання.
Практичний висновок: використовуйте вихід з веб-сайту в JSON для контексту сторінки та доказів запиту, а потім додайте логіку витягування, де бізнес-схема специфічна для цілі.
Коли JSON є правильною формою відповіді?
JSON є правильною формою, коли споживач є бекенд-сервісом, робітником черги, моніторинговим завданням, агентом, конвеєром даних або внутрішнім інструментом, який очікує передбачувані ключі. Це допомагає, коли ваш робочий процес потребує зберігати фінальну URL-адресу, статус, метадані сторінки, виявлені посилання, заголовки, текст, Markdown та діагностику поряд із захопленим контентом. Це спрощує налагодження та маршрутизацію нижнього рівня, оскільки програма не повинна виводити кожну деталь з одного рядка HTML.
HTML все ще є кращим первинним входом, коли важливі селектори, атрибути, структура таблиці, відносини DOM або вбудований стан. Текст і Markdown часто є кращими, коли мета полягає в пошуку, узагальненні, класифікації, огляді або споживанні AI. JSON є найсильнішим, коли він обгортає ці корисні виходи з відстежуваним контекстом.
| Форма відповіді | Використовуйте, коли | Чого уникати |
|---|---|---|
| JSON контекст | Ваш бекенд потребує метаданих, посилань, заголовків, тексту, Markdown та доказів запиту у передбачуваних полях | Не розглядайте JSON на рівні сторінки як автоматичне кастомне витягування. |
| Сирий HTML | Ваш парсер потребує селекторів, атрибутів, таблиць, посилань або вбудованої структури джерела | Не перетворюйте на текст занадто рано, якщо важливі відносини DOM. |
| Відрендерений HTML | Корисний публічний контент з'являється лише після виконання JavaScript | Не рендерте кожну сторінку, перш ніж довести, що відповідь джерела неповна. |
| Текст | Вам потрібен компактний читабельний контент для пошуку, індексації або простого порівняння | Не використовуйте простий текст, коли потрібні структуровані відносини сторінки. |
| Markdown | Вам потрібні читабельні заголовки, списки та посилання для AI або робочих процесів огляду | Не очікуйте, що Markdown зберігатиме кожен селектор або деталь макета. |
| Скриншот або PDF | Вам потрібні візуальні докази, огляд QA, архівний вихід або читабельний запис | Не використовуйте візуальні файли як основний вхід парсера, коли машинозчитувані дані достатні. |
Які поля JSON корисні в робочих процесах виробництва?
Корисний JSON починається з відстежуваності. Ваша програма повинна знати, яка URL-адреса була запитана, куди врешті-решт приземлився запит, який статус повернувся, який тип контенту був повернутий і наскільки великим був відповідь. Ці докази допомагають відокремити реальну зміну цілі від перенаправлення, тонкої відповіді, блокованої сторінки, тайм-ауту або непідтримуваного формату.
Контекст сторінки йде далі. Метадані, заголовки, описи, заголовки, канонічні підказки, посилання, чистий текст та Markdown можуть допомогти конвеєру вирішити, що парсити, індексувати, узагальнювати, архівувати або надсилати до іншого сервісу. Для AI та RAG робочих процесів метадані JSON плюс Markdown можуть бути сильнішими за простий текст, оскільки відповідь несе читабельний контент та операційний контекст разом.
Специфічні для цілі поля йдуть після цього. Якщо ваш продукт потребує ціни, SKU, автора, рейтингу, посади, місця, дати події або доступності, створіть цей шар витягування навколо цільових сторінок, які ви насправді підтримуєте. ScraperFly допомагає отримувати та підготовлювати відповідь; ваша програма визначає бізнес-схему.
Як команди повинні тестувати вихід з веб-сайту в JSON?
Почніть з однієї публічної цільової URL-адреси в API Builder. Спочатку захопіть відповідь джерела, перевірте повернутий контекст і підтвердіть, які поля насправді присутні. Потім порівняйте альтернативні формати: HTML для роботи парсера, текст або Markdown для читабельного контенту, метадані JSON для діагностики та візуальний вихід, коли рецензенту потрібні докази.
Якщо сторінка насичена JavaScript, порівняйте вихід джерела з API рендерингу JavaScript або API відрендереного HTML. Рендеринг є доцільним, коли він додає контент, який потрібен вашому продукту. Якщо рендеринг не покращує відповідь, перевірте час, перенаправлення, контекст запиту або поведінку цілі перед повторною спробою.
| Крок тестування | Питання для відповіді | Рішення, яке це підтримує |
|---|---|---|
| Отримати публічну URL-адресу | Чи успішна відповідь і приземляється на очікувану фінальну URL-адресу? | Підтвердіть, що ціль доступна, перш ніж почати роботу парсера. |
| Перевірте вихідний HTML | Чи містить початкова відповідь поля або контент, які вам потрібні? | Зберігайте запит легким, коли захоплення джерела є достатнім. |
| Порівняйте формати виходу | Чи є HTML, текст, Markdown або контекст JSON найкращою формою для нижнього рівня? | Уникайте створення конвертерів навколо неправильного формату. |
| Рендерити лише за потреби | Чи додає виконання браузера значущий публічний контент? | Використовуйте рендеринг для реальних прогалин у контенті, а не як стандартний податок. |
| Визначте кастомне витягування | Які специфічні для цілі бізнес-поля потрібні вашій програмі? | Залиште ScraperFly як шар захоплення, а ваш парсер як шар схеми. |
Чим веб-сайт у JSON відрізняється від API парсера?
API парсера зазвичай передбачає, що сервіс розуміє специфічну для цілі схему та повертає кастомні сутності. Відповідь веб-сайту у JSON є іншою. Вона надає вашій програмі структурований контекст сторінки та докази захоплення, щоб ваш власний парсер міг приймати кращі рішення. Це розрізнення зберігає робочий процес надійним, оскільки публічні веб-сайти занадто різноманітні, щоб припускати, що кожну ціль можна звести до одного й того ж об'єкта JSON.
Якщо вашій команді потрібен чистий читабельний контент, порівняйте API парсингу контенту веб-сайту, API парсера HTML в текст та API парсера HTML в Markdown. Якщо вам потрібно парсити на рівні DOM, почніть з API скрапінгу HTML або API парсера HTML для веб-скрапінгу.
Як ScraperFly зберігає практичність робочих процесів JSON?
ScraperFly зберігає робочий процес практичним, дозволяючи одному й тому ж API-шляху почати просто і додавати контролі, коли ціль доводить, що вони потрібні. Публічна сторінка, яка повертає корисний вихідний HTML, може залишатися легкою. Сторінка, що рендериться клієнтом, може використовувати виконання браузера. Маршрут з потребами публічного контексту може додати заголовки, куки, цільове країну або сесії. Робочий процес огляду може додати скриншоти або PDF. Кожен вибір повинен покращувати відповідь, а не просто ускладнювати запит.
Це важливо для витрат і підтримуваності. Команди часто перевантажують конвеєри веб-сайту в JSON, пропускаючи кожну ціль через браузер, перетворюючи все в один і той же формат, а потім виявляючи, що парсер нижнього рівня все ще потребує специфічних для цілі правил. ScraperFly надає вам контролі захоплення, формати відповіді та докази, щоб спочатку вибрати менший шлях. Сторінка цін та калькулятор вартості кредитів API веб-скрапінгу можуть допомогти оцінити вплив перед зростанням обсягу.
Практичний висновок: найкращий робочий процес веб-сайту в JSON надає розробникам чітку обгортку відповіді, зберігає вагу запиту в відповідності з ціллю та залишає кастомне бізнес-витягування там, де воно належить: у логіці програми.










