






Формати відповіді API для веб-скрапінгу - це вихідні форми, які повертаються після захоплення публічної сторінки, включаючи HTML, текст, Markdown, метадані JSON, скріншоти та PDF. Правильний формат залежить від подальшого завдання: парсинг розмітки, подача в AI-пайплайн, перегляд контенту, моніторинг змін, архівування доказів або збереження візуального запису.
Вибір форми відповіді на ранньому етапі запобігає непотрібному очищенню. Це також допомагає командам уникати створення конвертерів, інструментів захоплення браузера та логіки обробки, перш ніж вони дізнаються, що насправді потрібно продукту.
ScraperFly дозволяє розробникам тестувати кілька вихідних форматів на одному й тому ж публічному цільовому URL. Це робить вибір формату інженерним рішенням на основі реальних відповідей, а не припущень.
Що таке формати відповіді API для веб-скрапінгу?
Формат відповіді API для веб-скрапінгу визначає, як захоплена публічна сторінка повертається до клієнтського додатку.
Основна ціль може бути однаковою, але відповідь може служити дуже різним робочим процесам. HTML зберігає структуру сторінки. Текст видаляє більшість розмітки. Markdown зберігає читабельну структуру для контентних робочих процесів. Метадані JSON описують запит і контекст сторінки. Скріншоти та PDF зберігають візуальні докази.
Формат відокремлений від методу захоплення. Сторінка може бути отримана через звичайний HTTP-запит або відрендерена в браузері перед створенням вибраного виходу.
| Формат | Найкраще для | Не ідеально для | Приклад виходу | Користувач на downstream |
|---|---|---|---|---|
| Сирий HTML | Парсинг DOM, селектори, посилання, атрибути | Чисте споживання контенту без попередньої обробки | Тіло відповіді HTML | Розробник бекенду |
| Відрендерений HTML | Контент DOM, згенерований JavaScript | Статичні сторінки, які вже містять необхідні дані | HTML, згенерований браузером | Інженер зі скрапінгу |
| Звичайний текст | Індексація пошуку, легкий аналіз, простий перегляд | Робочі процеси, які потребують заголовків, посилань або макету | Чистий читабельний текст | Команда даних або пошуку |
| Markdown | Споживання AI/RAG, редакційний перегляд, документація | Точний парсинг DOM | Заголовки, абзаци, списки, посилання | Команда продукту AI |
| Метадані JSON | Статус, фінальний URL, тип контенту, контекст запиту | Випадкове витягування полів з цілі | Структурований контекст відповіді | Інженер платформи |
| Скріншот | Візуальний QA, моніторинг, докази макету | Шукаюча структурована інформація | Зображення артефакту | Команда QA або моніторингу |
| Архівування, затвердження, портативні записи | Тонке парсинг контенту | Документ для завантаження | Команда відповідності або операцій |
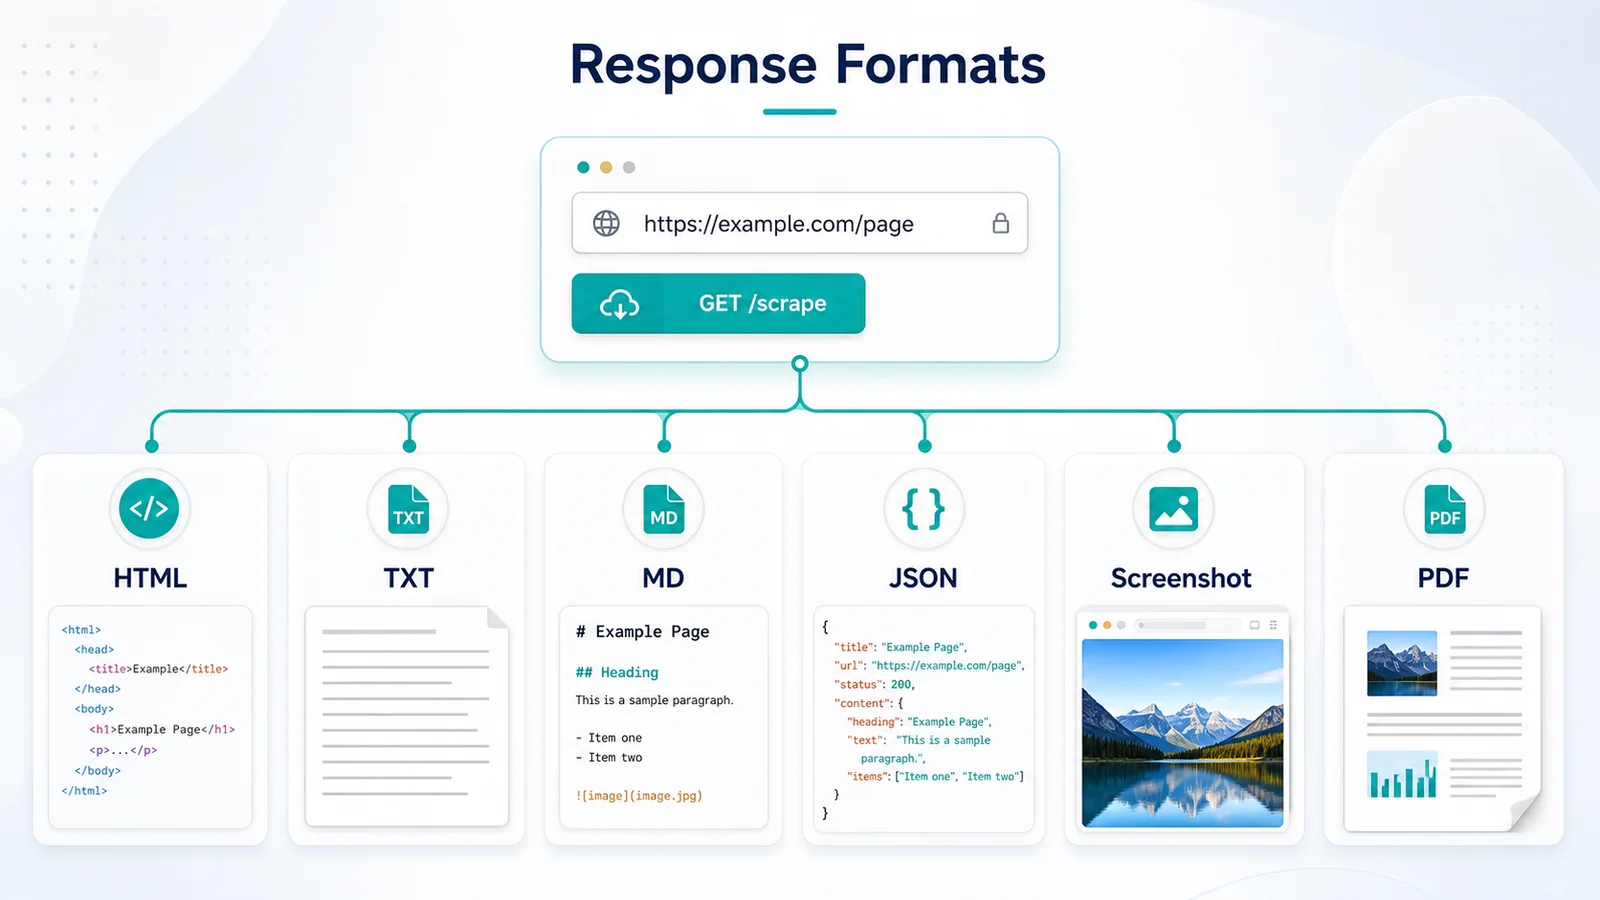
Практичний висновок: розглядайте формат виходу як частину архітектури програми, а не як косметичну опцію API.
Чому важливий формат відповіді після захоплення сторінки?
Запит - це лише початок робочого процесу скрапінгу. Відповідь все ще повинна перейти в парсер, індекс пошуку, AI-пайплайн, систему моніторингу, архів або інтерфейс продукту.
Поганий вибір формату переносить роботу вниз по потоку.
Наприклад, відправка сирого HTML в пайплайн споживання AI може вимагати видалення шаблонів, фільтрації навігації, очищення посилань та нормалізації контенту. Повернення звичайного тексту до парсера може видалити зв'язки DOM, необхідні для ідентифікації цін, заголовків, таблиць або атрибутів продукту.
Та ж проблема виникає у візуальних робочих процесах. Команда, якій потрібен доказ того, як виглядала сторінка, може спочатку захопити HTML, а потім підтримувати окремі робітники Playwright або Puppeteer для створення скріншотів. Підходящий візуальний вихід може усунути цей додатковий шар.
Вибір формату впливає на:
- скільки очищення виконує програма;
- чи зберігається структура сторінки;
- наскільки легко розробникам налагоджувати результат;
- чи підходить відповідь для автоматизованої обробки;
- скільки пам'яті та пропускної здатності використовує пайплайн;
- чи потрібен окремий конвертер або робітник браузера.
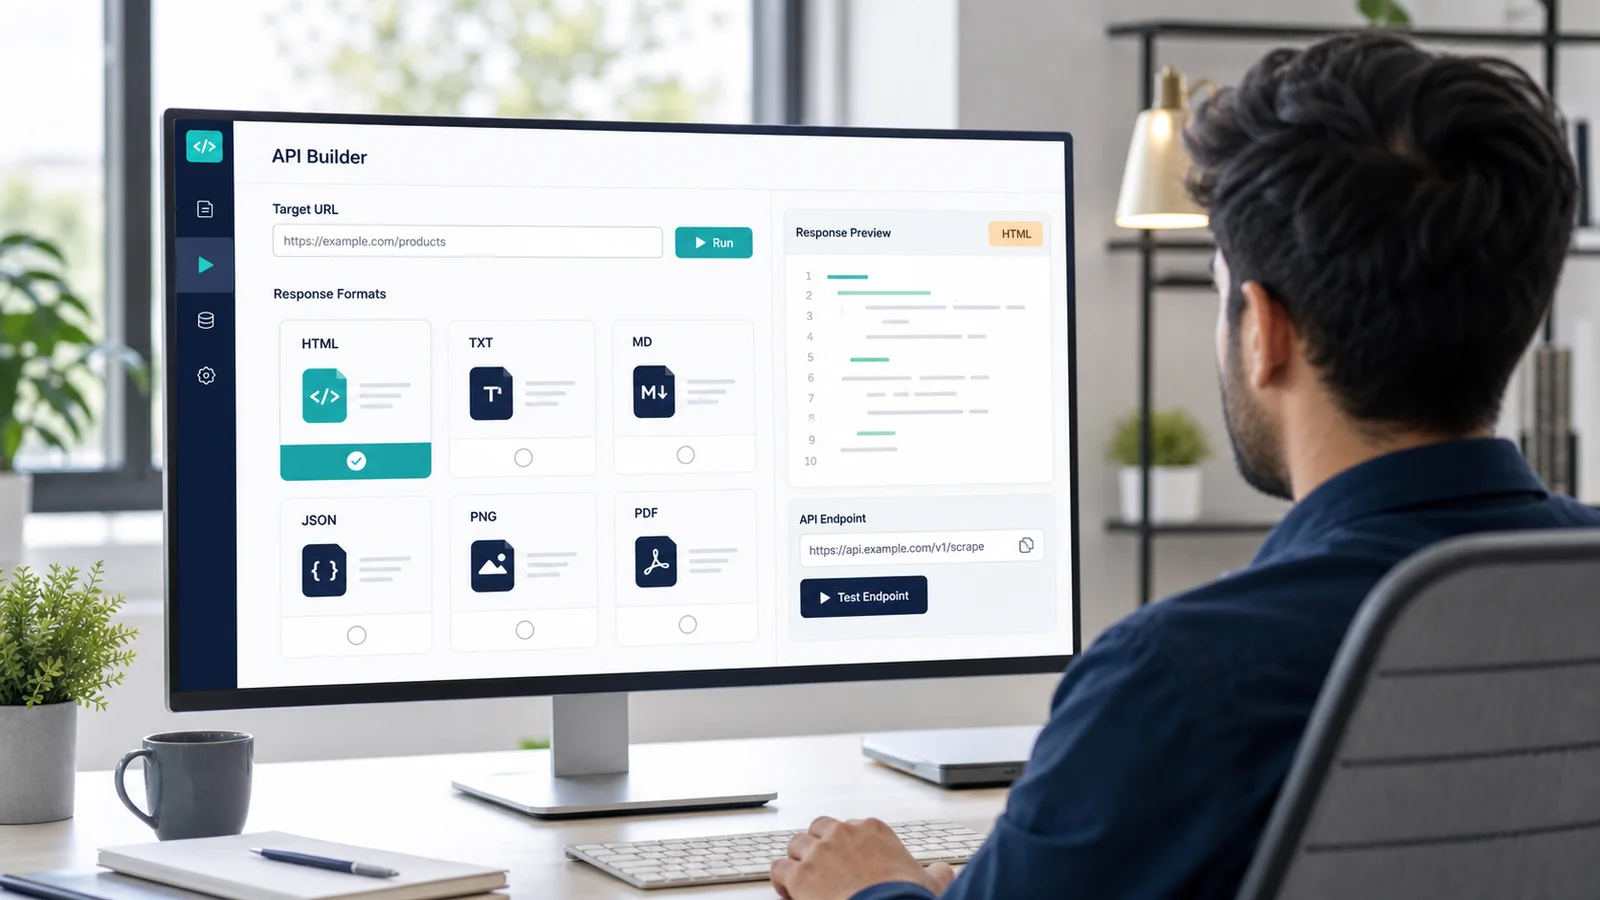
Перед написанням коду трансформації протестуйте ціль через API Builder. Порівняйте тіло відповіді, структуру контенту, розмір та зручність використання між форматами.
Практичний висновок: виберіть формат перед створенням конвертерів, оскільки очищення вниз по потоку може коштувати більше інженерного часу, ніж початковий запит.
Коли робочий процес скрапінгу повинен використовувати вихід HTML?
HTML - це правильний формат, коли додаток потребує оригінальної структури сторінки.
Парсер може перевіряти теги, класи, атрибути, заголовки, посилання, таблиці, вбудовані метадані та зв'язки DOM. Це робить HTML підходящим для логіки витягування, де додаток вже знає, які елементи важливі.
Звичайні робочі процеси HTML включають:
- витягування полів продукту за допомогою селекторів;
- виявлення посилань для краулера;
- парсинг структурованих таблиць;
- читання канонічних тегів або метаданих;
- ідентифікація секцій сторінки за ієрархією DOM;
- зберігання вихідної розмітки для подальшої обробки.
Сирий HTML - це початкова відповідь сервера. Це зазвичай найлегше місце для початку.
Відрендерений HTML - це DOM, створений після того, як браузер виконує JavaScript сторінки. Це важливо, коли необхідний контент не існує в оригінальній відповіді.
| Запитання | Сирий HTML | Відрендерений HTML |
|---|---|---|
| Звідки він походить? | Початкова HTTP-відповідь | DOM, згенерований браузером |
| Чи виконується JavaScript? | Ні | Так |
| Найкраще для | Статичні та серверно-рендерені сторінки | Клієнтсько-рендерені додатки |
| Типова затримка | Нижча | Вища |
| Відносна вага запиту | Легша | Важча |
| Основний ризик | Відсутній контент, згенерований браузером | Використання браузера, коли це не потрібно |
| Метод валідації | Шукати в відповіді необхідний контент | Порівняти відрендерений DOM з сирим HTML |
HTML не є автоматично кращим, оскільки містить більше інформації. Він може включати навігацію, скрипти, стилі, код відстеження та несумісні елементи сторінки. Цей шум прийнятний, коли парсеру потрібен структурний контроль, але неефективний, коли мета полягає в читабельному контенті.
Практичний висновок: використовуйте HTML, коли структура DOM є вхідними даними для вашої логіки, і вибирайте відрендерений HTML лише тоді, коли JavaScript створює необхідний вам контент.
Коли текст і Markdown кращі за HTML?
Текст і Markdown корисні, коли подальший робочий процес потребує читабельного контенту сторінки, а не повного контролю над DOM.
Звичайний текст видаляє більшість візуальної та структурної розмітки. Він добре підходить для аналізу ключових слів, індексації пошуку, порівняння контенту, простого класифікування та робочих процесів, де заголовки або посилання не є суттєвими.
Markdown зберігає більше значення. Заголовки, абзаци, списки та посилання залишаються легшими для інтерпретації, ніж у плоскому тексті. Це часто робить Markdown корисним для:
- Підготовка документів RAG;
- Споживання LLM;
- Редакційний перегляд;
- Імпорт бази знань;
- Контекст запиту;
- Аналіз документації;
- Міграція контенту.
Markdown не є заміною точному парсингу HTML. Якщо додаток повинен ідентифікувати ціну продукту за конкретним селектором, відрізняти навігаційні посилання від посилань на тіло або перевіряти атрибути, HTML залишається більш безпечним вибором.
Якість Markdown також залежить від вихідної сторінки. Чисті редакційні сторінки зазвичай конвертуються більш передбачувано, ніж високодинамічні макети, інформаційні панелі, складні таблиці або сторінки з фрагментованим контентом.
| Робочий процес | Рекомендований формат | Додатковий формат | Чому |
|---|---|---|---|
| Користувацький парсер | HTML | Метадані JSON | Зберігає селектори та зв'язки DOM |
| Споживання AI/RAG | Markdown | Текст або HTML | Зберігає читабельну ієрархію та посилання |
| Індексація пошуку | Текст | Markdown | Зменшує розмітку та шум обробки |
| Моніторинг контенту | Текст або HTML | Скріншот | Підтримує машинне порівняння та візуальний перегляд |
| Перегляд QA | Скріншот | HTML | Показує відрендерений вигляд з доказами джерела |
| Архів | HTML або скріншот | Створює портативний запис | |
| Звітність | Текст або Markdown | Скріншот | Підтримує резюме з візуальним контекстом |
Добрий робочий процес AI може використовувати більше ніж один формат. Markdown може надати читабельний контент, тоді як метадані JSON записують фінальний URL, тип контенту, статус та контекст захоплення.
Практичний висновок: використовуйте текст для компактного читабельного контенту, Markdown для збереженої структури документа та HTML, коли витягування залежить від DOM.
Що команди повинні очікувати від виходу метаданих JSON?
Метадані JSON надають структурований контекст про захоплення та відповідь. Вони не перетворюють автоматично кожну цільову сторінку в індивідуальну бізнес-схему.
Корисні метадані можуть включати інформацію, таку як:
- статус запиту;
- цільовий URL;
- фінальний URL після редиректів;
- тип контенту;
- розмір відповіді;
- час або контекст запиту;
- вибраний формат відповіді;
- деталі захоплення або маршрутизації, підтримувані API.
Ця структура цінна для ведення журналу, моніторингу, налагодження та координації подальшої обробки. Пайплайн може використовувати метадані, щоб вирішити, чи потрібно парсити, зберігати, повторювати або відхиляти тіло.
Однак метадані JSON не слід плутати з випадковим витягуванням схеми.
Наприклад, відповідь JSON не означає, що API автоматично ідентифікує кожну назву продукту, ціну, рейтинг, автора, компанію або поле статті на будь-якому веб-сайті. Витягування, специфічне для цілі, все ще вимагає логіки парсера, підтримуваних функцій витягування або окремого шару трансформації.
Практичний шаблон - це поєднання метаданих з іншою відповіддю:
- HTML плюс метадані для робочих процесів парсера;
- Markdown плюс метадані для споживання AI;
- скріншот плюс метадані для доказів QA;
- PDF плюс метадані для архівних записів.
Практичний висновок: використовуйте метадані JSON, щоб зрозуміти запит і контекст сторінки, а не як припущення, що кожна сторінка стане індивідуальним структурованим набором даних.
Коли скріншоти та PDF є правильним виходом API для скрапінгу?
Скріншоти та PDF підходять, коли візуальний вигляд є частиною доказів.
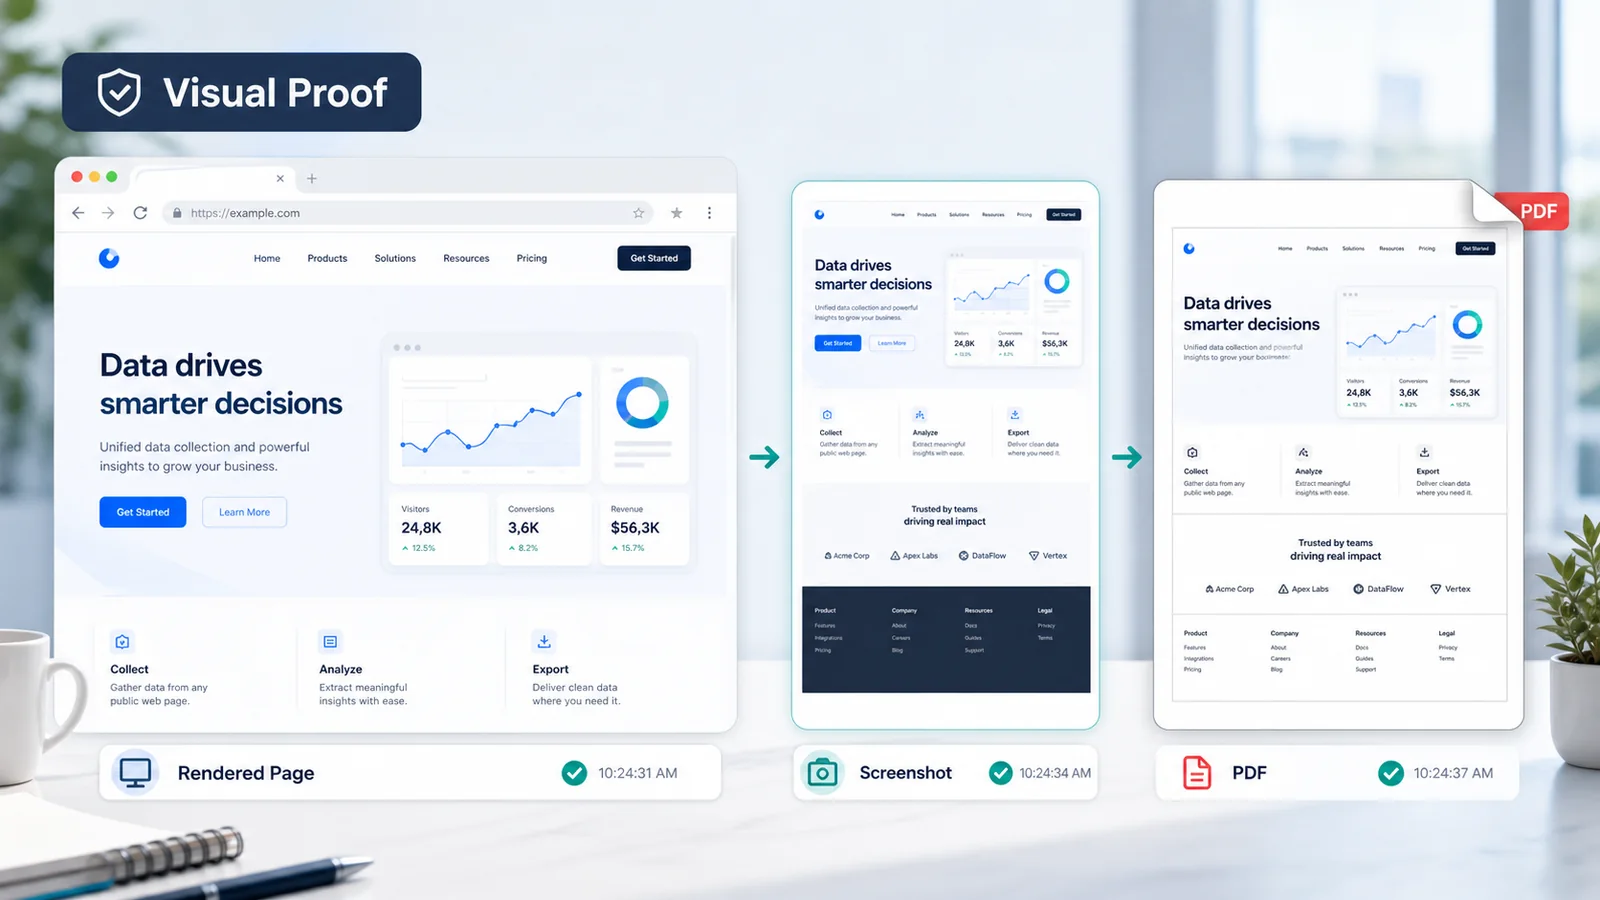
HTML і текст можуть показати, який контент був повернутий, але вони можуть не довести, як браузер відобразив сторінку. Скріншот може захопити макет, видимі помилки, екрани згоди, відсутні компоненти, зміни в адаптивності або регіонально специфічну презентацію.
Скріншоти корисні для:
- моніторингу візуальної регресії;
- QA відрендерованої сторінки;
- перевірки макету;
- перегляду кампаній та цільових сторінок;
- відтворення проблем;
- робочих процесів людського затвердження.
PDF кращі, коли результат повинен бути збережений, поділений, надрукований, переглянутий або збережений як артефакт документа. Вони можуть підтримувати архів, перегляд відповідності, затвердження та ведення оперативних записів.
| Формат доказу | Найкраще використання | Основна перевага | Основне обмеження |
|---|---|---|---|
| Скріншот | Візуальний QA та докази стану сторінки | Показує, що з'явилося у вікні перегляду | Не зручно для структурованого пошуку |
| Архів, перегляд та портативні записи | Зберігає артефакт, схожий на документ | Більший і важчий для парсингу | |
| HTML | Докази джерела та DOM | Структура, що читається машиною | Може не відповідати остаточному візуальному вигляду |
| Текст або Markdown | Докази контенту | Легко шукати та аналізувати | Втрачає візуальний макет |
Візуальний вихід повинен доповнювати дані, що читаються машиною, а не замінювати їх. Робочий процес моніторингу може автоматично порівнювати HTML або текст і генерувати скріншот лише тоді, коли виявлено значну зміну.
Скріншоти та PDF також важчі за звичайний текст або сирий HTML. Перегляньте поточні варіанти кредитів на Ціни перед створенням візуальних артефактів для кожного запиту.
Практичний висновок: вибирайте скріншоти для візуального стану та PDF для портативних записів, зберігаючи HTML або текст, коли системі також потрібні докази, що читаються машиною.
Як рендеринг JavaScript змінює якість формату відповіді?
Рендеринг JavaScript покращує якість виходу лише тоді, коли ціль залежить від виконання браузера.
Сирова HTTP-відповідь може містити повну статтю, сторінку продукту або сторінку документації. У цьому випадку рендеринг додає затримку та вагу запиту без покращення вибраного формату.
Інші сторінки повертають оболонку програми та завантажують контент після того, як браузер запускається. Відповідь Markdown або скріншота, створена до того, як з'явиться цей контент, може бути неповною. Рендеринг дозволяє браузеру побудувати DOM перед тим, як ScraperFly виробляє запитуваний вихід.
Загальні ознаки того, що рендеринг може бути необхідним, включають:
- сирий HTML не містить видимого тексту сторінки;
- списки або таблиці з'являються лише після завантаження сторінки;
- клієнтські фрейми вставляють основний контент;
- скріншот показує порожню оболонку;
- ціль завантажує дані через фонові запити;
- затримані компоненти вимагають контрольованого очікування.
Не припускайте, що вихід Markdown, скріншота або PDF автоматично вимагає рендерингу. Рішення повинно виходити з поведінки цілі.
Спочатку протестуйте сторінку без рендерингу. Шукайте необхідний контент. Потім порівняйте відповідь з запитом, активованим браузером, використовуючи API рендерингу JavaScript.
Практичний висновок: рендеринг покращує формат лише тоді, коли виконання браузера змінює контент, з якого цей формат створюється.
Формат виробництва слід вибрати з подальшої вимоги назад.
Використовуйте цей процес прийняття рішень:
- Визначте споживача. Визначте, чи відповідає відповідь парсеру, LLM, індексу пошуку, рецензенту QA, архіву чи системі моніторингу.
- Визначте необхідні докази. Вирішіть, чи потрібна робочому процесу структура DOM, читабельний контент, контекст запиту, візуальний вигляд або портативний запис.
- Спочатку протестуйте сире захоплення. Підтвердіть, чи існує необхідний контент без рендерингу браузера.
- Порівняйте формати на одному цілі. Оцініть HTML, текст, Markdown, метадані або візуальний вихід, використовуючи один і той же публічний URL.
- Виміряйте очищення. Виберіть відповідь, яка вимагає найменшої надійної індивідуальної трансформації.
- Перевірте розмір і вагу відповіді. Уникайте зберігання або генерації більше даних, ніж використовує програма.
- Документуйте профіль запиту. Запишіть вибраний формат, налаштування рендерингу, очікування, маршрутизацію, заголовки та очікуваний вихід.
Вибраний формат може відрізнятися в залежності від групи цілей. Редакційні сторінки можуть підходити для Markdown, сторінки електронної комерції можуть вимагати HTML, а візуальний моніторинг може поєднувати текст зі скріншотами.
Один глобальний профіль відповіді зручний, але рідко є оптимальним для змішаного виробничого навантаження.
Практичний висновок: вибирайте формати для кожного класу робочих процесів, перевіряйте їх на репрезентативних цілях і записуйте перевірений профіль запиту перед масштабуванням.
Як формати відповіді впливають на вартість і вагу запиту?
Формати відповіді впливають на пропускну здатність, зберігання, час обробки та кредити API.
Основна відповідь HTML або текст зазвичай легша, ніж скріншот або PDF, відрендерені браузером. Різниця стає важливою при виробничому обсязі.
| Профіль виходу | Відносна вага | Вартість виправдана, коли | Уникайте, коли |
|---|---|---|---|
| Сирий HTML | Легкий | DOM або вихідна розмітка потрібні | Потрібен лише читабельний контент |
| Звичайний текст | Легкий | Компактна обробка контенту є метою | Структура та посилання важливі |
| Markdown | Легкий до помірного | AI або редакційні робочі процеси виграють від ієрархії | Потрібен точний парсинг DOM |
| Метадані JSON | Легкі | Контекст запиту підтримує операції | Очікується, що замінить парсинг |
| Відрендерений HTML | Вища | JavaScript створює необхідний контент | Сирий HTML вже повний |
| Скріншот | Вища | Потрібні візуальні докази або QA | Кожен запит обробляється лише машиною |
| Вища | Потрібен портативний архівний запис | Артефакт ніколи не переглядається або не зберігається |
Контроль витрат слід почати з репрезентативних цілей. Групуйте запити за форматом і потребою рендерингу, а не оцінюйте кожен URL так, ніби він вимагає найважчого профілю.
Кредити ScraperFly дозволяють зв'язати вагу запиту з активованими контролями. Команди можуть почати з безкоштовного тесту, порівняти формати та оцінити фактичне навантаження, використовуючи калькулятор вартості кредитів API для веб-скрапінгу.
Практичний висновок: резервуйте відрендерені та файлові виходи для робочих процесів, які використовують їх додаткові докази.
Яких помилок слід уникати командам при виборі виходу API для скрапінгу?
Найпоширеніша помилка - це вибір знайомого формату замість формату, який потрібен продукту.
Уникайте цих шаблонів:
Відправка HTML скрізь. Сирий розмітка додає непотрібне очищення до контенту та AI-пайплайнів.
Використання тексту для точного витягування. Звичайний текст видаляє зв'язки DOM, на які можуть покладатися парсери.
Припущення, що Markdown ідеальний для кожної сторінки. Складні таблиці, інтерактивні компоненти та незвичайні макети можуть не конвертуватися чисто.
Ставлення до метаданих JSON як до індивідуального витягування. Структурований контекст запиту не є тим самим, що й специфічна для цілі бізнес-схема.
Генерація скріншотів для машинних робочих процесів. Візуальні файли додають вагу, але надають мало цінності, коли жодна людина або система візуального порівняння їх не використовує.
Використання PDF як вхідних даних для парсера. PDF є корисними записами, але рідко є найефективнішим джерелом для структурованого витягування.
Рендеринг кожного запиту. Виконання браузера повинно вирішити продемонстровану прогалину в контенті.
Створення конвертерів перед тестуванням форматів. Команда може витратити дні на відтворення виходу, який API вже може повернути.
Використання одного формату для кожної цілі. Різні типи сторінок і споживачі вниз по потоку часто потребують різних профілів.
Тестуйте репрезентативні сторінки через API Builder, порівнюйте вихід і вибирайте на основі зручності використання, а не популярності формату.
Практичний висновок: перевірте відповідь з її реальним споживачем вниз по потоку перед тим, як зобов'язати архітектуру виробництва.
ПИТАННЯ ПОКУПЦЯ
Загальні питання перед вибором формату відповіді
Відповідайте на практичні питання оцінки щодо HTML, тексту, Markdown, метаданих JSON, скріншотів, PDF, рендерингу, ваги запиту та зручності використання в виробництві.
OUTPUT FAQMarkdown, текст та AI-пайплайни
Виберіть читабельний вихід, коли споживачем є пошук, RAG, редакційний перегляд або легкий аналіз контенту.
Чи завжди Markdown є найкращим форматом для AI або RAG пайплайна?
Ні. Markdown корисний, коли заголовки, списки та посилання покращують контекст документа. Звичайний текст може бути кращим для компактної обробки, тоді як HTML може бути необхідним, коли контент спочатку потрібно вибрати з конкретних елементів DOM.
Чи може один додаток використовувати різні формати відповіді для різних цілей?
Так. Виробничий додаток може класифікувати цілі за робочим процесом. Сторінки документації можуть використовувати Markdown, сторінки продуктів можуть використовувати HTML, а цілі візуального моніторингу можуть використовувати скріншоти.
HTML плюс контекст відповіді
Використовуйте структурований контекст для налагодження, маршрутизації та ведення журналу запитів, не вдаючись до метаданих як до індивідуального витягувача.
Чи може API для скрапінгу повернути HTML та метадані для одного й того ж робочого процесу?
Так, робочий процес може використовувати контент сторінки разом з контекстом відповіді. HTML підтримує парсинг, тоді як метадані можуть записувати статус, фінальний URL, тип контенту, розмір відповіді та інші деталі запиту, підтримувані API.
Чи автоматично витягує JSON вихід продукти або поля статей?
Ні. Метадані JSON описують захоплення або відповідь. Їх не слід інтерпретувати як автоматичне витягування випадкових полів, таких як ціни, автори, рейтинги або атрибути продукту.
Скріншоти, PDF та відрендерений вихід
Додавайте візуальні артефакти, коли важливі перегляд, архів або докази зовнішнього вигляду, а не для кожного запиту лише для машини.
Чи слід генерувати скріншоти для кожної моніторингової сторінки?
Зазвичай ні. Читабельний HTML або текст краще для автоматизованого порівняння. Скріншоти найбільш цінні, коли зміна вимагає візуального підтвердження, людського перегляду або доказів макету.
У чому різниця між відрендереним HTML та скріншотом?
Відрендерений HTML містить DOM після виконання браузера і залишається підходящим для парсингу. Скріншот - це зображення, що показує, як сторінка виглядала візуально. Ці два формати відповідають на різні запитання.
Коли робочий процес скрапінгу повинен використовувати вихід PDF?
Використовуйте PDF, коли захоплена сторінка повинна стати портативним документом для перегляду, затвердження, архівування або ведення записів. Використовуйте HTML, текст або Markdown, коли автоматизована обробка є основною вимогою.
Тестування перед інтеграцією
Порівняйте формати на репрезентативних цілях перед тим, як команда створює конвертери або масштабує важкий профіль.
Як розробники повинні порівнювати формати перед інтеграцією?
Запустіть один і той же репрезентативний цільовий URL через API Builder, використовуючи кілька форматів. Порівняйте структуру, відсутній контент, розмір відповіді, потреби в рендерингу, вимоги до очищення та зручність використання вниз по потоку перед вибором виробничого профілю.
Тестуйте форму відповіді перед зобов'язанням архітектури
Пайплайн скрапінгу стає легшим для підтримки, коли API повертає форму, яку продукт може використовувати негайно.
ScraperFly дозволяє командам захоплювати публічні сторінки як HTML, текст, Markdown, метадані JSON, скріншоти або PDF через одну модель запиту. Почніть з репрезентативної цілі, порівняйте формати в API Builder, активуйте рендеринг браузера лише тоді, коли сторінка цього вимагає, і зберігайте візуальні виходи для робочих процесів, які використовують візуальні докази.
Найкращий формат відповіді - це не той, що має найбільше даних. Це той, що усуває непотрібну обробку, зберігаючи докази, які потрібні вашій програмі.









