






Потік роботи на бекенді
Залиште Node.js зосередженим на оркестрації, поки ScraperFly займається захопленням
Node.js є природним місцем для бекенд-завдань, черг, API маршрутів, агентів, панелей управління та подій, що керуються подіями. Він не повинен ставати кастомною браузерною платформою, перш ніж ваша команда дізнається, чи є відповідь публічної сторінки придатною.
ScraperFly надає Node.js сервісам чистий шар захоплення: отримайте публічну URL-адресу, виберіть HTML, текст, Markdown, метадані JSON, скріншот або PDF, і додайте рендеринг, сесії, заголовки, маршрутизацію по країні, затримки або більш сильну доставку лише тоді, коли ціль доведе, що ці контролі покращують результат.
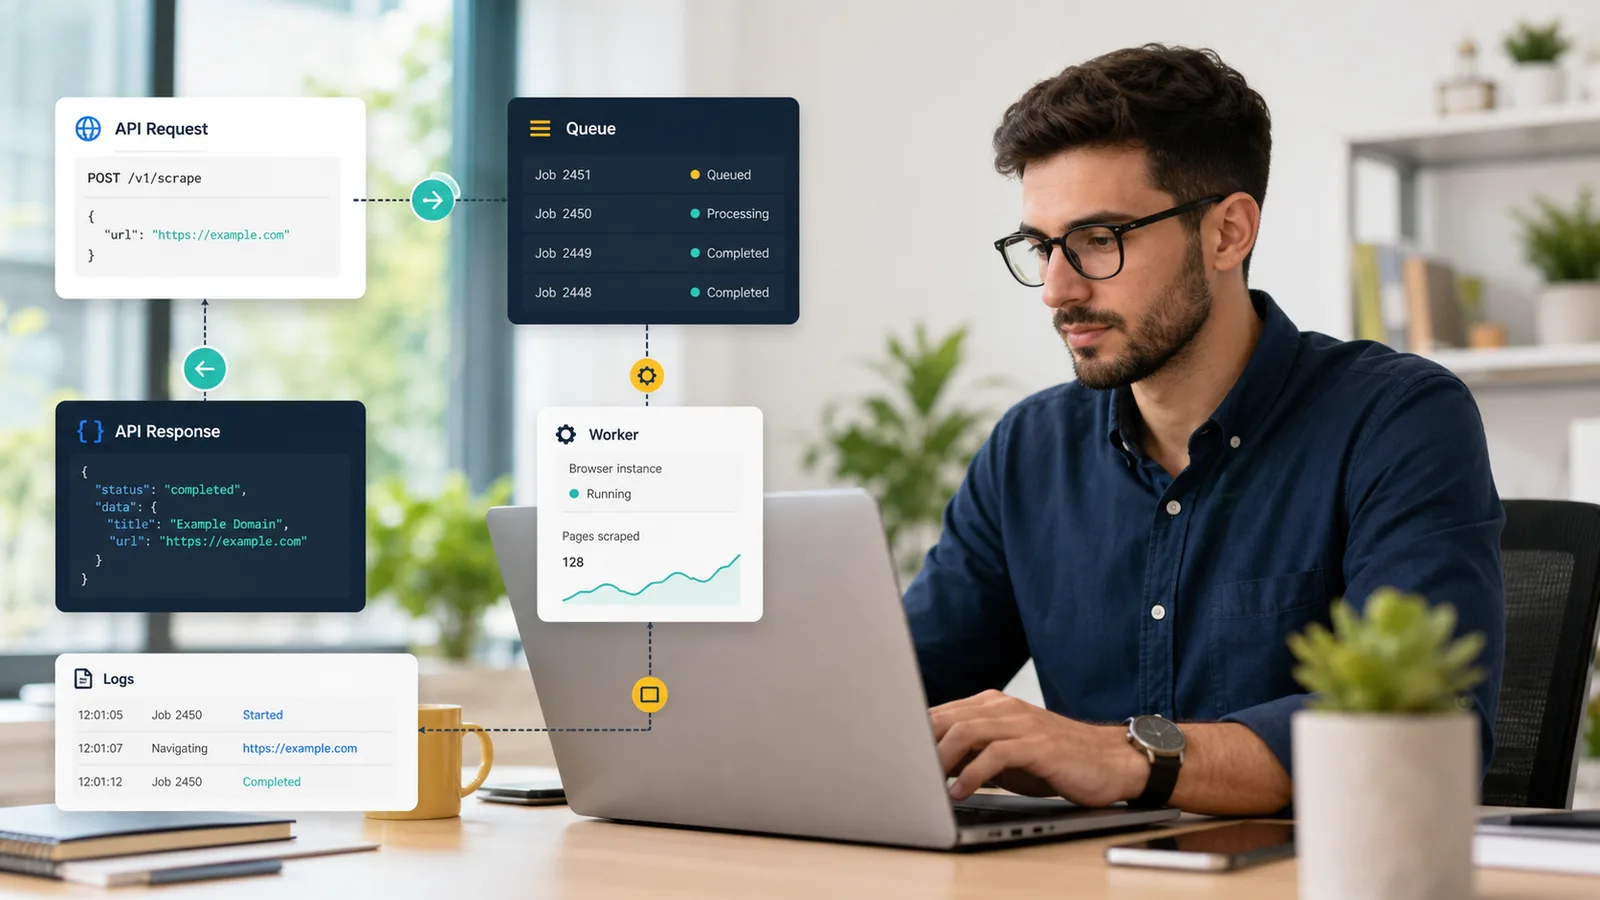
Як працює API веб-скрапінгу Node.js?
Потік роботи API веб-скрапінгу Node.js надсилає публічну цільову URL-адресу та параметри запиту з бекенд-сервісу до розміщеного шару захоплення. API отримує сторінку, застосовує контролі рендерингу або маршрутизації за потреби та повертає відповідь, яку ваше Node.js застосування може обробити. Ваш код залишається відповідальним за парсинг, валідацію, поведінку черги, зберігання, сповіщення та логіку продукту.
Ця межа робить бекенд легшим для обслуговування. Замість того, щоб змішувати автоматизацію браузера, обробку проксі, повторні спроби, конвертацію відповідей та витягування полів в один сервіс, додаток Node.js може викликати один запит і зберігати решту конвеєра явною. Робітник може захопити сторінку, перевірити статус і метадані, парсити необхідні поля та вставити результат у базу даних або систему нижнього рівня.
Практична порада: використовуйте ScraperFly для надійного захоплення публічних сторінок і дайте Node.js володіти специфічним для застосування потоком роботи навколо відповіді.
Що повинна довести перша запит на скрапінг Node.js?
Перша запит повинна довести цільову сторінку та формат відповіді, перш ніж код стане повторно використовуваним. Надішліть одну репрезентативну URL-адресу, зберігайте профіль запиту легким і перевірте результат. Перевірте фінальну URL-адресу, статус, тип контенту, розмір відповіді, тіло та чи присутні поля, які потрібні вашому парсеру. Якщо вихідний HTML вже містить корисний контент, бекенд може залишатися простим. Якщо сторінка є оболонкою програми або відсутні важливі поля, порівняйте відрендерений вихід перед тим, як перетворити кожне завдання на запит браузера.
Це важливо, оскільки команди Node.js часто швидко переходять від успішного тесту до черги або робітника. Якщо перший запит перевантажений рендерингом, преміум маршрутизацією, тривалими затримками або візуальним виходом, цей дорогий профіль може стати за замовчуванням, перш ніж хтось дізнається, який варіант насправді мав значення. Кращий потік роботи доводить один тип сторінки за раз і зберігає кожен контроль прив'язаним до доказів.
| Перевірка бекенду | Що це доводить | Що має зробити наступним завдання Node.js |
|---|---|---|
| Вихідна відповідь | Чи містить сирий HTML корисні поля | Зберігайте завдання легким, коли захоплення джерела достатньо. |
| Відрендерена відповідь | Чи змінює JavaScript контент | Увімкніть рендеринг лише для шаблонів, які потребують виконання браузера. |
| Метадані відповіді | Статус, фінальна URL-адреса, тип контенту, розмір та докази запиту | Зберігайте це з журналами завдань перед парсингом або повторними спробами. |
| Формат виходу | Чи потребує споживач нижнього рівня розмітки, читабельного контенту, метаданих або візуальних доказів | Виберіть форму відповіді перед створенням конвертерів. |
| Тип помилки | Чи є проблема з введенням, авторизацією, поведінкою цілі, обмеженням швидкості, мережею або рендерингом | Виправте конфігурацію, повторіть з затримкою або навмисно ескалюйте. |
Який формат відповіді має запитувати Node.js?
Найкращий формат - це той, який ваш бекенд може використовувати без додаткового очищення. HTML корисний, коли парсеру потрібна структура DOM, посилання, атрибути, таблиці або вбудовані метадані. Відрендерений HTML корисний, коли виконання браузера створює фінальний DOM. Текст і Markdown краще, коли потік роботи потребує читабельного контенту для пошуку, резюме, контексту агента, RAG-інгестії або перегляду контенту. Метадані JSON корисні для журналів та оперативних рішень. Скріншоти та PDF краще для QA, затверджень, моніторингу, архівів або візуальних доказів.
Не вибирайте HTML скрізь лише тому, що він знайомий. Сервіс Node.js, який постачає LLM, може виграти від Markdown. Робітник моніторингу може потребувати метаданих плюс скріншот. Парсер може потребувати сирий HTML для селекторів. Архів відповідності може потребувати PDF-виходу. Тестуйте форму відповіді на ранніх етапах, щоб сервіс не виростав у шар конвертера, який API може уникнути.
Для глибшого рішення формату використовуйте посібник з форматів відповідей API веб-скрапінгу перед жорстким кодуванням вашої моделі бекенду.
| Споживач Node.js | Формат для тестування | Чому це підходить | На що звернути увагу |
|---|---|---|---|
| Сервіс парсера | HTML або відрендерений HTML | Зберігає селектори, посилання, атрибути та відносини DOM | Вимагає специфічного для цілі витягування та валідації. |
| Пошуковий або AI робітник | Текст або Markdown | Чистіший читабельний контент з меншим шумом макета | Може не зберігати достатньо структури для точного витягування полів. |
| Моніторинг черги | Метадані JSON | Робить статус, фінальну URL-адресу, розмір відповіді та тип контенту видимими | Не замінює парсинг даних цілі. |
| QA або затвердження | Скріншот | Показує, як виглядала відрендерена публічна сторінка | Важчий, ніж машинозчитуваний вихід. |
| Архів або запис перегляду | Створює портативний візуальний документ | Менш зручний для автоматизованого парсингу. |
Коли слід сервісу Node.js увімкнути рендеринг, сесії, заголовки або маршрутизацію?
Увімкніть контролі, коли докази цілі показують реальну потребу. Використовуйте рендеринг JavaScript, коли вихідний HTML неповний, і корисний контент з'являється після виконання браузера. Використовуйте заголовки, коли публічна ціль очікує легітимний контекст запиту, такий як мова, прийнятий тип контенту або поведінка реферера. Використовуйте сесії, коли пов'язані запити залежать від спільних куків або стану. Використовуйте маршрутизацію по країні, коли публічний контент змінюється за регіоном, валютою, мовою, доступністю або поведінкою перенаправлення. Використовуйте більш сильну маршрутизацію, коли повторні зразки показують, що простий шлях не може отримати придатну відповідь.
Ці опції не повинні жити як безмовні значення за замовчуванням у спільному допоміжному класі. Бекенд-черга може обробляти багато типів сторінок, і не всі з них заслуговують на один і той же профіль запиту. Зберігайте профілі явними: статичні сторінки, сторінки з великою кількістю JavaScript, регіональні сторінки, станні потоки та завдання з візуальними доказами повинні бути достатньо окремими, щоб витрати та невдачі залишалися зрозумілими.
Для сторінок, створених браузером, перегляньте API рендерингу JavaScript. Для спільного стану використовуйте API сесій. Для контексту запиту дивіться кастомні заголовки. Для рішень щодо шляху доставки порівняйте сторінку API веб-скрапінгу з ротацією проксі.
Як робітники Node.js повинні обробляти невдачі скрапінгу?
Робітники Node.js потребують невдач, з якими можна діяти. Неправильна URL-адреса, недійсний ключ, непідтримуваний формат або несумісний параметр файлу повинні зупинити завдання та вказати на конфігурацію. Тайм-аут, обмеження швидкості, помилка 5xx на стороні сервера, проблема з підключенням, несподіване перенаправлення, тонка HTML-оболонка або тайм-аут рендерингу повинні бути зафіксовані з профілем запиту та оброблені з обмеженою повторною спробою або іншим тестом захоплення. Ставтеся до кожної невдачі як до доказу, а не просто до рядка виключення.
Це особливо важливо в чергах. Один поганий профіль може множитися на сотні завдань, якщо логіка повторних спроб занадто широка. Зберігайте метадані відповіді поруч з результатом кожного завдання: статус, фінальна URL-адреса, тип контенту, розмір відповіді, формат виходу, вибір рендерингу, вибір маршрутизації, час затримки та кількість повторних спроб. Коли невдачі групуються за типом цілі, команда може виправити профіль, а не здогадуватися в коді застосування.
Розділ повторного використання обробки помилок нижче розширює ці групи, але правило бекенду просте: зупиняйте помилки конфігурації, обережно повторюйте тимчасові невдачі та ескалюйте лише тоді, коли повторні зразки виправдовують важчий запит.
Як черги скрапінгу Node.js можуть залишатися передбачуваними?
Передбачувані черги починаються з класифікації сторінок. Відокремлюйте прості HTML-завдання від відрендерених сторінок, потоків, що залежать від сесій, регіональних цілей, випадків преміум маршрутизації, захоплень скріншотів та архівів PDF. Кожен клас повинен мати свій власний профіль запиту, очікування паралельності, поведінку повторних спроб та ведення журналу. Це дозволяє малому скрапу не успадковувати витрати найважчої цілі в системі.
Модель кредитів ScraperFly підтримує цей стиль роботи, оскільки команди можуть тестувати невеликі обсяги, зберігати нерівномірні проекти на кредитах за фактом, і переміщати повторювані навантаження на місячні кредити, коли обсяг стає зрозумілим. Важливий крок - знати, які профілі ваші реальні цілі потребують, перш ніж збільшувати паралельність.
Використовуйте цінову політику після тестування реальних URL-адрес, а не до. Правильна оцінка залежить від того, чи є ваші завдання в основному сирим HTML, відрендереним HTML, потоками на основі сесій, преміум маршрутами, візуальними файлами або їх комбінацією.
Що має належати Node.js після захоплення?
Node.js має володіти робочим процесом, який є унікальним для вашого продукту: черги, робітники, повторні спроби, модулі парсера, правила валідації, дедуплікація, зберігання, вебхуки, сповіщення, панелі управління та інтеграції нижнього рівня. ScraperFly має володіти шаром захоплення публічних сторінок: доставка запитів, рендеринг за потреби, сесії, заголовки, маршрутизація, формати відповідей, скріншоти, PDF та докази відповіді.
Ця межа надає бекенду стабільний контракт. Якщо парсинг ламається, перевірте захоплену відповідь і оновіть селектори. Якщо захоплення ламається, відрегулюйте профіль запиту. Якщо черга зростає, налаштуйте паралельність і класи завдань без переписування інфраструктури браузера. Сервіс залишається нудним у найкращому сенсі: чіткі входи, чіткі виходи та менше прихованих рухомих частин.
З чого повинна почати команда Node.js?
Почніть з однієї реальної публічної цілі в API Builder або cURL, а потім перенесіть перевірений запит у Node.js. Спочатку протестуйте сирий HTML, порівняйте відрендерений вихід, коли контент відсутній, виберіть формат відповіді, який може використовувати ваш бекенд, і зафіксуйте достатньо метаданих, щоб пояснити майбутні невдачі.
Після того, як перший тип сторінки працює, навмисно додайте партії. Зберігайте профілі запитів видимими в коді, уникайте одного глобального "важкого скрапу" допоміжного класу та дайте черзі масштабуватися навколо доказів з реальних відповідей.












