






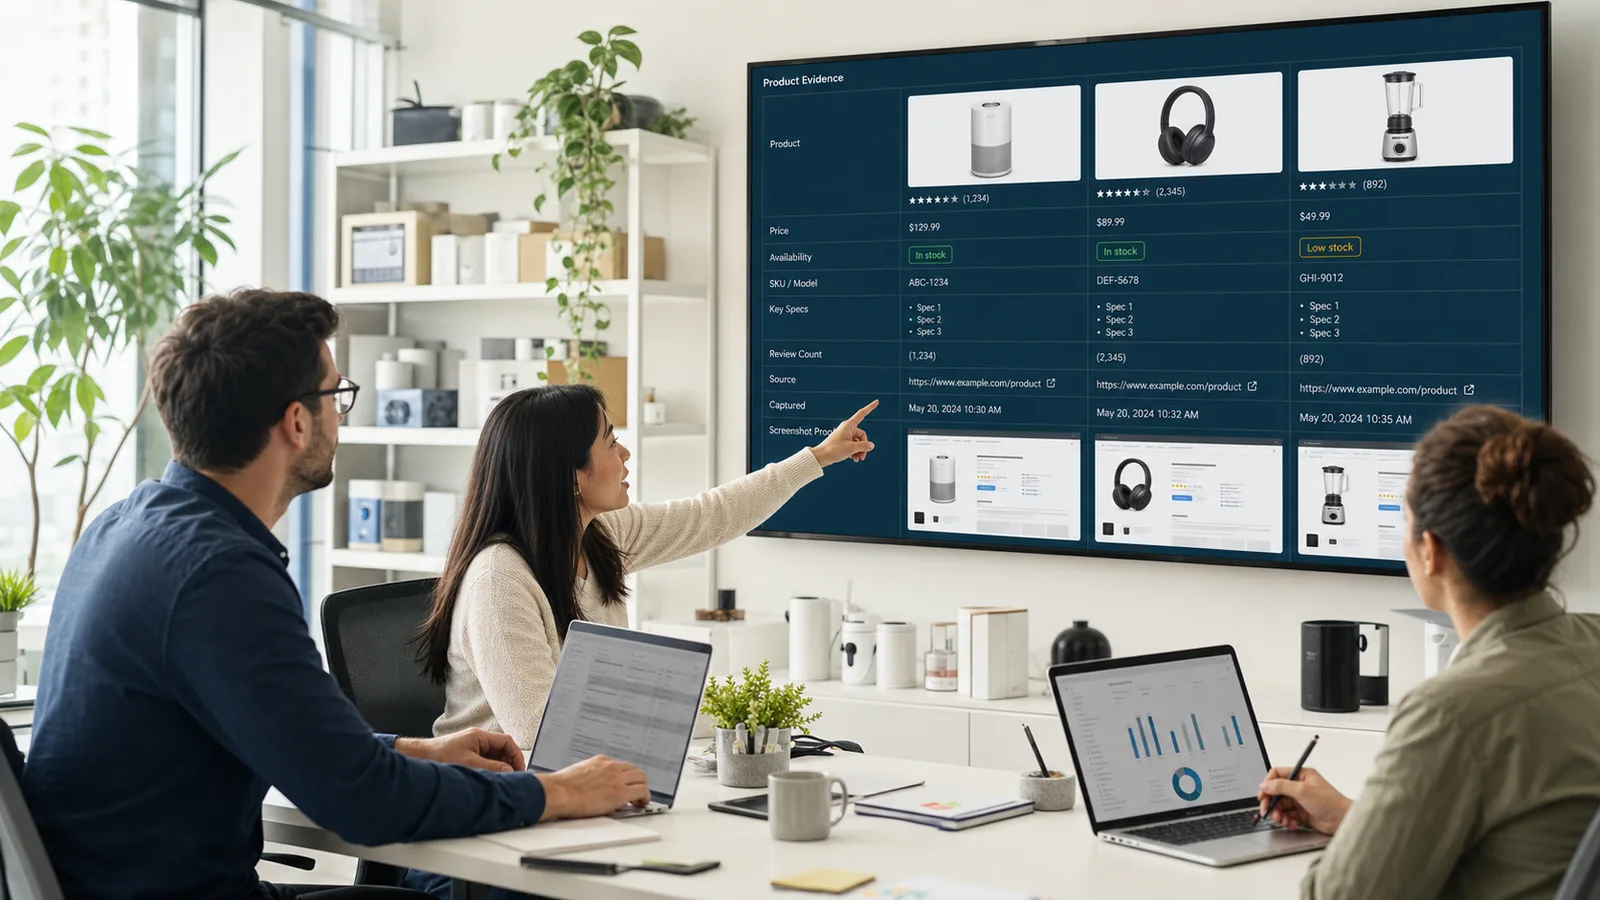
Докази продукту
Збирайте сторінки продуктів з ціною, наявністю, заявами та контекстом джерела
Дослідження продуктів залежить від публічних доказів, розкиданих по сторінках продуктів, списках ринків, категоріях, відгуках, сторінках цін, документації, журналах змін та сторінках запуску. ScraperFly допомагає командам захоплювати ці джерела в практичних форматах, перш ніж вони інвестують у нормалізацію, збагачення або регулярний моніторинг.
Цінність полягає не лише в отриманні URL. Корисний запис продукту повинен пояснювати, звідки він взявся, коли був захоплений, який варіант або стан продавця був видимий, який формат відповіді використовувався, і чи змінило рендеринг або візуальне підтвердження результат. Цей контекст допомагає зберегти дослідницьку роботу на землі, коли джерела, категорії та ритм все ще змінюються.
Що таке веб-скрапінг для дослідження продуктів?
Веб-скрапінг для дослідження продуктів означає захоплення публічних сторінок, пов'язаних з продуктами, щоб команди могли вивчати ринки, категорії, конкурентів, асортимент, ціни, заяви про продукти, відгуки, наявність та структуру каталогу. Джерела можуть включати сторінки деталей продукту, списки ринків, категорії, сторінки брендів, сторінки магазинів, сторінки відгуків, документацію продукту, сторінки порівняння та оголошення про запуск.
ScraperFly підходить як шар захоплення. Він отримує публічну сторінку та повертає HTML, рендерений HTML, текст, Markdown, метадані, скріншоти або PDF в залежності від потреб робочого процесу. Система продукту нижнього рівня може потім витягувати поля, нормалізувати атрибути, об'єднувати дублікати записів, картографувати категорії, оцінювати можливості продукту або маршрутизувати зразки для перегляду.
Ця відокремленість важлива. ScraperFly не вдається, що кожне джерело продукту має однакову схему або що кожна сторінка автоматично стає чистим каталогом. Він надає командам надійне захоплення джерел і докази відповіді, щоб дослідження продуктів могло починатися з реальної поведінки сторінки, а не крихких припущень.
Практичний висновок: використовуйте скрапінг продуктів, щоб спочатку зберегти публічні докази джерел, а потім нормалізувати та порівнювати записи в системі, яка розуміє вашу модель продукту.
Які джерела продуктів варто захоплювати?
Найкращі робочі процеси дослідження продуктів починаються з карти джерел. Сторінки деталей продукту розкривають назву, бренд, SKU, варіант, ціну, наявність, зображення, опис, специфікації, рейтинги та контекст продавця. Сторінки категорій розкривають асортимент, позиціонування, рейтинг, фільтри та пагінацію. Списки ринків розкривають продавців, стан запасів, конкурентні пропозиції, підказки щодо доставки та мову акцій. Сторінки відгуків можуть додати контекст публічної репутації, тоді як документація та журнали змін можуть розкрити можливості продукту та рух релізів.
Не масштабуйте кожне джерело одночасно. Протестуйте невелику групу репрезентативних сторінок продуктів, категорій та ринків. Порівняйте HTML джерела з рендереним виходом. Перевірте, чи поля з'являються послідовно. Перевірте, чи ціна та наявність змінюються в залежності від регіону, продавця, стану cookie або вибору варіанту. Потім перетворіть лише перевірені типи джерел у регулярне захоплення.
| Тип джерела | Корисні докази | Загальний ризик | Найкращий вибір захоплення |
|---|---|---|---|
| Сторінки деталей продукту | Назва, бренд, SKU, ціна, зображення, специфікації, наявність | Варіанти, JavaScript, регіональні пропозиції, зміни продавців | HTML або рендерений HTML з метаданими |
| Сторінки категорій | Асортимент, фільтри, рейтинг, пагінація, картки продуктів | Динамічне сортування, спонсоровані розміщення, дублікати продуктів | HTML, Markdown, зразки скріншотів |
| Списки ринків | Продавець, ціна, стан запасів, підказки щодо доставки, контекст пропозиції | Персоналізація, регіональна наявність, поведінка анти-бота | Рендерене захоплення, докази маршрутизації, зразки підтвердження |
| Сторінки відгуків | Рейтинг, кількість відгуків, публічні фрагменти, теми | Пагінація, запити на вхід, часто змінювані кількості | Текст, Markdown, метадані, вибрані скріншоти |
| Документи та сторінки запуску | Заяви про функції, примітки про реліз, специфікації, мова позиціонування | Шум шаблону, динамічні секції, змінені шляхи документів | Markdown або текст з метаданими джерела |
Які поля продукту команди повинні визначити першими?
Схема дослідження продукту повинна бути достатньо специфічною, щоб підтримувати рішення. Загальні поля включають назву продукту, бренд, SKU або модель, категорію, варіант, продавця, ціну, валюту, знижку, стан запасів, URL зображення, опис, специфікації, рейтинг, кількість відгуків, URL джерела, фінальний URL, мітку часу, статус відповіді та формат виходу. Для чутливих записів скріншот може зберегти видиме підтвердження стану продукту.
Точна схема залежить від роботи. Дослідження асортименту може цікавити категорію, бренд та сім'ю продуктів. Перевірки цін потребують валюти, продавця, варіанту та контексту акцій. Збагачення каталогу може вимагати специфікацій та зображень. Виявлення продуктів може вимагати описів, заяв, відгуків та тексту порівняння. Моніторинг потребує міток часу та достатнього контексту джерела, щоб пояснити, чому поле змінилося.
| Група полів | Приклади | Чому це важливо | Примітка щодо захоплення |
|---|---|---|---|
| Ідентичність | Назва, бренд, SKU, модель, категорія, URL джерела | Допомагає зіставити записи продуктів між джерелами. | Зберігайте фінальний URL та мітку часу для відстеження. |
| Комерційний стан | Ціна, валюта, знижка, запаси, продавець, підказка щодо доставки | Підтримує перевірки цін та порівняння пропозицій. | Зберігайте варіант та регіональний контекст. |
| Деталі продукту | Опис, специфікації, зображення, сумісність, заяви про функції | Підтримує збагачення каталогу та виявлення продуктів. | Використовуйте HTML для структурованих полів або Markdown для відгуків. |
| Репутація | Рейтинг, кількість відгуків, публічні фрагменти | Додає контекст ринку без заміни аналізу. | Зберігайте докази джерела та уникайте трактування фрагментів як повного настрою. |
| Доказ | Скріншот, PDF, метадані відповіді, налаштування захоплення | Полегшує аудит зразків високої цінності. | Використовуйте для QA та важливих змінених записів. |
Коли сторінки продуктів потребують рендерингу або сильнішої доставки?
Багато сторінок продуктів містять корисні поля в HTML джерела. Ці сторінки можуть залишатися легкими. Інші сторінки формують ціну, стан запасів, варіанти, відгуки, галереї зображень, рекомендації або картки продуктів після виконання JavaScript. Рендеринг корисний, коли він змінює докази, які потрібні робочому процесу продукту. Час очікування корисний, коли контент з'являється пізно. Сильніша доставка або регіональна маршрутизація корисні, коли сторінка повертає неповний, заблокований або специфічний для ринку контент.
Найкращий шлях базується на доказах. Спочатку захопіть HTML джерела, порівняйте рендерений вихід на репрезентативних зразках, перевірте фінальний URL та розмір відповіді, а потім виріште, чи рендеринг, очікування, заголовки, сесії, цільова країна або преміум маршрутизація повинні бути частиною цього профілю джерела. Сторінки API рендерингу JavaScript, цільова країна та формати відповідей допомагають командам свідомо приймати ці рішення.
Практичний висновок: зберігайте прості джерела продуктів легкими та залишайте важчі контролі для сторінок, де зразки доводять, що вони покращують якість полів.
Як команди повинні впоратися з якістю даних продукту?
Дані продукту швидко стають безладними. Один і той же продукт може з'являтися під різними назвами, продавцями, валютами, категоріями або варіантами. Список може показувати знижку в одному регіоні та повну ціну в іншому. Кількість відгуків змінюється. Зображення обертаються. Специфікації продукту можуть бути приховані за вкладками. Сторінка категорії може включати спонсоровані продукти або персоналізацію. Шар захоплення повинен зберігати достатньо доказів, щоб система нижнього рівня могла нормалізувати ці відмінності.
ScraperFly допомагає, роблячи захоплення джерел повторюваним та перевіряємим. Зберігайте URL джерела, фінальний URL, статус, тип контенту, розмір відповіді, мітку часу, формат виходу та артефакти підтвердження, коли це необхідно. Потім використовуйте вашу модель продукту для видалення дублікатів, картографування категорій, очищення атрибутів, об'єднання пропозицій продавців та визначення, які поля є достатньо надійними для аналізу або автоматизації.
Як дослідження продуктів може залишатися доступним?
Дослідження продуктів часто починається з експериментів: категорія, конкурент, ринок, кілька сімей продуктів, кілька регіонів. Це не повинно вимагати великої фіксованої підписки, перш ніж якість джерела буде доведена. Почніть з безкоштовних кредитів, протестуйте репрезентативні сторінки, купуйте кредити за принципом "плати за те, що використовуєш" для нерівномірних досліджень, і переходьте до регулярного збору лише на місячні кредити, коли ритм джерела та профіль запитів стануть зрозумілими.
Вага запиту також має значення. HTML, текст та Markdown можуть покривати багато сторінок дослідження. Рендеринг, очікування, скріншоти, маршрутизація по країнах, сесії та преміум доставка належать до джерел, де вони покращують захоплені докази. Сторінки калькулятора вартості кредитів та цін допомагають оцінити вплив перед розширенням категорій або ринків.
Чому варто використовувати ScraperFly для дослідження продуктів?
ScraperFly надає командам продуктів, зростання, даних та досліджень один шар API для захоплення публічних джерел продуктів. Він може повернути сирий HTML для витягування, рендерений HTML, коли важливий JavaScript, текст або Markdown для відгуків, метадані для ведення обліку та скріншоти або PDF для візуального підтвердження. Він також зберігає контролі доставки явними, щоб команди могли вибирати сесії, заголовки, цільову країну, очікування або преміум маршрутизацію лише тоді, коли докази підтримують важчий запит.
Це робить дослідження продуктів легшими для початку та безпечнішими для масштабування. Команди можуть дешево тестувати джерела, зберігати контекст джерела, порівнювати формати відповідей та перетворювати перевірені сторінки в регулярні робочі процеси без необхідності спочатку будувати крихку інфраструктуру для отримання, рендерингу, проксі, скріншотів та очищення.











































