






ScraperFlyWebdaten-API für KI

request control

Benutzerdefinierte Header Scraping API mit Unterstützung für Cookies

ScraperFly ermöglicht es Teams, ausgewählte Header und Cookies für öffentliche Seiten weiterzuleiten, wenn der Anfragekontext die Antwort ändert, während die Header-Profile klein, testbar und einfach zu debuggen bleiben.

Anforderungs-Kontext

Nur die Header senden, die die öffentliche Antwort klarer machen

ScraperFly hilft Teams, den Anforderungs-Kontext hinzuzufügen, ohne jedes Scraping in eine kopierte Browsersitzung zu verwandeln. Beginnen Sie mit einer sauberen Basislinie und leiten Sie dann nur die Header oder Cookies weiter, die die öffentliche Antwort tatsächlich ändern: Sprache, akzeptierter Inhaltstyp, Zustimmungsstatus, Referer-Pfad, Geräteverhalten oder von der Website authentifizierte Präferenzen, die bereits in Ihrem Workflow verfügbar sind.

Das hält das Scraping von benutzerdefinierten Headern verständlich. Entwickler können die Antworten vor und nach dem Scraping vergleichen, sehen, was sich geändert hat, und Header nur dann mit Rendering, Sitzungen, Länderauswahl oder stärkerem Routing kombinieren, wenn die Beweise die zusätzliche Kontrolle unterstützen.
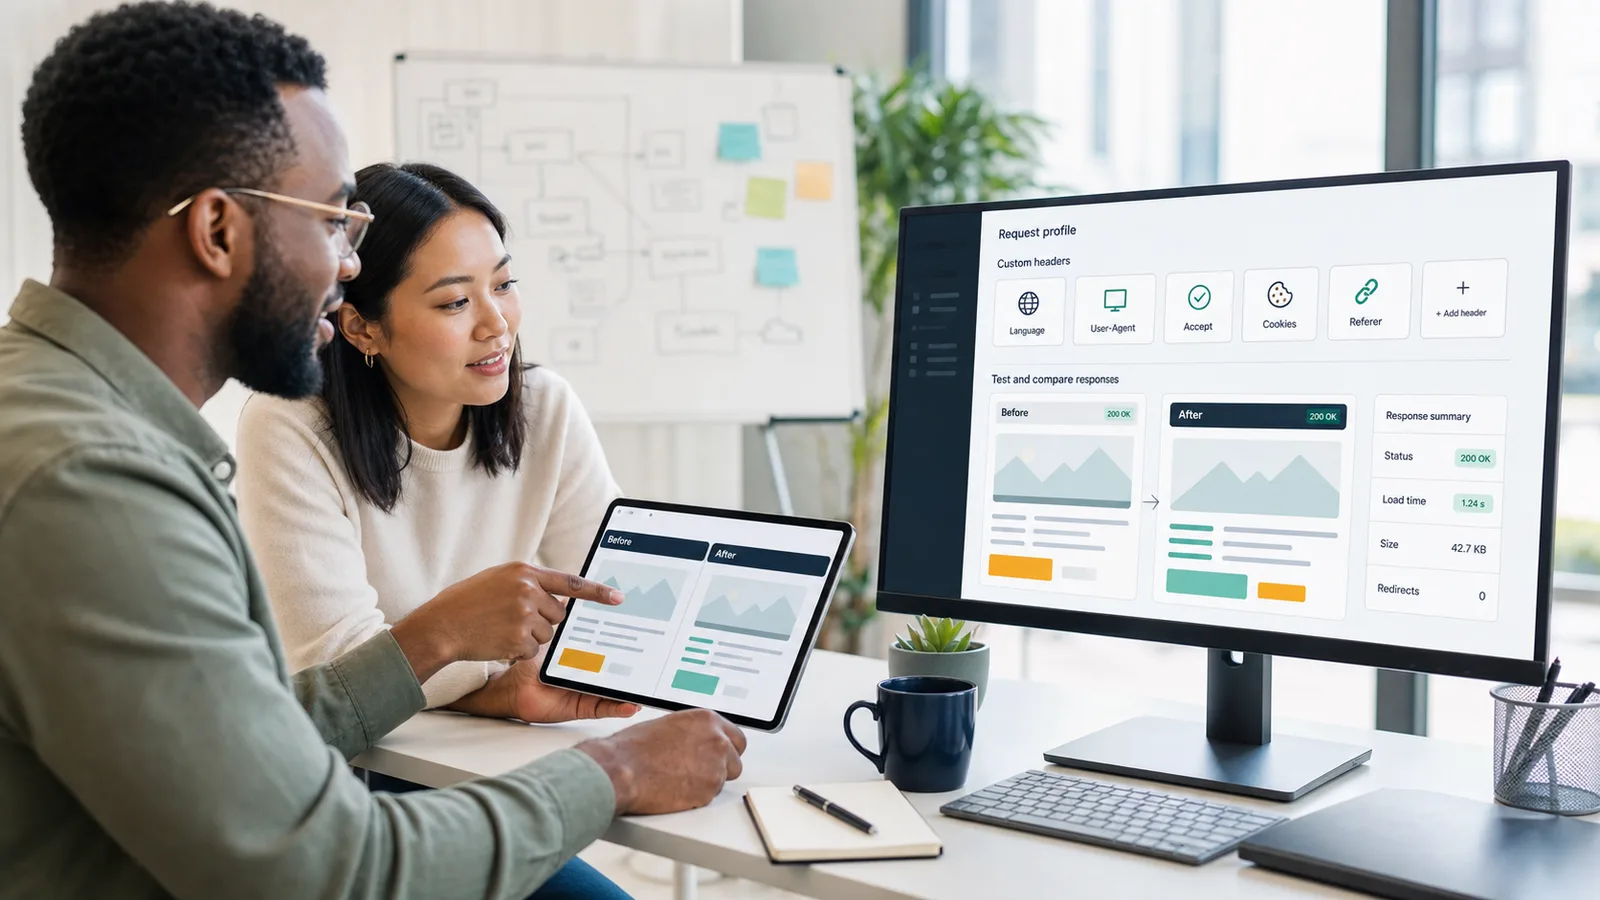
ausgewählte HeaderCookiesBasislinienvergleich
Entwickler vergleichen benutzerdefinierte Header- und Cookie-Antwortprofile in einem Scraping-API-Anforderungs-Builder

Was ist eine API zum Scraping von benutzerdefinierten Headern?

Eine API zum Scraping von benutzerdefinierten Headern ist eine gehostete Anforderungsschicht, die eine öffentliche Seite abrufen kann, während sie ausgewählte HTTP-Header oder Cookies mit der Anfrage sendet. Anstatt für jedes Ziel einen separaten Abruf-Stack zu erstellen, sendet Ihre Anwendung die Ziel-URL, wählt das Ausgabeformat und die Lieferkontrollen aus und fügt den Anforderungs-Kontext nur hinzu, wenn die Zielantwort beweist, dass es wichtig ist.

Header sind kein magischer Umgehungsweg. Sie sind Kontextsignale. Eine öffentliche Seite kann unterschiedlich auf Sprachpräferenzen, akzeptierte Inhaltstypen, Benutzer-Agent-Familien, Referer-Kontext, Cache-Direktiven oder Cookies reagieren. Das Ziel ist es, diesen Kontext explizit und testbar zu machen, damit der Scraper die nützliche Antwort reproduzieren kann, ohne unnötigen Browser-Müll zu tragen.

Praktische Erkenntnis: Verwenden Sie benutzerdefinierte Header, um einen erforderlichen Anforderungs-Kontext zu erklären, nicht um ein unklareres Scraping-Profil zu verschleiern.

Wann sollte eine Scraping-Anfrage Header weiterleiten?

Leiten Sie Header weiter, wenn sie die Antwort ändern, die Ihr Produkt verwenden kann. Ein Sprach-Header kann übersetzten Text zurückgeben. Ein Header zur Inhaltsverhandlung kann beeinflussen, ob das Ziel HTML, JSON-ähnliche Daten oder komprimierte Ausgaben sendet. Ein Referer kann für öffentliche Abläufe wichtig sein, die von einer vorherigen Seite abhängen. Cookies können Zustimmung, Währung, Region oder leichten Status bewahren. Das Verhalten des Benutzer-Agent-Stils kann das Layout oder die Markup-Familie ändern, die eine Seite zurückgibt.

Der richtige Workflow ist einfach: Senden Sie eine Basislinienanfrage, inspizieren Sie die Antwort, fügen Sie eine Art von Kontext hinzu und vergleichen Sie dann. Wenn die nützlichen Felder erscheinen, hat das Header-Profil seinen Platz verdient. Wenn sich nichts Wichtiges ändert, entfernen Sie es und halten Sie die Anfrage kleiner.

Header oder Kontext Was es beeinflussen kann Verwenden Sie es, wenn
Accept-LanguageSprache, regionale Kopie, Währungs-Hinweise, lokalisierte LabelsDas Ziel gibt eine andere nützliche Seite nach Region oder Sprache zurück.
Benutzer-Agent-KontextMarkup-Familie, responsives Layout, bot-sensitives VerhaltenDie gleiche URL gibt für verschiedene Client-Profile unterschiedliches HTML zurück.
Accept und Inhalts-HeaderZurückgegebener Inhaltstyp, Kompression, AntwortformDas Ziel verhandelt die Ausgabe basierend auf akzeptierten Formaten.
RefererÖffentlicher Navigationskontext, Umleitungsweg, Kampagnen- oder ListenflussDie Zielantwort hängt vom öffentlichen Seitenpfad ab, der dazu geführt hat.
CookiesZustimmungsstatus, Präferenzen, Währung, Region, Sitzungs-KontinuitätDer Workflow benötigt einen stabilen, legitimen und reproduzierbaren Status.
Content-TypePOST-Body-Verarbeitung und API-ähnliches ZielverhaltenSie senden einen Body und das Ziel erwartet ein bestimmtes Anforderungsformat.

Warum sollten Teams vermeiden, jeden Browser-Header zu kopieren?

Das Kopieren jedes Browser-Headers fühlt sich gründlich an, macht das Scraping jedoch in der Regel schwieriger zu betreiben. Eine echte Browser-Anfrage kann flüchtige Werte, Gerätehinweise, Cache-Zustände, Experimente, Tracking-Kontexte und Header enthalten, die für die benötigten Daten irrelevant sind. Wenn all das standardmäßig weitergeleitet wird, wird es schwieriger, Fehler zu erklären, da die Anfrage keine saubere Ursache-Wirkungs-Beziehung mehr hat.

Ein kleineres Header-Profil ist einfacher zu testen, zu reproduzieren, zu überwachen und in Code zu integrieren. Es macht auch die Kostenentscheidungen klarer. Wenn eine Seite mit Quell-HTML plus einem Sprach-Header funktioniert, gibt es keinen Grund, die Komplexitätskosten für Rendering, Sitzungs-Kontinuität und Premium-Routing zu zahlen. Wenn eine Seite nach dem Vorhandensein des richtigen Kontexts immer noch fehlschlägt, hat das Team stärkere Beweise für den nächsten Eskalationsschritt.

Verwenden Sie den API Builder, um eine Basislinienanfrage mit einer headerbewussten Anfrage zu vergleichen, bevor Sie Parser-Code um das Ergebnis schreiben.

Wie unterscheiden sich Header von Cookies und Sitzungen?

Header beschreiben die Anfrage. Cookies tragen den Status. Sitzungen bewahren die Kontinuität über verwandte Anfragen. Sie arbeiten oft zusammen, lösen jedoch unterschiedliche Probleme. Ein Sprach-Header kann nach einer regionalen Version einer Seite fragen. Ein Cookie kann eine Zustimmungswahl oder Währungspräferenz speichern. Eine Sitzung kann diesen Status konsistent halten, während der Workflow über verwandte öffentliche Seiten wechselt.

Dieser Unterschied ist wichtig, da jede Kontrolle eine klare Aufgabe haben sollte. Wenn eine einzelne öffentliche Seite ein Sprachsignal benötigt, kann ein Header ausreichen. Wenn ein Workflow den Status über eine Suchseite, eine Listen-Seite und eine Detailseite hinweg aufrechterhalten muss, sind Sitzungen geeigneter. Wenn nützliche Inhalte erst nach dem Ausführen von Frontend-Code erscheinen, können Header allein JavaScript-Rendering nicht ersetzen.

Kontrolle Hält oder ändert Beste Verwendung Häufiger Fehler
HeaderAnforderungs-Kontext für eine AnfrageSprache, akzeptierte Ausgabe, Benutzer-Agent-Familie, Referer-KontextWeiterleitung von lauten Browser-Headern ohne Beweise.
CookiesVom Ziel bereitgestellter StatusZustimmung, Präferenzen, regionaler Status, leichte KontinuitätVerwendung von veralteten oder nicht verwandten Cookies über verschiedene Ziele hinweg.
SitzungenKontinuität über verwandte AnfragenMehrstufige öffentliche Abläufe, die von gemeinsamem Status abhängenVerwendung von Sitzungen für isolierte Seiten ohne Abhängigkeit.
RenderingVon Browsern erstellter SeitenstatusSPAs, frontend-geladene Inhalte, Wartezeiten, Screenshots, PDFsRendering von Seiten, bei denen das Quell-HTML bereits die Daten enthält.
LänderauswahlGeografische Anforderungs-PerspektiveSeiten, die je nach Region, Währung, Verfügbarkeit oder Umleitung variierenVerwendung von Geografie, wenn ein einfaches Sprach- oder Cookie-Signal ausgereicht hätte.

Welches Antwortbeweis zeigt, dass ein Header-Profil funktioniert?

Der nützliche Beweis liegt in der Antwort, nicht in der Header-Liste. Vergleichen Sie die endgültige URL, den Statuscode, den Inhaltstyp, die Antwortgröße, die Sprache, sichtbare Felder, extrahierte Links, Umleitungsverhalten und Parser-Ergebnisse über die Proben hinweg. Wenn die einzige Änderung kosmetischer Natur ist, ist der Header möglicherweise nicht wert, behalten zu werden. Wenn die Ziel-Felder verfügbar werden oder sich über Seiten stabilisieren, ist das Profil nützlich.

Wählen Sie die Ausgabe, die den Vergleich erleichtert. HTML ist nützlich, wenn Selektoren und DOM-Beziehungen wichtig sind. Text oder Markdown können es einfacher machen, Inhaltsunterschiede zu lesen. JSON-Metadaten helfen bei Diagnosen wie endgültiger URL, Status, Antwortgröße und Inhaltstyp. Screenshots und PDFs helfen, wenn ein Mensch visuelle Beweise benötigt. Der Leitfaden zu den Antwortformaten erklärt, wann jede Ausgabeform sinnvoll ist.

Praktische Erkenntnis: Behalten Sie einen Header nur, wenn er die Antwort auf eine Weise ändert, die Ihr Produkt nutzen kann oder Ihr Team erklären kann.

Wie funktionieren Header mit Rendering und Routing?

Header können Teil eines umfassenderen Anforderungsprofils sein. Ein Ziel benötigt möglicherweise einen Sprach-Header und rohes HTML. Ein anderes benötigt möglicherweise Cookies und eine persistente Sitzung. Eine JavaScript-lastige Seite benötigt möglicherweise Rendering plus eine Wartezeit. Eine regionssensible Seite benötigt möglicherweise eine Länderauswahl. Ein strengeres Ziel benötigt möglicherweise eine stärkere Lieferung über eine rotierende Proxy-Scraping-API oder Premium-Routing.

Der Fehler besteht darin, jede Kontrolle gleichzeitig zu aktivieren. Das verbirgt, welche Kontrolle das Problem gelöst hat, und macht das Produktionsverhalten schwierig zu optimieren. Beginnen Sie mit Headern, wenn der Anforderungs-Kontext die vermutete Lücke ist, und eskalieren Sie nur, wenn die Antwortbeweise auf Rendering, Sitzungen, Geografie oder Routing hinweisen.

Wie kann das Scraping von benutzerdefinierten Headern vorhersehbar bleiben?

Halten Sie jedes Anforderungsprofil klein, benannt und wiederholbar. Dokumentieren Sie, welche Header weitergeleitet werden und warum. Testen Sie repräsentative URLs, bevor Sie skalieren. Trennen Sie Seitenvorlagen, die unterschiedlichen Kontext benötigen. Verfolgen Sie Status, endgültige URL, Antwortgröße, Inhaltstyp und Qualität der extrahierten Felder, damit schlechte Antworten nicht stillschweigend in die Pipeline gelangen.

Die Kostenkontrolle folgt derselben Logik. Header und Cookies sind oft leichter als Browser-Rendering oder Premium-Routing, aber ein lautes Profil kann dennoch Debugging-Overhead erzeugen. Halten Sie einfache Seiten einfach, reservieren Sie schwerere Kontrollen für Seiten, die nachweisen, dass sie benötigt werden, und überprüfen Sie Preise, bevor Sie eine neue Zielklasse skalieren.

Wo sollte ein Team anfangen?

Beginnen Sie mit einer Basislinienanfrage von ScraperFly für die öffentliche Ziel-URL. Erfassen Sie HTML oder das Antwortformat, das Ihr Parser benötigt. Fügen Sie den kleinsten Header- oder Cookie-Kontext hinzu, der das fehlende oder instabile Ergebnis erklären könnte. Vergleichen Sie die Ausgaben. Wenn die Antwort sich verbessert, behalten Sie das Profil. Wenn nicht, entfernen Sie den Header und untersuchen Sie stattdessen Rendering, Sitzungen, Routing oder ziel-spezifische Fehler.

Für fokussierte Header-Seiten verwenden Sie die speziellen Leitfäden für Benutzer-Agent-Verhalten, Accept-Language und Referer-Kontext. Für praktische Tests öffnen Sie den API Builder und vergleichen Sie die Anforderungsprofile, bevor Sie Produktions-Parser-Code schreiben.


Benutzerdefinierte Header

Senden Sie den Anforderungs-Kontext, den das Ziel versteht, ohne das Scraping-Profil zu verbergen.

Header können Sprache, Inhaltstyp, Geräteverhalten, Cache-Verwaltung und den Zugriff auf öffentliche Seiten beeinflussen. ScraperFly ermöglicht es Teams, Header-Kontext gezielt hinzuzufügen, die Antwort zu vergleichen und die endgültige Anforderungsform einfach zu reproduzieren.

Roh-HTML-Antwort, die auf sichtbare Seitendaten abgebildet ist
01

Verfügbarkeit von Roh-HTML

Überprüfen Sie, ob die benötigten Felder bereits in der ersten HTML-Antwort vorhanden sind.

Bester erster Test für einfache Seiten, Artikel, Dokumente, Listen und Produktdetails.

Vergleich vor und nach der JavaScript-Rendering
02

JavaScript-Abhängigkeit

Vergleichen Sie das Roh-HTML mit dem gerenderten DOM oder Screenshot, bevor Sie das Browser-Rendering aktivieren.

Verwenden Sie Rendering, wenn das Roh-HTML nur eine Hülle ist und Skripte den nützlichen Inhalt erstellen.

Cookies, Zustimmung, Sitzung und Zugriffs-Kontext für das Scraping
03

Status & Zugriffs-Kontext

Identifizieren Sie, ob Cookies, Zustimmung, Anmeldegrenzen, Pagination oder der gleiche Besucherstatus die Antwort beeinflussen.

Verwenden Sie Sitzungen und Header, wenn die Kontinuität die Daten, die Sie erhalten, verändert.

Regionale Inhaltsvariationen über Länder und Routen hinweg
04

Geo-/Inhaltsvariation

Testen Sie, ob Land, Sprache, Währung, Inventar, SERP, Anzeigen oder Routenreputation das Ergebnis verändern.

Verwenden Sie Geo- oder Premium-Routing nur, wenn sichergestellt ist, dass die Antwort je nach Route variiert.

Überprüfungen vor dem Scraping von benutzerdefinierten Headern.

Wo befindet sich das Ziel-Feld?

Finden Sie heraus, ob das Feld im Roh-HTML, im gerenderten DOM, einem API-Aufruf, strukturierten Daten, einer Datei oder einem späteren Interaktionszustand vorhanden ist.

Was ändert die Antwort?

Probieren Sie einige URLs aus und vergleichen Sie Status, endgültige URL, Inhaltslänge, Weiterleitungen, leere Zustände und sichtbare Ergebnisunterschiede.

Welcher Kontext ist erforderlich?

Markieren Sie alle Abhängigkeiten von Zustimmung, Gebietsschema, Cookies, Headern, Authentifizierungsgrenzen, Paginierung, Filtern oder vorherigen Anfragen.

Wie sieht ein Fehler aus?

Definieren Sie die Signale für blockierte, teilweise, veraltete, umgeleitete, leere, zeitüberschreitende oder regionsfremde Antworten, bevor Sie skalieren.

Wie Header das Scraping-Setup ändern.

Abrufmodus

Die Verfügbarkeit von Roh-HTML entscheidet, ob die erste Anfrage einfach bleiben kann oder Rendering, Wartezeiten, Screenshots oder Extraktion benötigt.

Anfragekontext

Statusanforderungen entscheiden, ob Header, Cookies, Sitzungen, Zustimmungsverwaltung oder ein stabiler Besucherprofil hinzugefügt werden müssen.

Routing-Wahl

Geo- und Reputationsfunde entscheiden, ob das Standard-Routing ausreicht oder eine Länder-/Premium-Route gerechtfertigt ist.

Validierungsregeln

Bekannte Fehlerzustände werden zu Prüfungen für Wiederholungen, Eskalationen, QA-Überprüfungen und zur Entscheidung, wann ein leichteres Profil dennoch vollständig ist.

Header-Anforderungs-Builder.

Erstellen Sie Scraping-Anfragen mit Headern, Ausgabeformat und Lieferkontrollen an einem Ort.

Benutzerdefinierte Header sind nützlich, wenn das Ziel je nach Clientsignal variiert oder einen spezifischen öffentlichen Anforderungs-Kontext benötigt. Beginnen Sie mit dem kleinsten Header-Set und fügen Sie Rendering, Sitzungen, Länderauswahl oder stärkeres Routing hinzu, wenn Proben die zusätzliche Komplexität rechtfertigen.

01
01

Fügen Sie nur die Header hinzu, die die Antwort ändern.

Halten Sie das Anforderungsprofil sauber, damit das Team erklären kann, warum jeder Header existiert.

02
02

Überprüfen Sie die Auswirkungen von Headern im Vergleich zu einer Basislinie.

Vergleichen Sie Status, endgültige URL, Inhaltstyp, Größe und extrahierte Felder, bevor Sie skalieren.

03
03

Bewegen Sie das bewährte Header-Profil in den Code.

Kopieren Sie eine reproduzierbare Anfrage in cURL, Python, Node.js, Postman oder einen Backend-Job.

Steuerungen, die Anfragen vorhersehbar halten

cURL-Beispiel

Generieren Sie Markdown mit derselben Anfrageform, die Sie in die Produktion überführen können.

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Fehlerbehandlung

Verwandeln Sie Scraping-Fehler in Lösungen

Jeder Webdaten-Workflow trifft schließlich auf eine schlechte Antwort: eine fehlende URL, einen ungültigen Schlüssel, eine leere HTML-Hülle, ein Ziel 403, ein Ratenlimit, ein Render-Timeout, eine fehlerhafte PDF-Erfassung oder eine JSON-Nutzlast, die nicht die Felder enthält, die Ihr Produkt erwartet hat. ScraperFly ist so konzipiert, dass diese Momente diagnostizierbar sind. Sie überprüfen den HTTP-Status, den stabilen Fehlercode, das Anfrageprofil und das zurückgegebene Artefakt und wählen dann den kostengünstigsten nützlichen nächsten Schritt: die Anfrage beheben, Credits hinzufügen, verlangsamen, mit Backoff erneut versuchen, Rendering aktivieren, das Land ändern, Premium-Routing verwenden, Header beibehalten oder die Ausgabe vor der Skalierung validieren.

Stabile FehlerformEntscheidungen zum erneuten VersuchKostenbewusste EskalationAusgabevalidierung
Entwickler, der Code und API-Anforderungsparameter auf einem Laptop überprüft

01 / Anforderungssetup und Zugriff

Beheben Sie zuerst Anforderungsfehler

Einige Fehler sind überhaupt keine Zielprobleme. Sie treten auf, bevor ScraperFly einen sinnvollen Zustellversuch unternehmen kann: eine fehlende oder fehlerhafte URL, ein nicht unterstütztes Ausgabeformat, ein inkompatibler visueller Dateityp, ein fehlender API-Schlüssel, ein ungültiger Schlüssel oder ein Schlüssel, der pausiert oder deaktiviert wurde. Diese Fehler sind Konfigurationssignale, keine Wiederholsignale: Stoppen Sie den Workflow, weisen Sie den Entwickler auf das genaue Feld hin, das korrigiert werden muss, und konzentrieren Sie die Credits auf echte Zieltests anstelle wiederholter fehlerhafter Eingaben.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Validieren Sie die URL und die Kodierung, bevor Sie einen Batch senden.
  • Verwenden Sie unterstützte Ausgaben: HTML, Text, Markdown, JSON, Screenshot oder PDF.
  • Passen Sie die Screenshot-Dateitypen an den Bildausgang und den PDF-Dateityp an den PDF-Ausgang an.
  • Behandeln Sie fehlende oder ungültige API-Schlüssel als Konfigurationsarbeit, nicht als Wiederholungsarbeit.
Business-Dashboard mit Diagrammen, Dokumenten und Nutzungsplanung auf einem Schreibtisch

02 / Credits, Limits und Parallelität

Trennen Sie Limits von Fehlern

Eine Arbeitslast kann fehlschlagen, weil das Konto keine verwendbaren Credits hat, das monatliche Planlimit erreicht wurde oder die Parallelität für den aktuellen Plan und die Zielmischung zu aggressiv ist. ScraperFly macht diese Grenzen als Betriebssignale sichtbar, nicht als mysteriöse Scrape-Fehler. Das hält die Kaufentscheidung praktisch: kostenlos starten, das Ziel testen, Pay-as-you-go-Credits für unregelmäßige Jobs kaufen, auf monatliche Credits umsteigen, wenn das Volumen vorhersehbar wird, und Backoff verwenden, wenn der Anforderungsdruck das eigentliche Problem ist.

usage_limit_reachedrate_limitedcreditsBackoff
  • Verwenden Sie den Kontostatus, um verbleibende Credits vor großen Ausführungen zu überprüfen.
  • Wiederholen Sie die Ratenlimits mit Backoff, anstatt sofort den Druck zu erhöhen.
  • Halten Sie einmalige Projekte im Pay-as-you-go-Modell, wenn das Volumen unregelmäßig ist.
  • Verschieben Sie vorhersehbare wiederkehrende Arbeiten auf monatliche Credits, wenn das Muster bewiesen ist.
Serverraum, der Lieferwege, Routing und Netzwerk-Infrastruktur darstellt

03 / Zielzustellung und Netzwerk

Finden Sie zuerst Lieferfehler

Viele Scraping-Plattformen fassen Lieferprobleme in einem vagen Anforderungsfehler zusammen. In der Produktion ist das nicht genug. Das Team muss wissen, ob die Anfrage zeitlich abgelaufen ist, das Ziel upstream einen vorübergehenden Serverfehler zurückgegeben hat, die Verbindung fehlgeschlagen ist, die Antwort zu groß war, Weiterleitungen irgendwo unerwartet gingen oder die Seite als winziges HTML ohne nützlichen Inhalt zurückkam. ScraperFly verwandelt diese Fehler in Liefernachweise: Versuchen Sie zuerst das leichte Profil, vergleichen Sie den Status und die Antwortgröße, und entscheiden Sie dann, ob die nächste Anfrage Backoff, eine andere Route, einen Premium-Proxy, Länderauswahl oder eine engere Erfassung benötigt.

Zeitüberschreitung5xxWeiterleitungenAntwort_zu_groß
  • Wiederholen Sie vorübergehende Netzwerk- und Upstream-Fehler mit einer kontrollierten Backoff-Politik.
  • Vergleichen Sie die endgültige URL, den Status, den Inhaltstyp und die Antwortgröße über die Proben.
  • Eskalieren Sie das Routing nur, wenn die Antwort beweist, dass der einfache Pfad instabil ist.
  • Behandeln Sie übergroße Antworten als ein Umfangsproblem, bevor Sie dasselbe Profil skalieren.
Digitaler Sicherheitsbildschirm, der Anti-Bot- und geschützte Zugriffssignale darstellt

04 / Anti-Bot-, Geo- und Zugriffsblöcke

Blöcke lesen, bevor Sie eskalieren

Ein Ziel 403, 401, 429, CAPTCHA-Bildschirm, WAF-Herausforderung, Login-Wall, Einwilligungsloop oder regionsspezifische Fehlanpassung ist nicht nur ein Fehler; es ist ein Hinweis darauf, was die Website vom Besucher erwartet. Wettbewerber drängen oft Teams zu einem schwereren Standardprofil, aber das kann das Budget belasten, ohne die Lösung zu beweisen. Der bessere Weg von ScraperFly ist eine evidenzbasierte Eskalation: realistische Header beibehalten, wenn der Kontext wichtig ist, Sitzungen verwenden, wenn die Kontinuität die Antwort ändert, Rendering aktivieren, wenn der nützliche Inhalt browserbasiert ist, und Premium- oder Länderrouting wählen, wenn Reputation oder Geografie das Ergebnis ändern.

403429CAPTCHALänderfehlanpassung
  • Verwenden Sie Premium-Routing, wenn die IP-Reputation der nachgewiesene Engpass ist.
  • Verwenden Sie Ländermarkierung, wenn Sprache, Währung, Inventar oder Suchergebnisse je nach Markt variieren.
  • Verwenden Sie Header, Cookies und Sitzungen, wenn sich der Zustand des Besuchers auf die Antwort auswirkt.
  • Reduzieren Sie die Parallelität und fügen Sie Backoff hinzu, wenn wiederholte Anfragen die Ziel-Drosselung auslösen.
Entwickler, der Code und Ausgabeartefakte auf einem Laptop vorbereitet

05 / Rendering- und Ausgabequalität

Nutzbare Artefakte versenden

Ein 200-Status ist nicht dasselbe wie ein nutzbarer Scrape. Das rohe HTML kann eine leere App-Schale sein, Markdown kann den Hauptartikel verpassen, JSON kann erwartete Metadaten fehlen, Text kann Rauschen enthalten, Screenshots können leer sein, und PDF- oder Bildausgaben können fehlschlagen, wenn der Browser-Schritt abläuft. ScraperFly ist wertvoll, weil dieselbe API-Anfrage von rohem HTML zu gerendertem DOM, sauberem Text, Markdown, JSON, Screenshot oder PDF wechseln kann und dann gegen das Artefakt überprüft wird, das Ihr Produkt tatsächlich benötigt. Das reduziert Klebekode, fehlgeschlagene Importe und teure Batchläufe, die nur nachträglich schlechte Ausgaben entdecken.

render_timeoutbrowser_render_failedJSON-FelderPDF/Bildausgabe
  • Rendering aktivieren, wenn rohes HTML nur eine Schale ist und der nützliche Inhalt nach JavaScript erscheint.
  • Validieren Sie Text, Markdown und JSON gegen erwartete Felder, bevor Sie sie batchen.
  • Verwenden Sie Screenshot- oder PDF-Ausgaben, wenn visuelle Beweise oder Prüfungsnachweise wichtig sind.
  • Behandeln Sie leere oder teilweise Artefakte als Qualitätsfehler, selbst wenn der HTTP-Status erfolgreich ist.
ScraperFly passt

Sauberere Fehlerbehebung

ScraperFly hilft Teams zu entscheiden, was zu beheben, was erneut zu versuchen und was zu eskalieren ist, ohne jede Abfrage in das teuerste Anfrageprofil zu verwandeln.

Stabile Fehlerform

Verwenden Sie HTTP-Status und Fehlercode zusammen, damit die Anwendungslogik zwischen der Behebung von Eingaben, dem Aktualisieren von Anmeldeinformationen, dem Verlangsamen, dem erneuten Versuch oder der Eskalation der Lieferung wählen kann.

Nur bei Bedarf erneut versuchen

Netzwerkfehler, Ratenlimits und temporäre Serverfehler können mit Backoff behandelt werden. Ungültige URLs, nicht unterstützte Formate und fehlerhafte Schlüssel sollten einmal korrigiert werden.

Kostenbewusste Eskalation

Beginnen Sie mit dem leichten Anfrageprofil und fügen Sie Rendering, Premium-Routing, Länder, Sitzungen, Header, Wartezeiten oder visuelle Erfassung nur hinzu, wenn der Fehler dies beweist.

Ausgabe vor der Skalierung validieren

Bestätigen Sie das tatsächliche Artefakt, das Ihr Produkt benötigt: HTML, Text, Markdown, JSON, Screenshot oder PDF, bevor Sie dasselbe Profil über ein großes URL-Set kopieren.

Header-Kosten

Halten Sie Header-Experimente klein, bevor Sie schwerere Kontrollen hinzufügen

Header sind im Vergleich zum Rendering durch den Browser oder Premium-Routing leichtgewichtig. Testen Sie sie zuerst, wenn der Anfragekontext das Problem lösen könnte, und eskalieren Sie nur, wenn Beweise in der Antwort darauf hinweisen.

Eine leichte HTML-Anfrage, die eine einfache Antwort zurückgibt
01

Einfacher Abruf

Verwenden Sie einen einfachen Abruf, wenn das öffentliche HTML bereits die benötigten Felder enthält.

Leichtestes Anfrageprofil; behalten Sie es, wenn die Antwort vollständig ist.

JavaScript-Rendering, das ein vollständiges DOM erzeugt
02

Rendering

Verwenden Sie Rendering, wenn rohes HTML eine Hülle ist und JavaScript die Seite vervollständigt.

Schwereres Profil; verwenden Sie es nur, wenn die Browserausgabe das Ergebnis ändert.

Mehrere Anfragen, die Cookies und den Besucherstatus beibehalten
03

Zustandsbehaftete Sitzung

Verwenden Sie Sitzungen, wenn Cookies, Zustimmung, Sprache oder Paginierung die Antwort ändern.

Schwereres Zustandsprofil; bewahren Sie es nur, wenn Kontinuität wichtig ist.

Anforderungsrouting über Geo- und hochwertigere Routen
04

Premium-Routing & Geo

Verwenden Sie Premium-Routing oder Geo nur, wenn Herkunft, Land, Ruf oder regionale Inhalte das Ergebnis ändern.

Schwerstes Routing-Profil; wenden Sie es nur auf Ziele an, die nachweisen, dass sie es benötigen.

Was das Header-basierte Scraping schwerer macht

Mehr Infrastrukturarbeit

Browser-Rendering, Routing-Entscheidungen und längere Wartezeiten bedeuten, dass die Plattform mehr tun muss, als nur eine einfache Antwort zurückzugeben.

Mehr Zielunsicherheit

Weiterleitungen, leere Zustände, Ratenlimits und Challenge-Seiten erfordern oft stärkere Lieferoptionen oder Wiederholungen.

Mehr Zustand zu bewahren

Cookies, Sitzungen, Einwilligungen und mehrseitige Abläufe fügen bewegliche Teile hinzu, die ein einfacher zustandsloser Abruf nicht hat.

Mehr Beweise zurückzugeben

Screenshots, PDFs, gerenderte Ausgaben und reichhaltigere Antwortartefakte sind nützlich, aber sie sind schwerer als einfaches HTML.

Wie man Header-Workflows vorhersehbar hält

Beispiel vor der Skalierung

Testen Sie zuerst eine kleine URL-Gruppe und gruppieren Sie Ziele nach dem leichtesten Profil, das vollständige Daten zurückgibt.

Standardmäßig nicht rendern

Überprüfen Sie das rohe HTML, bevor Sie das Rendering aktivieren. Viele öffentliche Seiten enthalten bereits die Daten, die Sie benötigen.

Eskalieren Sie anhand von Beweisen

Steigen Sie nur auf, wenn die Antwort fehlende Inhalte, Zustandsabhängigkeit, geo-variationen oder Routing-Probleme zeigt.

Nützliche Ergebnisse messen

Optimieren Sie basierend auf gültigen gelieferten Datensätzen, nicht auf dem Rohanfragevolumen. Ein leichteres Profil ist nur dann am besten, wenn es vollständig bleibt.

Header-Fragen

Häufige Fragen zu benutzerdefinierten Headern und Cookies in ScraperFly

Praktische Antworten für Teams, die entscheiden, wann Header, Cookies, Sitzungen, Rendering und Routing Teil einer öffentlichen Web-Scraping-Anfrage sein sollten.

HEADER FAQ
HEADERS

Anforderungs-Kontext weiterleiten

Header sollten eine spezifische Antwortänderung erklären und nicht aus Gewohnheit einen Browser kopieren.

Soll ich alle Browser-Header weiterleiten?

Nein. Beginnen Sie mit dem kleinsten Satz, der die Antwort auf nützliche Weise ändert, und entfernen Sie dann alles, was das Ergebnis nicht verbessert.

Welche Header sind es wert, zuerst getestet zu werden?

Testen Sie Sprache, User-Agent, Accept, Content-Type, Referer oder cachebezogene Header, wenn die Basisantwort darauf hindeutet, dass eines dieser Signale die Seite ändert.

COOKIES

Arbeiten mit öffentlichem Zustand

Cookies können Präferenzen oder Kontinuität tragen, wenn der Workflow wirklich davon abhängt.

Wann helfen Cookies bei einer Scraping-Anfrage?

Cookies helfen, wenn eine öffentliche Seite Zustimmungsstatus, Währung, Sprache, Region, Präferenzen oder Kontinuität benötigt, die legitim und reproduzierbar für den Workflow sind.

Sind Cookies dasselbe wie Sitzungen?

Nein. Cookies tragen Zustandswerte. Sitzungen halten verwandte Anfragen zusammen, sodass der Zustand über einen mehrstufigen öffentlichen Workflow konsistent bleibt.

CONTROLS

Kombinieren von Headern mit ScraperFly-Optionen

Header können zusammen mit Rendering, Sitzungen, Länderauswahl und Routing funktionieren, wenn Beweise die Mischung unterstützen.

Können Header mit JavaScript-Rendering funktionieren?

Ja. Verwenden Sie Header für den Anforderungs-Kontext und Rendering für browserbasierte Inhalte. Aktivieren Sie beide nur, wenn jede von ihnen ein sichtbares Antwortproblem löst.

Wann sollte Routing hinzugefügt werden?

Fügen Sie Länderauswahl, rotierende Proxys oder Premium-Routing hinzu, wenn Status, Weiterleitungen, Blockierungen oder regionale Ausgaben zeigen, dass der Lieferweg die Antwort beeinflusst.

DEBUGGING

Profile vorhersehbar halten

Ein klares Profil erleichtert die Diagnose von Fehlern, bevor der Verkehr skaliert.

Wie weiß ich, ob ein Header geholfen hat?

Vergleichen Sie Basislinie und headerbewusste Antworten für die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße, die Sprache, sichtbare Felder und die Parser-Ausgabe.

Wie beeinflussen Header die Kostenkontrolle?

Header sind im Vergleich zur Browserdarstellung oder zu Premium-Routing leichtgewichtig, daher sind sie oft wert, zuerst getestet zu werden, wenn der Anfragekontext das vermutete Problem ist.










