






Backend-Workflow
Halten Sie Node.js auf Orchestrierung fokussiert, während ScraperFly die Erfassung übernimmt
Node.js ist ein natürlicher Ort für Backend-Jobs, Warteschlangen, API-Routen, Agenten, Dashboards und ereignisgesteuerte Workflows. Es sollte nicht zu einer benutzerdefinierten Browser-Plattform werden, bevor Ihr Team weiß, ob die Antwort der öffentlichen Seite verwendbar ist.
ScraperFly bietet Node.js-Diensten eine saubere Erfassungsschicht: Rufen Sie eine öffentliche URL ab, wählen Sie HTML, Text, Markdown, JSON-Metadaten, Screenshot oder PDF-Ausgabe und fügen Sie Rendering, Sitzungen, Header, Länderrouting, Wartezeiten oder stärkere Zustellungen nur hinzu, wenn sich zeigt, dass diese Kontrollen das Ergebnis verbessern.
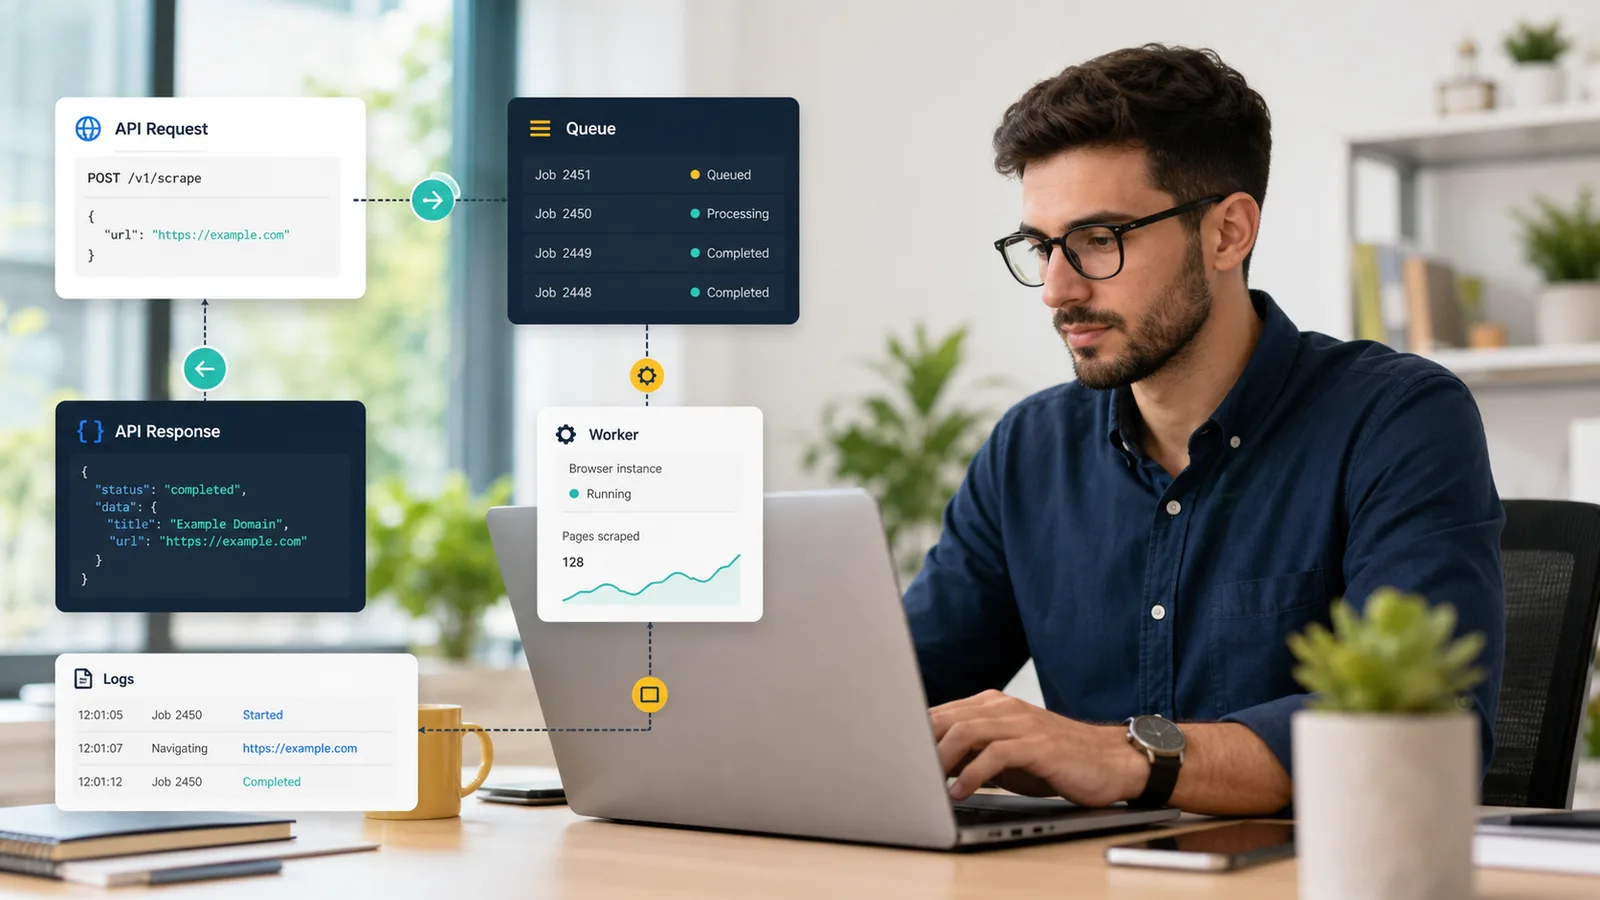
Wie funktioniert eine Node.js Web Scraping API?
Ein Node.js Web Scraping API-Workflow sendet eine öffentliche Ziel-URL und Anfrageoptionen von einem Backend-Dienst an eine gehostete Erfassungsschicht. Die API ruft die Seite ab, wendet Rendering- oder Routing-Kontrollen an, wenn nötig, und gibt eine Antwort zurück, die Ihre Node.js-Anwendung verarbeiten kann. Ihr Code bleibt verantwortlich für Parsing, Validierung, Warteschlangenverhalten, Speicherung, Benachrichtigungen und Produktlogik.
Diese Grenze hält das Backend einfacher zu warten. Anstatt Browserautomatisierung, Proxy-Verwaltung, Wiederholungen, Antwortkonvertierung und Feldextraktion in einen Dienst zu mischen, kann die Node.js-App eine Anfrageoberfläche aufrufen und den Rest der Pipeline explizit halten. Ein Arbeiter kann eine Seite erfassen, Status und Metadaten inspizieren, die benötigten Felder parsen und das Ergebnis in eine Datenbank oder ein nachgelagertes System einpflegen.
Praktische Erkenntnis: Verwenden Sie ScraperFly für zuverlässige Erfassung öffentlicher Seiten und lassen Sie Node.js den anwendungsspezifischen Workflow rund um die Antwort verwalten.
Was sollte die erste Node.js-Scraping-Anfrage beweisen?
Die erste Anfrage sollte die Zielseite und das Antwortformat beweisen, bevor der Code wiederverwendbar wird. Senden Sie eine repräsentative URL, halten Sie das Anfrageprofil leicht und inspizieren Sie das Ergebnis. Überprüfen Sie die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße, den Body und ob die Felder, die Ihr Parser benötigt, vorhanden sind. Wenn das Quell-HTML bereits den nützlichen Inhalt enthält, kann das Backend einfach bleiben. Wenn die Seite ein App-Shell ist oder wichtige Felder fehlen, vergleichen Sie die gerenderte Ausgabe, bevor Sie jeden Job in eine Browseranfrage umwandeln.
Das ist wichtig, weil Node.js-Teams oft schnell von einem erfolgreichen Test in eine Warteschlange oder einen Arbeiter übergehen. Wenn die erste Anfrage mit Rendering, Premium-Routing, langen Wartezeiten oder visueller Ausgabe überlastet ist, kann dieses teure Profil zum Standard werden, bevor jemand weiß, welche Option tatsächlich wichtig war. Ein besserer Workflow beweist einen Seitentyp nach dem anderen und hält jede Kontrolle an Beweise gebunden.
| Backend-Überprüfung | Was es beweist | Was der Node.js-Job als Nächstes tun sollte |
|---|---|---|
| Quellantwort | Ob das rohe HTML die nützlichen Felder enthält | Halten Sie den Job leichtgewichtig, wenn die Quellenerfassung ausreicht. |
| Gerenderte Antwort | Ob JavaScript den Inhalt ändert | Aktivieren Sie Rendering nur für Vorlagen, die eine Browserausführung benötigen. |
| Antwortmetadaten | Status, endgültige URL, Inhaltstyp, Größe und Anfragebeweise | Speichern Sie es mit den Jobprotokollen, bevor Sie parsen oder erneut versuchen. |
| Ausgabeformat | Ob der nachgelagerte Verbraucher Markup, lesbaren Inhalt, Metadaten oder visuelle Beweise benötigt | Wählen Sie die Antwortform, bevor Sie Konverter erstellen. |
| Fehlertyp | Ob das Problem Eingabe, Authentifizierung, Zielverhalten, Ratenlimit, Netzwerk oder Rendering ist | Konfiguration beheben, mit Backoff erneut versuchen oder absichtlich eskalieren. |
Welches Antwortformat sollte Node.js anfordern?
Das beste Format ist das, das Ihr Backend ohne zusätzliche Bereinigung verwenden kann. HTML ist nützlich, wenn der Parser DOM-Struktur, Links, Attribute, Tabellen oder eingebettete Metadaten benötigt. Gerendertes HTML ist nützlich, wenn die Browserausführung das endgültige DOM erstellt. Text und Markdown sind besser, wenn der Workflow lesbaren Inhalt für Suche, Zusammenfassungen, Agentenkontext, RAG-Eingabe oder Inhaltsüberprüfung benötigt. JSON-Metadaten sind nützlich für Protokolle und betriebliche Entscheidungen. Screenshots und PDFs sind besser für QA, Genehmigungen, Überwachung, Archive oder visuelle Beweise.
Wählen Sie nicht überall HTML, nur weil es vertraut ist. Ein Node.js-Dienst, der ein LLM speist, könnte von Markdown profitieren. Ein Überwachungsarbeiter benötigt möglicherweise Metadaten plus einen Screenshot. Ein Parser benötigt möglicherweise rohes HTML für Selektoren. Ein Compliance-Archiv benötigt möglicherweise PDF-Ausgaben. Testen Sie die Antwortform frühzeitig, damit der Dienst keine Konverterebene entwickelt, die die API vermeiden kann.
Für die tiefere Formatentscheidung verwenden Sie den Leitfaden zu den Antwortformaten der Web-Scraping-API, bevor Sie Ihr Backend-Modell fest codieren.
| Node.js-Verbraucher | Zu testendes Format | Warum es passt | Darauf achten |
|---|---|---|---|
| Parser-Dienst | HTML oder gerendertes HTML | Bewahrt Selektoren, Links, Attribute und DOM-Beziehungen | Erfordert ziel spezifische Extraktion und Validierung. |
| Such- oder KI-Arbeiter | Text oder Markdown | Sauberer lesbarer Inhalt mit weniger Layout-Rauschen | Erhält möglicherweise nicht genug Struktur für präzise Feldextraktion. |
| Warteschlangenüberwachung | JSON-Metadaten | Macht Status, endgültige URL, Antwortgröße und Inhaltstyp sichtbar | Ersetzt nicht das Parsen der Ziel Daten selbst. |
| QA oder Genehmigungen | Screenshot | Zeigt, wie die gerenderte öffentliche Seite aussah | Schwerer als maschinenlesbare Ausgabe. |
| Archiv oder Überprüfungsprotokoll | Erstellt ein tragbares visuelles Dokument | Weniger praktisch für automatisiertes Parsen. |
Wann sollte ein Node.js-Dienst Rendering, Sitzungen, Header oder Routing aktivieren?
Aktivieren Sie Kontrollen, wenn Zielbeweise einen echten Bedarf zeigen. Verwenden Sie JavaScript-Rendering, wenn das Quell-HTML unvollständig ist und nützlicher Inhalt nach der Browserausführung erscheint. Verwenden Sie Header, wenn ein öffentliches Ziel einen legitimen Anfragekontext wie Sprache, akzeptierten Inhaltstyp oder Referer-Verhalten erwartet. Verwenden Sie Sitzungen, wenn verwandte Anfragen von gemeinsamen Cookies oder Zuständen abhängen. Verwenden Sie Länderrouting, wenn sich öffentliche Inhalte nach Region, Währung, Sprache, Verfügbarkeit oder Weiterleitungsverhalten ändern. Verwenden Sie stärkere Routen, wenn wiederholte Proben zeigen, dass der einfache Pfad keine verwendbare Antwort abrufen kann.
Diese Optionen sollten nicht als stille Standardwerte in einem gemeinsamen Helfer leben. Eine Backend-Warteschlange kann viele Seitentypen verarbeiten, und nicht alle verdienen dasselbe Anfrageprofil. Halten Sie Profile explizit: Statische Seiten, JavaScript-intensive Seiten, regionale Seiten, zustandsbehaftete Flows und visuelle Beweisjobs sollten ausreichend getrennt sein, damit Kosten und Fehler verständlich bleiben.
Für browsererstellte Seiten überprüfen Sie die JavaScript-Rendering-API. Für gemeinsamen Zustand verwenden Sie die Sitzungs-API. Für Anfragekontext siehe benutzerdefinierte Header. Für Entscheidungen über den Lieferweg vergleichen Sie die Seite der rotierenden Proxy-Scraping-API.
Wie sollten Node.js-Arbeiter mit Scraping-Fehlern umgehen?
Node.js-Arbeiter benötigen Fehler, die bearbeitet werden können. Eine fehlerhafte URL, ein ungültiger Schlüssel, ein nicht unterstütztes Format oder eine inkompatible Dateioption sollten den Job stoppen und auf die Konfiguration hinweisen. Ein Timeout, Ratenlimit, upstream 5xx, Verbindungsproblem, unerwartete Weiterleitung, dünnes HTML-Shell oder Render-Timeout sollten mit dem Anfrageprofil protokolliert und mit einem begrenzten Wiederholungsversuch oder einem anderen Erfassungstest behandelt werden. Behandeln Sie jeden Fehler als Beweis, nicht nur als Ausnahmezeichenfolge.
Dies ist besonders wichtig in Warteschlangen. Ein einzelnes schlechtes Profil kann sich über Hunderte von Jobs multiplizieren, wenn die Wiederholungslogik zu breit ist. Speichern Sie Antwortmetadaten neben jedem Job-Ergebnis: Status, endgültige URL, Inhaltstyp, Antwortgröße, Ausgabeformat, Rendering-Wahl, Routing-Wahl, Wartezeit und Wiederholungsanzahl. Wenn Fehler nach Zieltyp gruppiert werden, kann das Team das Profil beheben, anstatt im Anwendungscode zu raten.
Der wiederverwendbare Abschnitt zur Fehlerbehandlung unten erweitert diese Gruppen, aber die Backend-Regel ist einfach: Stoppen Sie Konfigurationsfehler, versuchen Sie temporäre Fehler vorsichtig erneut und eskalieren Sie nur, wenn wiederholte Proben die schwerere Anfrage rechtfertigen.
Wie können Node.js-Scraping-Warteschlangen vorhersehbar bleiben?
Vorhersehbare Warteschlangen beginnen mit der Seitenklassifizierung. Trennen Sie einfache HTML-Jobs von gerenderten Seiten, sitzungsabhängigen Flows, regionalen Zielen, Premium-Routing-Fällen, Screenshot-Erfassungen und PDF-Archiven. Jede Klasse sollte ihr eigenes Anfrageprofil, ihre eigenen Erwartungen an die Parallelität, ihr eigenes Wiederholungsverhalten und ihre eigenen Protokolle haben. Das hält ein kleines Scraping davon ab, die Kosten des schwersten Ziels im System zu erben.
Das Kreditmodell von ScraperFly unterstützt diesen Arbeitsstil, da Teams kleine Tests durchführen, ungleiche Projekte auf Pay-as-you-go-Credits halten und wiederkehrende Arbeitslasten auf monatliche Credits umstellen können, wenn das Volumen klar wird. Der wichtige Schritt besteht darin, zu wissen, welche Profile Ihre echten Ziele benötigen, bevor Sie die Parallelität erhöhen.
Verwenden Sie Preise, nachdem Sie echte URLs getestet haben, nicht vorher. Die richtige Schätzung hängt davon ab, ob Ihre Jobs hauptsächlich rohes HTML, gerendertes HTML, sitzungsbasierte Flows, Premium-Routen, visuelle Dateien oder eine Mischung sind.
Was sollte Node.js nach der Erfassung besitzen?
Node.js sollte den Workflow besitzen, der einzigartig für Ihr Produkt ist: Warteschlangen, Arbeiter, Wiederholungen, Parser-Module, Validierungsregeln, Duplikation, Speicherung, Webhooks, Benachrichtigungen, Dashboards und nachgelagerte Integrationen. ScraperFly sollte die Schicht zur Erfassung öffentlicher Seiten besitzen: Anfragezustellung, Rendering bei Bedarf, Sitzungen, Header, Routing, Antwortformate, Screenshots, PDFs und Antwortbeweise.
Diese Grenze gibt dem Backend einen stabilen Vertrag. Wenn das Parsen fehlschlägt, inspizieren Sie die erfasste Antwort und aktualisieren Sie die Selektoren. Wenn die Erfassung fehlschlägt, passen Sie das Anfrageprofil an. Wenn die Warteschlange wächst, optimieren Sie die Parallelität und Jobklassen, ohne die Browserinfrastruktur neu zu schreiben. Der Dienst bleibt im besten Sinne langweilig: klare Eingaben, klare Ausgaben und weniger versteckte bewegliche Teile.
Wo sollte ein Node.js-Team anfangen?
Beginnen Sie mit einem echten öffentlichen Ziel im API Builder oder cURL, und bewegen Sie dann die bewährte Anfrage in Node.js. Testen Sie zuerst rohes HTML, vergleichen Sie die gerenderte Ausgabe, wenn Inhalte fehlen, wählen Sie das Antwortformat, das Ihr Backend verwenden kann, und protokollieren Sie genügend Metadaten, um zukünftige Fehler zu erklären.
Nachdem der erste Seitentyp funktioniert, fügen Sie absichtlich Batches hinzu. Halten Sie Anfrageprofile im Code sichtbar, vermeiden Sie einen globalen "schweren Scrape"-Helfer und lassen Sie die Warteschlange um Beweise aus echten Antworten skalieren.












