






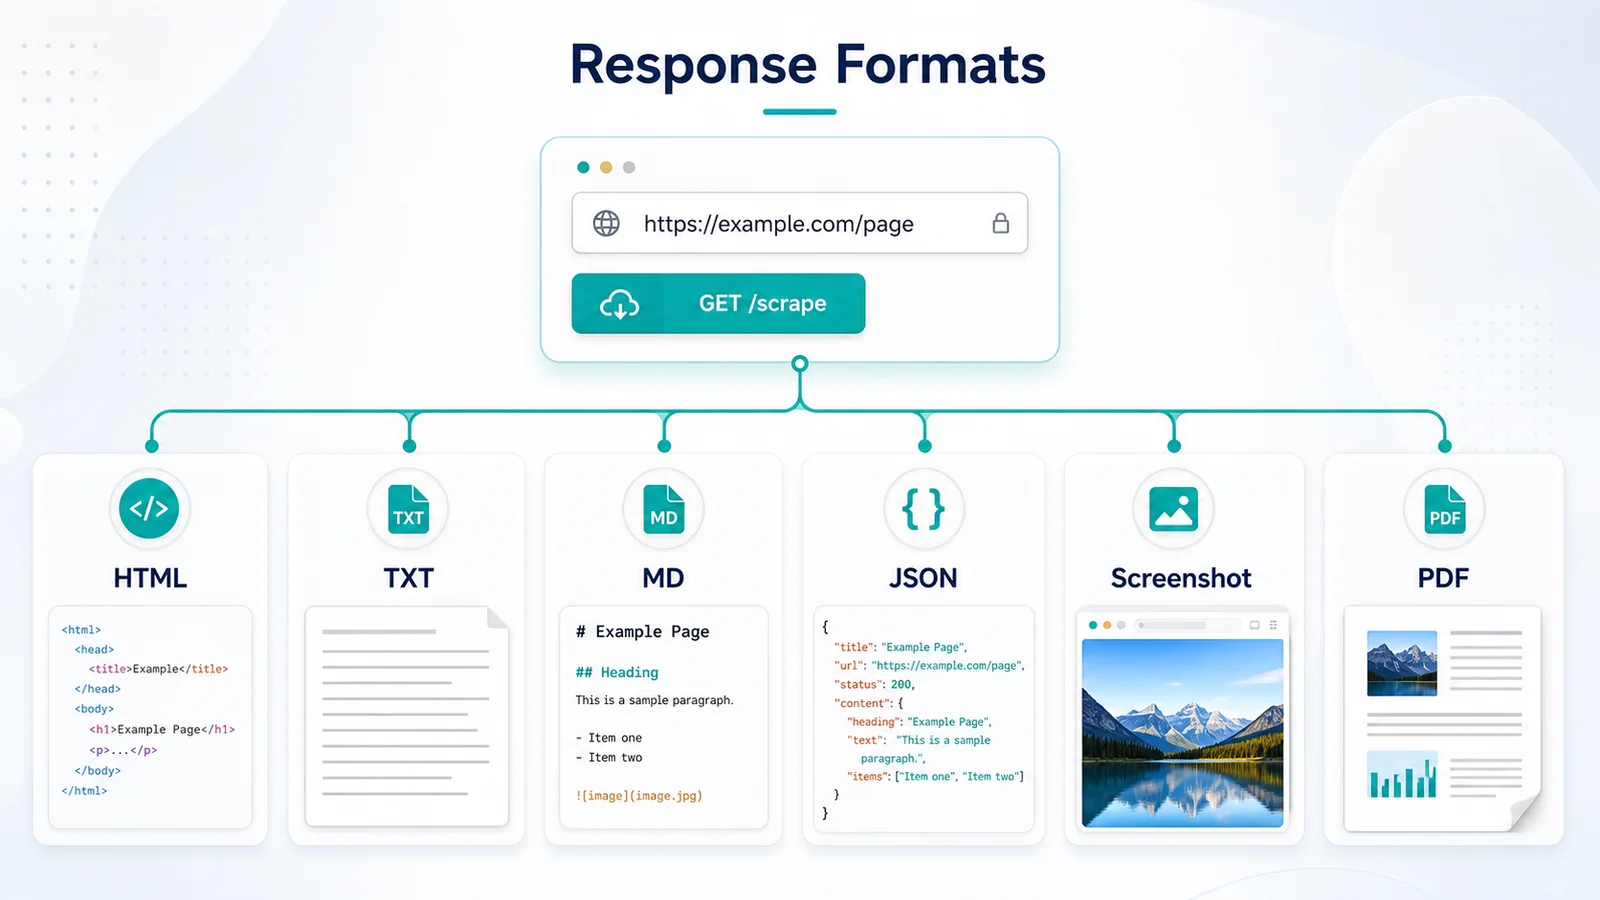
Die Antwortformate der Web-Scraping-API sind die Ausgabestrukturen, die zurückgegeben werden, nachdem eine öffentliche Seite erfasst wurde, einschließlich HTML, Text, Markdown, JSON-Metadaten, Screenshots und PDFs. Das richtige Format hängt von der nachgelagerten Aufgabe ab: Markup-Parsing, Füttern einer KI-Pipeline, Überprüfen von Inhalten, Überwachen von Änderungen, Archivieren von Beweisen oder Bewahren eines visuellen Protokolls.
Die frühzeitige Auswahl der Antwortform verhindert unnötige Bereinigungen. Sie hilft auch Teams, Konverter, Browsererfassungstools und Verarbeitungslogik zu vermeiden, bevor sie wissen, was das Produkt tatsächlich benötigt.
ScraperFly ermöglicht Entwicklern, mehrere Ausgabeformate gegen dieselbe öffentliche Ziel-URL zu testen. Dies macht die Formatwahl zu einer ingenieurtechnischen Entscheidung, die auf realen Antworten und nicht auf Annahmen basiert.
Was sind die Antwortformate der Web-Scraping-API?
Ein Web-Scraping-API-Antwortformat definiert, wie eine erfasste öffentliche Seite an die Client-Anwendung zurückgegeben wird.
Das zugrunde liegende Ziel kann dasselbe sein, aber die Antwort kann sehr unterschiedliche Arbeitsabläufe bedienen. HTML bewahrt die Seitenstruktur. Text entfernt die meisten Markups. Markdown behält eine lesbare Struktur für Inhaltsarbeitsabläufe. JSON-Metadaten beschreiben die Anfrage und den Seitenkontext. Screenshots und PDFs bewahren visuelle Beweise.
Das Format ist unabhängig von der Erfassungsmethode. Eine Seite kann durch eine normale HTTP-Anfrage abgerufen oder in einem Browser gerendert werden, bevor die ausgewählte Ausgabe erstellt wird.
| Format | Am besten geeignet für | Nicht ideal für | Ausgabe-Beispiel | Nachgelagerter Benutzer |
|---|---|---|---|---|
| Roh-HTML | DOM-Parsing, Selektoren, Links, Attribute | Saubere Inhaltsaufnahme ohne Vorverarbeitung | HTML-Antwortkörper | Backend-Entwickler |
| Gerendertes HTML | JavaScript-generierter DOM-Inhalt | Statische Seiten, die bereits die erforderlichen Daten enthalten | Vom Browser generiertes HTML | Scraping-Ingenieur |
| Reiner Text | Suchindexierung, leichte Analyse, einfache Überprüfung | Arbeitsabläufe, die Überschriften, Links oder Layout benötigen | Sauber lesbarer Text | Daten- oder Suchteam |
| Markdown | KI/RAG-Aufnahme, redaktionelle Überprüfung, Dokumentation | Präzise DOM-Extraktion | Überschriften, Absätze, Listen, Links | KI-Produktteam |
| JSON-Metadaten | Status, endgültige URL, Inhaltstyp, Anfragekontext | Willkürliche Feldextraktion aus dem Ziel | Strukturierter Antwortkontext | Plattform-Ingenieur |
| Screenshot | Visuelle QA, Überwachung, Layout-Beweise | Durchsuchbare strukturierte Daten | Bildartefakt | QA- oder Überwachungsteam |
| Archivierung, Genehmigung, tragbare Aufzeichnungen | Fein abgestimmte Inhaltsanalyse | Herunterladbares Dokument | Compliance- oder Betriebsteam |
Praktische Erkenntnis: Behandeln Sie das Ausgabeformat als Teil der Anwendungsarchitektur und nicht als kosmetische API-Option.
Warum ist das Antwortformat wichtig, nachdem eine Seite abgerufen wurde?
Die Anfrage ist nur der Anfang eines Scraping-Workflows. Die Antwort muss immer noch in einen Parser, einen Suchindex, eine KI-Pipeline, ein Überwachungssystem, ein Archiv oder eine Produktoberfläche überführt werden.
Eine schlechte Formatwahl verschiebt die Arbeit nach unten.
Zum Beispiel kann das Senden von Roh-HTML in eine KI-Aufnahme-Pipeline die Entfernung von Boilerplate, Navigationsfilterung, Linkbereinigung und Inhaltsnormalisierung erfordern. Das Zurückgeben von reinem Text an einen Parser kann die DOM-Beziehungen entfernen, die benötigt werden, um Preise, Überschriften, Tabellen oder Produkteigenschaften zu identifizieren.
Das gleiche Problem tritt in visuellen Workflows auf. Ein Team, das einen Nachweis darüber benötigt, wie eine Seite erschien, kann zuerst HTML erfassen und dann separate Playwright- oder Puppeteer-Worker aufrechterhalten, um Screenshots zu generieren. Eine geeignete visuelle Ausgabe kann diese zusätzliche Schicht entfernen.
Die Wahl des Formats beeinflusst:
- wie viel Bereinigung die Anwendung durchführt;
- ob die Seitenstruktur erhalten bleibt;
- wie einfach Entwickler das Ergebnis debuggen können;
- ob die Antwort für die automatisierte Verarbeitung geeignet ist;
- wie viel Speicherplatz und Bandbreite die Pipeline verwendet;
- ob ein separater Konverter oder Browser-Worker erforderlich ist.
Bevor Sie Transformationscode schreiben, testen Sie das Ziel über den API Builder. Vergleichen Sie den Antwortkörper, die Inhaltsstruktur, die Größe und die Benutzerfreundlichkeit über die Formate hinweg.
Praktische Erkenntnis: Wählen Sie das Format, bevor Sie Konverter erstellen, da nachgelagerte Bereinigungen mehr Ingenieurzeit kosten können als die ursprüngliche Anfrage.
Wann sollte ein Scraping-Workflow HTML-Ausgaben verwenden?
HTML ist das richtige Format, wenn die Anwendung die ursprüngliche Struktur der Seite benötigt.
Ein Parser kann Tags, Klassen, Attribute, Überschriften, Links, Tabellen, eingebettete Metadaten und DOM-Beziehungen inspizieren. Dies macht HTML geeignet für benutzerdefinierte Extraktionslogik, bei der die Anwendung bereits weiß, welche Elemente wichtig sind.
Typische HTML-Workflows umfassen:
- Extrahieren von Produktfeldern mit Selektoren;
- Entdecken von Links für einen Crawler;
- Parsing strukturierter Tabellen;
- Lesen von kanonischen Tags oder Metadaten;
- Identifizieren von Seitenabschnitten nach DOM-Hierarchie;
- Speichern von Quellmarkup für die spätere Verarbeitung.
Roh-HTML ist die anfängliche Serverantwort. Es ist normalerweise der leichteste Ausgangspunkt.
Gerendertes HTML ist der DOM, der erzeugt wird, nachdem ein Browser das JavaScript der Seite ausgeführt hat. Es ist wichtig, wenn der erforderliche Inhalt in der ursprünglichen Antwort nicht vorhanden ist.
| Frage | Roh-HTML | Gerendertes HTML |
|---|---|---|
| Woher kommt es? | Erste HTTP-Antwort | Vom Browser generierter DOM |
| Wird JavaScript ausgeführt? | Nein | Ja |
| Am besten geeignet für | Statische und servergerenderte Seiten | Client-gerenderte Anwendungen |
| Typische Latenz | Geringer | Höher |
| Relatives Anfragegewicht | Leichter | Schwerer |
| Hauptrisiko | Fehlender browsergenerierter Inhalt | Verwendung eines Browsers, wenn es nicht notwendig ist |
| Validierungsmethode | Suche in der Antwort nach erforderlichem Inhalt | Vergleiche den gerenderten DOM mit Roh-HTML |
HTML ist nicht automatisch besser, weil es mehr Informationen enthält. Es kann Navigation, Skripte, Stile, Tracking-Code und nicht verwandte Seitenelemente enthalten. Dieses Rauschen ist akzeptabel, wenn ein Parser strukturelle Kontrolle benötigt, aber ineffizient, wenn das Ziel lesbarer Inhalt ist.
Praktische Erkenntnis: Verwenden Sie HTML, wenn die DOM-Struktur ein Eingangsparameter für Ihre Logik ist, und wählen Sie gerendertes HTML nur, wenn JavaScript den benötigten Inhalt erstellt.
Wann sind Text und Markdown besser als HTML?
Text und Markdown sind nützlich, wenn der nachgelagerte Workflow lesbaren Seiteninhalt benötigt, anstatt vollständige DOM-Kontrolle.
Reiner Text entfernt die meisten visuellen und strukturellen Markups. Es eignet sich gut für Keyword-Analyse, Suchindexierung, Inhaltsvergleich, einfache Klassifizierung und Arbeitsabläufe, bei denen Überschriften oder Links nicht entscheidend sind.
Markdown bewahrt mehr Bedeutung. Überschriften, Absätze, Listen und Links bleiben leichter zu interpretieren als in flachem Text. Dies macht Markdown oft nützlich für:
- RAG-Dokumentenvorbereitung;
- LLM-Aufnahme;
- redaktionelle Überprüfung;
- Wissensdatenbank-Importe;
- Prompt-Kontext;
- Dokumentationsanalyse;
- Inhaltsmigration.
Markdown ist kein Ersatz für präzises HTML-Parsing. Wenn die Anwendung einen Produktpreis anhand eines bestimmten Selektors identifizieren, Navigationslinks von Inhaltslinks unterscheiden oder Attribute inspizieren muss, bleibt HTML die sicherere Wahl.
Die Qualität von Markdown hängt auch von der Quellseite ab. Saubere redaktionelle Seiten konvertieren normalerweise vorhersehbarer als hochinteraktive Layouts, Dashboards, komplexe Tabellen oder Seiten mit fragmentiertem Inhalt.
| Workflow | Empfohlenes Format | Optionales Format | Warum |
|---|---|---|---|
| Benutzerdefinierter Parser | HTML | JSON-Metadaten | Bewahrt Selektoren und DOM-Beziehungen |
| KI/RAG-Aufnahme | Markdown | Text oder HTML | Hält lesbare Hierarchie und Links |
| Suchindexierung | Text | Markdown | Reduziert Markup und Verarbeitungsrauschen |
| Inhaltsüberwachung | Text oder HTML | Screenshot | Unterstützt maschinellen Vergleich und visuelle Überprüfung |
| QA-Überprüfung | Screenshot | HTML | Zeigt gerenderte Erscheinung mit Quellbeweis |
| Archiv | HTML oder Screenshot | Erstellt ein tragbares Protokoll | |
| Berichterstattung | Text oder Markdown | Screenshot | Unterstützt Zusammenfassungen mit visuellem Kontext |
Ein guter KI-Workflow kann mehr als ein Format verwenden. Markdown kann lesbaren Inhalt liefern, während JSON-Metadaten die endgültige URL, den Inhaltstyp, den Status und den Erfassungskontext aufzeichnen.
Praktische Erkenntnis: Verwenden Sie Text für kompakte lesbare Inhalte, Markdown für bewahrte Dokumentstruktur und HTML, wenn die Extraktion von der DOM abhängt.
Was sollten Teams von JSON-Metadaten-Ausgaben erwarten?
JSON-Metadaten bieten strukturierten Kontext zur Erfassung und Antwort. Es verwandelt nicht automatisch jede Zielseite in ein benutzerdefiniertes Geschäftsschema.
Nützliche Metadaten können Informationen wie Folgendes enthalten:
- Anfrage-Status;
- Ziel-URL;
- Endgültige URL nach Weiterleitungen;
- Inhaltstyp;
- Antwortgröße;
- Timing oder Anfragekontext;
- Ausgewähltes Antwortformat;
- Erfassungs- oder Routingdetails, die von der API unterstützt werden.
Diese Struktur ist wertvoll für Protokollierung, Überwachung, Debugging und Koordination nachgelagerter Verarbeitung. Eine Pipeline kann Metadaten verwenden, um zu entscheiden, ob der Körper geparst, gespeichert, erneut versucht oder abgelehnt werden soll.
JSON-Metadaten sollten jedoch nicht mit willkürlicher Schemaextraktion verwechselt werden.
Zum Beispiel bedeutet eine JSON-Antwort nicht unbedingt, dass die API automatisch jeden Produktnamen, Preis, Bewertung, Autor, Firma oder Artikelbereich auf einer beliebigen Website identifiziert. Zielgerichtete Extraktion erfordert weiterhin Parserlogik, unterstützte Extraktionsfunktionen oder eine separate Transformationsebene.
Ein praktisches Muster besteht darin, Metadaten mit einer anderen Antwort zu kombinieren:
- HTML plus Metadaten für Parser-Workflows;
- Markdown plus Metadaten für KI-Aufnahme;
- Screenshot plus Metadaten für QA-Beweise;
- PDF plus Metadaten für Archivunterlagen.
Praktische Erkenntnis: Verwenden Sie JSON-Metadaten, um die Anfrage und den Seitenkontext zu verstehen, nicht als Annahme, dass jede Seite zu einem benutzerdefinierten strukturierten Datensatz wird.
Wann sind Screenshots und PDFs die richtigen Ausgaben der Scraping-API?
Screenshots und PDFs sind geeignet, wenn das visuelle Erscheinungsbild Teil des Beweises ist.
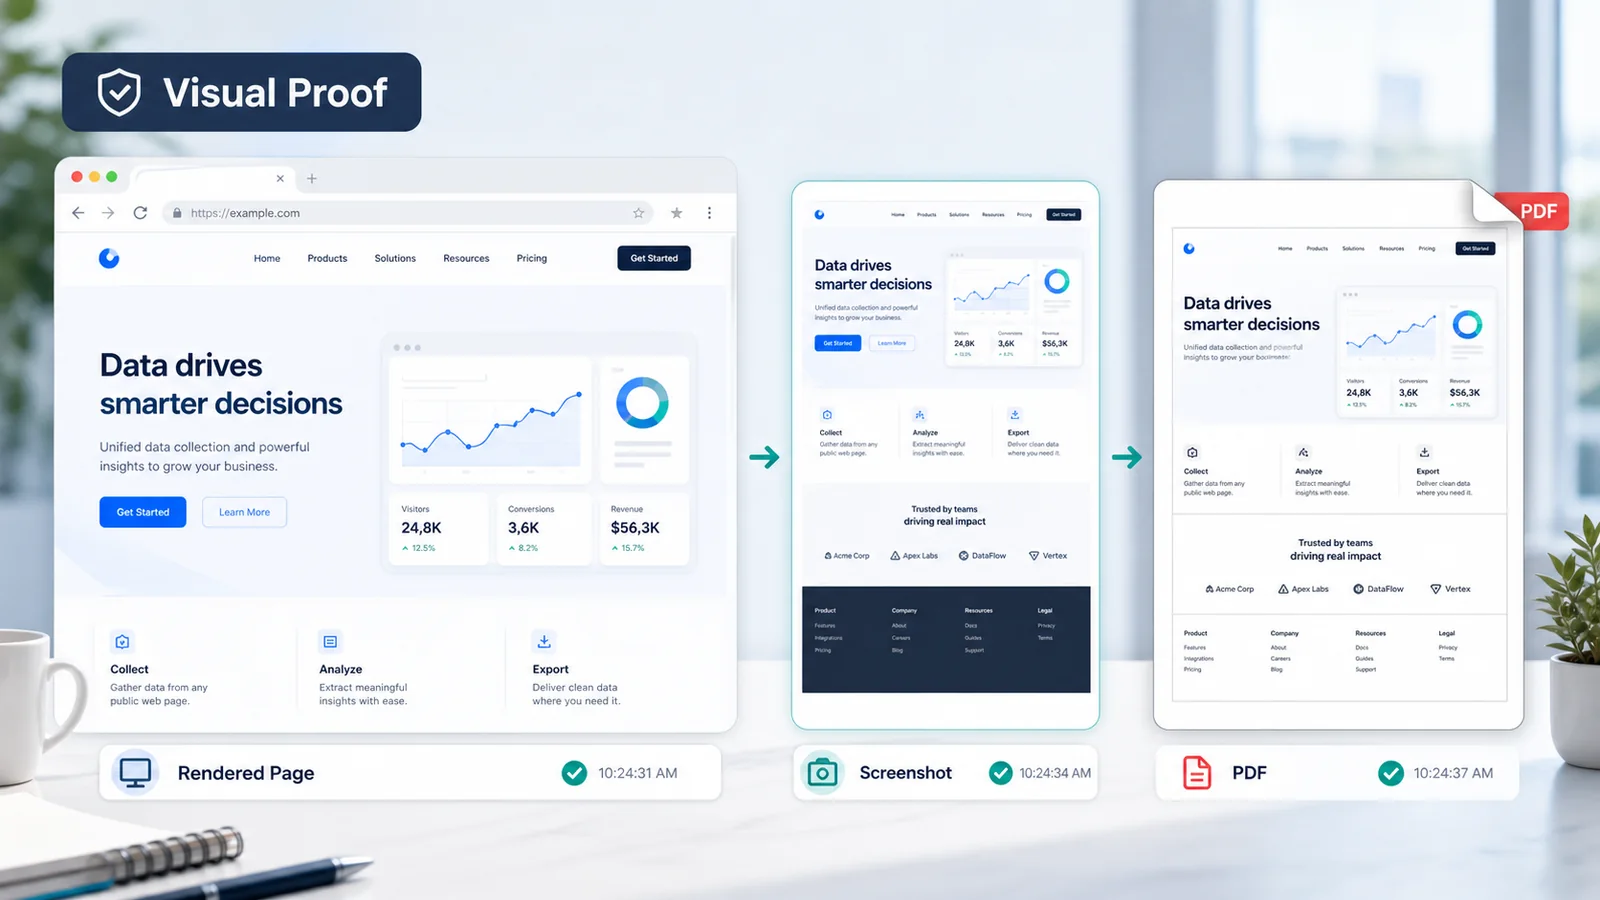
HTML und Text können zeigen, welcher Inhalt zurückgegeben wurde, aber sie können nicht beweisen, wie der Browser die Seite angezeigt hat. Ein Screenshot kann Layout, sichtbare Fehler, Zustimmungsscreens, fehlende Komponenten, responsive Änderungen oder regionsspezifische Präsentationen erfassen.
Screenshots sind nützlich für:
- visuelle Regressionüberwachung;
- gerenderte Seiten-QA;
- Layout-Verifizierung;
- Überprüfung von Kampagnen- und Zielseiten;
- Fehlerreproduktion;
- menschliche Genehmigungs-Workflows.
PDFs sind besser, wenn das Ergebnis gespeichert, geteilt, gedruckt, überprüft oder als dokumentenähnliches Artefakt aufbewahrt werden muss. Sie können Archiv-, Compliance-Überprüfungen, Genehmigungen und betriebliche Aufzeichnungen unterstützen.
| Beweisformat | Beste Verwendung | Hauptvorteil | Hauptbeschränkung |
|---|---|---|---|
| Screenshot | Visuelle QA und Seitenstatusbeweise | Zeigt, was im Ansichtsfenster erschien | Nicht praktisch für strukturierte Suchen |
| Archiv, Überprüfung und tragbare Aufzeichnungen | Bewahrt ein dokumentenähnliches Artefakt | Größer und schwerer zu parsen | |
| HTML | Quell- und DOM-Beweise | Maschinenlesbare Struktur | Entspricht möglicherweise nicht dem endgültigen visuellen Erscheinungsbild |
| Text oder Markdown | Inhaltsbeweise | Einfach zu durchsuchen und zu analysieren | Verliert visuelles Layout |
Visuelle Ausgaben sollten maschinenlesbare Daten ergänzen, nicht ersetzen. Ein Überwachungsworkflow kann HTML oder Text automatisch vergleichen und einen Screenshot nur generieren, wenn eine bedeutende Änderung festgestellt wird.
Screenshots und PDFs sind auch schwerer als reiner Text oder Roh-HTML. Überprüfen Sie die aktuellen Kreditoptionen auf Preise, bevor Sie visuelle Artefakte für jede Anfrage generieren.
Praktische Erkenntnis: Wählen Sie Screenshots für visuelle Zustände und PDFs für tragbare Aufzeichnungen, während Sie HTML oder Text beibehalten, wenn das System auch maschinenlesbare Beweise benötigt.
Wie verändert das Rendern von JavaScript die Qualität des Antwortformats?
Das Rendern von JavaScript verbessert die Ausgabequalität nur, wenn das Ziel von der Ausführung im Browser abhängt.
Eine rohe HTTP-Antwort kann einen vollständigen Artikel, eine Produktseite oder eine Dokumentationsseite enthalten. In diesem Fall fügt das Rendern Latenz und Anfragegewicht hinzu, ohne das ausgewählte Format zu verbessern.
Andere Seiten geben ein Anwendungsshell zurück und laden Inhalte, nachdem der Browser gestartet wurde. Eine Markdown- oder Screenshot-Antwort, die erstellt wurde, bevor dieser Inhalt erscheint, kann unvollständig sein. Das Rendern ermöglicht es dem Browser, den DOM aufzubauen, bevor ScraperFly die angeforderte Ausgabe erzeugt.
Häufige Anzeichen dafür, dass das Rendern erforderlich sein könnte, sind:
- das rohe HTML enthält keinen sichtbaren Seitentext;
- Listen oder Tabellen erscheinen erst nach dem Laden der Seite;
- clientseitige Frameworks fügen den Hauptinhalt ein;
- ein Screenshot zeigt ein leeres Shell;
- das Ziel lädt Daten über Hintergrundanfragen;
- verzögerte Komponenten erfordern ein kontrolliertes Warten.
Gehen Sie nicht davon aus, dass Markdown-, Screenshot- oder PDF-Ausgaben automatisch ein Rendern erfordern. Die Entscheidung sollte sich aus dem Verhalten des Ziels ergeben.
Testen Sie die Seite zuerst ohne Rendering. Suchen Sie nach dem erforderlichen Inhalt. Vergleichen Sie dann die Antwort mit einer browseraktivierten Anfrage unter Verwendung der JavaScript-Rendering-API.
Praktische Erkenntnis: Rendering verbessert ein Format nur, wenn die Ausführung im Browser den Inhalt ändert, aus dem dieses Format erstellt wird.
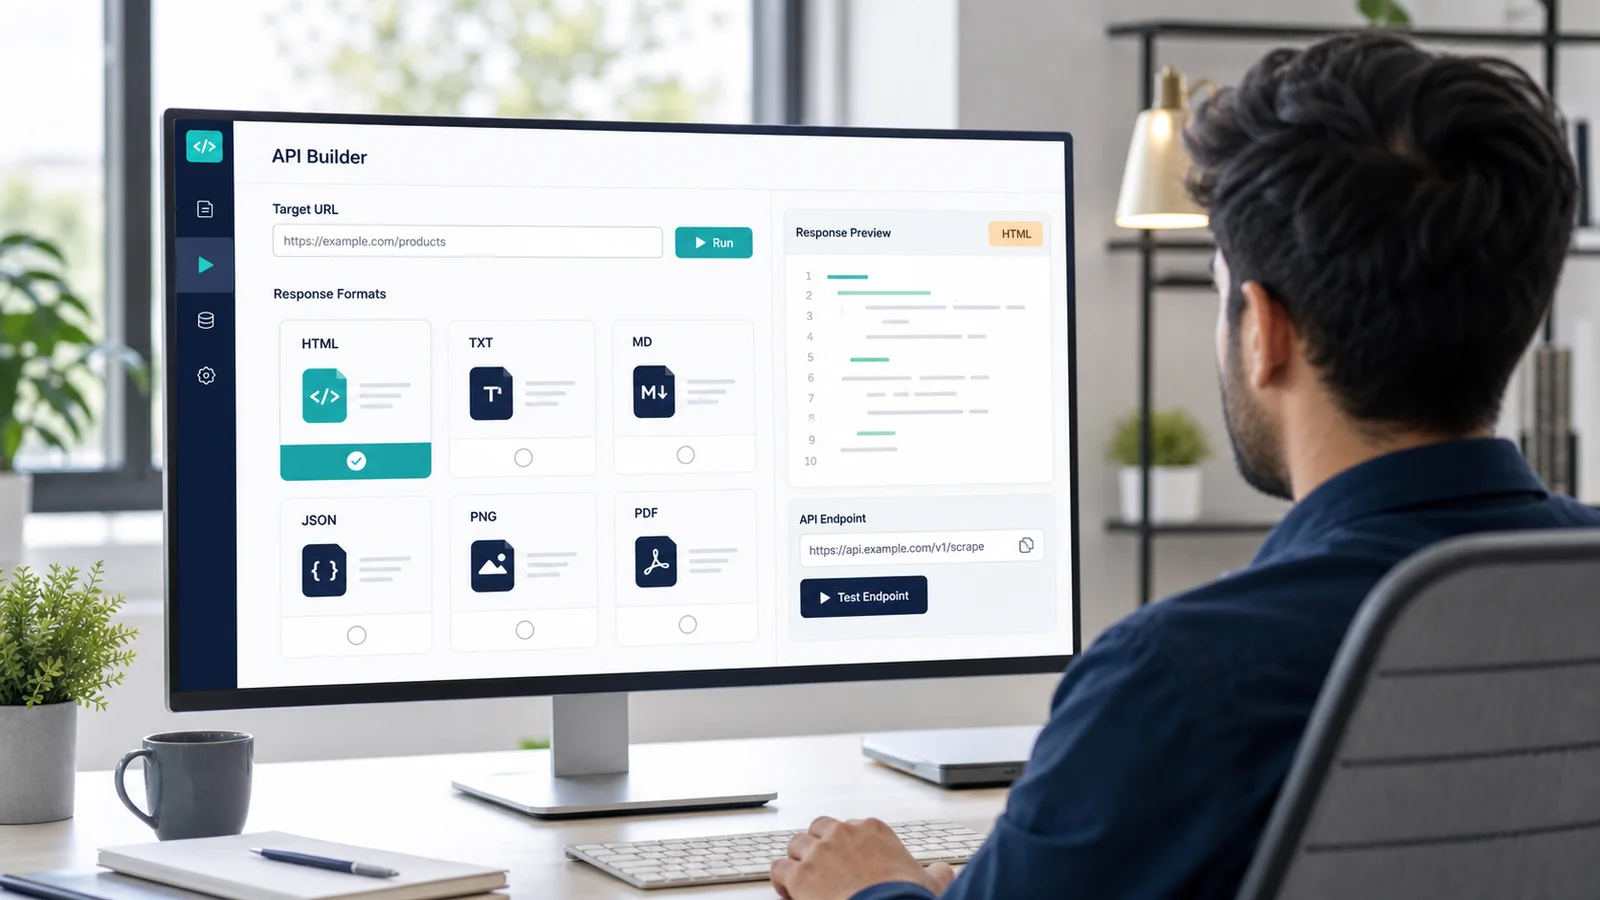
Ein Produktionsformat sollte aus den nachgelagerten Anforderungen rückwärts ausgewählt werden.
Verwenden Sie diesen Entscheidungsprozess:
- Definieren Sie den Verbraucher. Bestimmen Sie, ob die Antwort an einen Parser, LLM, Suchindex, QA-Überprüfer, Archiv oder Überwachungssystem geht.
- Definieren Sie die benötigten Beweise. Entscheiden Sie, ob der Workflow DOM-Struktur, lesbaren Inhalt, Anfragekontext, visuelles Erscheinungsbild oder ein tragbares Protokoll benötigt.
- Testen Sie zuerst die rohe Erfassung. Bestätigen Sie, ob der erforderliche Inhalt ohne Browser-Rendering vorhanden ist.
- Vergleichen Sie Formate an einem Ziel. Bewerten Sie HTML, Text, Markdown, Metadaten oder visuelle Ausgaben unter Verwendung derselben öffentlichen URL.
- Messung der Bereinigung. Wählen Sie die Antwort, die die wenigsten zuverlässigen benutzerdefinierten Transformationen erfordert.
- Überprüfen Sie die Antwortgröße und das Gewicht. Vermeiden Sie es, mehr Daten zu speichern oder zu generieren, als die Anwendung verwendet.
- Dokumentieren Sie das Anfrageprofil. Protokollieren Sie das gewählte Format, die Rendering-Einstellung, Wartezeiten, Routing, Header und die erwartete Ausgabe.
Das ausgewählte Format kann je nach Zielgruppe unterschiedlich sein. Redaktionelle Seiten können Markdown verwenden, E-Commerce-Seiten benötigen möglicherweise HTML, und visuelle Überwachung kann Text mit Screenshots kombinieren.
Ein globales Antwortprofil ist praktisch, aber selten optimal für eine gemischte Produktionslast.
Praktische Erkenntnis: Wählen Sie Formate pro Workflow-Klasse, validieren Sie sie an repräsentativen Zielen und protokollieren Sie das bewährte Anfrageprofil, bevor Sie skalieren.
Wie beeinflussen Antwortformate Kosten und Anfragegewicht?
Antwortformate beeinflussen Bandbreite, Speicher, Verarbeitungszeit und API-Credits.
Eine grundlegende HTML- oder Textantwort ist normalerweise leichter als ein vom Browser gerenderter Screenshot oder PDF. Der Unterschied wird bei Produktionsvolumen wichtig.
| Ausgabeprofil | Relatives Gewicht | Kosten sind gerechtfertigt, wenn | Vermeiden, wenn |
|---|---|---|---|
| Roh-HTML | Leicht | DOM oder Quellmarkup erforderlich ist | Nur lesbarer Inhalt benötigt wird |
| Reiner Text | Leicht | Kompakte Inhaltsverarbeitung das Ziel ist | Struktur und Links wichtig sind |
| Markdown | Leicht bis moderat | KI- oder redaktionelle Workflows von Hierarchie profitieren | Präzise DOM-Extraktion erforderlich ist |
| JSON-Metadaten | Leicht | Anfragekontext die Operationen unterstützt | Erwartet wird, dass es das Parsen ersetzt |
| Gerendertes HTML | Höher | JavaScript den erforderlichen Inhalt erstellt | Roh-HTML bereits vollständig ist |
| Screenshot | Höher | Visueller Beweis oder QA erforderlich ist | Jede Anfrage nur maschinell verarbeitet wird |
| Höher | Ein tragbares archiviertes Protokoll erforderlich ist | Das Artefakt nie überprüft oder aufbewahrt wird |
Die Kostenkontrolle sollte mit repräsentativen Zielen beginnen. Gruppieren Sie Anfragen nach Format und Renderingbedarf, anstatt jede URL so zu bewerten, als würde sie das schwerste Profil erfordern.
ScraperFly-Credits ermöglichen es, das Anfragegewicht mit aktivierten Kontrollen zu verbinden. Teams können mit einem kostenlosen Test beginnen, Formate vergleichen und die tatsächliche Arbeitslast mit dem Web-Scraping-API-Credit-Kostenrechner schätzen.
Praktische Erkenntnis: Reservieren Sie gerenderte und dateibasierte Ausgaben für Workflows, die ihre zusätzlichen Beweise verwenden.
Welche Fehler sollten Teams vermeiden, wenn sie die Ausgabe der Scraping-API auswählen?
Der häufigste Fehler besteht darin, ein vertrautes Format anstelle des Formats auszuwählen, das das Produkt benötigt.
Vermeiden Sie diese Muster:
HTML überall senden. Rohmarkup fügt unnötige Bereinigungen zu Inhalten und KI-Pipelines hinzu.
Text für präzise Extraktion verwenden. Reiner Text entfernt DOM-Beziehungen, auf die Parser möglicherweise angewiesen sind.
Annehmen, dass Markdown für jede Seite perfekt ist. Komplexe Tabellen, interaktive Komponenten und ungewöhnliche Layouts konvertieren möglicherweise nicht sauber.
JSON-Metadaten als benutzerdefinierte Extraktion behandeln. Strukturierter Anfragekontext ist nicht dasselbe wie ein zielgerichtetes Geschäftsschema.
Screenshots für maschinenbasierte Workflows generieren. Visuelle Dateien fügen Gewicht hinzu, bieten jedoch wenig Wert, wenn kein menschliches oder visuelles Vergleichssystem sie verwendet.
PDF als Parser-Eingabe verwenden. PDFs sind nützliche Aufzeichnungen, aber selten die effizienteste Quelle für strukturierte Extraktion.
Jede Anfrage rendern. Die Ausführung im Browser sollte eine nachgewiesene Inhaltslücke schließen.
Konverter erstellen, bevor Formate getestet werden. Ein Team kann Tage damit verbringen, eine Ausgabe zu reproduzieren, die die API bereits zurückgeben kann.
Ein Format für jedes Ziel verwenden. Verschiedene Seitentypen und nachgelagerte Verbraucher benötigen oft unterschiedliche Profile.
Testen Sie repräsentative Seiten über den API Builder, vergleichen Sie die Ausgabe und wählen Sie basierend auf der Benutzerfreundlichkeit und nicht auf der Formatpopularität.
Praktische Erkenntnis: Validieren Sie die Antwort mit ihrem realen nachgelagerten Verbraucher, bevor Sie sich auf die Produktionsarchitektur festlegen.
KÄUFERFRAGEN
Häufige Fragen vor der Auswahl eines Antwortformats
Beantworten Sie praktische Bewertungsfragen zu HTML, Text, Markdown, JSON-Metadaten, Screenshots, PDFs, Rendering, Anfragegewicht und Produktionsbenutzbarkeit.
AUSGABE-FAQMarkdown, Text und KI-Pipelines
Wählen Sie lesbare Ausgaben, wenn der Verbraucher Suche, RAG, redaktionelle Überprüfung oder leichte Inhaltsanalyse ist.
Ist Markdown immer das beste Format für eine KI- oder RAG-Pipeline?
Nein. Markdown ist nützlich, wenn Überschriften, Listen und Links den Dokumentkontext verbessern. Reiner Text kann besser für kompakte Verarbeitung sein, während HTML erforderlich sein kann, wenn der Inhalt zuerst aus bestimmten DOM-Elementen ausgewählt werden muss.
Kann eine Anwendung unterschiedliche Antwortformate für verschiedene Ziele verwenden?
Ja. Eine Produktionsanwendung kann Ziele nach Workflow klassifizieren. Dokumentationsseiten können Markdown verwenden, Produktseiten können HTML verwenden, und visuelle Überwachungsziele können Screenshots verwenden.
HTML plus Antwortkontext
Verwenden Sie strukturierten Kontext, um Anfragen zu debuggen, zu routen und zu protokollieren, ohne vorzugeben, dass Metadaten ein benutzerdefinierter Extraktor sind.
Kann eine Scraping-API HTML und Metadaten für denselben Workflow zurückgeben?
Ja, ein Workflow kann Seiteninhalt zusammen mit Antwortkontext verwenden. HTML unterstützt das Parsen, während Metadaten den Status, die endgültige URL, den Inhaltstyp, die Antwortgröße und andere von der API unterstützte Anfragedetails aufzeichnen können.
Extrahiert JSON-Ausgabe automatisch Produkte oder Artikelbereiche?
Nein. JSON-Metadaten beschreiben die Erfassung oder Antwort. Es sollte nicht als automatische Extraktion willkürlicher Felder wie Preise, Autoren, Bewertungen oder Produkteigenschaften interpretiert werden.
Screenshots, PDFs und gerenderte Ausgaben
Fügen Sie visuelle Artefakte hinzu, wenn Überprüfung, Archivierung oder Erscheinungsbeweise wichtig sind, nicht für jede maschinenbasierte Anfrage.
Sollten Screenshots für jede überwachte Seite generiert werden?
In der Regel nicht. Maschinenlesbares HTML oder Text ist besser für automatisierte Vergleiche. Screenshots sind am wertvollsten, wenn eine Änderung visuelle Bestätigung, menschliche Überprüfung oder Layout-Beweise erfordert.
Was ist der Unterschied zwischen gerendertem HTML und einem Screenshot?
Gerendertes HTML enthält den DOM nach der Ausführung im Browser und bleibt für das Parsen geeignet. Ein Screenshot ist ein Bild, das zeigt, wie die Seite visuell erschien. Die beiden Formate beantworten unterschiedliche Fragen.
Wann sollte ein Scraping-Workflow PDF-Ausgaben verwenden?
Verwenden Sie PDF, wenn die erfasste Seite ein tragbares Dokument für Überprüfung, Genehmigung, Archivierung oder Aufzeichnung werden muss. Verwenden Sie HTML, Text oder Markdown, wenn automatisierte Verarbeitung die Hauptanforderung ist.
Testen vor der Integration
Vergleichen Sie die Formate an repräsentativen Zielen, bevor das Team Konverter erstellt oder ein schweres Profil skaliert.
Wie sollten Entwickler Formate vor der Integration vergleichen?
Führen Sie dieselbe repräsentative Ziel-URL durch den API Builder mit mehreren Formaten aus. Vergleichen Sie Struktur, fehlenden Inhalt, Antwortgröße, Rendering-Anforderungen, Bereinigungsanforderungen und nachgelagerte Benutzerfreundlichkeit, bevor Sie das Produktionsprofil auswählen.
Testen Sie die Antwortform, bevor Sie sich auf die Architektur festlegen
Eine Scraping-Pipeline wird einfacher zu warten, wenn die API die Form zurückgibt, die das Produkt sofort verwenden kann.
ScraperFly ermöglicht es Teams, öffentliche Seiten als HTML, Text, Markdown, JSON-Metadaten, Screenshots oder PDFs über ein Anfrage-Modell zu erfassen. Beginnen Sie mit einem repräsentativen Ziel, vergleichen Sie Formate im API Builder, aktivieren Sie das Browser-Rendering nur, wenn die Seite es erfordert, und behalten Sie visuelle Ausgaben für Workflows, die visuelle Beweise verwenden.
Das beste Antwortformat ist nicht das mit den meisten Daten. Es ist das, das unnötige Verarbeitung entfernt und gleichzeitig die Beweise bewahrt, die Ihre Anwendung benötigt.









