






Haupt-API-Schicht
Erstellen Sie das Anfrageprofil, bevor Ihr Produkt von den Daten abhängt
Eine Web Scraping API bietet Ihrem Produkt eine zuverlässige Möglichkeit, öffentliche Webseiten abzurufen, die Antwort zu überprüfen und nutzbare Ausgaben zurückzugeben, ohne jede bewegliche Komponente der Scraping-Infrastruktur zu besitzen. Ihr Team sendet eine Ziel-URL und ein klares Anfrageprofil. ScraperFly kümmert sich um die Erfassungsschicht und gibt dann HTML, Text, Markdown, JSON-Metadaten, Screenshots oder PDFs in der Form zurück, die Ihr Workflow verwenden kann.
Der praktische Vorteil ist Kontrolle. Eine einfache Seite sollte eine leichte HTML-Anfrage bleiben. Eine JavaScript-Seite kann gerendert werden, wenn der nützliche Inhalt im Quell-HTML fehlt. Ein schwieriges Ziel kann Sitzungen, Header, Länderrouting oder Premium-Lieferungen hinzufügen, nachdem die Antwort bewiesen hat, dass diese Kontrollen benötigt werden. Dieser Weg hält die Tests günstiger, das Produktionsverhalten leichter erklärbar und die Ingenieurzeit auf das Produkt konzentriert, anstatt auf die Wartung von Browsern und Proxys.
Was ersetzt eine Web Scraping API tatsächlich?
Eine Web Scraping API ersetzt die Erfassungsinfrastruktur rund um den Abruf öffentlicher Seiten. Ohne sie muss ein Team oft HTTP-Clients, Browser-Arbeiter, Proxy-Pools, Wiederholungslogik, Timeout-Regeln, Header-Weiterleitung, Sitzungsstatus, Ausgabewandler, Screenshot-Erfassung, PDF-Generierung, Protokolle und Überwachung für jedes Ziel pflegen. Diese Arbeit kann für eine sehr spezialisierte Plattform nützlich sein, ist aber selten der Kernwert des Produkts, das die Daten benötigt.
ScraperFly verlagert diese operationale Schicht hinter eine API-Oberfläche. Die Anwendung besitzt weiterhin, was downstream wichtig ist: die Auswahl von Zielen, das Parsen von Feldern, die Validierung der Datenqualität, das Speichern von Datensätzen, den Vergleich von Änderungen, das Generieren von Warnungen oder das Füttern von KI- und Analysesystemen. ScraperFly konzentriert sich darauf, eine öffentliche Seitenantwort in eine zuverlässige Form zu bringen, sodass das nächste System von Beweisen und nicht von einem fragilen, selbstgemachten Abruf ausgeht.
Praktische Erkenntnis: Verwenden Sie eine Web Scraping API, wenn Ihr Produkt öffentliche Seitenbeweise benötigt, nicht eine weitere interne Plattform für Browser-, Proxy-, Wiederholungs- und Konvertierungsarbeiten.
Wie sollte die erste Anfrage aufgebaut werden?
Die erste Anfrage sollte absichtlich langweilig sein. Senden Sie die öffentliche URL, fordern Sie die kleinste nützliche Ausgabe an und überprüfen Sie das Ergebnis. Wenn das Quell-HTML den Inhalt enthält, den Ihr Parser benötigt, halten Sie die Anfrage einfach. Wenn die Seite nur eine dünne App-Schale, leeres Markup oder Inhalte zurückgibt, die erscheinen, nachdem das Frontend-JavaScript ausgeführt wurde, aktivieren Sie das Rendering für dieses Ziel. Wenn die Antwort je nach Sprache, Zustimmungsstatus, Standort oder vorherigen Schritten variiert, bewerten Sie Header, Cookies, Sitzungen oder Länderrouting.
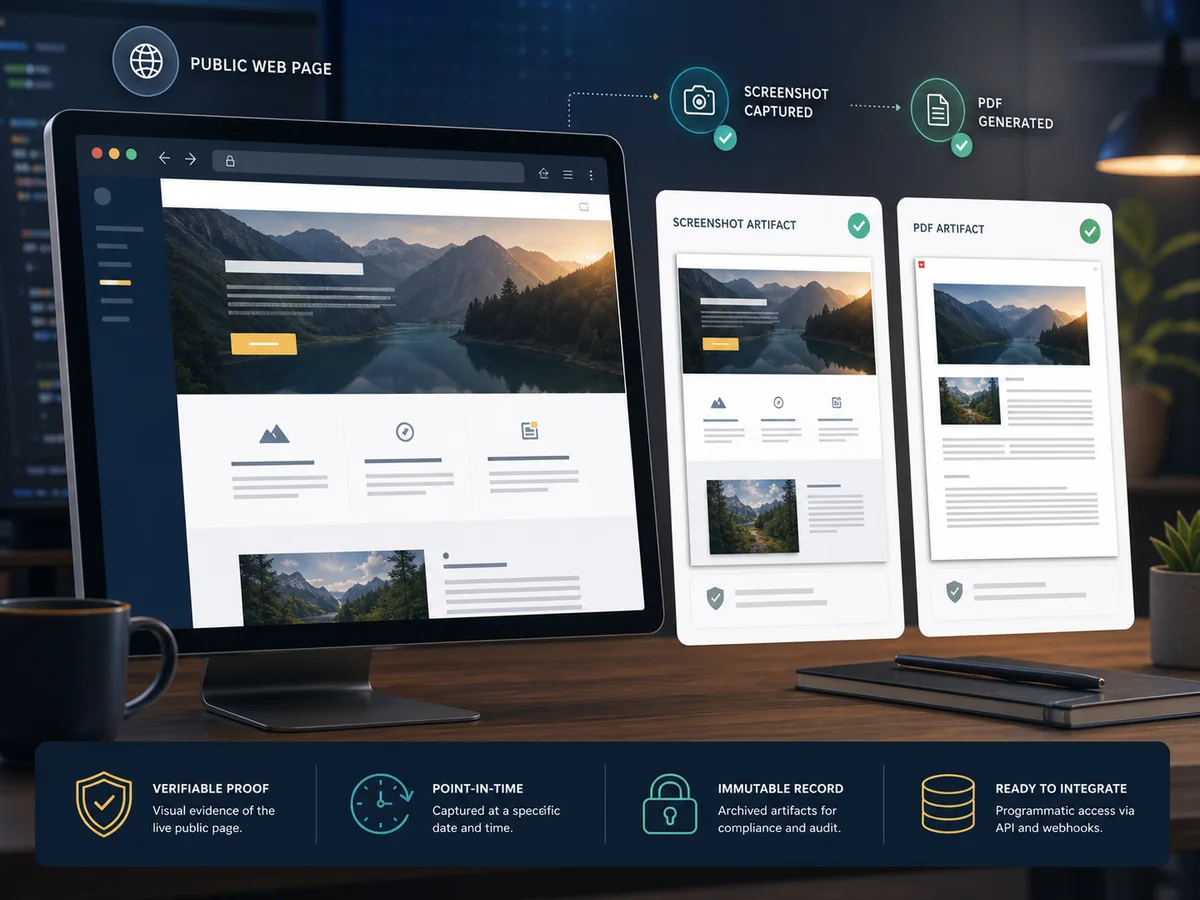
Dies ist die gleiche Logik, die im Anfrage-Builder-Block der Seite unten reflektiert wird: Erstellen Sie eine zuverlässige Anfrage und fügen Sie dann Kontrollen nur hinzu, wenn das Ziel beweist, dass es sie benötigt. Der Punkt ist nicht, fortgeschrittene Funktionen zu verbergen. Der Punkt ist, jede Funktion an einen Grund zu binden. Rendering löst browsererstellte Inhalte. Sitzungen bewahren den Status über verwandte Anfragen. Header tragen legitimen Anfragekontext. Premium- oder Länderrouting hilft, wenn die Lieferbeweise zeigen, dass der Standardweg nicht ausreicht. Screenshots und PDFs schaffen visuelle Beweise, wenn maschinenlesbare Ausgaben allein die gesamte Geschichte nicht erzählen können.
| Anfrageentscheidung | Beginnen Sie mit | Fügen Sie mehr hinzu, wenn | Warum es wichtig ist |
|---|---|---|---|
| Grundlegende öffentliche Seitenaufnahme | URL plus HTML-Ausgabe | Quell-HTML ist unvollständig oder unbrauchbar | Hält den ersten Test schnell, günstig und einfach zu debuggen. |
| JavaScript-erstellte Inhalte | Roh-HTML-Vergleich | Der Browser ändert den nützlichen Inhalt | Rendering wird zu einer evidenzbasierten Kontrolle, nicht zu einer Standardsteuer. |
| Zustandsabhängige oder regionale Seiten | Einfache Anfrage mit Antwortmetadaten | Sprache, Cookies, Routenstatus oder Standort ändern die Antwort | Sitzungen, Header und Routing bleiben an das Zielverhalten gebunden. |
| Überprüfungs-, QA- oder Archiv-Workflows | Maschinenlesbare Ausgabe | Jemand benötigt einen Beweis dafür, wie die Seite aussah | Screenshots und PDFs ergänzen parsbare Daten, anstatt sie zu ersetzen. |
Welches Antwortformat sollte die API zurückgeben?
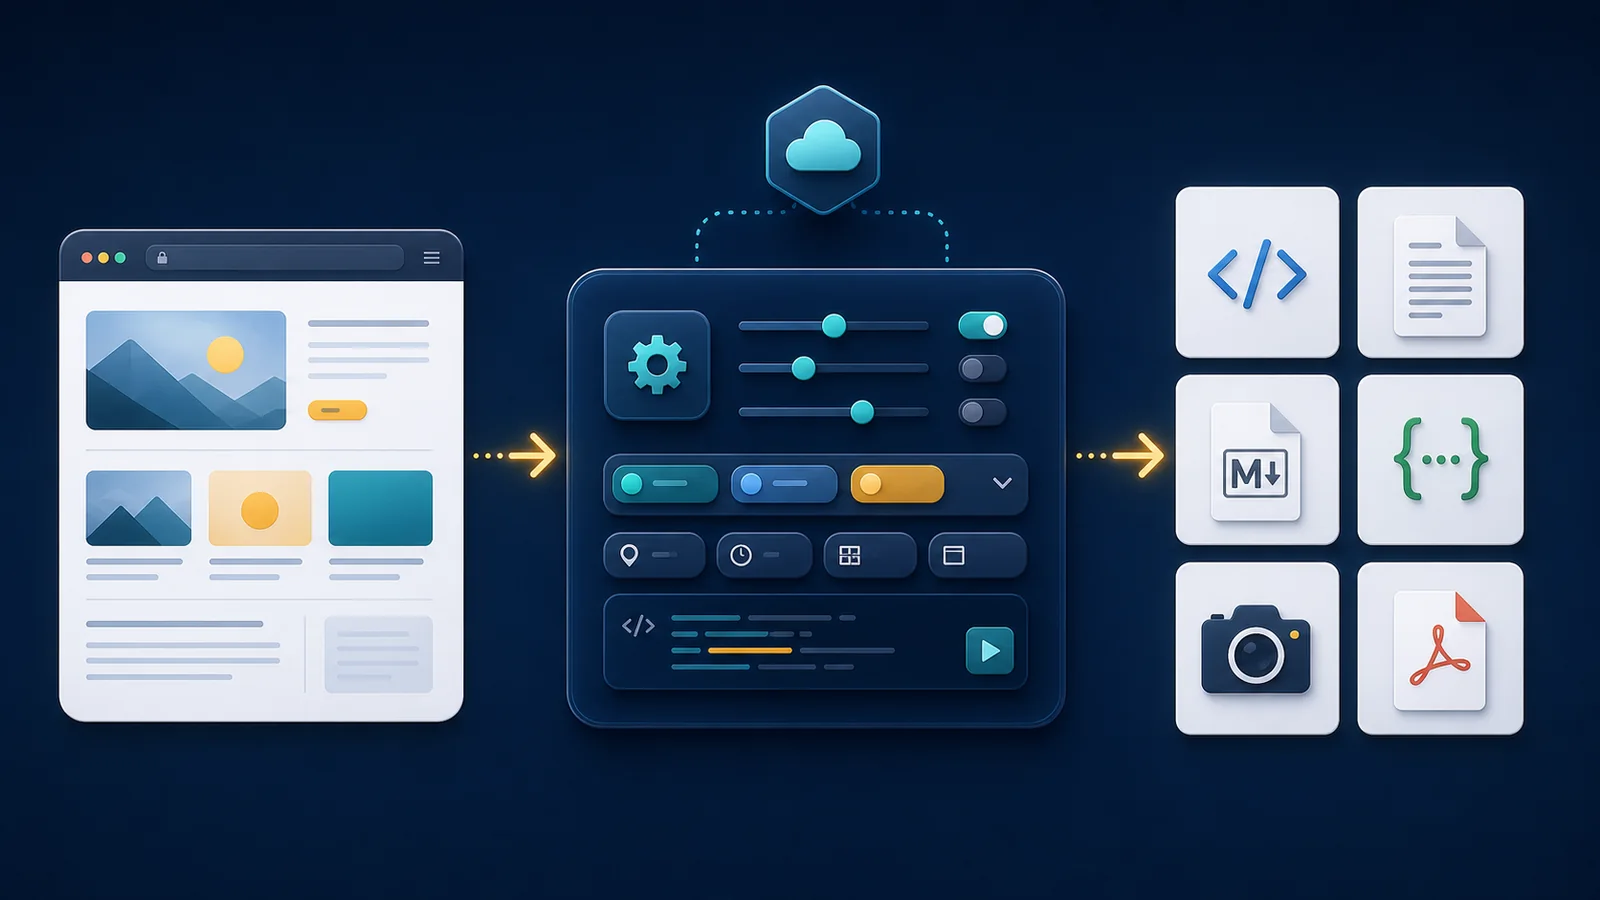
Das beste Antwortformat ist das, das Ihr nächstes System mit dem geringsten Aufwand nutzen kann. HTML ist richtig, wenn Selektoren, Tabellen, Links, Attribute oder DOM-Beziehungen wichtig sind. Gerendertes HTML ist nützlich, wenn Frontend-JavaScript das Markup erstellt, das Ihr Parser benötigt. Text ist leichter, wenn der Workflow nur lesbaren Seiteninhalt benötigt. Markdown hilft KI, RAG, Zusammenfassungen, Dokumentation und Überprüfungs-Workflows, da Überschriften und Links leichter zu verstehen sind als reiner Text.
JSON-Metadaten sind nützlich für den operationale Kontext: Status, endgültige URL, Inhaltstyp, Timing und Antwortdetails, die Protokolle und Debugging unterstützen. Es ersetzt keine benutzerdefinierte Extraktion. Screenshots und PDFs dienen einem anderen Zweck: visuellen Beweisen. Sie helfen bei Überwachung, QA, Compliance-Überprüfungen, Genehmigungen und Archiven, sind jedoch schwerer und normalerweise weniger praktisch für die maschinelle Analyse.
| Ausgabe | Am besten geeignet für | Hauptvorteil | Trade-off |
|---|---|---|---|
| Roh- oder gerendertes HTML | DOM-Parsing, Selektoren, Tabellen, Links | Bewahrt Struktur und Seitenbeziehungen | Erfordert Parser-Logik und Aufräumarbeiten downstream |
| Text | Suche, Indizierung, leichte Analyse | Kompakt und leicht zu verarbeiten | Entfernt den Großteil des strukturellen Kontexts |
| Markdown | KI, RAG, Zusammenfassungen, Inhaltsüberprüfung | Bewahrt lesbare Überschriften, Listen und Links | Nicht ideal für präzise DOM-Extraktion |
| JSON-Metadaten | Protokollierung, Diagnosen, Workflow-Routing | Erleichtert die Inspektion von Anfragebeweisen | Ersetzt keine zielgerichtete Feldextraktion |
| Screenshot oder PDF | QA, Überwachung, Genehmigungen, Archive | Zeigt, wie die gerenderte Seite aussah | Schwerer und weniger praktisch für das Parsing |
Wann sind Rendering, Sitzungen, Header und Proxy-Routing wichtig?
Fortgeschrittene Kontrollen sind wichtig, wenn sie ein spezifisches Zielproblem lösen. Browser-Rendering ist wichtig, wenn die Daten nach der Ausführung von JavaScript erstellt werden. Wartezeiten sind wichtig, wenn der Browser den richtigen Status spät lädt. Header sind wichtig, wenn das öffentliche Ziel legitimen Kontext wie Sprache, Inhaltstyp, Referrer oder ein spezifisches User-Agent-Muster erwartet. Sitzungen sind wichtig, wenn verwandte Anfragen von gemeinsamen Cookies oder Routenstatus abhängen. Länderrouting ist wichtig, wenn öffentliche Inhalte je nach Standort, Währung, Verfügbarkeit oder Regulierung variieren. Premium-Routing ist wichtig, wenn die Antwortbeweise zeigen, dass die Standardlieferung keine nutzbare Seite zurückgibt.
Diese Reihenfolge ist wichtig. Alles auf einmal zu aktivieren, kann eine Anfrage teurer, langsamer und schwieriger zu diagnostizieren machen. Ein besserer Workflow besteht darin, repräsentative Seiten zu testen, die Antwortgröße und den Inhalt zu vergleichen, die endgültige URL und den Status zu überprüfen und dann das kleinste Anfrageprofil auszuwählen, das zuverlässig das benötigte Artefakt produziert. Dies macht auch die Produktionswiederherstellung klarer: Wenn ein Ziel beginnt, eine Weiterleitung, einen Timeout, eine leere Schale oder einen unerwarteten Inhaltstyp zurückzugeben, weiß das Team, welchen Teil des Anfrageprofils es überprüfen muss.
Praktische Erkenntnis: Fügen Sie Rendering, Sitzungen, Header, Routing oder visuelle Ausgaben hinzu, wenn die Antwort beweist, dass sie die Erfassungsqualität verbessern, nicht weil sie verfügbar sind.
Wie hält ScraperFly den Kaufprozess risikoärmer?
Ein Scraping-Projekt beginnt oft unsicher. Das Team weiß möglicherweise nicht, ob das Ziel statisch, JavaScript-lastig, standortsensitiv, sitzungsabhängig oder schwer zu liefern ist. Diese Arbeit in eine schwere Infrastruktur oder einen großen wiederkehrenden Plan zu sperren, bevor das Ziel getestet wird, schafft Risiken. ScraperFly ist für einen einfacheren Weg positioniert: Beginnen Sie mit kostenlosen Credits, validieren Sie echte Seiten, kaufen Sie Credits, wenn ein Projekt sie benötigt, und wechseln Sie zu monatlichen Credits, wenn die wiederkehrende Nachfrage klar ist.
Dieses Modell passt zum technischen Workflow. Eine leichte Anfrage sollte leicht bleiben. Eine schwerere gerenderte oder geroutete Anfrage sollte verwendet werden, wenn sie Wert schafft. Visuelle Dateien sollten generiert werden, wenn jemand visuelle Beweise benötigt. Der API-Builder unterstützt dieselbe Kauf-Logik, da er es dem Team ermöglicht, eine echte Anfrage zu inspizieren, bevor es Klebercode schreibt oder Batches skalieren kann. Kostenkontrolle ist nicht nur ein Preisproblem; es ist eine Gewohnheit im Anfrage-Design.
Was sollte downstream von der Scraping-API bleiben?
ScraperFly sollte nicht als magischer Extraktor dargestellt werden, der jede öffentliche Seite in einen perfekten Datensatz verwandelt. Die API erfasst die Ausgabe öffentlicher Seiten und bietet Kontrollen für Rendering, Routing, Sitzungen, Header, Formate und visuelle Beweise. Ihr Produkt entscheidet weiterhin, was die Daten bedeuten. Feldzuordnung, Entitätsnormalisierung, Duplikation, Qualitätsprüfungen, Warnungen, Bewertungen, Speicherung und Geschäftslogik bleiben downstream, wo sie hingehören.
Diese Grenze macht das Produkt vertrauenswürdiger. Eine Web Scraping API sollte einem Entwickler helfen, zuverlässige Quellbeweise zu erhalten und dann der Anwendung erlauben, ihre eigenen Regeln anzuwenden. Das ist besonders wichtig für KI-, Überwachungs-, Analyse- und Automatisierungs-Workflows, bei denen schlechte Quellbeweise zu schlechten Zusammenfassungen, falschen Warnungen, doppelten Datensätzen oder teuren Wiederholungen führen können.
Wohin sollte ein Team gehen, nachdem es die Grundlagen verstanden hat?
Der nächste Schritt besteht darin, eine echte Anfrage zu erstellen, nicht eine theoretische Architektur. Verwenden Sie den API-Builder, um eine öffentliche URL zu testen, Ausgabeformate zu vergleichen und zu entscheiden, ob die Seite Rendering, Sitzungen, Header, Routing oder visuelle Erfassung benötigt. Wenn die Hauptfrage die Ausgabeform ist, überprüfen Sie die Web Scraping API-Antwortformate-Seite. Wenn die Seite JavaScript-lastig ist, vergleichen Sie das Ergebnis mit den JavaScript-Rendering-API-Hinweisen. Wenn der Zustand bei Anfragen wichtig ist, erklärt die Sitzungs-API-Seite, wann gemeinsamer Kontext nützlich ist.
Sobald das Anfrageprofil bewiesen ist, verschieben Sie es in den Backend-, Worker-, Agent-, Parser-, Monitor- oder Archiv-Workflow, der die Daten benötigt. Das ist das Kernversprechen von ScraperFly: eine praktische API-Schicht für öffentliche Webdaten, mit Kontrollen, die von dem ersten Test bis zur Produktion sichtbar bleiben.












