






Parser-bereite Markup
Fangen Sie zuverlässiges HTML ein, bevor die Extraktionsregeln davon abhängen
Ein HTML-Parser ist nur so zuverlässig wie der Seitenquellcode, den er erhält. Wenn die Anfrage eine dünne Hülle, eine Weiterleitung, einen blockierten Fallback oder Markup zurückgibt, das nur nach der Ausführung von JavaScript erscheint, können Selektoren und Extraktionsregeln fehlschlagen, selbst wenn der Parser selbst korrekt ist.
ScraperFly bietet Teams einen saubereren Ausgangspunkt: Holen Sie sich öffentliche Seiten als rohes HTML, wenn das Markup bereits vorhanden ist, wechseln Sie zu gerendertem HTML, wenn das nützliche DOM im Browser erstellt wird, und bewahren Sie Beweise für die Antwort auf, damit die Parsing-Entscheidungen auf dem tatsächlichen Seitenzustand basieren.
Was ist eine HTML-Parser-API für Web-Scraping?
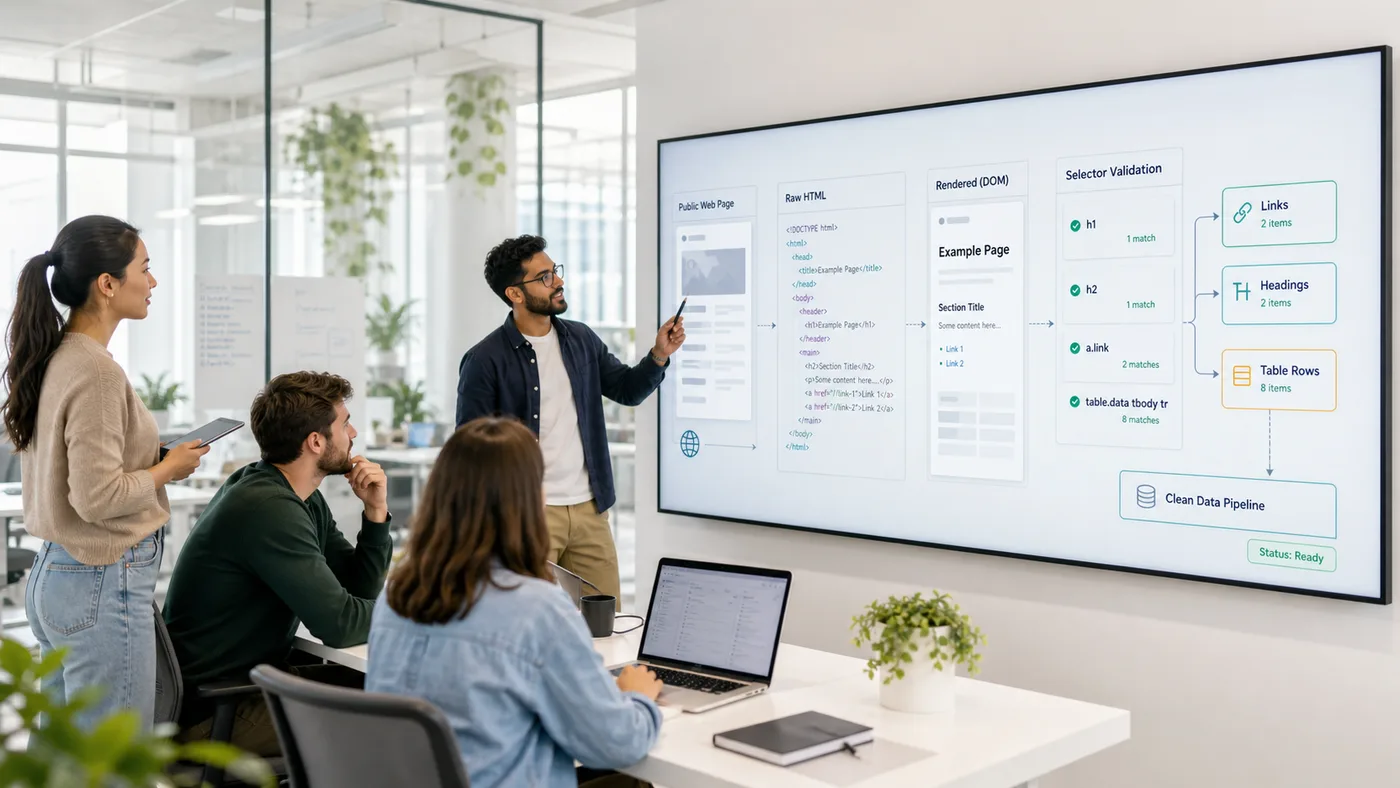
Ein HTML-Parser-API-Workflow beginnt damit, eine öffentliche Seite abzurufen und Ihrer Anwendung Markup zu geben, das sie inspizieren kann. Der Parser extrahiert dann Links, Überschriften, Tabellen, Metadaten, Produktkarten, Artikelabschnitte, Paginierung, eingebettete Daten oder andere Seitenelemente aus dieser erfassten Quelle.
Die praktische Herausforderung besteht nicht nur im Parsen. Es geht darum, die richtige Version der Seite zu erfassen, bevor das Parsen beginnt. Einige Ziele geben nützliches Markup in der ursprünglichen HTML-Antwort preis. Andere senden eine leere App-Hülle und erstellen das DOM im Browser. Einige geben eine andere Seite zurück, abhängig von Headern, Cookies, Region oder Routing. ScraperFly kümmert sich um diese Erfassungsschicht, damit Ihr Parser von einer verifizierten Antwort aus arbeiten kann, anstatt von brüchigem Browserkleber.
Wann sollte der Parser rohes HTML oder gerendertes HTML verwenden?
Rohes HTML ist der beste Ausgangspunkt, wenn das Ziel nützliches Markup sofort sendet. Es ist leichter, schneller zu inspizieren und einfacher, über Proben hinweg zu vergleichen. Gerendertes HTML ist nützlich, wenn die ursprüngliche Quelle nur einen Routencontainer, ein Hydrationsskript, Platzhalterknoten oder spät geladenen Inhalt enthält, der nach der Ausführung im Browser erscheint.
Die Entscheidung sollte pro Ziel und nicht global getroffen werden. Wenn jede URL standardmäßig durch einen Browser gezwungen wird, wird der Workflow schwerer, bevor das Team weiß, ob das Rendering die erfasste Quelle verbessert. Ein besseres Muster besteht darin, zuerst das Quell-HTML abzurufen, es mit den erwarteten Feldern zu vergleichen und das Rendering nur für Seiten zu aktivieren, bei denen der Parser das benötigte Markup nicht sehen kann.
| Parser-Eingabe | Verwenden Sie es, wenn | Hauptvorteil | Wichtige Überprüfung |
|---|---|---|---|
| Rohes HTML | Die ursprüngliche Antwort enthält die Links, Felder, Tabellen oder Inhaltsblöcke. | Leichtgewichtig und einfach zu debuggen. | Bestätigen Sie, dass das Markup vorhanden ist, bevor Sie Selektoren schreiben. |
| Gerendertes HTML | JavaScript erstellt das nützliche DOM, nachdem die Quellantwort geladen wurde. | Erfasst den vom Browser erstellten Seitenzustand. | Verwenden Sie das Rendering nur, wenn es die Antwort ändert. |
| Text oder Markdown | Der nachgelagerte Workflow benötigt lesbaren Inhalt anstelle von DOM-Beziehungen. | Sauberere Eingabe für Inhaltsüberprüfung, Suche und KI-Workflows. | Verwenden Sie es nicht, wenn Selektoren oder Attribute wichtig sind. |
| JSON-Metadaten | Die Anwendung benötigt Antwortkontext für Protokollierung, QA oder Routing-Entscheidungen. | Legt operationale Beweise rund um die Erfassung offen. | Es ergänzt das Parsen; es ersetzt keine zielgerichteten Extraktionsregeln. |
Was sollten Teams validieren, bevor sie Parser-Regeln skalieren?
Parser-Regeln sehen oft stabil bei einer Probe aus und brechen dann über ein URL-Set hinweg. Die Lösung besteht darin, die Antwortform vor der Skalierung zu validieren: Stellen Sie sicher, dass die gleichen Abschnitte vorhanden sind, erwartete Links vorhanden sind, Tabellen eine vorhersehbare Struktur beibehalten, die Paginierung sichtbar ist und die Antwort nicht stillschweigend auf einen anderen Seitentyp umgeleitet wurde.
ScraperFly hilft, indem es die Anfragekontrollen sichtbar hält. Sie können rohen und gerenderten Output vergleichen, die endgültige URL und den Status bewahren, die Antwortgröße inspizieren und Screenshots verwenden, wenn visuelle Beweise wichtig sind. Das macht Selektorfehler leichter diagnostizierbar: Der Parser kann feststellen, ob sich das Ziel geändert hat, das Markup verschoben wurde, JavaScript erforderlich war oder die Erfassung die falsche Seite zurückgegeben hat.
| Validierungspunkt | Warum es wichtig ist | Parser-sichere Aktion |
|---|---|---|
| Erwarteter Container | Der Parser benötigt einen stabilen Abschnitt, von dem aus er starten kann. | Überprüfen Sie, ob rohes oder gerendertes HTML den Container enthält. |
| Links und Paginierung | Viele Crawls scheitern, wenn nächste-Seite-Links fehlen oder transformiert werden. | Überprüfen Sie hrefs und Seitenkontrollen über Proben hinweg. |
| Tabellen und Listen | Daten können zwischen Vorlagen Spalten, Bezeichnungen oder Verschachtelungen verschieben. | Vergleichen Sie die Struktur, bevor Sie Felder zuordnen. |
| Status und endgültige URL | Ein Parser kann eine Anmeldeseite, eine Weiterleitungsseite oder eine sanfte Blockierung erhalten. | Protokollieren Sie die Antwortbeweise mit jedem geparsten Ergebnis. |
| Antwortformat | DOM-Parsen, Textaufnahme und visuelle QA benötigen unterschiedliche Ausgaben. | Wählen Sie HTML, Text, Markdown, JSON, Screenshot oder PDF basierend auf dem Verbraucher. |
Wo passt ScraperFly in eine HTML-Parsing-Pipeline?
ScraperFly sitzt vor Ihrem Parser. Ihre Anwendung sendet eine Ziel-URL und ein Anfrageprofil und erhält dann eine Antwortform, die Ihre Pipeline verwenden kann: rohes HTML für die Quellbearbeitung, gerendertes HTML für vom Browser erstellte Seiten, sauberen Text oder Markdown für Inhalts-Workflows, JSON-Metadaten für Diagnosen oder Screenshots und PDFs für visuelle Beweise.
Diese Trennung ist wertvoll. Ihr Team behält die Kontrolle über Selektoren, Extraktionsregeln, Validierung, Speicherung und Geschäftslogik. ScraperFly kümmert sich um die Abrufschicht, das Browser-Rendering, wenn es tatsächlich benötigt wird, Sitzungs- und Header-Kontext, Routing-Optionen und Antwortformate. Das Ergebnis ist eine sauberere Grenze zwischen "die richtige Seitenquelle abrufen" und "die Daten extrahieren, die uns wichtig sind."
Für einen breiteren Überblick über unterstützte Ausgaben vergleichen Sie die Antwortformate der Web-Scraping-API. Um ein Anfrageprofil zu testen, bevor Sie Produktionscode schreiben, verwenden Sie den öffentlichen API Builder.
Wie können Teams das HTML-Parsen in der Produktion stabil halten?
Das Parsen in der Produktion benötigt Beweise, nicht nur Selektoren. Speichern Sie die Ziel-URL, die endgültige URL, den Status, den Inhaltstyp, die Antwortgröße, die Rendereinstellung, die Zeitsteuerungen und das gewählte Ausgabeformat mit jeder Erfassung. Diese Felder erleichtern es, Parserfehler von Zieländerungen, Lieferproblemen und JavaScript-Rendering-Lücken zu trennen.
Wenn der Parser beginnt, Felder zu vermissen, vermeiden Sie es, die Extraktionslogik sofort neu zu schreiben. Überprüfen Sie zuerst, ob das erfasste Markup weiterhin die erwartete Quelle enthält. Wenn ja, aktualisieren Sie den Parser. Wenn nicht, passen Sie das Anfrageprofil an: rendern Sie die Seite, warten Sie auf späten Inhalt, bewahren Sie den Sitzungsstatus, fügen Sie legitime Header hinzu, wählen Sie das Länderrouting oder verwenden Sie stärkere Lieferungen für Ziele, die nachweisen, dass sie es benötigen.
Wie macht das das Scraping günstiger im Betrieb?
HTML-Parsen wird teuer, wenn Teams das schwerste Anfrageprofil für jede Seite verwenden. ScraperFly unterstützt einen praktischeren Weg: Beginnen Sie mit leichtgewichtigem HTML-Capture, überprüfen Sie, ob das Markup nützliche Daten enthält, und fügen Sie dann das Browser-Rendering, Wartezeiten, Sitzungen, Header, Länderauswahl, Premium-Routing, Screenshots oder PDFs nur hinzu, wenn das Ziel nachweist, dass diese Kontrollen das Ergebnis verbessern.
Dies ist besonders nützlich für Projekte mit gemischten Zielen. Einfache öffentliche Seiten können bei einfachen Erfassungen bleiben. JavaScript-intensive Seiten können gerendertes HTML verwenden. Seiten, die Beweise benötigen, können Screenshot- oder PDF-Ausgaben hinzufügen. Ungleichmäßige Projekte können Pay-as-you-go-Credits verwenden, während vorhersehbare Produktionslasten auf monatliche Credits umsteigen können, wenn das Muster klar ist. Die Preisseite erklärt diesen Weg im Detail.







