






ScraperFlyAPI de datos web lista para IA

request control

API de Scraping con Encabezados Personalizados y soporte para cookies

ScraperFly permite a los equipos enviar encabezados y cookies seleccionados para páginas públicas cuando el contexto de la solicitud cambia la respuesta, manteniendo los perfiles de encabezados pequeños, probables y fáciles de depurar.

Contexto de la solicitud

Envía solo los encabezados que aclaran la respuesta pública

ScraperFly ayuda a los equipos a agregar contexto de solicitud sin convertir cada scraping en una sesión de navegador copiada. Comienza desde una base limpia, luego reenvía los encabezados o cookies que realmente cambian la respuesta pública: idioma, tipo de contenido aceptado, estado de consentimiento, ruta de referencia, comportamiento del dispositivo o preferencias autenticadas por el sitio que ya están disponibles para tu flujo de trabajo.

Eso mantiene el scraping de encabezados personalizados comprensible. Los desarrolladores pueden comparar las respuestas antes y después, ver qué cambió y emparejar encabezados con renderizado, sesiones, segmentación por país o enrutamiento más fuerte solo cuando la evidencia respalda el control adicional.
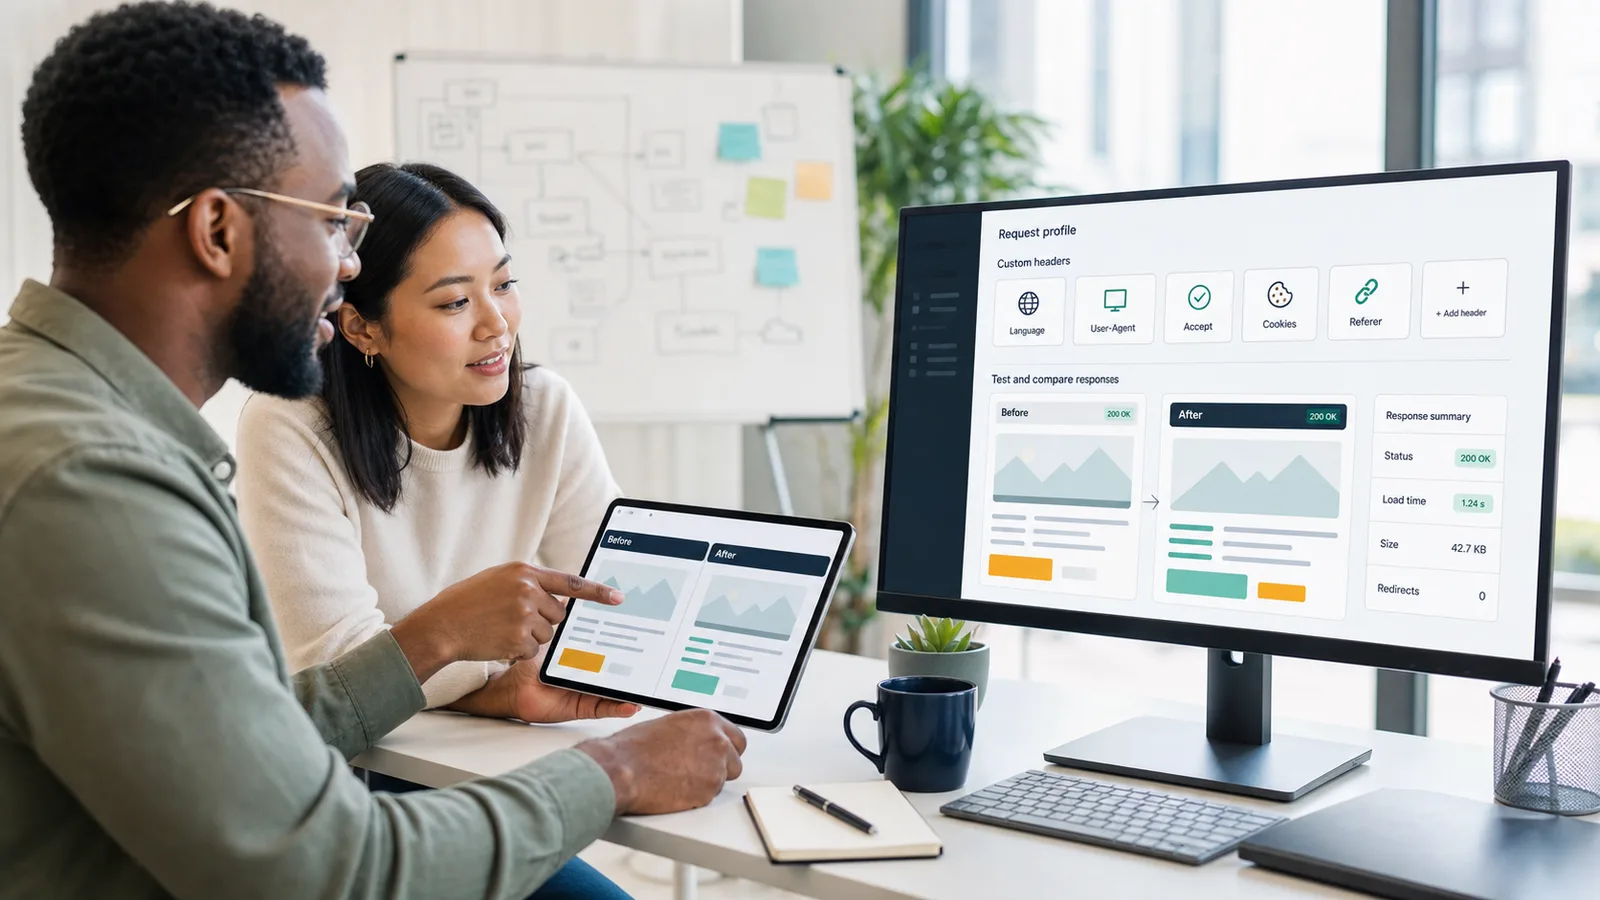
encabezados seleccionadoscookiescomparación de base
Desarrolladores comparando perfiles de respuesta de encabezados personalizados y cookies en un generador de solicitudes de API de scraping

¿Qué es una API de scraping de encabezados personalizados?

Una API de scraping de encabezados personalizados es una capa de solicitud alojada que puede obtener una página pública mientras envía encabezados HTTP o cookies seleccionados con la solicitud. En lugar de construir una pila de obtención separada para cada objetivo, tu aplicación envía la URL del objetivo, elige el formato de salida y los controles de entrega, y agrega contexto de solicitud solo cuando la respuesta del objetivo demuestra que es importante.

Los encabezados no son un bypass mágico. Son señales de contexto. Una página pública puede responder de manera diferente a las preferencias de idioma, tipos de contenido aceptados, familias de agentes de usuario, contexto de referencia, directivas de caché o cookies. El objetivo es hacer que ese contexto sea explícito y comprobable, para que el scraper pueda reproducir la respuesta útil sin llevar desorden innecesario del navegador.

Conclusión práctica: usa encabezados personalizados para explicar un contexto de solicitud requerido, no para disfrazar un perfil de scraping poco claro.

¿Cuándo debe una solicitud de scraping reenviar encabezados?

Reenvía encabezados cuando cambien la respuesta que tu producto puede usar. Un encabezado de idioma puede devolver un texto traducido. Un encabezado de negociación de contenido puede afectar si el objetivo envía HTML, datos similares a JSON o salida comprimida. Un referer puede ser importante para flujos públicos que dependen de una página anterior. Las cookies pueden preservar el consentimiento, la moneda, la región o el estado ligero. El comportamiento del estilo de agente de usuario puede cambiar el diseño o la familia de marcado que un sitio devuelve.

El flujo de trabajo correcto es simple: envía una solicitud base, inspecciona la respuesta, agrega un tipo de contexto, luego compara. Si los campos útiles aparecen, el perfil de encabezados se ganó su lugar. Si nada importante cambia, elimínalo y mantén la solicitud más pequeña.

Encabezado o contexto Qué puede afectar Úsalo cuando
Accept-LanguageIdioma, copia regional, pistas de moneda, etiquetas localizadasEl objetivo devuelve una página útil diferente por localidad o idioma.
Contexto de agente de usuarioFamilia de marcado, diseño responsivo, comportamiento sensible a botsLa misma URL devuelve HTML diferente para diferentes perfiles de cliente.
Accept y encabezados de contenidoTipo de contenido devuelto, compresión, forma de respuestaEl objetivo negocia la salida según los formatos aceptados.
RefererContexto de navegación pública, ruta de redirección, flujo de campaña o listadoLa respuesta del objetivo depende de la ruta de la página pública que llevó a ella.
CookiesEstado de consentimiento, preferencias, moneda, región, continuidad de sesiónEl flujo de trabajo necesita un estado que sea estable, legítimo y reproducible.
Content-TypeManejo del cuerpo POST y comportamiento del objetivo estilo APIEnvías un cuerpo y el objetivo espera un formato de solicitud específico.

¿Por qué los equipos deben evitar copiar cada encabezado del navegador?

Copiar cada encabezado del navegador parece exhaustivo, pero generalmente hace que el scraping sea más difícil de operar. Una solicitud real del navegador puede incluir valores volátiles, pistas del dispositivo, estado de caché, experimentos, contexto de seguimiento y encabezados que son irrelevantes para los datos que necesitas. Cuando todo eso se reenvía por defecto, los fallos se vuelven más difíciles de explicar porque la solicitud ya no tiene una relación clara de causa y efecto.

Un perfil de encabezados más pequeño es más fácil de probar, reproducir, monitorear y mover a código. También hace que las decisiones de costo sean más claras. Si una página funciona con HTML fuente más un encabezado de idioma, no hay razón para pagar el costo de complejidad de renderizado, continuidad de sesión y enrutamiento premium. Si una página aún falla después de que el contexto correcto está presente, el equipo tiene evidencia más sólida para el siguiente paso de escalación.

Usa el API Builder para comparar una solicitud base con una solicitud consciente de encabezados antes de escribir código de parser alrededor del resultado.

¿Cómo son diferentes los encabezados de las cookies y sesiones?

Los encabezados describen la solicitud. Las cookies llevan estado. Las sesiones preservan la continuidad a través de solicitudes relacionadas. A menudo trabajan juntas, pero resuelven problemas diferentes. Un encabezado de idioma puede pedir una versión regional de una página. Una cookie puede mantener una elección de consentimiento o preferencia de moneda. Una sesión puede mantener ese estado consistente mientras el flujo de trabajo se mueve a través de páginas públicas relacionadas.

Esa diferencia importa porque cada control debe tener un trabajo claro. Si una sola página pública necesita una señal de idioma, un encabezado puede ser suficiente. Si un flujo de trabajo debe mantener el estado a través de una página de búsqueda, una página de listado y una página de detalles, las sesiones son más apropiadas. Si el contenido útil aparece solo después de que se ejecuta el código del frontend, los encabezados por sí solos no reemplazarán el renderizado de JavaScript.

Control Mantiene o cambia Mejor uso Error común
EncabezadosContexto de solicitud para una solicitudIdioma, salida aceptada, familia de agente de usuario, contexto de referenciaReenviar encabezados ruidosos del navegador sin evidencia.
CookiesEstado proporcionado por el objetivoConsentimiento, preferencias, estado regional, continuidad ligeraUsar cookies obsoletas o no relacionadas en diferentes objetivos.
SesionesContinuidad a través de solicitudes relacionadasFlujos públicos de múltiples pasos que dependen de un estado compartidoUsar sesiones para páginas aisladas sin dependencia.
RenderizadoEstado de página construido por el navegadorSPAs, contenido cargado en el frontend, esperas, capturas de pantalla, PDFsRenderizar páginas donde el HTML fuente ya contiene los datos.
Segmentación por paísPerspectiva de solicitud geográficaPáginas que varían por región, moneda, disponibilidad o redirecciónUsar geografía cuando una simple señal de idioma o cookie era suficiente.

¿Qué evidencia de respuesta prueba que un perfil de encabezados funciona?

La prueba útil está en la respuesta, no en la lista de encabezados. Compara la URL final, el código de estado, el tipo de contenido, el tamaño de la respuesta, el idioma, los campos visibles, los enlaces extraídos, el comportamiento de redirección y los resultados del parser a través de muestras. Si el único cambio es cosmético, el encabezado puede no valer la pena mantenerlo. Si los campos del objetivo se vuelven disponibles o se estabilizan a través de páginas, el perfil es útil.

Elige la salida que facilite la comparación. HTML es útil cuando los selectores y las relaciones DOM importan. Texto o Markdown pueden hacer que las diferencias de contenido sean más fáciles de leer. Los metadatos JSON ayudan con diagnósticos como URL final, estado, tamaño de respuesta y tipo de contenido. Las capturas de pantalla y los PDFs ayudan cuando un humano necesita prueba visual. La guía de formatos de respuesta explica cuándo cada forma de salida vale la pena usar.

Conclusión práctica: mantén un encabezado solo cuando cambie la respuesta de una manera que tu producto pueda usar o tu equipo pueda explicar.

¿Cómo funcionan los encabezados con el renderizado y el enrutamiento?

Los encabezados pueden ser parte de un perfil de solicitud más amplio. Un objetivo puede necesitar un encabezado de idioma y HTML en bruto. Otro puede necesitar cookies y una sesión persistente. Una página con mucho JavaScript puede necesitar renderizado más una espera. Una página sensible a la región puede necesitar segmentación por país. Un objetivo más estricto puede necesitar una entrega más fuerte a través de una API de scraping de proxy rotativo o enrutamiento premium.

El error es habilitar cada control a la vez. Eso oculta qué control resolvió el problema y hace que el comportamiento de producción sea difícil de ajustar. Comienza con encabezados cuando el contexto de la solicitud es la brecha sospechada, luego escala solo cuando la evidencia de respuesta apunta a renderizado, sesiones, geografía o enrutamiento.

¿Cómo puede el scraping de encabezados personalizados mantenerse predecible?

Mantén cada perfil de solicitud pequeño, nombrado y repetible. Documenta qué encabezados se reenvían y por qué. Prueba URLs representativas antes de escalar. Separa plantillas de página que necesitan diferentes contextos. Rastrea el estado, la URL final, el tamaño de respuesta, el tipo de contenido y la calidad de los campos extraídos para que las malas respuestas no entren silenciosamente en el pipeline.

El control de costos sigue la misma lógica. Los encabezados y cookies son a menudo más ligeros que el renderizado del navegador o el enrutamiento premium, pero un perfil ruidoso aún puede crear sobrecarga de depuración. Mantén las páginas simples simples, reserva controles más pesados para páginas que demuestren que los necesitan y revisa los precios antes de escalar una nueva clase de objetivo.

¿Dónde debe comenzar un equipo?

Comienza con una solicitud base de ScraperFly para la URL pública del objetivo. Captura HTML o el formato de respuesta que tu parser necesita. Agrega el contexto de encabezado o cookie más pequeño que podría explicar el resultado faltante o inestable. Compara salidas. Si la respuesta mejora, mantén el perfil. Si no, elimina el encabezado e investiga el renderizado, las sesiones, el enrutamiento o errores específicos del objetivo en su lugar.

Para páginas de encabezados enfocadas, usa las guías dedicadas para comportamiento de agente de usuario, Accept-Language, y contexto de Referer. Para pruebas prácticas, abre el API Builder y compara los perfiles de solicitud antes de escribir código de parser de producción.


Encabezados personalizados

Envía el contexto de la solicitud que el objetivo entiende sin ocultar el perfil de scraping

Los encabezados pueden afectar el idioma, el tipo de contenido, el comportamiento del dispositivo, el manejo de caché y el acceso a páginas públicas. ScraperFly permite a los equipos agregar contexto de encabezado deliberadamente, comparar la respuesta y mantener la forma final de la solicitud fácil de reproducir.

Respuesta HTML cruda mapeada a datos visibles de la página
01

Disponibilidad de HTML crudo

Verifica si los campos que necesitas ya están presentes en la primera respuesta HTML.

Mejor primera prueba para páginas simples, artículos, documentos, listados y detalles de productos.

Comparación antes y después de la renderización de JavaScript
02

Dependencia de JavaScript

Compara HTML crudo con el DOM renderizado o captura de pantalla antes de activar la renderización del navegador.

Usa la renderización cuando el HTML crudo es solo una estructura y los scripts crean el contenido útil.

Cookies, consentimiento, contexto de sesión y acceso para scraping
03

Estado y contexto de acceso

Identifica si las cookies, el consentimiento, los límites de inicio de sesión, la paginación o el mismo estado del visitante afectan la respuesta.

Usa sesiones y encabezados cuando la continuidad cambia los datos que recibes.

Variaciones de contenido regional a través de países y rutas
04

Variación geo/contenido

Prueba si el país, idioma, moneda, inventario, SERP, anuncios o la reputación de la ruta cambian el resultado.

Usa enrutamiento geo o premium solo cuando el objetivo demuestra que la respuesta varía según la ruta.

Verificaciones antes del scraping de encabezados personalizados

¿Dónde está el campo objetivo?

Encuentra si el campo existe en HTML crudo, DOM renderizado, una llamada API, datos estructurados, un archivo o un estado de interacción posterior.

¿Qué cambia la respuesta?

Muestra algunas URL y compara el estado, la URL final, la longitud del contenido, redirecciones, estados vacíos y diferencias en los resultados visibles.

¿Qué contexto se requiere?

Marca cualquier dependencia en consentimiento, localización, cookies, encabezados, límites de autenticación, paginación, filtros o solicitudes anteriores.

¿Cómo se ve el fallo?

Define las señales para respuestas bloqueadas, parciales, obsoletas, redirigidas, vacías, con tiempo de espera o desajustadas por región antes de escalar.

Cómo los encabezados cambian la configuración de scraping

Modo de obtención

La disponibilidad de HTML crudo decide si la primera solicitud puede permanecer simple o necesita renderizado, esperas, capturas de pantalla o extracción.

Contexto de la solicitud

Los requisitos de estado deciden si agregar encabezados, cookies, sesiones, manejo de consentimiento o un perfil de visitante estable.

Elección de enrutamiento

Los hallazgos geográficos y de reputación deciden si el enrutamiento estándar es suficiente o si se justifica una ruta de país/premium.

Reglas de validación

Los estados de fallo conocidos se convierten en verificaciones para reintentos, escalación, revisión de QA y decidir cuándo un perfil más ligero sigue siendo completo.

Generador de solicitudes de encabezados

Construye solicitudes de scraping con encabezados, formato de salida y controles de entrega en un solo lugar

Los encabezados personalizados son útiles cuando el objetivo varía según la señal del cliente o necesita un contexto de solicitud pública específico. Comienza con el conjunto de encabezados más pequeño, luego agrega renderizado, sesiones, segmentación por país o enrutamiento más fuerte cuando las muestras justifiquen la complejidad adicional.

01
01

Agrega solo los encabezados que cambian la respuesta

Mantén el perfil de solicitud limpio para que el equipo pueda explicar por qué existe cada encabezado.

02
02

Verifica el impacto del encabezado contra una base

Compara estado, URL final, tipo de contenido, tamaño y campos extraídos antes de escalar.

03
03

Mueve el perfil de encabezados probado a código

Copia una solicitud reproducible en cURL, Python, Node.js, Postman o un trabajo de backend.

Controles que mantienen las solicitudes predecibles

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Manejo de errores

Convierte los fallos de scraping en soluciones

Cada flujo de trabajo de datos web eventualmente se encuentra con una respuesta mala: una URL faltante, una clave inválida, una estructura HTML vacía, un objetivo 403, un límite de tasa, un tiempo de espera de renderizado, una captura de PDF rota o una carga útil JSON que no contiene los campos que tu producto esperaba. ScraperFly está diseñado para hacer que esos momentos sean diagnosticables. Inspeccionas el estado HTTP, el código de error estable, el perfil de solicitud y el artefacto devuelto, luego eliges el siguiente movimiento útil más económico: corregir la solicitud, agregar créditos, desacelerar, reintentar con retroceso, habilitar el renderizado, cambiar de país, usar enrutamiento premium, preservar encabezados o validar la salida antes de escalar.

Forma de error estableDecisiones de reintentoEscalación consciente de costosValidación de salida
Desarrollador revisando código y parámetros de solicitud de API en una laptop

01 / Configuración de solicitud y acceso

Corrige primero los errores de solicitud

Algunas fallas no son problemas del objetivo en absoluto. Ocurren antes de que ScraperFly pueda hacer un intento de entrega significativo: una URL faltante o mal formada, un formato de salida no soportado, un tipo de archivo visual incompatible, una clave de API faltante, una clave inválida, o una clave que ha sido pausada o deshabilitada. Estos errores son señales de configuración, no señales de reintento: detén el flujo de trabajo, señala al desarrollador el campo exacto que necesita corrección, y mantén los créditos enfocados en pruebas reales del objetivo en lugar de entradas incorrectas repetidas.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Valida la URL y la codificación antes de enviar un lote.
  • Usa salidas soportadas: HTML, texto, Markdown, JSON, captura de pantalla o PDF.
  • Ajusta los tipos de archivo de captura de pantalla al tipo de salida de imagen y el tipo de archivo PDF a la salida PDF.
  • Trata las claves de API faltantes o inválidas como trabajo de configuración, no como trabajo de reintento.
Tablero de negocios con gráficos, documentos y planificación de uso en un escritorio

02 / Créditos, límites y concurrencia

Separar límites de fallos

Una carga de trabajo puede fallar porque la cuenta no tiene créditos utilizables, se ha alcanzado el límite del plan mensual, o la concurrencia es demasiado agresiva para el plan actual y la mezcla de objetivos. ScraperFly hace visibles esos límites como señales operativas, no como fallas misteriosas de raspado. Eso mantiene la decisión de compra práctica: comienza gratis, prueba el objetivo, compra créditos de pago por uso para trabajos irregulares, pasa a créditos mensuales cuando el volumen se vuelve predecible, y usa retroceso cuando la presión de solicitud es el verdadero problema.

usage_limit_reachedrate_limitedcreditsretroceso
  • Usar el estado de la cuenta para verificar créditos restantes antes de ejecuciones grandes.
  • Reintentar límites de tasa con retroceso en lugar de aumentar la presión de inmediato.
  • Mantener proyectos únicos en pago por uso cuando el volumen es desigual.
  • Mover trabajos recurrentes predecibles a créditos mensuales cuando el patrón esté comprobado.
Sala de servidores que representa rutas de entrega, enrutamiento e infraestructura de red

03 / Entrega objetivo y red

Encontrar fallos de entrega primero

Muchas plataformas de scraping colapsan los problemas de entrega en un fallo de solicitud vago. En producción, eso no es suficiente. El equipo necesita saber si la solicitud se agotó, si el objetivo ascendente devolvió un error temporal del servidor, si la conexión falló, si la respuesta fue demasiado grande, si las redirecciones fueron a algún lugar inesperado, o si la página regresó como un HTML pequeño sin contenido útil. ScraperFly convierte esos fallos en evidencia de entrega: prueba primero el perfil ligero, compara el estado y el tamaño de la respuesta, luego decide si la siguiente solicitud necesita retroceso, otra ruta, proxy premium, segmentación por país, o una captura más estrecha.

tiempo de espera5xxredireccionesrespuesta_demasiado_grande
  • Reintentar fallos temporales de red y ascendentes con una política de retroceso controlada.
  • Comparar URL final, estado, tipo de contenido y tamaño de respuesta entre muestras.
  • Escalar el enrutamiento solo cuando la respuesta demuestre que el camino simple es inestable.
  • Tratar respuestas sobredimensionadas como un problema de alcance antes de escalar el mismo perfil.
Pantalla de seguridad digital que representa señales de anti-bot y acceso protegido

04 / Bloques de anti-bot, geográficos y de acceso

Leer bloques antes de la escalación

Una pantalla de error 403, 401, 429, CAPTCHA, desafío WAF, muro de inicio de sesión, bucle de consentimiento o desajuste específico de región no es solo un error; es una pista sobre lo que el sitio espera del visitante. Los competidores a menudo empujan a los equipos hacia un perfil predeterminado más pesado, pero eso puede agotar el presupuesto sin demostrar la solución. El mejor camino de ScraperFly es la escalación basada en evidencia: preservar encabezados realistas cuando el contexto importa, usar sesiones cuando la continuidad cambia la respuesta, habilitar renderizado cuando el contenido útil es generado por el navegador, y elegir enrutamiento premium o por país cuando la reputación o la geografía cambian el resultado.

403429CAPTCHAdesajuste de país
  • Usar enrutamiento premium cuando la reputación de IP es el cuello de botella comprobado.
  • Usar segmentación por país cuando el idioma, la moneda, el inventario o los resultados de búsqueda cambian según el mercado.
  • Usar encabezados, cookies y sesiones cuando el estado del visitante cambia la respuesta.
  • Reducir la concurrencia y agregar retroceso cuando las solicitudes repetidas activan la limitación del objetivo.
Desarrollador preparando código y artefactos de salida en una laptop

05 / Calidad de renderizado y salida

Enviar artefactos utilizables

Un estado 200 no es lo mismo que un raspado utilizable. El HTML crudo puede ser un shell de aplicación vacío, Markdown puede omitir el artículo principal, JSON puede carecer de metadatos esperados, el texto puede incluir ruido, las capturas de pantalla pueden estar en blanco, y la salida en PDF o imagen puede fallar si el paso del navegador se agota. ScraperFly es valioso porque la misma solicitud de API puede pasar de HTML crudo a DOM renderizado, texto limpio, Markdown, JSON, captura de pantalla o PDF, y luego ser verificada contra el artefacto que tu producto realmente necesita. Eso reduce el código de pegamento, las importaciones fallidas y las ejecuciones por lotes costosas que solo descubren una mala salida después del hecho.

render_timeoutbrowser_render_failedcampos JSONsalida PDF/imágenes
  • Habilitar renderizado cuando el HTML crudo es solo un shell y el contenido útil aparece después de JavaScript.
  • Valida texto, Markdown y JSON contra los campos esperados antes de agrupar.
  • Utiliza captura de pantalla o salida en PDF cuando la prueba visual o la evidencia de auditoría son importantes.
  • Considera los artefactos en blanco o parciales como fallos de calidad incluso cuando el estado HTTP es exitoso.
Ajuste de ScraperFly

Recuperación de errores más limpia

ScraperFly ayuda a los equipos a decidir qué corregir, qué reintentar y qué escalar sin convertir cada raspado en el perfil de solicitud más costoso.

Forma de error estable

Utiliza el estado HTTP y el código de error juntos para que la lógica de la aplicación pueda elegir entre corregir la entrada, actualizar credenciales, desacelerar, reintentar o escalar la entrega.

Reintentar solo cuando ayuda

Las fallas de red, los límites de tasa y los errores temporales del servidor pueden usar retroceso. Las URL inválidas, los formatos no soportados y las claves incorrectas deben corregirse una vez.

Escalación consciente de costos

Comienza con el perfil de solicitud ligero, luego agrega renderizado, enrutamiento premium, país, sesiones, encabezados, esperas o captura visual solo cuando la falla lo demuestre.

Valida la salida antes de escalar

Confirma el artefacto real que tu producto necesita: HTML, texto, Markdown, JSON, captura de pantalla o PDF, antes de copiar el mismo perfil en un gran conjunto de URL.

Costo de encabezados

Mantén los experimentos de encabezados pequeños antes de agregar controles más pesados

Los encabezados son ligeros en comparación con la renderización del navegador o el enrutamiento premium. Prueba primero los encabezados cuando el contexto de la solicitud pueda resolver el problema, luego escala solo si la evidencia de la respuesta apunta allí.

Una solicitud HTML ligera que devuelve una respuesta simple
01

Obtención básica

Utiliza una obtención básica cuando el HTML público ya contiene los campos que necesitas.

Perfil de solicitud más ligero; mantenlo cuando la respuesta esté completa.

Renderizado de JavaScript produciendo un DOM completo
02

Renderización

Utiliza el renderizado cuando el HTML en bruto es una estructura y JavaScript completa la página.

Perfil más pesado; úsalo solo cuando la salida del navegador cambie el resultado.

Varios requests preservando cookies y estado del visitante
03

Sesión con estado

Usa sesiones cuando las cookies, el consentimiento, la localidad o la paginación cambien la respuesta.

Perfil de estado más pesado; conservalo solo cuando la continuidad sea importante.

Enrutamiento de requests a través de rutas geo y de mayor calidad
04

Enrutamiento y geo premium

Usa enrutamiento premium o geo solo cuando el origen, país, reputación o contenido regional cambien el resultado.

Perfil de enrutamiento más pesado; aplícalo solo a objetivos que demuestren que lo necesitan.

Qué hace que el scraping basado en encabezados sea más pesado

Más trabajo de infraestructura

El renderizado en el navegador, las opciones de enrutamiento y las esperas más largas significan que la plataforma tiene que hacer más que devolver una simple respuesta.

Más incertidumbre del objetivo

Redirecciones, estados vacíos, límites de tasa y páginas de desafío a menudo requieren opciones de entrega más fuertes o reintentos.

Más estado que preservar

Cookies, sesiones, consentimiento y flujos de múltiples páginas añaden partes móviles que una simple obtención sin estado no tiene.

Más evidencia para devolver

Capturas de pantalla, PDFs, salida renderizada y artefactos de respuesta más ricos son útiles, pero son más pesados que el HTML simple.

Cómo mantener los flujos de trabajo de encabezados predecibles

Muestra antes de escalar

Prueba primero un pequeño conjunto de URL y agrupa los objetivos por el perfil más ligero que devuelva datos completos.

No renderizar por defecto

Inspecciona el HTML crudo antes de activar el renderizado. Muchas páginas públicas ya contienen los datos que necesitas.

Escalar por evidencia

Aumenta solo cuando la respuesta muestre contenido faltante, dependencia de estado, variación geo o problemas de enrutamiento.

Mide resultados útiles

Optimiza en torno a registros válidos entregados, no al volumen de requests crudos. Un perfil más ligero es mejor solo cuando se mantiene completo.

Preguntas sobre encabezados

Preguntas comunes sobre encabezados personalizados y cookies en ScraperFly

Respuestas prácticas para equipos que deciden cuándo los encabezados, cookies, sesiones, renderización y enrutamiento deberían ser parte de una solicitud pública de web scraping.

PREGUNTAS FRECUENTES SOBRE ENCABEZADOS
HEADERS

Reenviando el contexto de la solicitud

Los encabezados deben explicar un cambio específico en la respuesta, no copiar un navegador por hábito.

¿Debería reenviar todos los encabezados del navegador?

No. Comienza con el conjunto más pequeño que cambie la respuesta de manera útil, luego elimina cualquier cosa que no mejore el resultado.

¿Qué encabezados valen la pena probar primero?

Prueba el idioma, user-agent, accept, tipo de contenido, referer o encabezados relacionados con la caché cuando la respuesta base sugiere que una de esas señales cambia la página.

COOKIES

Trabajando con estado público

Las cookies pueden llevar preferencias o continuidad cuando el flujo de trabajo depende genuinamente de ellas.

¿Cuándo ayudan las cookies en una solicitud de scraping?

Las cookies ayudan cuando una página pública necesita estado de consentimiento, moneda, idioma, región, preferencias o continuidad que sea legítima y reproducible para el flujo de trabajo.

¿Son las cookies lo mismo que las sesiones?

No. Las cookies llevan valores de estado. Las sesiones mantienen solicitudes relacionadas juntas para que el estado permanezca consistente a lo largo de un flujo de trabajo público de múltiples pasos.

CONTROLS

Combinando encabezados con opciones de ScraperFly

Los encabezados pueden trabajar junto con renderizado, sesiones, segmentación por país y enrutamiento cuando la evidencia respalda la mezcla.

¿Pueden los encabezados funcionar con renderizado en JavaScript?

Sí. Usa encabezados para el contexto de la solicitud y renderizado para contenido construido por el navegador. Habilita ambos solo cuando cada uno resuelva un problema visible de respuesta.

¿Cuándo se debe agregar el enrutamiento?

Agrega segmentación por país, proxies rotativos o enrutamiento premium cuando el estado, redirecciones, bloqueos o salida regional muestren que la ruta de entrega afecta la respuesta.

DEBUGGING

Manteniendo perfiles predecibles

Un perfil claro facilita el diagnóstico de fallos antes de que el tráfico escale.

¿Cómo sé si un encabezado ayudó?

Compara las respuestas de línea base y las que tienen en cuenta los encabezados para la URL final, estado, tipo de contenido, tamaño de respuesta, idioma, campos visibles y salida del analizador.

¿Cómo afectan los encabezados al control de costos?

Los encabezados son ligeros en comparación con el renderizado del navegador o el enrutamiento premium, por lo que a menudo vale la pena probarlos primero cuando se sospecha que el contexto de la solicitud es el problema.










