






Continuidad de sesión
Mantén el estado de la solicitud estable cuando las páginas públicas dependen de la continuidad
Algunos flujos de trabajo de scraping público no son realmente trabajos de una sola solicitud. Un objetivo puede establecer cookies, recordar el estado de consentimiento, mantener filtros activos, preservar el contexto de paginación o esperar que varias solicitudes relacionadas utilicen el mismo camino de entrega. Si ese estado desaparece entre solicitudes, la siguiente respuesta puede parecer incompleta, redirigida, inconsistente o simplemente diferente de la página que tu flujo de trabajo esperaba.
Las sesiones de ScraperFly brindan a los equipos una forma controlada de preservar el contexto útil de la solicitud sin hacer que cada scraping sea persistente por defecto. Comienza con una solicitud simple, compara la respuesta, luego agrega continuidad de sesión solo donde muestras repetidas demuestran que las cookies, el estado de la ruta, los encabezados, el renderizado o el contexto de enrutamiento realmente cambian el resultado.
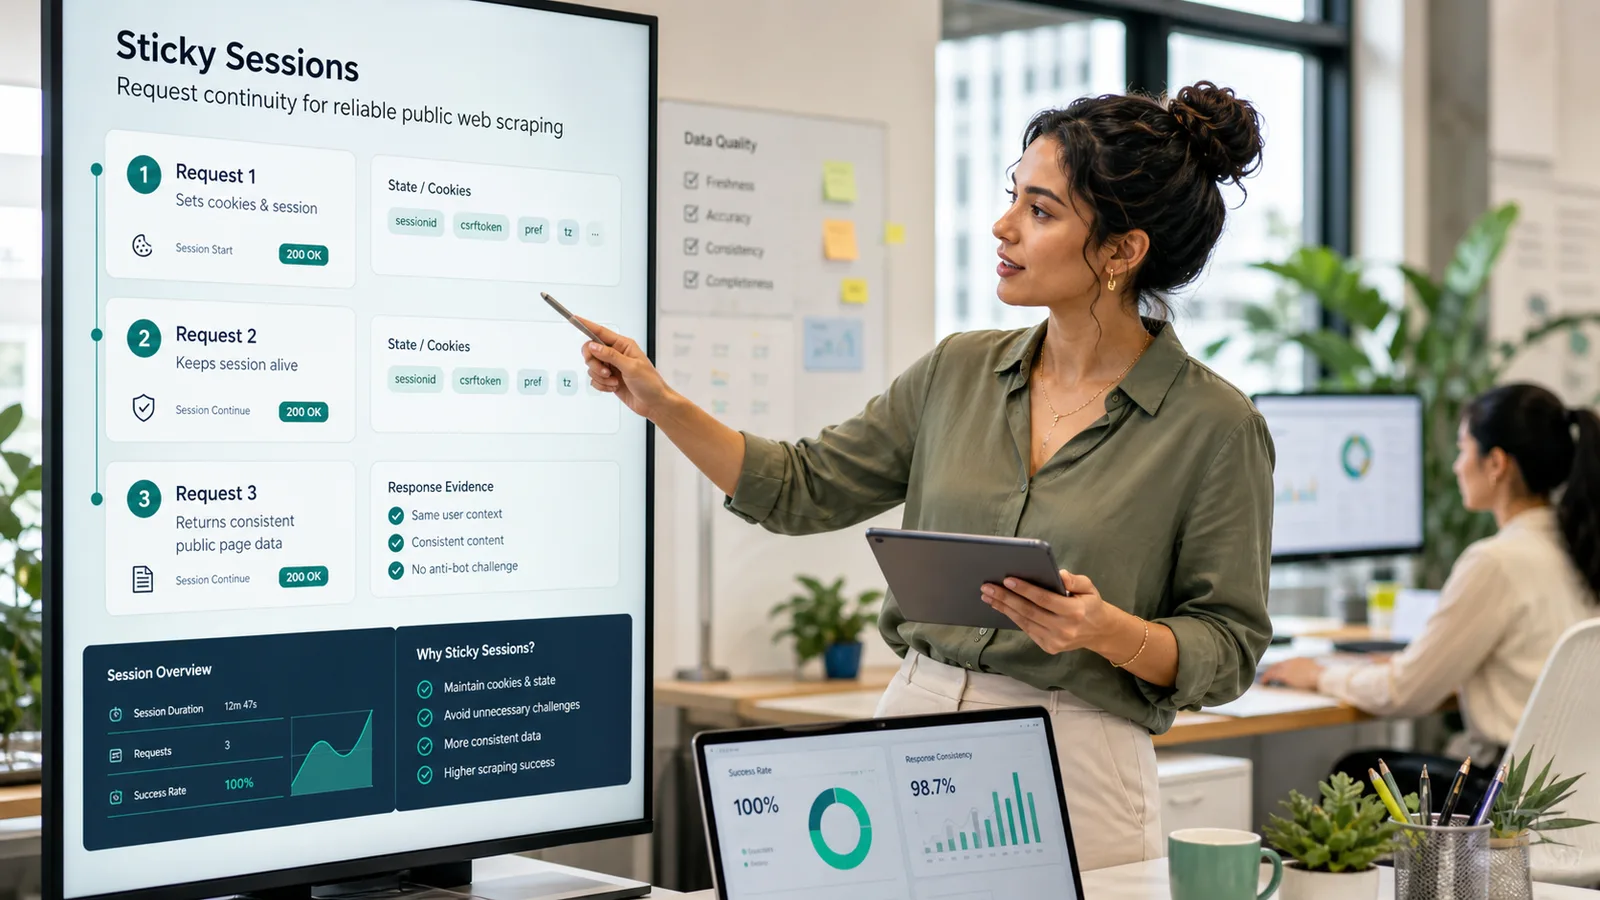
¿Qué son las sesiones persistentes en web scraping?
Las sesiones persistentes mantienen el contexto de la solicitud estable a través de solicitudes relacionadas de páginas públicas. En la práctica, eso puede significar preservar cookies, estado o continuidad de enrutamiento para que una secuencia de solicitudes se comporte como un flujo de trabajo conectado en lugar de varios fetches no relacionados. El valor no es la palabra sesión en sí. El valor es recibir una respuesta pública consistente cuando el objetivo depende de la continuidad.
Una solicitud sin estado sigue siendo la mejor opción por defecto para muchas páginas. Si el objetivo devuelve HTML, texto, Markdown, metadatos, captura de pantalla o salida PDF útil sin estado, agregar una sesión solo hace que el perfil de la solicitud sea más difícil de razonar. Usa sesiones cuando la respuesta demuestre que la continuidad importa.
Conclusión práctica: las sesiones son para solicitudes relacionadas que necesitan continuidad, no para cada captura de página pública.
¿Cuándo debería un flujo de trabajo de scraping usar sesiones?
Usa sesiones cuando la respuesta del objetivo cambie después de la primera solicitud o cuando las solicitudes posteriores dependan del estado establecido anteriormente. Ejemplos comunes incluyen flujos de consentimiento, filtros públicos, paginación, refinamientos de búsqueda, selección de región, preferencias de idioma, estado de ruta e interacciones públicas de múltiples pasos donde la siguiente página espera que el contexto anterior permanezca presente.
Las sesiones también son útiles al depurar diferencias en las respuestas. Si una solicitud devuelve la vista pública esperada y la siguiente solicitud la pierde, el problema puede ser la continuidad del estado en lugar de la ruta del proxy, el renderizado de JavaScript o la lógica del analizador. Una sesión permite al equipo probar esa hipótesis de manera limpia.
| Señal de flujo de trabajo | Lo que sugiere | Mejor acción siguiente |
|---|---|---|
| La primera página establece cookies o estado de consentimiento | Las solicitudes posteriores pueden depender del contexto almacenado | Prueba una sesión a través de la secuencia de solicitudes relacionadas. |
| La paginación pierde filtros | El estado no se está preservando entre páginas | Mantén el flujo de trabajo en una sesión estable. |
| El contenido cambia después de la selección de región o idioma | La respuesta pública depende del contexto | Combina sesiones con encabezados o enrutamiento por país cuando sea necesario. |
| La página renderizada funciona una vez pero no después | El estado del navegador, las cookies o el tiempo pueden afectar la respuesta | Compara el renderizado con y sin continuidad de sesión. |
| Una URL única devuelve contenido útil | El estado no es necesario | Mantén la solicitud sin estado y más ligera. |
¿Son las sesiones lo mismo que las cookies?
No. Las cookies son una parte del contexto de la solicitud. Una sesión es el modelo de continuidad más amplio que mantiene conectadas las solicitudes relacionadas. Una sesión puede preservar cookies, pero la razón comercial para usarla suele ser mayor: paginación estable, solicitudes públicas repetidas, enrutamiento consistente, preferencias seleccionadas o un flujo de trabajo que necesita el mismo contexto a través de los pasos.
Esta distinción mantiene la implementación más limpia. Si un solo encabezado resuelve la respuesta, usa un encabezado. Si el renderizado resuelve la respuesta, usa renderizado. Si el enrutamiento por país resuelve una diferencia regional, usa enrutamiento por país. Si las solicitudes relacionadas necesitan un estado compartido, usa una sesión. Cada control debe tener una razón.
| Control | Lo que preserva o cambia | Úsalo cuando |
|---|---|---|
| Cookies | Estado del objetivo almacenado | La respuesta pública depende del consentimiento, preferencias o valores establecidos por el objetivo. |
| Sesión | Continuidad a través de solicitudes relacionadas | Una secuencia necesita un contexto estable de una solicitud a la siguiente. |
| Encabezados | Contexto de solicitud legítimo | El objetivo varía según el idioma, agente de usuario, referer o tipo de contenido aceptado. |
| Enrutamiento por país | Contexto de entrega regional | La página pública cambia según la ubicación, moneda, disponibilidad o reglas de redirección. |
| Enrutamiento premium | Caminos de entrega más fuertes | El camino simple falla repetidamente después de que la solicitud es válida. |
| Renderizado | Estado de página ejecutado por el navegador | JavaScript crea el contenido útil después de la primera respuesta HTML. |
¿Cómo funcionan las sesiones con el enrutamiento de proxies y el renderizado?
Las sesiones, el enrutamiento y el renderizado pueden trabajar juntos, pero resuelven problemas diferentes. Una sesión mantiene la continuidad. El enrutamiento cambia el camino de entrega. El renderizado ejecuta JavaScript. Los encabezados llevan el contexto de la solicitud. El enrutamiento por país solicita una vista regional. El enrutamiento premium es una escalada para objetivos públicos más difíciles. Combinar todos ellos por defecto hace que la solicitud sea más pesada y más difícil de depurar.
El mejor patrón es probar una razón a la vez. Si el HTML fuente es delgado, prueba el renderizado. Si la página cambia por región, prueba el enrutamiento por país. Si las solicitudes repetidas pierden estado, prueba las sesiones. Si la ruta simple devuelve repetidamente un comportamiento de bloqueo después de que la solicitud es válida, prueba un enrutamiento más fuerte. Una sesión debe ser parte de un perfil de solicitud probado, no una conjetura.
Para controles adyacentes, compara scraping con proxy rotativo, encabezados personalizados y la API de renderizado de JavaScript.
¿Qué deben inspeccionar los equipos antes de escalar el scraping de sesiones?
Antes de que un flujo de trabajo persistente se convierta en un trabajo por lotes, inspecciona la evidencia de respuesta real. Verifica el código de estado, la URL final, el tipo de contenido, el tamaño de la respuesta, las cookies, las redirecciones, la salida renderizada, la salida de captura de pantalla y si las páginas posteriores mantienen el estado esperado. Si la página devuelve el mismo resultado útil sin una sesión, no lleves la complejidad de la sesión a producción.
Para flujos de trabajo que necesitan estado, haz que el comportamiento de la sesión sea visible en los registros y perfiles de solicitud. Cuando un scraping falla más tarde, el equipo debe saber si la solicitud utilizó una sesión, qué formato de salida se solicitó, si se ejecutó el renderizado, si cambió el enrutamiento y si la respuesta fue realmente diferente.
¿Cómo puede el scraping de sesiones mantenerse asequible?
Las sesiones añaden valor cuando la continuidad mejora el resultado, pero no deben convertirse en el defecto para páginas únicas no relacionadas. El flujo de trabajo consciente de costos es simple: mantén las capturas sin estado sin estado, usa sesiones para clases de ruta que necesitan continuidad y agrega renderizado, enrutamiento premium, enrutamiento por país, capturas de pantalla o PDFs solo donde el objetivo demuestre que esos controles mejoran la respuesta.
El modelo de precios de ScraperFly apoya este camino gradual. Los equipos pueden comenzar gratis, probar objetivos públicos reales, usar créditos de pago por uso para proyectos desiguales y mover flujos de trabajo recurrentes persistentes a créditos mensuales solo después de que se entienda el perfil de la solicitud.
Revisa los precios después de probar rutas de sesión representativas, luego usa el API Builder para copiar un perfil de solicitud que tu código de producción pueda repetir.
¿Dónde debería comenzar un equipo?
Comienza con una URL pública y una solicitud normal sin estado. Si la respuesta es útil, mantén el flujo de trabajo ligero. Si las solicitudes posteriores pierden cookies, filtros, consentimiento, paginación o estado regional, prueba una sesión con la secuencia relacionada más pequeña que demuestre la diferencia. Luego elige el formato de salida que tu producto pueda usar: HTML para analizadores, texto o Markdown para contenido legible, metadatos JSON para diagnósticos y capturas de pantalla o PDFs para prueba visual.
Ese enfoque mantiene la decisión de sesión práctica. El equipo obtiene la continuidad que necesita sin convertir cada scraping en un trabajo persistente más pesado, y los fracasos se vuelven más fáciles de explicar a partir de la evidencia en lugar de suposiciones.












