






Markup listo para el parser
Captura HTML confiable antes de que las reglas de extracción dependan de ello
Un parser HTML es tan confiable como la fuente de la página que recibe. Si la solicitud devuelve una estructura delgada, una redirección, un fallback bloqueado, o un markup que aparece solo después de que JavaScript se ejecute, los selectores y las reglas de extracción pueden fallar incluso cuando el parser en sí es correcto.
ScraperFly ofrece a los equipos un punto de partida más limpio: obtiene páginas públicas como HTML en bruto cuando el markup ya está presente, cambia a HTML renderizado cuando el DOM útil es construido por el navegador, y preserva la evidencia de respuesta para que las decisiones de parsing se basen en el estado real de la página.
¿Qué es una API de parser HTML para web scraping?
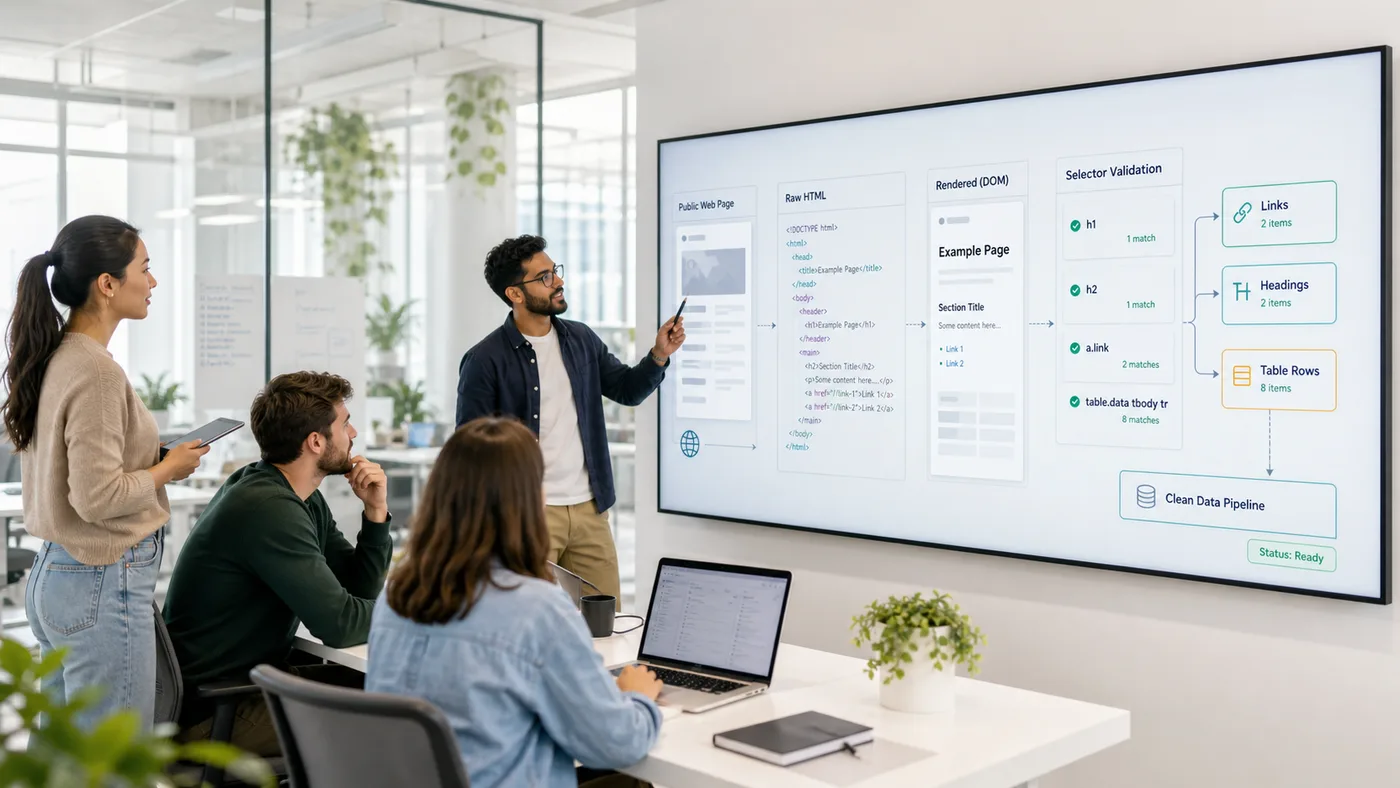
Un flujo de trabajo de API de parser HTML comienza recuperando una página pública y proporcionando a tu aplicación un markup que puede inspeccionar. El parser luego extrae enlaces, encabezados, tablas, metadatos, tarjetas de productos, secciones de artículos, paginación, datos incrustados u otros elementos de la página de esa fuente capturada.
El desafío práctico no es solo el parsing. Es capturar la versión correcta de la página antes de que comience el parsing. Algunos objetivos exponen un markup útil en la respuesta HTML inicial. Otros envían una estructura de aplicación vacía y construyen el DOM en el navegador. Algunos devuelven una página diferente dependiendo de encabezados, cookies, región o enrutamiento. ScraperFly maneja esa capa de captura para que tu parser pueda trabajar a partir de una respuesta verificada en lugar de un pegamento frágil del navegador.
¿Cuándo debe el parser usar HTML en bruto o HTML renderizado?
HTML en bruto es el mejor punto de partida cuando el objetivo envía un markup útil de inmediato. Es más ligero, más rápido de inspeccionar y más fácil de comparar entre muestras. HTML renderizado es útil cuando la fuente inicial solo contiene un contenedor de ruta, un script de hidratación, nodos de marcador de posición o contenido cargado tarde que aparece después de la ejecución del navegador.
La decisión debe ser por objetivo, no global. Si cada URL se fuerza a través de un navegador por defecto, el flujo de trabajo se vuelve más pesado antes de que el equipo sepa si el renderizado mejora la fuente capturada. Un mejor patrón es obtener primero el HTML fuente, compararlo con los campos esperados, y luego habilitar el renderizado solo para páginas donde el parser no puede ver el markup necesario.
| Entrada del parser | Úsalo cuando | Principal ventaja | Chequeo importante |
|---|---|---|---|
| HTML en bruto | La respuesta inicial contiene los enlaces, campos, tablas o bloques de contenido. | Ligero y fácil de depurar. | Confirma que el markup está presente antes de escribir selectores. |
| HTML renderizado | JavaScript construye el DOM útil después de que se carga la respuesta de la fuente. | Captura el estado de la página construida por el navegador. | Usa el renderizado solo cuando cambie la respuesta. |
| Texto o Markdown | El flujo de trabajo posterior necesita contenido legible en lugar de relaciones DOM. | Entrada más limpia para revisión de contenido, búsqueda y flujos de trabajo de IA. | No lo uses cuando los selectores o atributos importen. |
| Metadatos JSON | La aplicación necesita contexto de respuesta para registro, QA o decisiones de enrutamiento. | Expone evidencia operativa alrededor de la captura. | Complementa el parsing; no reemplaza las reglas de extracción específicas del objetivo. |
¿Qué deben validar los equipos antes de escalar las reglas del parser?
Las reglas del parser a menudo parecen estables en una muestra y luego fallan en un conjunto de URL. La solución es validar la forma de la respuesta antes de escalar: asegúrate de que las mismas secciones existan, que los enlaces esperados estén presentes, que las tablas mantengan una estructura predecible, que la paginación sea visible y que la respuesta no se haya redirigido silenciosamente a un tipo de página diferente.
ScraperFly ayuda manteniendo visibles los controles de solicitud. Puedes comparar la salida en bruto y renderizada, preservar la URL final y el estado, inspeccionar el tamaño de la respuesta y usar capturas de pantalla cuando la prueba visual importa. Eso hace que las fallas de selectores sean más fáciles de diagnosticar: el parser puede decir si el objetivo cambió, si el markup se movió, si se requirió JavaScript o si la captura devolvió la página equivocada.
| Punto de validación | Por qué importa | Acción segura para el parser |
|---|---|---|
| Contenedor esperado | El parser necesita una sección estable para comenzar. | Verifica si el HTML en bruto o renderizado contiene el contenedor. |
| Enlaces y paginación | Muchos rastreos fallan cuando faltan o se transforman los enlaces de la siguiente página. | Verifica hrefs y controles de página entre muestras. |
| Tablas y listas | Los datos pueden cambiar columnas, etiquetas o anidamientos entre plantillas. | Compara la estructura antes de mapear campos. |
| Estado y URL final | Un parser puede recibir un muro de inicio de sesión, una página de redirección o un bloqueo suave. | Registra la evidencia de respuesta con cada resultado parseado. |
| Formato de respuesta | El parsing DOM, la ingestión de texto y el QA visual necesitan diferentes salidas. | Elige HTML, texto, Markdown, JSON, captura de pantalla o PDF según el consumidor. |
¿Dónde encaja ScraperFly en un pipeline de parsing HTML?
ScraperFly se sitúa antes de tu parser. Tu aplicación envía una URL objetivo y un perfil de solicitud, luego recibe una forma de respuesta que tu pipeline puede usar: HTML en bruto para parsing de origen, HTML renderizado para páginas construidas por el navegador, texto limpio o Markdown para flujos de trabajo de contenido, metadatos JSON para diagnósticos, o capturas de pantalla y PDFs para evidencia visual.
Esta separación es valiosa. Tu equipo mantiene el control sobre selectores, reglas de extracción, validación, almacenamiento y lógica de negocio. ScraperFly maneja la capa de obtención, el renderizado del navegador cuando realmente se necesita, el contexto de sesión y encabezados, opciones de enrutamiento y formatos de respuesta. El resultado es un límite más limpio entre "obtener la fuente de página correcta" y "extraer los datos que nos importan".
Para una visión más amplia de los formatos de salida soportados, compara los formatos de respuesta de la API de web scraping. Para probar un perfil de solicitud antes de escribir código de producción, usa el API Builder público.
¿Cómo pueden los equipos mantener el parsing HTML estable en producción?
El parsing en producción necesita evidencia, no solo selectores. Almacena la URL objetivo, la URL final, el estado, el tipo de contenido, el tamaño de la respuesta, la configuración de renderizado, los controles de tiempo y el formato de salida elegido con cada captura. Esos campos facilitan mucho separar los errores del parser de los cambios en el objetivo, problemas de entrega y brechas de renderizado de JavaScript.
Cuando el parser comienza a perder campos, evita reescribir la lógica de extracción de inmediato. Primero inspecciona si el markup capturado aún contiene la fuente esperada. Si lo hace, actualiza el parser. Si no lo hace, ajusta el perfil de solicitud: renderiza la página, espera contenido tardío, preserva el estado de la sesión, añade encabezados legítimos, elige enrutamiento por país o usa una entrega más fuerte para objetivos que demuestran que la necesitan.
¿Cómo hace esto que el scraping sea más barato de operar?
El parsing HTML se vuelve costoso cuando los equipos utilizan el perfil de solicitud más pesado para cada página. ScraperFly apoya un camino más práctico: comienza con captura de HTML ligero, inspecciona si el markup contiene datos útiles, luego añade renderizado del navegador, esperas, sesiones, encabezados, targeting por país, enrutamiento premium, capturas de pantalla o PDFs solo cuando el objetivo demuestra que esos controles mejoran el resultado.
Esto es especialmente útil para proyectos con objetivos mixtos. Las páginas públicas simples pueden permanecer en capturas simples. Las páginas pesadas en JavaScript pueden usar HTML renderizado. Las páginas que necesitan prueba pueden añadir salida de captura de pantalla o PDF. Los proyectos desiguales pueden usar créditos de pago por uso, mientras que las cargas de trabajo de producción predecibles pueden pasar a créditos mensuales cuando el patrón esté claro. La página de precios explica ese camino en detalle.







