






Flujo de trabajo de backend
Mantén a Node.js enfocado en la orquestación mientras ScraperFly maneja la captura
Node.js es un lugar natural para trabajos de backend, colas, rutas de API, agentes, paneles de control y flujos de trabajo impulsados por eventos. No debería tener que convertirse en una plataforma de navegador personalizada antes de que tu equipo sepa si la respuesta de la página pública es utilizable.
ScraperFly proporciona a los servicios de Node.js una capa de captura limpia: obtiene una URL pública, elige salida en HTML, texto, Markdown, metadatos JSON, captura de pantalla o PDF, y añade renderizado, sesiones, encabezados, enrutamiento por país, esperas, o entrega más fuerte solo cuando el objetivo demuestra que esos controles mejoran el resultado.
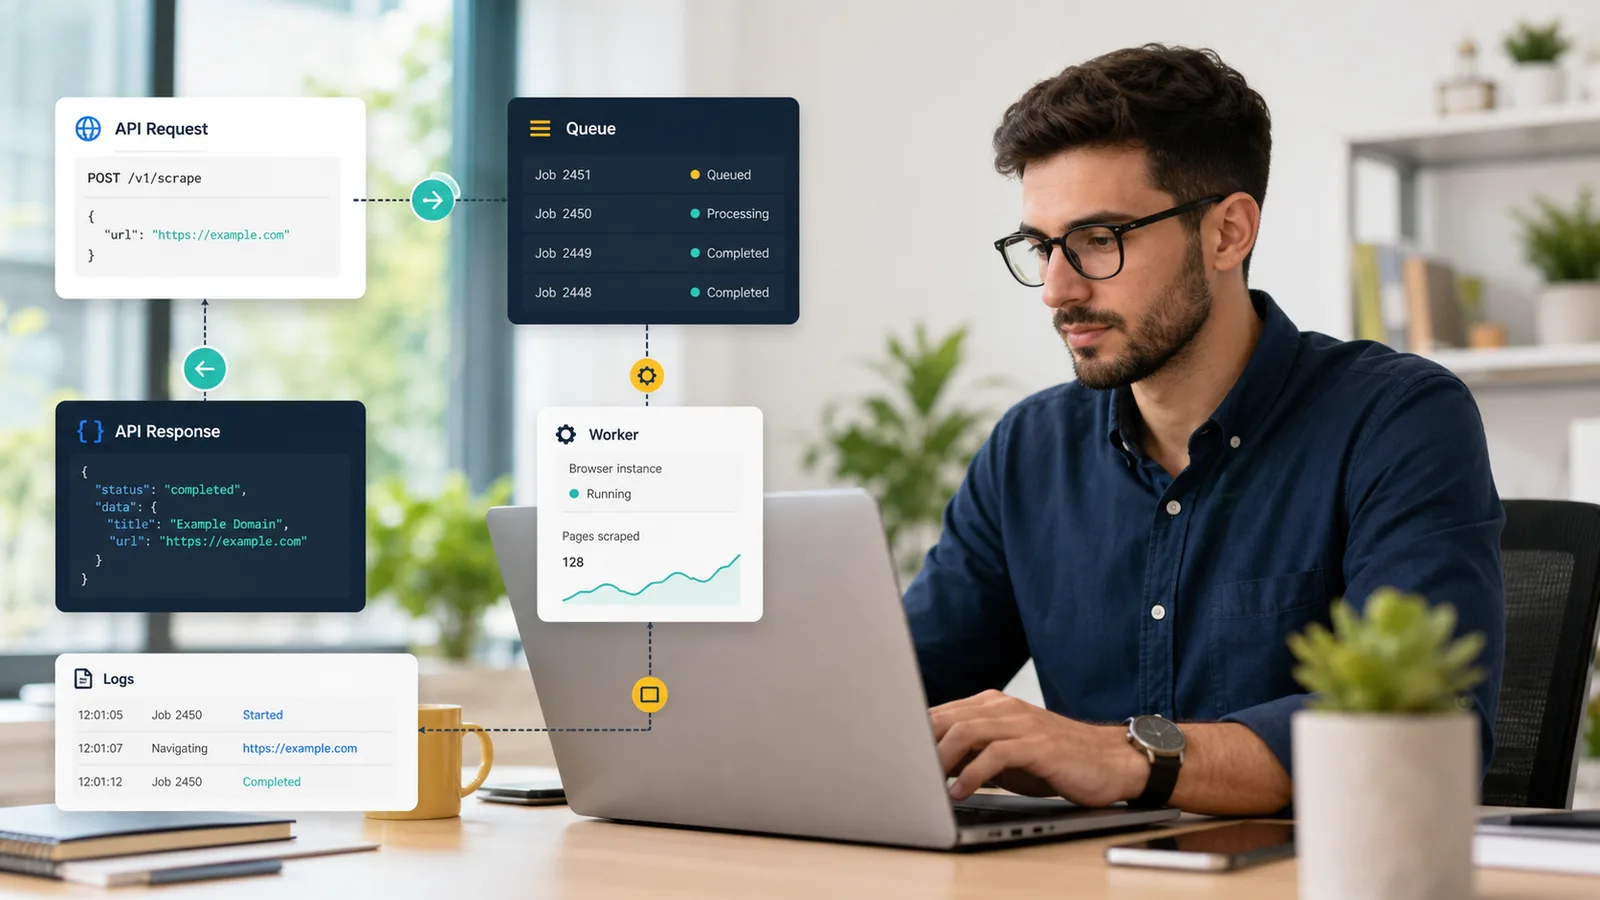
¿Cómo funciona una API de web scraping en Node.js?
Un flujo de trabajo de API de web scraping en Node.js envía una URL de destino pública y opciones de solicitud desde un servicio de backend a una capa de captura alojada. La API recupera la página, aplica controles de renderizado o enrutamiento cuando es necesario, y devuelve una respuesta que tu aplicación Node.js puede procesar. Tu código sigue siendo responsable de la análisis, validación, comportamiento de la cola, almacenamiento, alertas y lógica del producto.
Ese límite mantiene el backend más fácil de mantener. En lugar de mezclar automatización de navegador, manejo de proxies, reintentos, conversión de respuestas y extracción de campos en un solo servicio, la aplicación de Node.js puede llamar a una superficie de solicitud y mantener el resto de la tubería explícita. Un trabajador puede capturar una página, inspeccionar el estado y los metadatos, analizar los campos que necesita y enviar el resultado a una base de datos o sistema posterior.
Conclusión práctica: usa ScraperFly para una captura confiable de páginas públicas, y deja que Node.js se encargue del flujo de trabajo específico de la aplicación alrededor de la respuesta.
¿Qué debería probar la primera solicitud de scraping en Node.js?
La primera solicitud debería probar la página de destino y el formato de respuesta antes de que el código se vuelva reutilizable. Envía una URL representativa, mantén el perfil de solicitud ligero e inspecciona el resultado. Verifica la URL final, el estado, el tipo de contenido, el tamaño de la respuesta, el cuerpo y si los campos que tu analizador necesita están presentes. Si el HTML fuente ya contiene el contenido útil, el backend puede permanecer simple. Si la página es un shell de aplicación o falta campos importantes, compara la salida renderizada antes de convertir cada trabajo en una solicitud de navegador.
Esto es importante porque los equipos de Node.js a menudo se mueven rápidamente de una prueba exitosa a una cola o trabajador. Si la primera solicitud está sobrecargada con renderizado, enrutamiento premium, largas esperas o salida visual, ese perfil costoso puede convertirse en el predeterminado antes de que alguien sepa qué opción realmente importaba. Un mejor flujo de trabajo prueba un tipo de página a la vez y mantiene cada control vinculado a evidencia.
| Verificación de backend | Lo que prueba | Lo que debería hacer el trabajo de Node.js a continuación |
|---|---|---|
| Respuesta fuente | Si el HTML crudo contiene los campos útiles | Mantén el trabajo ligero cuando la captura de fuente es suficiente. |
| Respuesta renderizada | Si JavaScript cambia el contenido | Habilita el renderizado solo para plantillas que necesitan ejecución en navegador. |
| Metadatos de respuesta | Estado, URL final, tipo de contenido, tamaño y evidencia de solicitud | Almacénalo con los registros de trabajo antes de analizar o reintentar. |
| Formato de salida | Si el consumidor posterior necesita marcado, contenido legible, metadatos o prueba visual | Elige la forma de respuesta antes de construir convertidores. |
| Tipo de fallo | Si el problema es de entrada, autenticación, comportamiento del objetivo, límite de tasa, red o renderizado | Corrige la configuración, reintenta con retroceso o escala deliberadamente. |
¿Qué formato de respuesta debería solicitar Node.js?
El mejor formato es aquel que tu backend puede usar sin limpieza adicional. HTML es útil cuando el analizador necesita estructura DOM, enlaces, atributos, tablas o metadatos incrustados. HTML renderizado es útil cuando la ejecución en navegador crea el DOM final. Texto y Markdown son mejores cuando el flujo de trabajo necesita contenido legible para búsqueda, resúmenes, contexto de agente, ingestión RAG o revisión de contenido. Los metadatos JSON son útiles para registros y decisiones operativas. Capturas de pantalla y PDFs son mejores para QA, aprobaciones, monitoreo, archivos o prueba visual.
No elijas HTML en todas partes solo porque es familiar. Un servicio de Node.js que alimenta un LLM puede beneficiarse de Markdown. Un trabajador de monitoreo puede necesitar metadatos más una captura de pantalla. Un analizador puede necesitar HTML crudo para selectores. Un archivo de cumplimiento puede necesitar salida en PDF. Prueba la forma de respuesta temprano para que el servicio no crezca una capa de convertidor que la API pueda evitar.
Para la decisión de formato más profunda, utiliza la guía de formatos de respuesta de la API de web scraping antes de codificar tu modelo de backend.
| Consumidor de Node.js | Formato a probar | Por qué encaja | Cuidado con |
|---|---|---|---|
| Servicio de analizador | HTML o HTML renderizado | Preserva selectores, enlaces, atributos y relaciones DOM | Requiere extracción y validación específicas del objetivo. |
| Trabajador de búsqueda o IA | Texto o Markdown | Contenido legible más limpio con menos ruido de diseño | Puede no preservar suficiente estructura para extracción precisa de campos. |
| Monitoreo de colas | Metadatos JSON | Hace visible el estado, URL final, tamaño de respuesta y tipo de contenido | No reemplaza el análisis de los datos del objetivo en sí. |
| QA o aprobaciones | Captura de pantalla | Muestra cómo se veía la página pública renderizada | Más pesado que la salida legible por máquina. |
| Archivo o registro de revisión | Crea un documento visual portátil | Menos conveniente para análisis automatizado. |
¿Cuándo debería un servicio de Node.js habilitar renderizado, sesiones, encabezados o enrutamiento?
Habilita controles cuando la evidencia del objetivo muestre una necesidad real. Usa renderizado de JavaScript cuando el HTML fuente esté incompleto y el contenido útil aparezca después de la ejecución en navegador. Usa encabezados cuando un objetivo público espere un contexto de solicitud legítimo como idioma, tipo de contenido aceptado o comportamiento de referer. Usa sesiones cuando solicitudes relacionadas dependan de cookies o estado compartido. Usa enrutamiento por país cuando el contenido público cambie por región, moneda, idioma, disponibilidad o comportamiento de redirección. Usa enrutamiento más fuerte cuando muestras repetidas muestren que el camino simple no puede recuperar una respuesta utilizable.
Estas opciones no deberían vivir como valores predeterminados silenciosos en un helper compartido. Una cola de backend puede procesar muchos tipos de páginas, y no todas merecen el mismo perfil de solicitud. Mantén los perfiles explícitos: páginas estáticas, páginas pesadas en JavaScript, páginas regionales, flujos con estado y trabajos de prueba visual deberían ser lo suficientemente separados como para que el costo y los fallos sigan siendo comprensibles.
Para páginas construidas en navegador, revisa la API de renderizado de JavaScript. Para estado compartido, usa la API de sesiones. Para contexto de solicitud, consulta encabezados personalizados. Para decisiones sobre el camino de entrega, compara la página de API de scraping de proxy rotativo.
¿Cómo deberían manejar los trabajadores de Node.js los fallos de scraping?
Los trabajadores de Node.js necesitan fallos que se puedan actuar. Una URL mal formada, clave inválida, formato no soportado o opción de archivo incompatible deberían detener el trabajo y señalar a la configuración. Un tiempo de espera, límite de tasa, 5xx ascendente, problema de conexión, sorpresa de redirección, shell HTML delgado o tiempo de espera de renderizado deberían registrarse con el perfil de solicitud y manejarse con un reintento limitado o una prueba de captura diferente. Trata cada fallo como evidencia, no solo como una cadena de excepción.
Esto es especialmente importante en colas. Un solo perfil malo puede multiplicarse a través de cientos de trabajos si la lógica de reintento es demasiado amplia. Almacena metadatos de respuesta junto a cada resultado de trabajo: estado, URL final, tipo de contenido, tamaño de respuesta, formato de salida, elección de renderizado, elección de enrutamiento, tiempo de espera y conteo de reintentos. Cuando los fallos se agrupan por tipo de objetivo, el equipo puede corregir el perfil en lugar de adivinar dentro del código de la aplicación.
La sección de manejo de errores reutilizables a continuación expande esos grupos, pero la regla de backend es simple: detén los errores de configuración, reintenta fallos temporales con cuidado y escala solo cuando muestras repetidas justifiquen la solicitud más pesada.
¿Cómo pueden las colas de scraping en Node.js mantenerse predecibles?
Las colas predecibles comienzan con la clasificación de páginas. Separa trabajos de HTML simples de páginas renderizadas, flujos dependientes de sesiones, objetivos regionales, casos de enrutamiento premium, capturas de pantalla y archivos PDF. Cada clase debería tener su propio perfil de solicitud, expectativa de concurrencia, comportamiento de reintento y registro. Eso evita que un pequeño scraping herede el costo del objetivo más pesado en el sistema.
El modelo de crédito de ScraperFly apoya ese estilo de trabajo porque los equipos pueden probar pequeños, mantener proyectos desiguales en créditos de pago por uso, y mover cargas de trabajo recurrentes a créditos mensuales cuando el volumen se vuelve claro. El paso importante es saber qué perfiles requieren tus objetivos reales antes de aumentar la concurrencia.
Usa precios después de muestrear URLs reales, no antes. La estimación correcta depende de si tus trabajos son principalmente HTML crudo, HTML renderizado, flujos basados en sesiones, rutas premium, archivos visuales o una mezcla.
¿Qué debería poseer Node.js después de la captura?
Node.js debería poseer el flujo de trabajo que es único para tu producto: colas, trabajadores, reintentos, módulos de analizador, reglas de validación, deduplicación, almacenamiento, webhooks, alertas, paneles de control e integraciones posteriores. ScraperFly debería poseer la capa de captura de páginas públicas: entrega de solicitudes, renderizado cuando sea necesario, sesiones, encabezados, enrutamiento, formatos de respuesta, capturas de pantalla, PDFs y evidencia de respuesta.
Este límite le da al backend un contrato estable. Si el análisis falla, inspecciona la respuesta capturada y actualiza los selectores. Si la captura falla, ajusta el perfil de solicitud. Si la cola crece, ajusta la concurrencia y las clases de trabajo sin reescribir la infraestructura del navegador. El servicio se mantiene aburrido en el mejor sentido: entradas claras, salidas claras y menos partes móviles ocultas.
¿Dónde debería comenzar un equipo de Node.js?
Comienza con un objetivo público real en el API Builder o cURL, luego mueve la solicitud probada a Node.js. Prueba HTML crudo primero, compara la salida renderizada cuando falte contenido, elige el formato de respuesta que tu backend pueda usar y registra suficientes metadatos para explicar fallos futuros.
Después de que el primer tipo de página funcione, añade lotes deliberadamente. Mantén los perfiles de solicitud visibles en el código, evita un helper global "scraping pesado", y deja que la cola escale alrededor de la evidencia de respuestas reales.












