






Enrutamiento de proxy
Elige una entrega más fuerte solo cuando el objetivo demuestra que importa
La rotación de proxy es valiosa cuando los objetivos públicos responden de manera diferente según la ruta, reputación, región, continuidad de sesión o presión de solicitud. También es fácil de sobreutilizar. Si cada scraping comienza con la ruta más pesada, los equipos pagan más antes de saber si el objetivo realmente necesitaba ese camino.
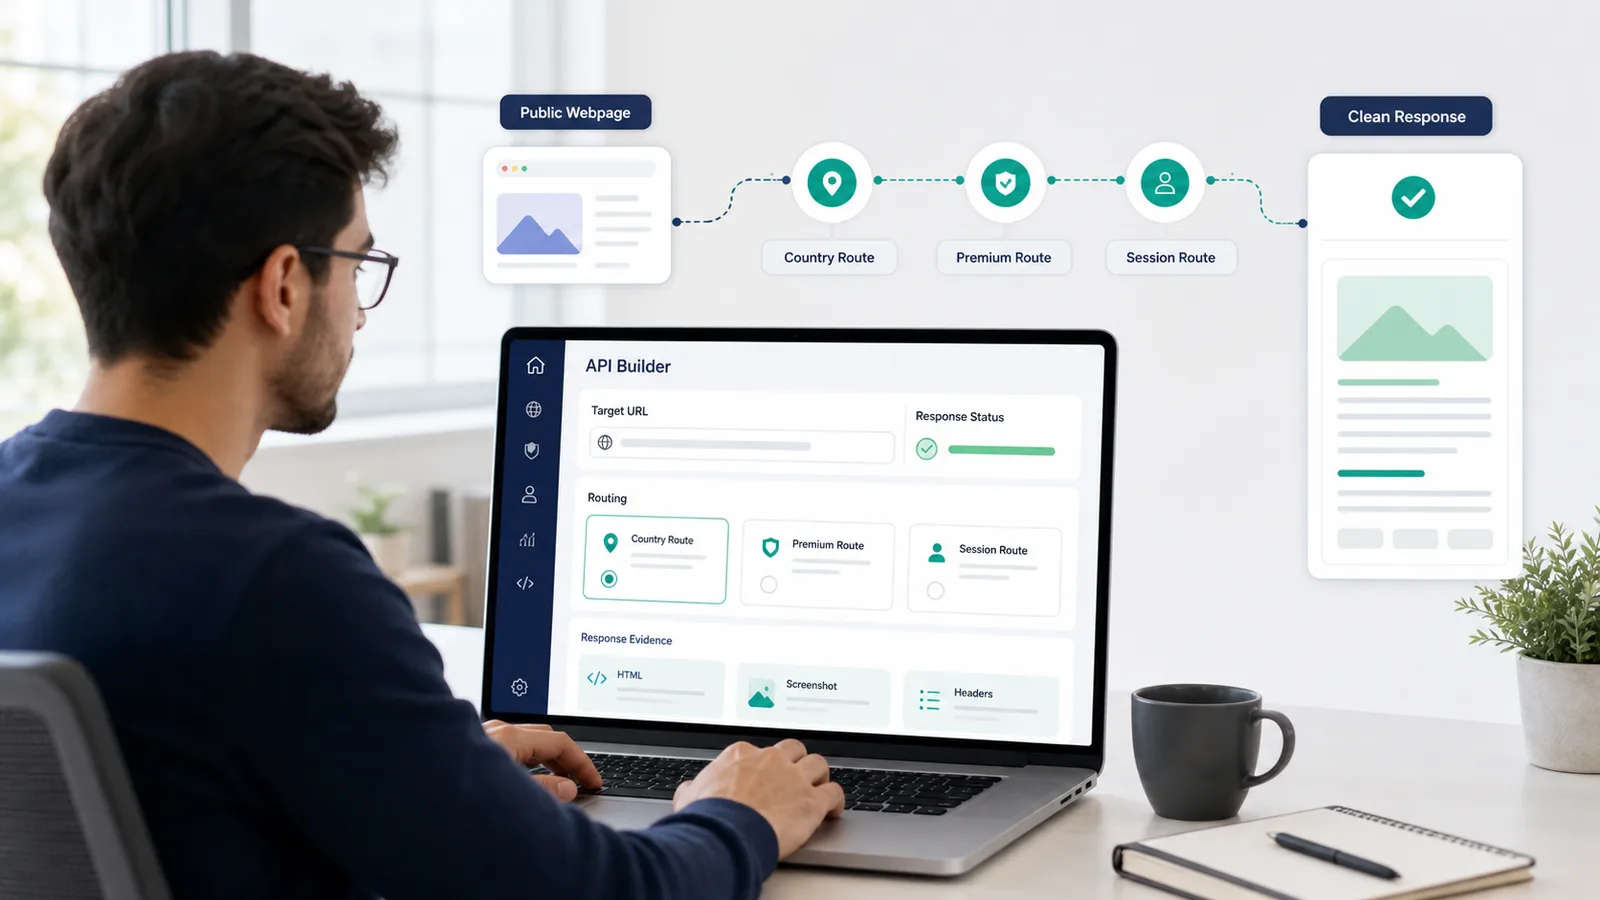
ScraperFly ofrece a los equipos un flujo de trabajo de enrutamiento práctico: comienza con una solicitud ligera, inspecciona la evidencia de respuesta, luego agrega enrutamiento premium, segmentación por país, sesiones, encabezados, renderizado, esperas, capturas de pantalla o PDFs solo donde mejoren el resultado. El objetivo no es más movimiento de proxy. El objetivo es una captura de página pública más limpia con menos reintentos ciegos y un costo más predecible.
¿Qué es una API de scraping con proxy rotativo?
Una API de scraping con proxy rotativo recupera páginas web públicas a través de una capa de solicitud gestionada que puede cambiar las rutas de entrega cuando la respuesta del objetivo lo requiere. En lugar de conectar un grupo de proxies en bruto a cada scraper, la aplicación envía una URL de destino y opciones de solicitud a una API. La API devuelve la respuesta en un formato utilizable, mientras que los metadatos de respuesta ayudan al equipo a entender qué sucedió.
Para ScraperFly, el enrutamiento de proxy es una parte de un flujo de trabajo de captura más amplio. Una solicitud puede permanecer simple para páginas públicas que devuelven HTML limpio. Puede agregar enrutamiento premium para objetivos más difíciles, segmentación por país cuando el contexto regional importa, sesiones cuando la continuidad cambia la respuesta, y renderizado cuando JavaScript construye el estado útil de la página.
Conclusión práctica: utiliza el comportamiento de proxy rotativo como un control de enrutamiento medido, no como un reemplazo predeterminado para entender el objetivo.
¿Cuándo necesitan realmente rotación de proxy los trabajos de scraping?
La rotación de proxy ayuda cuando el camino de entrega cambia la respuesta pública. Eso puede suceder cuando un objetivo limita solicitudes repetidas, devuelve contenido diferente por región, se comporta de manera diferente bajo una sesión estable, o responde mejor a través de una ruta más fuerte. La rotación también puede ayudar a distribuir la presión de solicitud a lo largo de un flujo de trabajo cuando el objetivo es sensible al acceso repetido desde una ruta.
Pero la rotación de proxy no soluciona todos los problemas de scraping. Una URL mal formada, clave de API faltante, formato de salida no soportado, shell de JavaScript vacío, espera de renderizado demasiado corta, respuesta sobredimensionada, bucle de redirección o error de analizador no se convertirán en un buen scraping solo porque la solicitud se mueva a través de otra ruta. Esos problemas necesitan diagnóstico, no más rotación.
| Evidencia de respuesta | Significado probable | Mejor siguiente acción |
|---|---|---|
| Respuesta 200 limpia con HTML útil | El camino ligero ya es suficiente | Mantén el perfil de solicitud simple. |
| Página 403 repetida o de desafío | El objetivo puede resistir la ruta actual | Prueba enrutamiento más fuerte después de confirmar que la solicitud es válida. |
| Patrón 429 o de limitación | La presión de solicitud puede ser demasiado alta | Usa retroceso, reduce la concurrencia, luego considera cambios de ruta. |
| Contenido diferente por país | La página pública varía por región | Usa segmentación por país para muestras regionales. |
| Shell vacío pero la página renderizada tiene contenido | JavaScript construye el estado útil | Usa renderizado antes de culpar a la ruta del proxy. |
| Redirecciones a páginas inesperadas | Las reglas del objetivo, localización, consentimiento o estado de ruta pueden diferir | Compara URL final, encabezados, cookies, país y comportamiento de sesión. |
¿Cómo se diferencia el enrutamiento de proxy del enrutamiento premium?
El enrutamiento de proxy es la idea de entrega amplia: la solicitud puede moverse a través de caminos de red gestionados en lugar de depender de una ruta directa. El enrutamiento premium es una opción de escalada más fuerte para objetivos públicos que no responden bien al camino simple. La segmentación por país es un control de entrega regional. Las sesiones mantienen la continuidad a través de solicitudes relacionadas. Los encabezados y cookies llevan el contexto de solicitud legítimo. El renderizado ejecuta JavaScript del navegador.
Estos controles a menudo trabajan juntos, pero resuelven problemas diferentes. El enrutamiento premium no es lo mismo que la segmentación por país. Una sesión no es lo mismo que la rotación. El renderizado no es una solución de proxy. Una buena arquitectura de scraping mantiene esas elecciones visibles para que un equipo pueda explicar por qué existe un perfil de solicitud.
| Control | Úsalo cuando | No lo uses como |
|---|---|---|
| Solicitud simple | El objetivo devuelve contenido útil sin entrega más fuerte | Una señal de que el flujo de trabajo está incompleto. |
| Enrutamiento premium | La entrega simple falla repetidamente después de que se valida la solicitud | El primer paso para cada página pública. |
| Segmentación por país | La respuesta cambia por región, idioma, moneda o disponibilidad | Un interruptor genérico anti-bloqueo. |
| Sesiones | Las solicitudes relacionadas dependen de un estado compartido o continuidad | Un reemplazo para la evidencia de enrutamiento. |
| Encabezados y cookies | La respuesta pública depende del contexto de solicitud aceptado | Una forma de prometer acceso privado. |
| Renderizado de JavaScript | El contenido útil aparece después de la ejecución del navegador | Una estrategia de proxy. |
¿Qué evidencia de respuesta debería guiar el enrutamiento de proxy?
Las mejores decisiones de enrutamiento provienen de la evidencia de respuesta, no de suposiciones. El código de estado, URL final, tamaño de respuesta, tipo de contenido, cuerpo de respuesta, ruta de redirección, comportamiento de tiempo de espera, país de ruta, estado de sesión y salida de captura de pantalla pueden mostrar si el objetivo necesita una entrega más fuerte o un perfil de solicitud diferente.
Una sola solicitud fallida rara vez prueba mucho. Una pequeña muestra a través de tipos de ruta es más útil: una solicitud ligera, una solicitud con los encabezados necesarios, una solicitud renderizada si la página es pesada en JavaScript, una solicitud segmentada por país si la región importa, y una ruta premium solo si las pruebas más simples no devuelven una respuesta utilizable. Esa secuencia mantiene el diagnóstico claro.
Usa el API Builder para probar la forma de la solicitud antes de moverla a producción. Si la página necesita ejecución del navegador, compara el resultado con la ruta del API de renderizado de JavaScript antes de tratar el problema como puramente relacionado con el proxy.
¿Cómo reduce ScraperFly el trabajo de infraestructura de proxy?
Una configuración de proxy en bruto puede dar a un equipo acceso a la red, pero generalmente no resuelve el resto del flujo de trabajo de scraping. El equipo aún tiene que mantener la construcción de solicitudes, formatos de salida, renderizado, reintentos, encabezados, cookies, capturas de pantalla, PDFs, registro, diagnósticos de respuesta, reglas de facturación y recuperación operativa. Eso es mucho pegamento alrededor de cada objetivo.
ScraperFly empaqueta la capa de captura como un flujo de trabajo de API. Los desarrolladores pueden solicitar HTML, texto limpio, Markdown, metadatos JSON, capturas de pantalla o PDFs; agregar renderizado cuando la página necesita ejecución del navegador; agregar sesiones o encabezados cuando la continuidad o el contexto de solicitud importan; y agregar fuerza de enrutamiento solo cuando la evidencia de respuesta lo respalde. El equipo puede centrarse en decidir qué datos importan en lugar de reconstruir la infraestructura de captura para cada trabajo.
¿Cómo puede el scraping con proxy mantenerse predecible en costos?
El control de costos comienza por igualar el peso de la solicitud al objetivo. Una página pública simple no debería tener el mismo perfil que una solicitud de navegador renderizada con enrutamiento premium, continuidad de sesión, salida visual y reintentos. El proceso correcto es clasificar los objetivos, mantener las páginas fáciles ligeras y reservar enrutamiento más fuerte para páginas que demuestren que lo necesitan.
El camino de facturación de ScraperFly apoya ese tipo de pruebas. Comienza con créditos gratuitos, compra créditos para proyectos desiguales y pasa a créditos mensuales cuando la demanda recurrente se vuelve predecible. El equipo puede estimar el costo a partir de muestras reales en lugar de comprar una configuración de proxy amplia antes de entender la carga de trabajo.
Revisa los precios después de muestrear objetivos representativos. Para flujos de trabajo con estado, compara con API de scraping web con sesiones. Para el contexto de solicitud, consulta encabezados personalizados para solicitudes de API de scraping. Para páginas regionales, utiliza segmentación por país; para objetivos más difíciles, utiliza enrutamiento premium solo donde la evidencia lo respalde.
¿Dónde debería comenzar un equipo?
Comienza con una URL de objetivo público real y el perfil de solicitud más ligero. Verifica el estado, la URL final, el tamaño de respuesta, el tipo de contenido y el cuerpo. Si la respuesta es útil, mantén ese perfil. Si la respuesta está bloqueada, vacía, es regional, inestable o incompleta, cambia un control a la vez y registra lo que mejoró el resultado.
Ese enfoque hace que el scraping con proxy rotativo sea más práctico. El equipo puede explicar por qué un objetivo utiliza una ruta simple, una ruta por país, una ruta premium, una sesión, renderizado o salida visual. También facilita la recuperación en producción porque la siguiente acción sigue la evidencia ya capturada por la solicitud.

















