






Prueba primero en terminal
Prueba la solicitud en cURL antes de que el flujo de trabajo se convierta en código
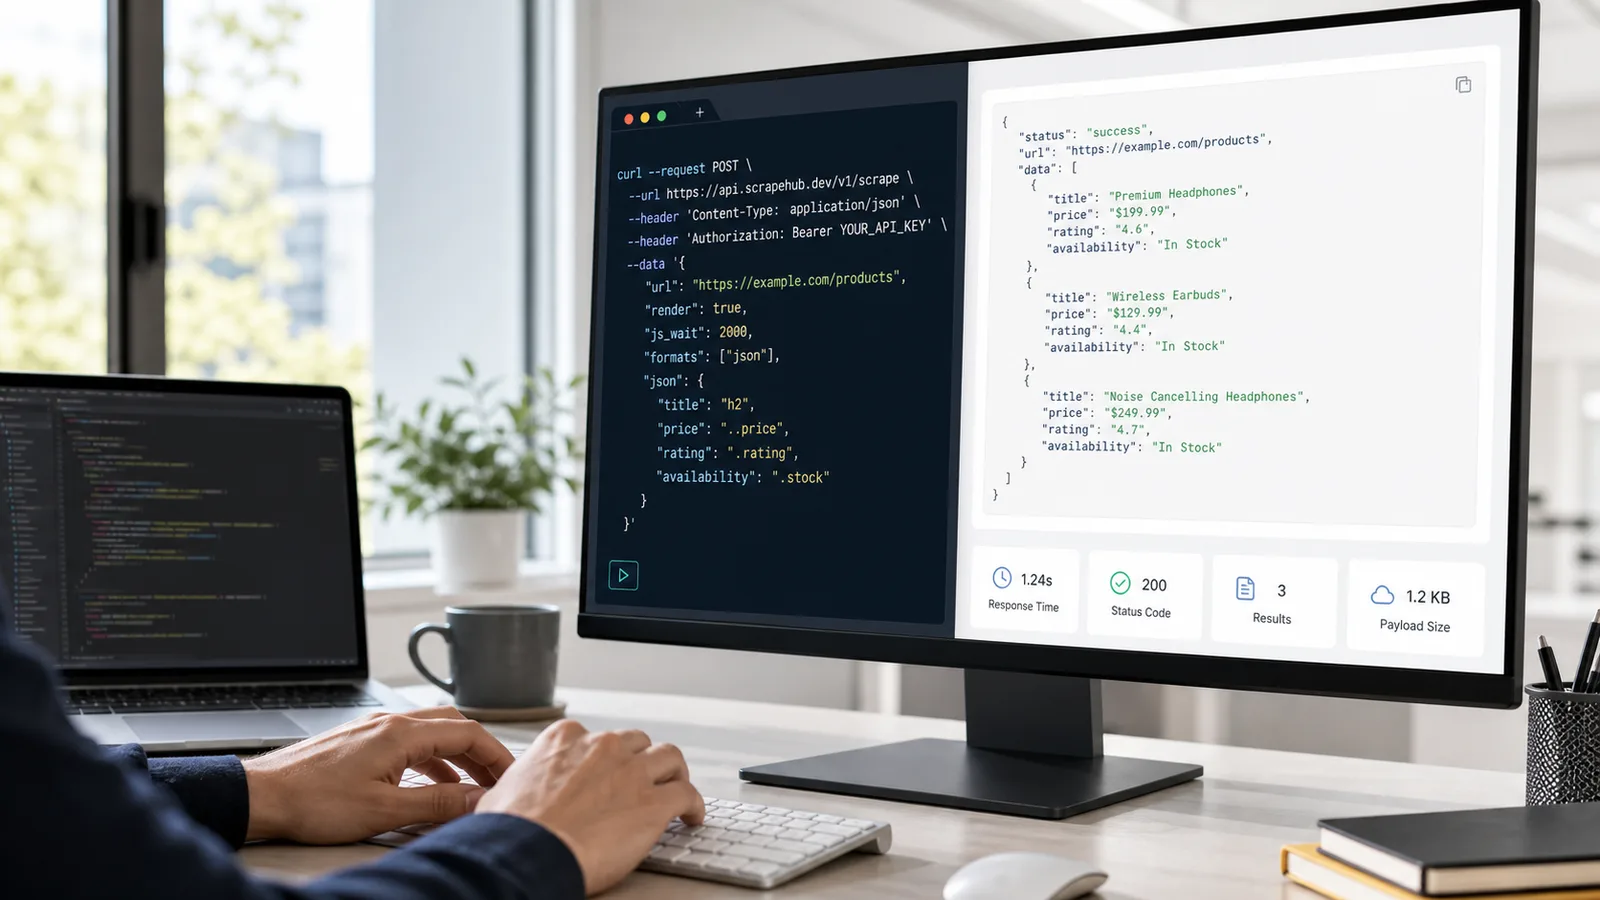
cURL es la forma más rápida de ver si una solicitud de scraping está bien formada. La URL objetivo, la clave API, el formato de salida, la elección de renderizado, los encabezados, las sesiones y los controles de enrutamiento permanecen visibles en un solo comando de terminal antes de que un trabajador de backend o un envoltorio de SDK oculte los detalles.
ScraperFly da a esa prueba de terminal un camino de producción. Comienza con una solicitud de URL pública limpia, inspecciona la respuesta, luego agrega renderizado en el navegador, enrutamiento más fuerte, segmentación por país, encabezados, sesiones, esperas, capturas de pantalla o PDFs solo cuando el objetivo demuestra que mejoran el resultado.
¿Cómo usas cURL con una API de web scraping?
Usa cURL para enviar una URL pública objetivo y opciones de respuesta a una API de web scraping alojada desde la terminal. Un buen flujo de trabajo de cURL prueba primero la respuesta de la página, luego agrega renderizado, enrutamiento, encabezados, sesiones o salida visual solo cuando la evidencia capturada muestra que esos controles son necesarios.
Eso hace que cURL sea útil antes de que exista cualquier código de integración. Un desarrollador puede probar una página, comparar formatos de respuesta, ver evidencia de estado y contenido, y entregar la forma exacta de la solicitud a un compañero de equipo, API Builder, Postman, Python, Node.js, un trabajador de cola o un trabajo de producción. El comando de terminal se convierte en un pequeño contrato: esta es la URL, este es el output, estos son los controles, y esta es la razón por la que están habilitados.
Conclusión práctica: comienza con cURL cuando necesites una solicitud de prueba transparente antes de convertir un flujo de trabajo de captura de páginas públicas en código de aplicación.
¿Por qué deberían comenzar las pruebas de scraping en la terminal?
El trabajo de scraping temprano falla con mayor frecuencia porque los equipos escriben código alrededor de un objetivo que no han inspeccionado completamente. Un script puede ocultar la codificación de URL, la autenticación, el formato de salida, el comportamiento de redirección, el tamaño de respuesta o la decisión de renderizado detrás de funciones auxiliares. Cuando la respuesta está vacía, bloqueada, es demasiado grande o falta el contenido esperado, el equipo tiene que depurar tanto el objetivo como su propia integración al mismo tiempo.
Una prueba primero en terminal mantiene esa primera decisión limpia. cURL muestra la forma de la solicitud en bruto. Puedes copiarla, ajustar un parámetro, comparar la siguiente respuesta y documentar la versión final sin tocar el código de la aplicación. Si la página es simple, el comando se mantiene simple. Si la página necesita renderizado en el navegador, sesiones, encabezados, enrutamiento por país o entrega más fuerte, esos controles se agregan con una razón que se puede ver en la respuesta.
Esto es especialmente útil cuando varias personas tocan el flujo de trabajo. Un ingeniero de datos puede probar la solicitud, un desarrollador de backend puede moverla a código, y un propietario de producto puede entender por qué se requiere un perfil más pesado para un objetivo pero no para otro.
| Prueba en terminal | Qué prueba | Por qué importa antes del código |
|---|---|---|
| Enviar una URL pública | El objetivo se puede alcanzar a través de la API | El equipo evita escribir lógica de integración alrededor de una URL mala o no representativa. |
| Elegir un formato de salida | La forma de respuesta se ajusta al consumidor posterior | Los parsers, pipelines de IA, flujos de QA y archivos necesitan diferentes salidas. |
| Comparar captura en bruto y renderizada | JavaScript cambia el contenido útil o no | El renderizado se convierte en una elección precisa, no en un gasto por defecto. |
| Agregar encabezados o sesiones deliberadamente | El contexto de la solicitud cambia la página pública devuelta | El flujo de trabajo mantiene controles con estado vinculados a la evidencia. |
| Inspeccionar errores en la terminal | El fallo está relacionado con la entrada, autenticación, formato, objetivo, límite, red o renderizado | Los reintentos y la escalación no se convierten en conjeturas. |
¿Qué debería probar la primera solicitud de scraping cURL?
La primera solicitud debería responder a una pregunta: ¿la captura de la página pública más simple proporciona evidencia utilizable para tu flujo de trabajo? Envía una URL objetivo real, elige un formato de salida y revisa el estado, la URL final, el tipo de contenido, el tamaño de respuesta y el cuerpo. Si el cuerpo contiene los campos que necesitas, el objetivo puede no necesitar un navegador, enrutamiento premium, largas esperas o archivos visuales. Si el cuerpo es una delgada cáscara, falta contenido clave, se redirige inesperadamente o es claramente diferente de la página visible, entonces tienes una razón para probar una opción más pesada.
No comiences habilitando cada control disponible. Eso hace que el primer resultado sea más difícil de interpretar. Si la solicitud tiene éxito, no sabes qué opción importaba. Si falla, no sabes qué opción creó el problema. Comienza con un perfil pequeño, cambia una cosa a la vez y mantén el comando final fácil de explicar.
Para un punto de partida más limpio, usa el API Builder para generar la solicitud canónica, luego copia el resultado en cURL, Postman o código de backend una vez que la respuesta esté probada.
¿Qué formato de respuesta debería intentar primero un flujo de trabajo cURL?
El formato de respuesta correcto depende del siguiente sistema, no del hábito. HTML es mejor cuando un parser necesita estructura DOM, selectores, atributos, enlaces, tablas o metadatos incrustados. Texto y Markdown son mejores cuando un flujo de contenido, índice de búsqueda, pipeline RAG o herramienta de revisión necesita contenido de página legible sin ruido de diseño. Los metadatos JSON ayudan con el registro y diagnóstico porque exponen evidencia operativa como estado, URL final, tipo de contenido y detalles de respuesta. Las capturas de pantalla y PDFs son útiles cuando los humanos necesitan prueba visual, revisión de QA, evidencia de cumplimiento o archivos de archivo.
cURL es bueno para esta elección porque hace que la prueba de formato sea rápida. Puedes enviar la misma URL pública, solicitar HTML, luego texto, luego Markdown, luego una salida visual si el flujo de trabajo lo necesita. El resultado es una decisión sobre lo que la aplicación puede usar de inmediato, no un montón de convertidores construidos antes de que el equipo sepa qué devuelve el objetivo.
| Salida a probar | Úsalo cuando | Decisión en terminal |
|---|---|---|
| HTML | Tu parser necesita estructura, enlaces, selectores o marcado incrustado | Úsalo como la primera prueba para captura de origen primero. |
| HTML renderizado | El DOM útil aparece solo después de la ejecución del navegador | Compara contra HTML en bruto antes de hacer del renderizado el valor por defecto. |
| Texto o Markdown | El flujo de trabajo necesita contenido legible para búsqueda, resúmenes o ingestión de IA | Elige el formato legible más limpio que tu herramienta posterior pueda usar. |
| Metadatos JSON | Necesitas contexto operativo para registro, depuración o clasificación de solicitudes | Úsalo para hacer visible la evidencia de respuesta en automatizaciones posteriores. |
| Captura de pantalla o PDF | El resultado debe ser revisado, archivado o probado visualmente | Reserva la salida visual para flujos de trabajo que necesitan evidencia legible por humanos. |
¿Cuándo debería una solicitud cURL agregar renderizado, encabezados, sesiones o enrutamiento?
Agrega controles cuando la respuesta te dé una razón específica. Habilita el renderizado de JavaScript cuando el HTML fuente carezca de contenido que aparece después de la ejecución del navegador. Agrega encabezados cuando un objetivo público espera un contexto de solicitud legítimo como idioma, tipo de contenido o comportamiento de referer. Usa sesiones cuando solicitudes relacionadas dependan de cookies compartidas o estado. Agrega enrutamiento por país cuando el contenido público cambie según la ubicación, idioma, moneda, disponibilidad o comportamiento de redirección regional. Considera un enrutamiento más fuerte cuando la evidencia repetida muestre que el camino simple no recupera una respuesta utilizable.
El objetivo no es mantener cada solicitud mínima para siempre. El objetivo es mantener cada actualización conectada al objetivo. cURL ayuda porque cada opción permanece visible. Si alguien pregunta por qué una solicitud usa renderizado o enrutamiento premium, la respuesta debería estar en el historial de muestras: HTML en bruto perdió el contenido, la página regional cambió, la sesión llevó el estado necesario, o el objetivo falló repetidamente a través del camino más ligero.
Para páginas que dependen en gran medida de la ejecución del navegador, compara el API de renderizado de JavaScript. Para flujos de solicitudes con estado, usa la página de API de sesiones. Para contexto de solicitud, revisa encabezados personalizados.
¿Cómo deberían los desarrolladores pasar de cURL a código de producción?
Mueve solo la forma de solicitud probada a código. La aplicación no debería heredar cada opción experimental que se probó en la terminal. Mantén el perfil de solicitud final pequeño, nombra por qué existe cada control y registra la evidencia de respuesta que importa para el flujo de trabajo. Eso hace que los fallos futuros sean más fáciles de diagnosticar porque el equipo puede comparar el comportamiento de producción con la prueba original de terminal.
Las integraciones de Python y Node.js deberían encargarse de la programación, colas, parsing, almacenamiento, alertas, política de reintentos y lógica de negocio. ScraperFly debería encargarse de la capa de captura de páginas públicas: entrega de solicitudes, renderizado cuando sea necesario, formatos de salida, controles de enrutamiento y evidencia de respuesta. cURL se sitúa entre esos mundos. Prueba la solicitud de API antes de que la integración la convierta en código reutilizable.
Cuando la solicitud sea estable, entrégala al camino de implementación correcto: Python para scripts, notebooks, trabajos de datos y flujos de análisis; Node.js para servicios de backend, colas, agentes y aplicaciones web.
¿Qué errores hacen que las pruebas de scraping cURL sean engañosas?
El mayor error es probar una URL fácil y asumir que todo el conjunto de objetivos se comporta de la misma manera. Un flujo de trabajo de producción debería muestrear los tipos de página reales: páginas estáticas, páginas con mucho JavaScript, páginas regionales, páginas con redirecciones, páginas que pueden requerir estado y páginas donde la prueba visual importa. Otro error es usar cURL como un plan de rastreo completo. cURL prueba una solicitud. No reemplaza la programación, la lógica de descubrimiento, el diseño de parsers, el almacenamiento, la monitorización o la disciplina de reintentos.
También es fácil dejar controles solo para pruebas en el perfil final. Largas esperas, renderizado, enrutamiento más fuerte, capturas de pantalla y PDFs pueden ser útiles, pero no deberían permanecer habilitados solo porque se probaron una vez. Mantén el comando legible. Mantén la salida vinculada al consumidor posterior. Mantén el costo de la solicitud alineado con lo que realmente necesita el objetivo.
Conclusión práctica: una buena prueba de cURL no es la solicitud más poderosa que puedes construir; es la solicitud más clara que prueba lo que la producción debería enviar.
¿Dónde debería comenzar un equipo?
Comienza con una URL pública real en el API Builder, genera el comando cURL y ejecútalo desde la terminal. Inspecciona la respuesta antes de escribir envoltorios o trabajadores. Si el contenido está presente, mantén la solicitud ligera. Si falta, agrega un control a la vez y compara el resultado. Una vez que el comando esté probado, mueve la misma forma de solicitud a la implementación que posee el resto del flujo de trabajo.
Para decisiones de salida, usa la guía de formatos de respuesta. Para planificación de costos, revisa precios después de saber qué perfiles de solicitud requieren tus objetivos reales.












