






Los formatos de respuesta de la API de web scraping son las formas de salida devueltas después de capturar una página pública, incluyendo HTML, texto, Markdown, metadatos JSON, capturas de pantalla y PDFs. El formato correcto depende de la tarea posterior: análisis de marcado, alimentación de una tubería de IA, revisión de contenido, monitoreo de cambios, archivo de evidencia o preservación de un registro visual.
Elegir la forma de respuesta temprano previene limpieza innecesaria. También ayuda a los equipos a evitar construir convertidores, herramientas de captura de navegador y lógica de procesamiento antes de saber lo que realmente necesita el producto.
ScraperFly permite a los desarrolladores probar varios formatos de salida contra la misma URL pública objetivo. Esto convierte la selección de formato en una decisión de ingeniería basada en respuestas reales en lugar de suposiciones.
¿Cuáles son los formatos de respuesta de la API de web scraping?
Un formato de respuesta de API de web scraping define cómo se devuelve una página pública capturada a la aplicación cliente.
El objetivo subyacente puede ser el mismo, pero la respuesta puede servir a flujos de trabajo muy diferentes. HTML preserva la estructura de la página. El texto elimina la mayor parte del marcado. Markdown mantiene una estructura legible para flujos de trabajo de contenido. Los metadatos JSON describen la solicitud y el contexto de la página. Las capturas de pantalla y los PDFs preservan evidencia visual.
El formato es independiente del método de captura. Una página puede ser obtenida a través de una solicitud HTTP normal o renderizada en un navegador antes de que se cree la salida seleccionada.
| Formato | Mejor para | No ideal para | Ejemplo de salida | Usuario posterior |
|---|---|---|---|---|
| HTML en bruto | Análisis DOM, selectores, enlaces, atributos | Ingesta de contenido limpio sin preprocesamiento | Cuerpo de respuesta HTML | Desarrollador backend |
| HTML renderizado | Contenido DOM generado por JavaScript | Páginas estáticas que ya contienen los datos requeridos | HTML generado por el navegador | Ingeniero de scraping |
| Texto plano | Indexación de búsqueda, análisis ligero, revisión simple | Flujos de trabajo que necesitan encabezados, enlaces o diseño | Texto limpio y legible | Equipo de datos o búsqueda |
| Markdown | Ingesta de IA/RAG, revisión editorial, documentación | Extracción precisa de DOM | Encabezados, párrafos, listas, enlaces | Equipo de producto de IA |
| Metadatos JSON | Estado, URL final, tipo de contenido, contexto de solicitud | Extracción de campo arbitrario del objetivo | Contexto de respuesta estructurado | Ingeniero de plataforma |
| Captura de pantalla | QA visual, monitoreo, evidencia de diseño | Datos estructurados buscables | Artefacto de imagen | Equipo de QA o monitoreo |
| Archivado, aprobación, registros portátiles | Análisis de contenido detallado | Documento descargable | Equipo de cumplimiento u operaciones |
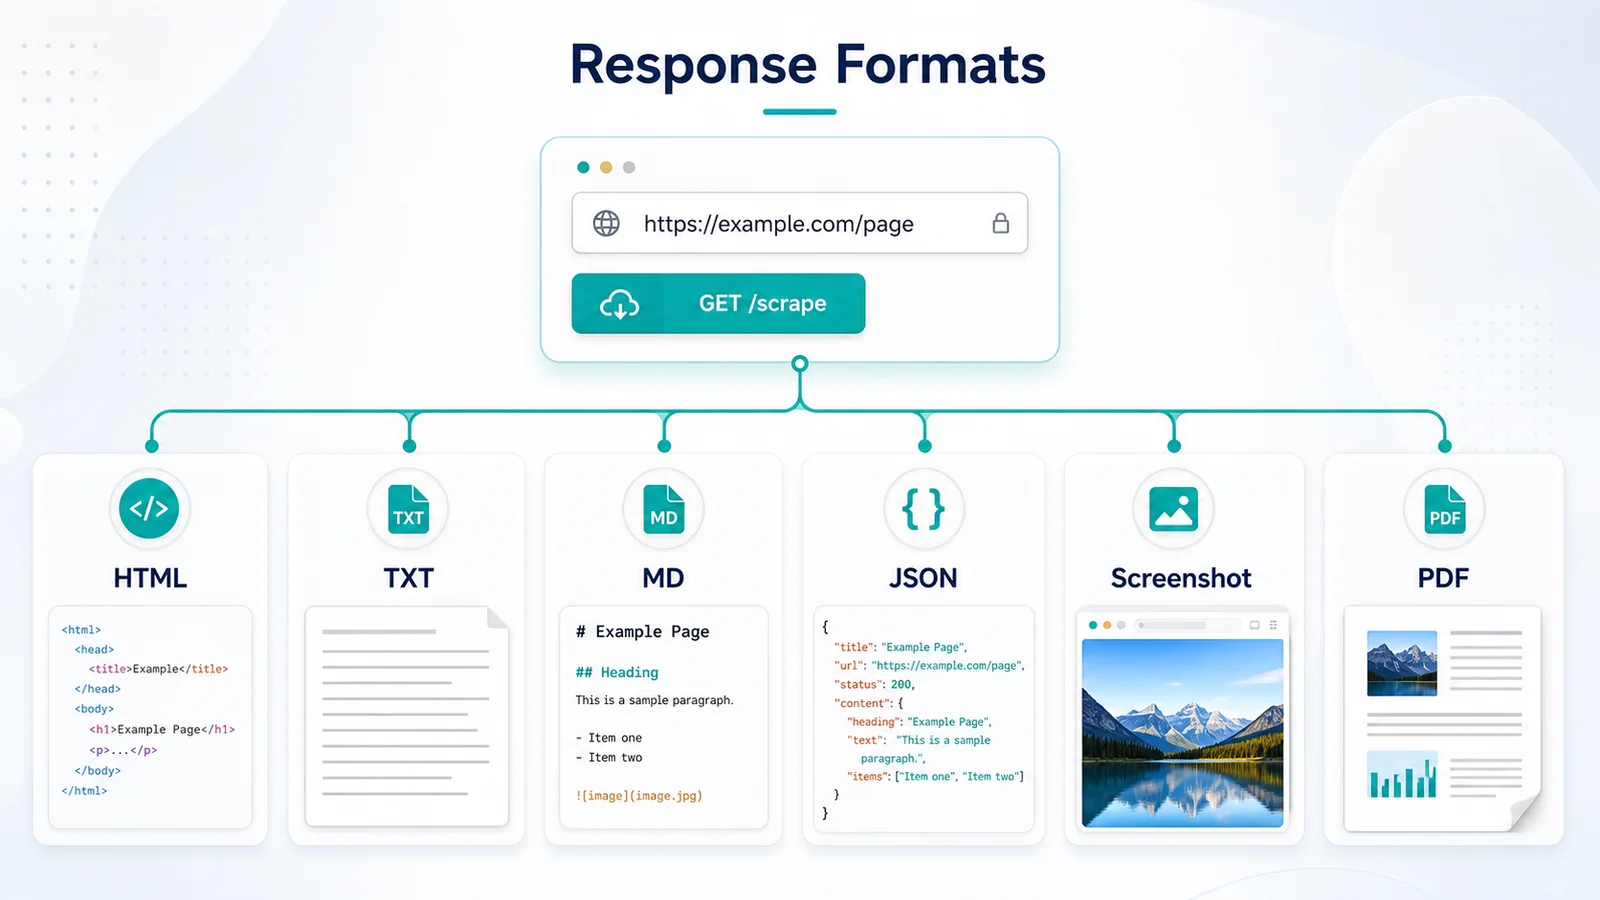
Conclusión práctica: trata el formato de salida como parte de la arquitectura de la aplicación, no como una opción cosmética de API.
¿Por qué importa el formato de respuesta después de que se ha capturado una página?
La solicitud es solo el comienzo de un flujo de trabajo de scraping. La respuesta aún debe pasar a un analizador, índice de búsqueda, tubería de IA, sistema de monitoreo, archivo o interfaz de producto.
Una mala elección de formato desplaza el trabajo hacia abajo.
Por ejemplo, enviar HTML en bruto a una tubería de ingestión de IA puede requerir eliminación de plantillas, filtrado de navegación, limpieza de enlaces y normalización de contenido. Devolver texto plano a un analizador puede eliminar las relaciones DOM necesarias para identificar precios, encabezados, tablas o atributos de productos.
El mismo problema aparece en flujos de trabajo visuales. Un equipo que necesita prueba de cómo apareció una página puede capturar HTML primero, luego mantener trabajadores separados de Playwright o Puppeteer para generar capturas de pantalla. Una salida visual adecuada puede eliminar esa capa extra.
La elección del formato afecta:
- cuánto trabajo de limpieza realiza la aplicación;
- si se preserva la estructura de la página;
- qué tan fácilmente los desarrolladores pueden depurar el resultado;
- si la respuesta es adecuada para procesamiento automatizado;
- cuánto almacenamiento y ancho de banda utiliza la tubería;
- si es necesario un convertidor o trabajador de navegador separado.
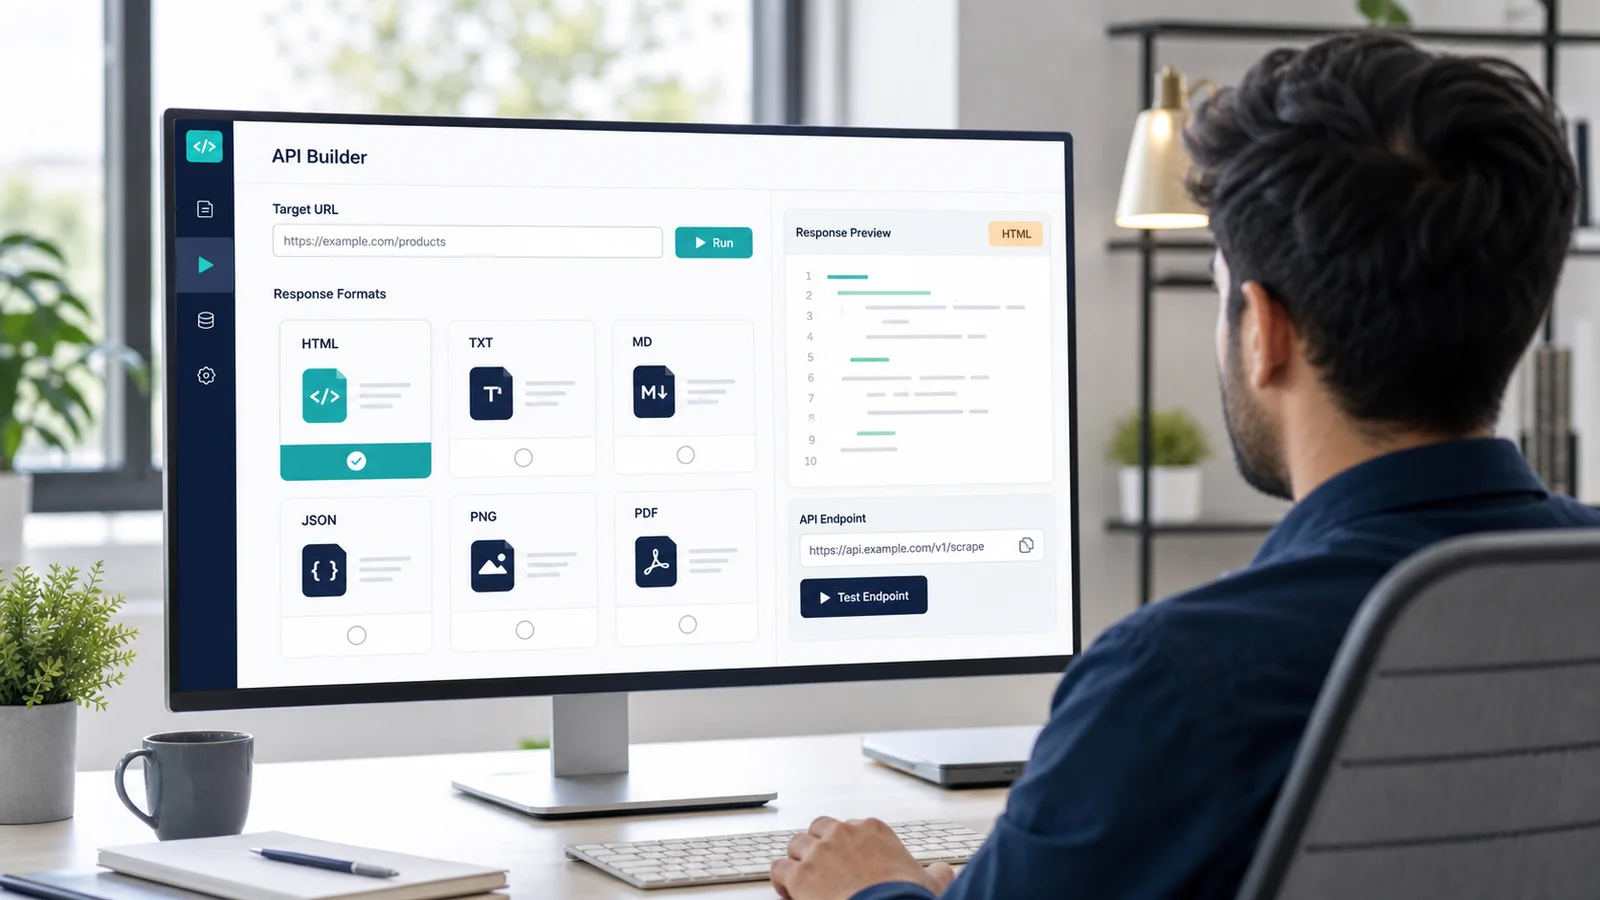
Antes de escribir código de transformación, prueba el objetivo a través del API Builder. Compara el cuerpo de respuesta, la estructura de contenido, el tamaño y la usabilidad a través de formatos.
Conclusión práctica: elige el formato antes de construir convertidores porque la limpieza posterior puede costar más tiempo de ingeniería que la solicitud original.
¿Cuándo debería un flujo de trabajo de scraping usar salida HTML?
HTML es el formato correcto cuando la aplicación necesita la estructura original de la página.
Un analizador puede inspeccionar etiquetas, clases, atributos, encabezados, enlaces, tablas, metadatos incrustados y relaciones DOM. Esto hace que HTML sea adecuado para lógica de extracción personalizada donde la aplicación ya sabe qué elementos son importantes.
Los flujos de trabajo HTML comunes incluyen:
- extraer campos de productos con selectores;
- descubrir enlaces para un rastreador;
- analizar tablas estructuradas;
- leer etiquetas canónicas o metadatos;
- identificar secciones de la página por jerarquía DOM;
- almacenar marcado fuente para procesamiento posterior.
HTML en bruto es la respuesta inicial del servidor. Por lo general, es el lugar más ligero para comenzar.
HTML renderizado es el DOM producido después de que un navegador ejecuta el JavaScript de la página. Es importante cuando el contenido requerido no existe en la respuesta original.
| Pregunta | HTML en bruto | HTML renderizado |
|---|---|---|
| ¿De dónde proviene? | Respuesta HTTP inicial | DOM generado por el navegador |
| ¿Se ejecuta JavaScript? | No | Sí |
| Mejor para | Páginas estáticas y renderizadas por el servidor | Aplicaciones renderizadas por el cliente |
| Latencia típica | Menor | Mayor |
| Peso relativo de la solicitud | Más ligero | Más pesado |
| Riesgo principal | Contenido generado por el navegador faltante | Usar un navegador cuando no es necesario |
| Método de validación | Buscar en la respuesta el contenido requerido | Comparar el DOM renderizado con HTML en bruto |
HTML no es automáticamente mejor porque contiene más información. Puede incluir navegación, scripts, estilos, código de seguimiento y elementos de página no relacionados. Ese ruido es aceptable cuando un analizador necesita control estructural, pero ineficiente cuando el objetivo es contenido legible.
Conclusión práctica: usa HTML cuando la estructura DOM sea una entrada para tu lógica, y elige HTML renderizado solo cuando JavaScript cree el contenido que necesitas.
¿Cuándo son mejores el texto y Markdown que HTML?
El texto y Markdown son útiles cuando el flujo de trabajo posterior necesita contenido de página legible en lugar de control completo del DOM.
El texto plano elimina la mayor parte del marcado visual y estructural. Funciona bien para análisis de palabras clave, indexación de búsqueda, comparación de contenido, clasificación simple y flujos de trabajo donde los encabezados o enlaces no son esenciales.
Markdown preserva más significado. Los encabezados, párrafos, listas y enlaces siguen siendo más fáciles de interpretar que en texto plano. Esto a menudo hace que Markdown sea útil para:
- Preparación de documentos RAG;
- Ingesta de LLM;
- revisión editorial;
- importaciones de bases de conocimiento;
- contexto de aviso;
- análisis de documentación;
- migración de contenido.
Markdown no es un sustituto para un análisis HTML preciso. Si la aplicación debe identificar un precio de producto mediante un selector específico, distinguir enlaces de navegación de enlaces de cuerpo, o inspeccionar atributos, HTML sigue siendo la opción más segura.
La calidad de Markdown también depende de la página fuente. Las páginas editoriales limpias generalmente se convierten de manera más predecible que los diseños altamente interactivos, tableros, tablas complejas o páginas con contenido fragmentado.
| Flujo de trabajo | Formato recomendado | Formato opcional | Por qué |
|---|---|---|---|
| Analizador personalizado | HTML | Metadatos JSON | Preserva selectores y relaciones DOM |
| Ingesta de IA/RAG | Markdown | Texto o HTML | Mantiene jerarquía legible y enlaces |
| Indexación de búsqueda | Texto | Markdown | Reduce el marcado y el ruido de procesamiento |
| Monitoreo de contenido | Texto o HTML | Captura de pantalla | Soporta comparación de máquina y revisión visual |
| Revisión de QA | Captura de pantalla | HTML | Muestra apariencia renderizada con evidencia fuente |
| Archivo | HTML o captura de pantalla | Crea un registro portátil | |
| Informes | Texto o Markdown | Captura de pantalla | Soporta resúmenes con contexto visual |
Un buen flujo de trabajo de IA puede usar más de un formato. Markdown puede proporcionar contenido legible, mientras que los metadatos JSON registran la URL final, tipo de contenido, estado y contexto de captura.
Conclusión práctica: usa texto para contenido legible compacto, Markdown para estructura de documento preservada, y HTML cuando la extracción dependa del DOM.
¿Qué deben esperar los equipos de la salida de metadatos JSON?
Los metadatos JSON proporcionan contexto estructurado sobre la captura y respuesta. No convierten automáticamente cada página objetivo en un esquema de negocio personalizado.
Los metadatos útiles pueden incluir información como:
- estado de la solicitud;
- URL objetivo;
- URL final después de redirecciones;
- tipo de contenido;
- tamaño de respuesta;
- tiempo o contexto de solicitud;
- formato de respuesta seleccionado;
- detalles de captura o enrutamiento soportados por la API.
Esta estructura es valiosa para registro, monitoreo, depuración y coordinación del procesamiento posterior. Una tubería puede usar metadatos para decidir si el cuerpo debe ser analizado, almacenado, reintentado o rechazado.
Sin embargo, los metadatos JSON no deben confundirse con la extracción de esquemas arbitrarios.
Por ejemplo, una respuesta JSON no significa necesariamente que la API identificará automáticamente cada nombre de producto, precio, calificación, autor, empresa o campo de artículo en cualquier sitio web. La extracción específica del objetivo aún requiere lógica de analizador, características de extracción soportadas o una capa de transformación separada.
Un patrón práctico es combinar metadatos con otra respuesta:
- HTML más metadatos para flujos de trabajo de analizador;
- Markdown más metadatos para ingestión de IA;
- captura de pantalla más metadatos para evidencia de QA;
- PDF más metadatos para registros de archivo.
Conclusión práctica: usa metadatos JSON para entender la solicitud y el contexto de la página, no como una suposición de que cada página se convertirá en un conjunto de datos estructurado personalizado.
¿Cuándo son las capturas de pantalla y los PDFs la salida correcta de la API de scraping?
Las capturas de pantalla y los PDFs son apropiados cuando la apariencia visual es parte de la evidencia.
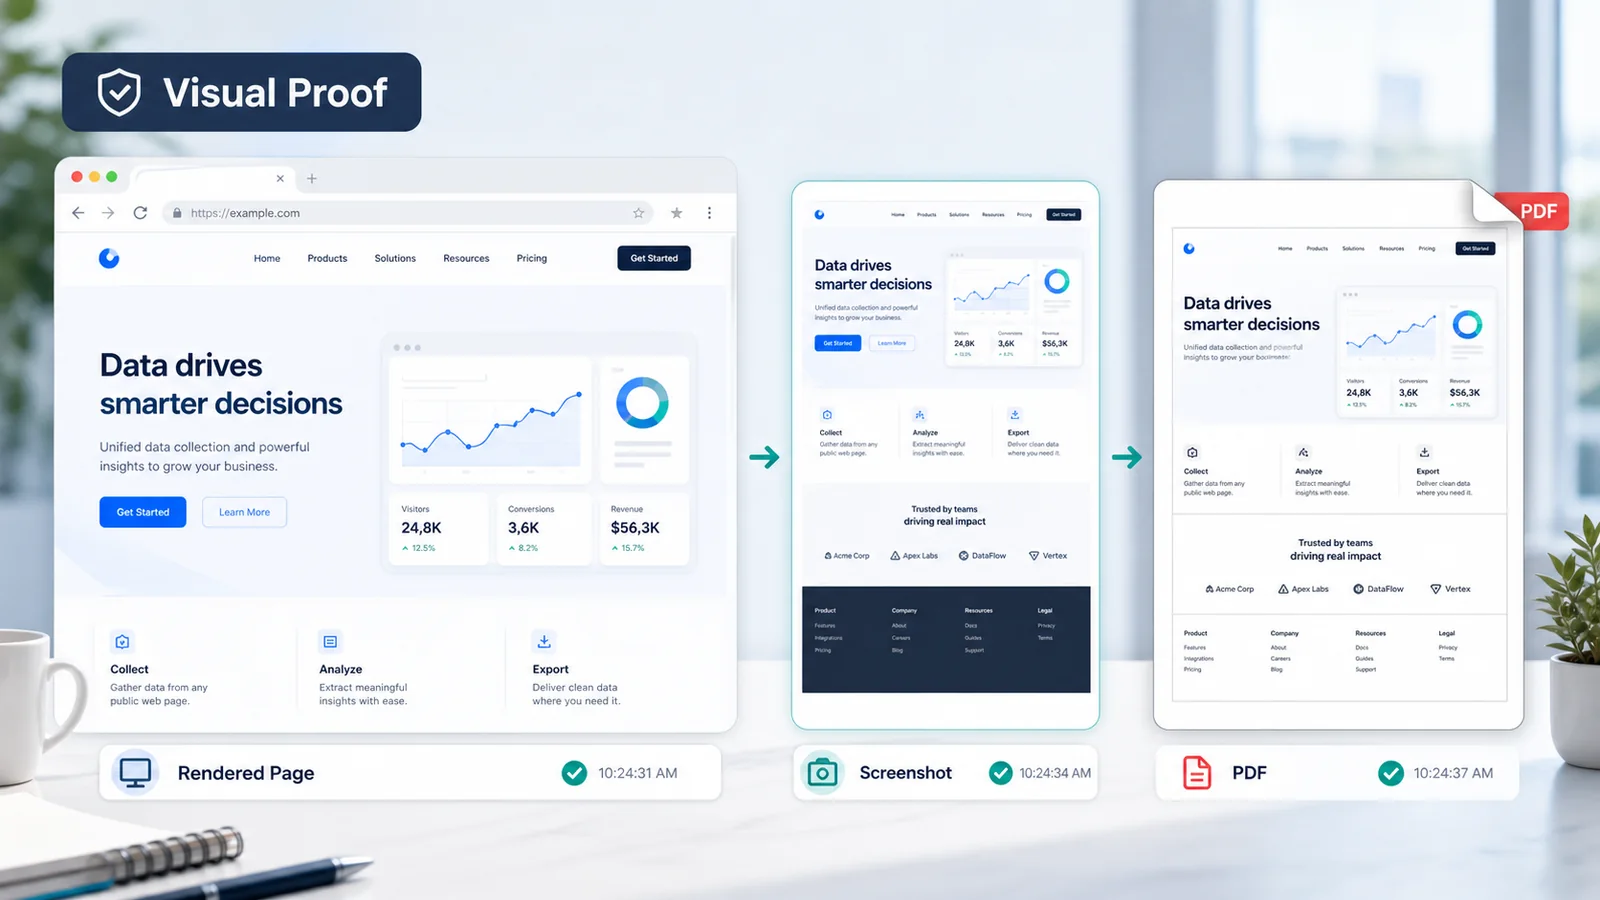
HTML y texto pueden mostrar qué contenido fue devuelto, pero pueden no probar cómo el navegador mostró la página. Una captura de pantalla puede capturar diseño, errores visibles, pantallas de consentimiento, componentes faltantes, cambios responsivos o presentación específica de región.
Las capturas de pantalla son útiles para:
- monitoreo de regresión visual;
- QA de página renderizada;
- verificación de diseño;
- revisión de campañas y páginas de destino;
- reproducción de problemas;
- flujos de trabajo de aprobación humana.
Los PDFs son mejores cuando el resultado debe ser almacenado, compartido, impreso, revisado o retenido como un artefacto similar a un documento. Pueden soportar archivo, revisión de cumplimiento, aprobación y mantenimiento de registros operativos.
| Formato de evidencia | Mejor uso | Principal ventaja | Principal limitación |
|---|---|---|---|
| Captura de pantalla | QA visual y evidencia de estado de página | Muestra lo que apareció en la ventana de visualización | No es conveniente para búsqueda estructurada |
| Archivo, revisión y registros portátiles | Preserva un artefacto similar a un documento | Más grande y más difícil de analizar | |
| HTML | Evidencia fuente y DOM | Estructura legible por máquina | Puede no coincidir con la apariencia visual final |
| Texto o Markdown | Evidencia de contenido | Fácil de buscar y analizar | Pierde diseño visual |
La salida visual debe complementar los datos legibles por máquina, no reemplazarlos. Un flujo de trabajo de monitoreo puede comparar HTML o texto automáticamente y generar una captura de pantalla solo cuando se detecta un cambio significativo.
Las capturas de pantalla y los PDFs también son más pesados que el texto plano o HTML en bruto. Revisa las opciones de crédito actuales en Precios antes de generar artefactos visuales para cada solicitud.
Conclusión práctica: elige capturas de pantalla para estado visual y PDFs para registros portátiles, mientras mantienes HTML o texto cuando el sistema también necesita evidencia legible por máquina.
¿Cómo cambia el renderizado de JavaScript la calidad del formato de respuesta?
El renderizado de JavaScript mejora la calidad de salida solo cuando el objetivo depende de la ejecución del navegador.
Una respuesta HTTP en bruto puede contener un artículo completo, página de producto o página de documentación. En ese caso, el renderizado agrega latencia y peso de solicitud sin mejorar el formato seleccionado.
Otras páginas devuelven un contenedor de aplicación y cargan contenido después de que el navegador comienza. Una respuesta de Markdown o captura de pantalla creada antes de que aparezca ese contenido puede estar incompleta. El renderizado permite que el navegador construya el DOM antes de que ScraperFly produzca la salida solicitada.
Señales comunes de que el renderizado puede ser necesario incluyen:
- el HTML en bruto no contiene texto visible de la página;
- listas o tablas aparecen solo después de cargar la página;
- los marcos del lado del cliente insertan el contenido principal;
- una captura de pantalla muestra un contenedor vacío;
- el objetivo carga datos a través de solicitudes en segundo plano;
- componentes retrasados requieren una espera controlada.
No asumas que la salida de Markdown, captura de pantalla o PDF requiere automáticamente renderizado. La decisión debe provenir del comportamiento del objetivo.
Prueba la página sin renderizado primero. Busca el contenido requerido. Luego compara la respuesta con una solicitud habilitada para navegador usando la API de renderizado de JavaScript.
Conclusión práctica: el renderizado mejora un formato solo cuando la ejecución del navegador cambia el contenido del que se construye ese formato.
Un formato de producción debe ser seleccionado desde el requisito posterior hacia atrás.
Usa este proceso de decisión:
- Define el consumidor. Identifica si la respuesta va a un analizador, LLM, índice de búsqueda, revisor de QA, archivo o sistema de monitoreo.
- Define la evidencia necesaria. Decide si el flujo de trabajo necesita estructura DOM, contenido legible, contexto de solicitud, apariencia visual o un registro portátil.
- Prueba la captura en bruto primero. Confirma si el contenido necesario existe sin renderizado del navegador.
- Compara formatos en un objetivo. Evalúa HTML, texto, Markdown, metadatos o salida visual usando la misma URL pública.
- mide la limpieza. Elige la respuesta que requiera la menor transformación personalizada confiable.
- Verifica el tamaño y peso de la respuesta. Evita almacenar o generar más datos de los que la aplicación utiliza.
- Documenta el perfil de solicitud. Registra el formato elegido, configuración de renderizado, esperas, enrutamiento, encabezados y salida esperada.
El formato seleccionado puede diferir según el grupo objetivo. Las páginas editoriales pueden ajustarse a Markdown, las páginas de comercio electrónico pueden requerir HTML, y el monitoreo visual puede combinar texto con capturas de pantalla.
Un perfil de respuesta global es conveniente, pero rara vez es óptimo para una carga de trabajo de producción mixta.
Conclusión práctica: elige formatos por clase de flujo de trabajo, valídalos en objetivos representativos y registra el perfil de solicitud comprobado antes de escalar.
¿Cómo afectan los formatos de respuesta el costo y el peso de la solicitud?
Los formatos de respuesta afectan el ancho de banda, almacenamiento, tiempo de procesamiento y créditos de API.
Una respuesta básica de HTML o texto suele ser más ligera que una captura de pantalla renderizada por el navegador o un PDF. La diferencia se vuelve importante en volumen de producción.
| Perfil de salida | Peso relativo | El costo está justificado cuando | Evitar cuando |
|---|---|---|---|
| HTML en bruto | Ligero | Se requiere marcado DOM o fuente | Solo se necesita contenido legible |
| Texto plano | Ligero | El procesamiento de contenido compacto es el objetivo | La estructura y los enlaces importan |
| Markdown | Ligero a moderado | Los flujos de trabajo de IA o editoriales se benefician de la jerarquía | Se requiere extracción precisa de DOM |
| Metadatos JSON | Ligero | El contexto de solicitud apoya las operaciones | Se espera que reemplace el análisis |
| HTML renderizado | Mayor | JavaScript crea el contenido requerido | HTML en bruto ya está completo |
| Captura de pantalla | Mayor | Se requiere prueba visual o QA | Cada solicitud se procesa solo por máquina |
| Mayor | Se requiere un registro archivado portátil | El artefacto nunca se revisa o retiene |
El control de costos debe comenzar con objetivos representativos. Agrupa solicitudes por formato y necesidad de renderizado en lugar de precios cada URL como si requiriera el perfil más pesado.
Los créditos de ScraperFly hacen posible conectar el peso de la solicitud a los controles habilitados. Los equipos pueden comenzar con una prueba gratuita, comparar formatos y estimar la carga de trabajo real usando el calculador de costos de créditos de API de web scraping.
Conclusión práctica: reserva salidas renderizadas y basadas en archivos para flujos de trabajo que usen su evidencia adicional.
¿Qué errores deben evitar los equipos al elegir la salida de la API de scraping?
El error más común es elegir un formato familiar en lugar del formato que necesita el producto.
Evita estos patrones:
Enviar HTML a todas partes. El marcado en bruto agrega limpieza innecesaria al contenido y a las tuberías de IA.
Usar texto para extracción precisa. El texto plano elimina relaciones DOM de las que los analizadores pueden depender.
Asumir que Markdown es perfecto para cada página. Tablas complejas, componentes interactivos y diseños inusuales pueden no convertirse limpiamente.
Tratar los metadatos JSON como extracción personalizada. El contexto de solicitud estructurado no es lo mismo que un esquema de negocio específico del objetivo.
Generar capturas de pantalla para flujos de trabajo solo de máquina. Los archivos visuales agregan peso pero proporcionan poco valor cuando ningún sistema de comparación humana o visual los utiliza.
Usar PDF como entrada para el analizador. Los PDFs son registros útiles pero rara vez son la fuente más eficiente para la extracción estructurada.
Renderizar cada solicitud. La ejecución del navegador debe resolver una brecha de contenido demostrada.
Construir convertidores antes de probar formatos. Un equipo puede pasar días reproduciendo una salida que la API ya puede devolver.
Usar un formato para cada objetivo. Diferentes tipos de página y consumidores posteriores a menudo necesitan perfiles diferentes.
Prueba páginas representativas a través del API Builder, compara la salida y elige en función de la usabilidad en lugar de la popularidad del formato.
Conclusión práctica: valida la respuesta con su verdadero consumidor posterior antes de comprometer la arquitectura de producción.
PREGUNTAS DEL COMPRADOR
Preguntas comunes antes de elegir un formato de respuesta
Responde preguntas de evaluación práctica sobre HTML, texto, Markdown, metadatos JSON, capturas de pantalla, PDFs, renderizado, peso de solicitud y usabilidad de producción.
FAQ DE SALIDAMarkdown, texto y tuberías de IA
Elige salida legible cuando el consumidor sea búsqueda, RAG, revisión editorial o análisis de contenido ligero.
¿Es Markdown siempre el mejor formato para una tubería de IA o RAG?
No. Markdown es útil cuando encabezados, listas y enlaces mejoran el contexto del documento. El texto plano puede ser mejor para procesamiento compacto, mientras que HTML puede ser necesario cuando el contenido debe seleccionarse primero de elementos DOM específicos.
¿Puede una aplicación usar diferentes formatos de respuesta para diferentes objetivos?
Sí. Una aplicación de producción puede clasificar objetivos por flujo de trabajo. Las páginas de documentación pueden usar Markdown, las páginas de productos pueden usar HTML, y los objetivos de monitoreo visual pueden usar capturas de pantalla.
HTML más contexto de respuesta
Usa contexto estructurado para depurar, enrutar y registrar solicitudes sin pretender que los metadatos sean un extractor personalizado.
¿Puede una API de scraping devolver HTML y metadatos para el mismo flujo de trabajo?
Sí, un flujo de trabajo puede usar contenido de página junto con contexto de respuesta. HTML soporta análisis, mientras que los metadatos pueden registrar el estado, URL final, tipo de contenido, tamaño de respuesta y otros detalles de solicitud soportados por la API.
¿La salida JSON extrae automáticamente productos o campos de artículos?
No. Los metadatos JSON describen la captura o respuesta. No deben interpretarse como extracción automática de campos arbitrarios como precios, autores, calificaciones o atributos de productos.
Capturas de pantalla, PDFs y salida renderizada
Agrega artefactos visuales cuando la revisión, archivo o evidencia de apariencia importan, no para cada solicitud solo de máquina.
¿Se deben generar capturas de pantalla para cada página monitoreada?
Generalmente no. HTML o texto legible por máquina son mejores para comparación automatizada. Las capturas de pantalla son más valiosas cuando un cambio requiere confirmación visual, revisión humana o evidencia de diseño.
¿Cuál es la diferencia entre HTML renderizado y una captura de pantalla?
HTML renderizado contiene el DOM después de la ejecución del navegador y sigue siendo adecuado para análisis. Una captura de pantalla es una imagen que muestra cómo apareció visualmente la página. Los dos formatos responden a preguntas diferentes.
¿Cuándo debería un flujo de trabajo de scraping usar salida PDF?
Usa PDF cuando la página capturada debe convertirse en un documento portátil para revisión, aprobación, archivo o mantenimiento de registros. Usa HTML, texto o Markdown cuando el procesamiento automatizado sea el principal requisito.
Pruebas antes de la integración
Compara los formatos en objetivos representativos antes de que el equipo construya convertidores o escale un perfil pesado.
¿Cómo deberían los desarrolladores comparar formatos antes de la integración?
Ejecuta la misma URL de objetivo representativo a través del API Builder usando varios formatos. Compara estructura, contenido faltante, tamaño de respuesta, necesidades de renderizado, requisitos de limpieza y usabilidad posterior antes de seleccionar el perfil de producción.
Prueba la forma de respuesta antes de comprometer la arquitectura
Una tubería de scraping se vuelve más fácil de mantener cuando la API devuelve la forma que el producto puede usar de inmediato.
ScraperFly permite a los equipos capturar páginas públicas como HTML, texto, Markdown, metadatos JSON, capturas de pantalla o PDFs a través de un modelo de solicitud. Comienza con un objetivo representativo, compara formatos en el API Builder, habilita el renderizado del navegador solo cuando la página lo requiere, y mantiene salidas visuales para flujos de trabajo que usan evidencia visual.
El mejor formato de respuesta no es el que tiene más datos. Es el que elimina el procesamiento innecesario mientras preserva la evidencia que tu aplicación necesita.









