






Recuperação baseada em evidências
Corrija a causa antes de repetir a solicitação
Erros de scraping se tornam caros quando cada falha recebe a mesma resposta: tente novamente com mais força. Um URL ruim, uma chave inválida, um alvo 403, um limite 429, um tempo limite de renderização, uma estrutura HTML vazia e uma resposta excessiva são problemas diferentes com soluções diferentes.
ScraperFly fornece às equipes as evidências da solicitação que elas precisam para escolher o próximo passo de forma deliberada. Inspecione o status, a URL final, o tamanho da resposta, o tipo de conteúdo, o formato de saída, o comportamento de renderização e os sinais do alvo antes de adicionar execução de navegador, sessões, cabeçalhos, roteamento por país ou entrega premium.
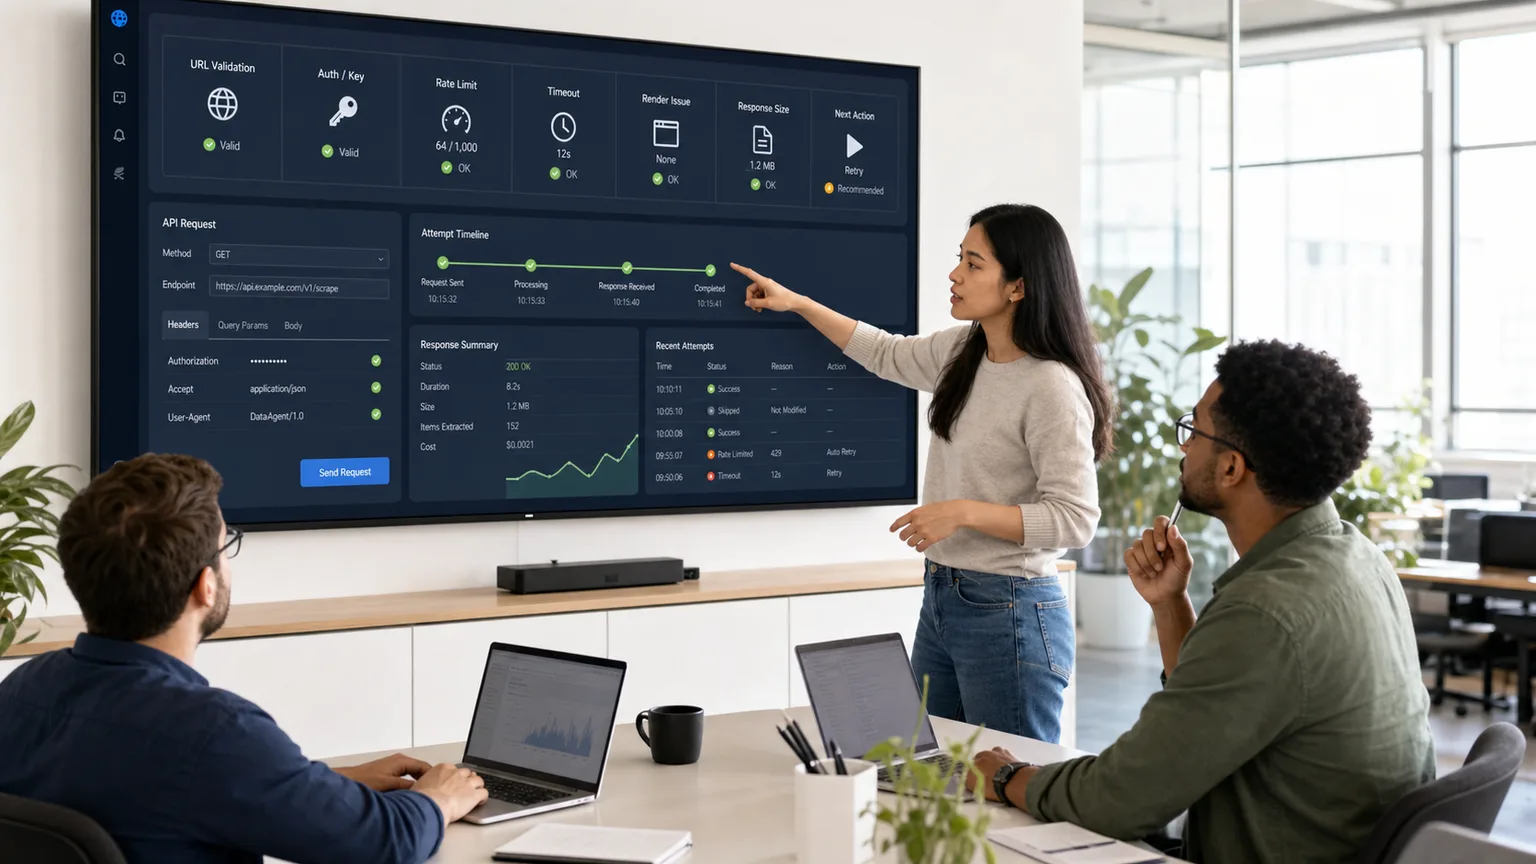
O que a manipulação de erros da API de scraping precisa responder?
Uma boa manipulação de erros faz mais do que dizer que uma solicitação falhou. Ela deve responder se o problema veio da solicitação, da conta, do alvo, do caminho da rede, da renderização do navegador, do formato de saída selecionado ou do parser downstream. Essa classificação decide se a próxima ação é correção, nova tentativa, espera, escalonamento ou uma captura menor.
É por isso que um fluxo de trabalho de scraping confiável deve registrar tanto o erro visível quanto as evidências ao redor. Uma resposta 200 com um corpo HTML pequeno pode ser menos útil do que um claro 403. Uma captura de tela bem-sucedida de uma página de erro ainda é uma falha de alvo. Um tempo limite de PDF pode ser um problema de escopo de saída em vez de um problema de proxy.
Quais erros de scraping devem ser corrigidos em vez de tentados novamente?
Algumas falhas devem parar o fluxo de trabalho imediatamente porque outra solicitação idêntica não pode ter sucesso. URLs ausentes, URLs malformadas, formatos não suportados, chaves de API inválidas, chaves pausadas, opções de arquivo incompatíveis e combinações de saída impossíveis são problemas de configuração. Eles precisam de validação e melhor feedback, não de backoff.
Erros de correção primeiro são onde a disciplina da API economiza dinheiro. Se a solicitação for inválida, gastar créditos em renderização, roteamento premium ou tentativas repetidas apenas oculta o verdadeiro problema. Valide a forma da solicitação cedo, depois envie lotes de produção apenas após a solicitação base estar correta.
| Grupo de erro | Sinal comum | Melhor próxima ação |
|---|---|---|
| Validação de entrada | URL ausente, URL inválida, parâmetro não suportado | Corrija a solicitação antes de tentar novamente |
| Autenticação | Chave de API ausente, inválida, desativada ou pausada | Corrija a configuração da conta ou da chave |
| Escolha de saída | Formato não suportado, opção de captura de tela ou PDF incompatível | Escolha um formato de resposta suportado |
| Problema de escopo | Resposta ou captura de arquivo excessiva | Reduza a captura ou use uma saída mais leve |
Quais falhas merecem tentativas controladas?
Falhas temporárias podem ser tentadas novamente, mas a política de nova tentativa deve ser limitada. Timeouts de rede, respostas 5xx transitórias upstream e limites de 429 podem se recuperar após backoff. Repeti-las imediatamente com maior concorrência geralmente torna o fluxo de trabalho menos estável.
Uma política de nova tentativa forte registra o motivo, espera antes da próxima tentativa, limita o total de tentativas e muda a solicitação apenas quando as evidências apoiam uma mudança. Por exemplo, um erro 403 do lado do alvo pode precisar de análise de contexto de acesso, não de um loop de nova tentativa genérico. Uma resposta HTML vazia pode precisar de uma comparação entre bruto e renderizado antes de qualquer mudança de roteamento.
| Falha | Postura de nova tentativa | Evidência a inspecionar |
|---|---|---|
| Timeout | Tentar novamente com um limite e backoff | Duração, estabilidade do alvo, tempo de renderização, início da resposta |
| Resposta 5xx upstream | Tentar novamente se o padrão temporário for plausível | Histórico de status, URL final, tamanho do corpo da resposta |
| Limite 429 | Diminuir a velocidade antes de aumentar a pressão | Concorrência, cadência de solicitações, limites da conta, tolerância do alvo |
| Resposta 403 do alvo | Diagnosticar antes de tentar novamente | Cabeçalhos, região, cookies, renderização, comportamento de roteamento |
Quando a renderização, esperas ou roteamento devem ser escalonados?
A escalonamento deve seguir a prova. Ative a renderização JavaScript quando o conteúdo público útil estiver ausente do HTML de origem e aparecer após a execução do navegador. Adicione esperas de renderização quando o navegador abrir a página, mas o conteúdo carregar depois. Considere cabeçalhos, cookies, sessões, direcionamento por país ou roteamento premium quando as evidências da resposta apontarem para contexto, continuidade, geografia ou comportamento de acesso do lado do alvo.
A chave é não transformar cada alvo na solicitação mais pesada. Use renderização para páginas que precisam de execução do navegador, revise as evidências de timeout de renderização quando o trabalho do navegador falhar e inspecione os casos de resposta muito grande antes de escalar o mesmo perfil.
Como o ScraperFly torna as decisões de recuperação práticas?
ScraperFly ajuda os desenvolvedores a construir a recuperação em torno de evidências observáveis da solicitação: status, URL final, tipo de conteúdo, tamanho da resposta, formato de saída, comportamento de renderização e perfil de roteamento. Isso facilita manter alvos simples leves enquanto dá a alvos mais difíceis um caminho limpo para renderização, sessões, cabeçalhos, direcionamento por país, roteamento premium, capturas de tela ou PDFs quando são justificados.
Use o API Builder para reproduzir a solicitação do alvo, comparar formatos de saída e testar o próximo controle antes de conectar uma política de nova tentativa ao código. Em seguida, use preços e o calculadora de custo de crédito da API de scraping para manter os experimentos de recuperação alinhados com a carga de trabalho real.







