






Recuperación basada en evidencia
Corrija la causa antes de repetir la solicitud
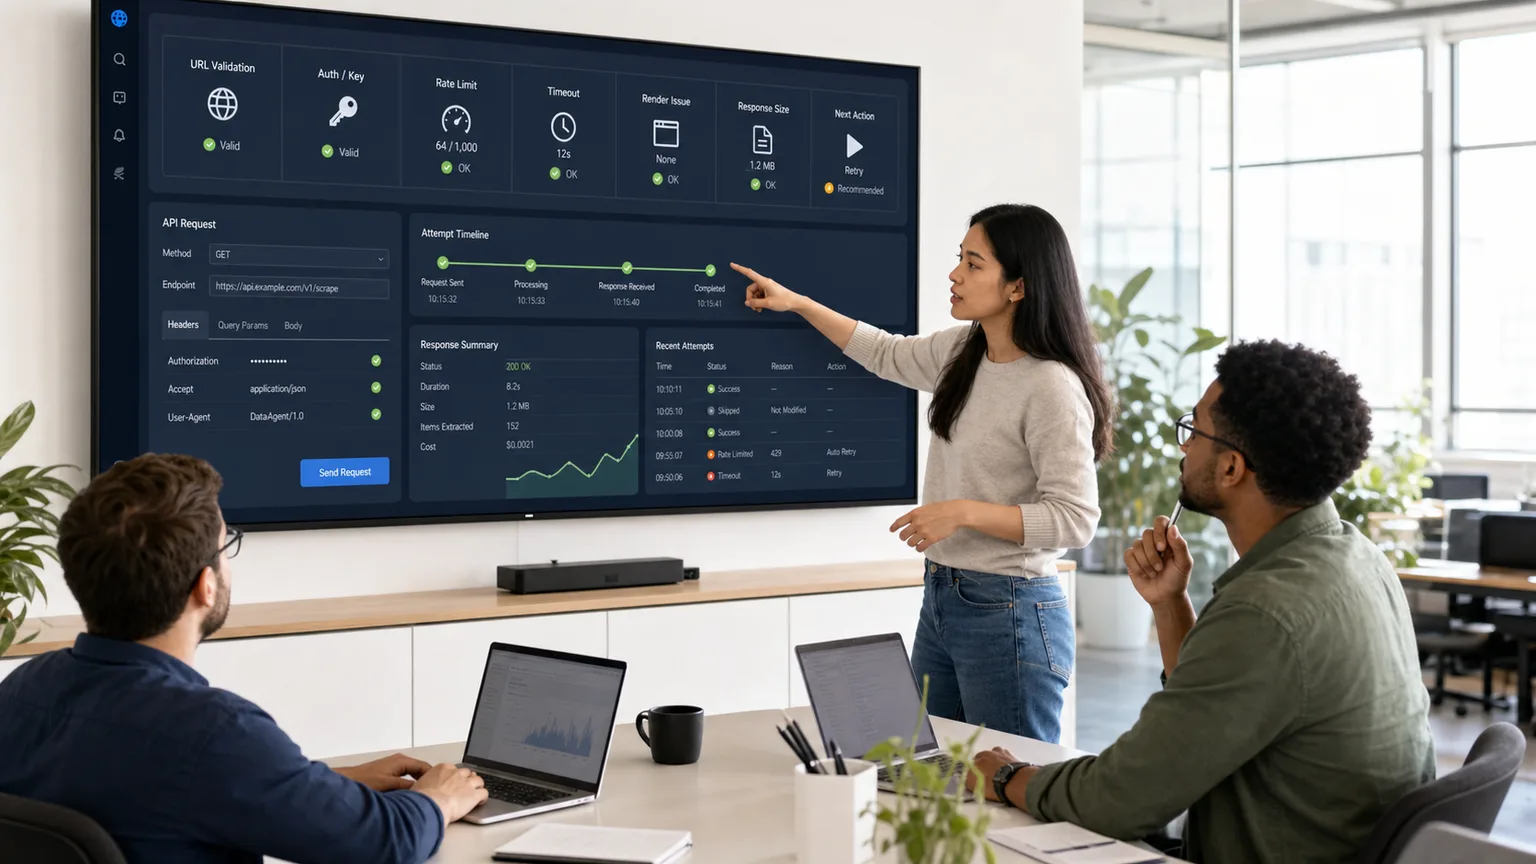
Los errores de scraping se vuelven costosos cuando cada fallo recibe la misma respuesta: reintentar con más fuerza. Una URL incorrecta, una clave inválida, un objetivo 403, un límite 429, un tiempo de espera de renderizado, un contenedor HTML vacío y una respuesta sobredimensionada son diferentes problemas con diferentes soluciones.
ScraperFly proporciona a los equipos la evidencia de la solicitud que necesitan para elegir el siguiente paso de manera deliberada. Inspeccione el estado, la URL final, el tamaño de la respuesta, el tipo de contenido, el formato de salida, el comportamiento de renderizado y las señales del objetivo antes de agregar ejecución de navegador, sesiones, encabezados, enrutamiento por país o entrega premium.
¿Qué necesita responder el manejo de errores de la API de scraping?
Un buen manejo de errores hace más que decir que una solicitud falló. Debe responder si el problema provino de la solicitud, la cuenta, el objetivo, la ruta de red, el renderizado del navegador, la salida seleccionada o el analizador posterior. Esa clasificación decide si la siguiente acción es corrección, reintento, espera, escalada o una captura más pequeña.
Por eso, un flujo de trabajo de scraping confiable debe registrar tanto el error visible como la evidencia circundante. Una respuesta 200 con un cuerpo HTML pequeño puede ser menos útil que un claro 403. Una captura de pantalla exitosa de una página de error sigue siendo un fallo del objetivo. Un tiempo de espera de PDF puede ser un problema de alcance de salida en lugar de un problema de proxy.
¿Qué errores de scraping deben ser corregidos en lugar de reintentados?
Algunos fallos deben detener el flujo de trabajo de inmediato porque otra solicitud idéntica no puede tener éxito. URLs faltantes, URLs mal formadas, formatos no soportados, claves API inválidas, claves pausadas, opciones de archivo incompatibles y combinaciones de salida imposibles son problemas de configuración. Necesitan validación y mejor retroalimentación, no retroceso.
Los errores de corrección primero son donde la disciplina de la API ahorra dinero. Si la solicitud es inválida, gastar créditos en renderizado, enrutamiento premium o intentos repetidos solo oculta el verdadero problema. Valide la forma de la solicitud temprano, luego envíe lotes de producción solo después de que la solicitud base sea correcta.
| Grupo de error | Señal común | Mejor siguiente acción |
|---|---|---|
| Validación de entrada | URL faltante, URL inválida, parámetro no soportado | Corregir la solicitud antes de reintentar |
| Autenticación | Clave API faltante, inválida, deshabilitada o pausada | Corregir la configuración de la cuenta o clave |
| Elección de salida | Formato no soportado, opción de captura de pantalla o PDF incompatible | Elegir un formato de respuesta soportado |
| Problema de alcance | Respuesta sobredimensionada o captura de archivo | Reducir la captura o usar una salida más ligera |
¿Qué fallos merecen reintentos controlados?
Los fallos temporales pueden ser reintentados, pero la política de reintentos debe estar limitada. Los tiempos de espera de red, las respuestas transitorias 5xx y los límites de tasa 429 seleccionados pueden recuperarse después de un retroceso. Repetirlos inmediatamente con mayor concurrencia generalmente hace que el flujo de trabajo sea menos estable.
Una política de reintentos sólida registra la razón, espera antes del siguiente intento, limita los reintentos totales y cambia la solicitud solo cuando la evidencia respalda un cambio. Por ejemplo, un error 403 del lado del objetivo puede necesitar un análisis del contexto de acceso, no un bucle de reintento genérico. Una respuesta HTML vacía puede necesitar una comparación entre crudo y renderizado antes de cualquier cambio de enrutamiento.
| Fallo | Postura de reintento | Evidencia a inspeccionar |
|---|---|---|
| Tiempo de espera | Reintentar con un límite y retroceso | Duración, estabilidad del objetivo, tiempo de renderizado, inicio de respuesta |
| Respuesta 5xx de upstream | Reintentar si el patrón temporal es plausible | Historial de estado, URL final, tamaño del cuerpo de respuesta |
| Límite de tasa 429 | Reducir la velocidad antes de aumentar la presión | Concurrencia, cadencia de solicitud, límites de cuenta, tolerancia del objetivo |
| Respuesta 403 del objetivo | Diagnosticar antes de reintentar | Encabezados, región, cookies, renderizado, comportamiento de ruta |
¿Cuándo deben escalarse el renderizado, las esperas o el enrutamiento?
La escalada debe seguir la prueba. Habilite el renderizado de JavaScript cuando el contenido público útil falte en el HTML fuente y aparezca después de la ejecución del navegador. Agregue esperas de renderizado cuando el navegador abra la página pero el contenido se cargue más tarde. Considere encabezados, cookies, sesiones, segmentación por país o enrutamiento premium cuando la evidencia de respuesta apunte a contexto, continuidad, geografía o comportamiento de acceso del lado del objetivo.
La clave es no convertir cada objetivo en la solicitud más pesada. Use renderizado para páginas que necesiten ejecución de navegador, revise la evidencia de tiempo de espera de renderizado cuando el trabajo del navegador falle, e inspeccione los casos de respuesta demasiado grande antes de escalar el mismo perfil.
¿Cómo hace ScraperFly que las decisiones de recuperación sean prácticas?
ScraperFly ayuda a los desarrolladores a construir la recuperación en torno a la evidencia observable de la solicitud: estado, URL final, tipo de contenido, tamaño de respuesta, formato de salida, comportamiento de renderizado y perfil de enrutamiento. Eso facilita mantener objetivos simples ligeros mientras se les da a los objetivos más difíciles un camino limpio hacia el renderizado, sesiones, encabezados, segmentación por país, enrutamiento premium, capturas de pantalla o PDFs cuando están justificados.
Utilice el API Builder para reproducir la solicitud objetivo, comparar formatos de salida y probar el siguiente control antes de integrar una política de reintentos en el código. Luego use precios y el calculador de costos de crédito de la API de scraping web para mantener los experimentos de recuperación alineados con la carga de trabajo real.







