






Saída de texto limpa
Transforme uma URL pública em texto legível sem carregar toda a página
Muitos trabalhos de scraping não precisam do documento HTML completo. Eles precisam do conteúdo legível: parágrafos, cópia de produtos, texto de artigos, páginas de ajuda, descrições de listagens, páginas de políticas, trechos de avaliações ou texto de monitoramento que pode ser pesquisado, comparado, resumido, classificado ou enviado para um pipeline interno.
ScraperFly mantém esse caminho prático. Envie uma URL pública, capture a página, renderize apenas quando o JavaScript for necessário e retorne texto limpo quando a marcação de layout, scripts, navegação e estrutura decorativa do DOM apenas adicionariam ruído. Se o fluxo de trabalho precisar de cabeçalhos e links, teste Markdown. Se precisar de seletores, mantenha HTML. O formato segue o trabalho.
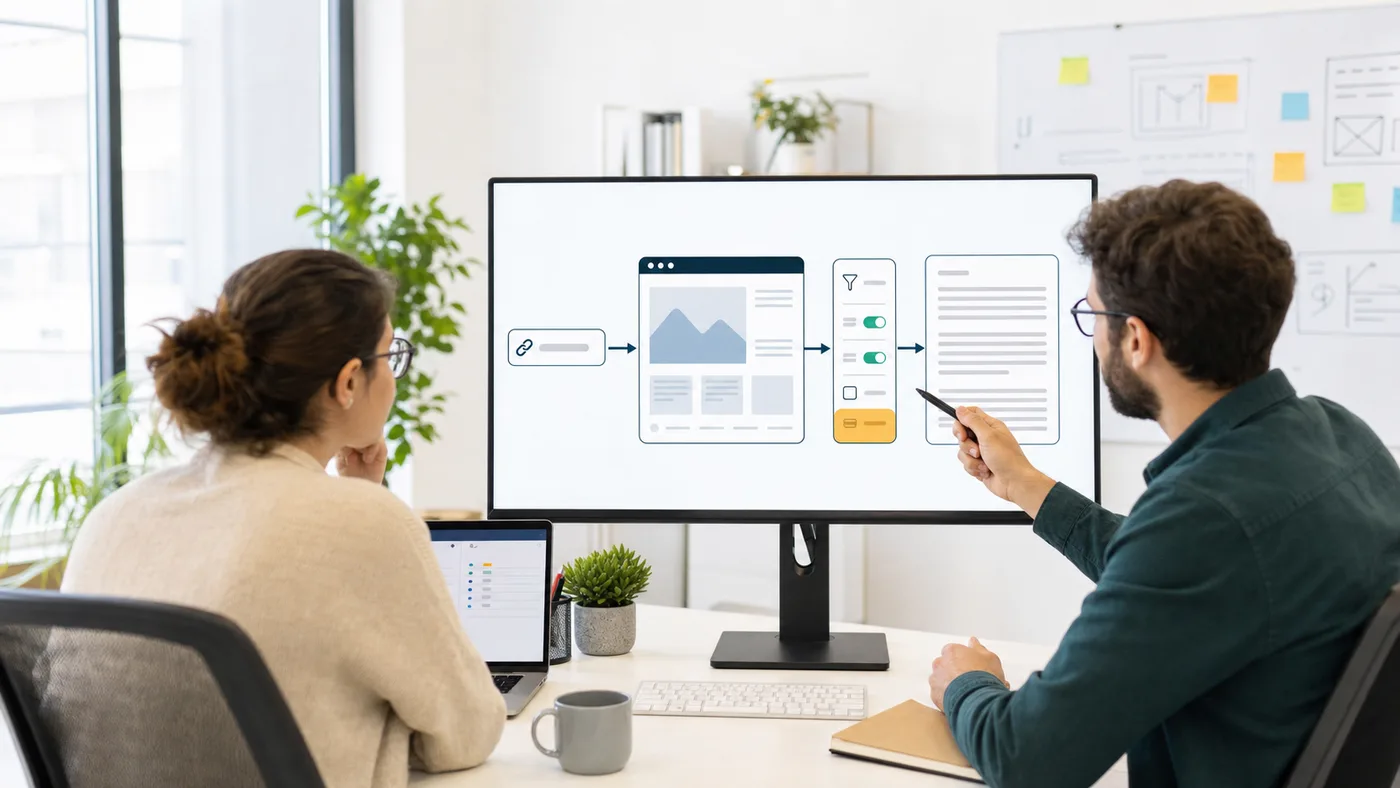
O que é uma API de URL para texto?
Uma API de URL para texto aceita uma URL pública, captura a resposta da página e retorna texto legível que um aplicativo pode usar sem precisar analisar o documento HTML completo primeiro. É útil quando o próximo passo se preocupa mais com o significado do conteúdo do que com a estrutura do DOM: indexação de pesquisa, monitoramento, sumarização, classificação, prompts de IA, fluxos de trabalho de revisão ou comparação de conteúdo leve.
ScraperFly lida com a camada de captura para esse fluxo de trabalho. Ele pode buscar a página pública, executar a renderização do navegador quando o texto útil é criado pelo JavaScript e retornar a saída de texto através da mesma superfície da API usada para HTML, Markdown, metadados, capturas de tela e PDFs. Seu aplicativo pode então armazenar, comparar, enriquecer ou direcionar o texto sem manter um serviço de limpeza separado para cada alvo.
A decisão importante não é "texto em toda parte". O texto é poderoso quando a marcação é ruído. Ele é mais fraco quando o analisador precisa de relacionamentos de elementos, atributos, tabelas ou estrutura de links. Um fluxo de trabalho confiável testa o alvo primeiro, compara formatos de resposta e usa texto apenas quando preserva o conteúdo que o produto realmente precisa.
Quando o texto é melhor que HTML ou Markdown?
O texto é a saída mais compacta para fluxos de trabalho focados em conteúdo. Ele remove a camada de marcação para que sistemas subsequentes possam se concentrar em palavras, frases, entidades, sentimento, mudanças de conteúdo ou correspondência simples. Isso o torna útil para pesquisa interna, alertas, QA de conteúdo, enriquecimento de dados e alguns fluxos de trabalho de IA onde a estrutura é menos importante do que a legibilidade.
Markdown mantém mais estrutura leve: cabeçalhos, listas e links. HTML mantém a maior estrutura: tags, atributos, tabelas e relacionamentos de elementos. A melhor escolha depende do consumidor. Se uma equipe escolher texto quando realmente precisa de cabeçalhos e links, pode perder contexto útil. Se escolher HTML quando só precisa de cópia legível, pode gastar tempo limpando marcação que nunca importou.
| Saída | Use quando | O que preserva | Compensação |
|---|---|---|---|
| Texto | O fluxo de trabalho precisa de conteúdo legível para pesquisa, resumos, correspondência ou monitoramento. | Conteúdo simples com menos ruído de marcação. | A maior parte da estrutura é removida. |
| Markdown | IA, RAG, documentação ou fluxos de trabalho de revisão se beneficiam de cabeçalhos, links e listas. | Conteúdo legível com estrutura leve. | Ainda não é ideal para extração precisa do DOM. |
| HTML | Seletores, tabelas, atributos, links ou relacionamentos do DOM importam. | Marcação da página e pistas estruturais. | Requer análise e limpeza. |
| Texto renderizado | Conteúdo útil aparece apenas após a execução do JavaScript. | Conteúdo legível do estado da página renderizada pelo navegador. | Mais pesado do que texto do HTML de origem. |
| Captura de tela ou PDF | Humanos precisam de prova visual do que a página exibiu. | Aparência renderizada para QA ou registros de arquivo. | Mais difícil de consultar automaticamente. |
Se você precisar comparar todas as saídas suportadas, use o guia de formatos de resposta da API de web scraping. Para fluxos de trabalho pesados em estrutura, comece com a API de scraping HTML. Para pipelines de IA que ainda se beneficiam de cabeçalhos e links, compare texto com o caminho da API de scraping Markdown antes de definir o formato.
Como você sabe se uma URL pode retornar texto útil?
Comece com uma URL de amostra real e inspecione a resposta. A página pode conter conteúdo legível no HTML de origem, ou pode exigir renderização do navegador porque o texto importante aparece após a execução do JavaScript. Também pode redirecionar, retornar o local errado, incluir uma parede de consentimento ou produzir uma página de fallback curta que tecnicamente tem sucesso, mas é inútil para o pipeline de conteúdo.
Um bom fluxo de trabalho de URL para texto verifica a URL final, status, tipo de conteúdo, tamanho da resposta, HTML de origem, estado renderizado e uma pequena amostra do texto retornado. Se o texto estiver vazio, duplicado, dominado pela navegação ou faltando o conteúdo do corpo esperado, o perfil da solicitação precisa de ajuste antes do volume. Isso pode significar renderização, tempo de espera, cabeçalhos, cookies, sessões, direcionamento de país ou um formato de saída diferente.
Use o API Builder para essa primeira passagem. Teste a mesma URL como HTML de origem, HTML renderizado, texto e Markdown. Uma vez que a equipe possa ver qual resposta contém o conteúdo útil, a solicitação de produção se torna um contrato claro em vez de um palpite.
Onde a URL para texto se encaixa em fluxos de trabalho de IA, pesquisa e monitoramento?
A saída de texto é frequentemente o caminho mais rápido para sistemas que não precisam do layout da página. Pipelines de pesquisa podem indexar texto. Trabalhos de monitoramento podem comparar instantâneas de texto. Ferramentas internas podem classificar ou direcionar páginas. Fluxos de trabalho de IA podem resumir, pontuar ou enriquecer conteúdo quando a entrada já é legível e compacta.
Isso não significa que todo fluxo de trabalho de IA deva usar texto simples. Markdown pode ser melhor quando cabeçalhos, listas e links melhoram o contexto. HTML pode ser melhor quando o modelo ou analisador precisa entender a estrutura da tabela, cartões de produtos ou elementos repetidos. Capturas de tela podem ser úteis quando um humano precisa verificar como a página parecia no momento da captura.
ScraperFly oferece às equipes uma camada de captura para essas escolhas. Mantenha a URL, metadados de resposta, formato de saída, estado de renderização e qualquer prova visual anexada ao registro para que o sistema subsequente possa explicar de onde veio o texto e por que deve ser confiável.
Como as equipes podem manter os trabalhos de URL para texto leves?
A maioria dos trabalhos de URL para texto deve começar com a solicitação mais simples. Se o HTML de origem contiver o texto útil, não há razão para pagar pela execução do navegador, roteamento premium ou arquivos visuais em cada página. Adicione controles mais pesados apenas quando evidências mostrarem que a solicitação simples está incompleta ou instável.
Isso é especialmente importante para monitoramento recorrente, ingestão de IA e grandes filas de conteúdo. Uma pequena diferença no perfil da solicitação pode se multiplicar rapidamente em milhares de URLs. Comece grátis, teste alvos representativos e, em seguida, escolha créditos pay-as-you-go ou um plano de crédito mensal assim que o padrão recorrente estiver claro. Revise Preços e estime fluxos de trabalho mais pesados com o calculadora de custo de crédito da API de web scraping.
| Necessidade | Comece com | Adicione apenas quando | Mantenha previsível ao |
|---|---|---|---|
| Conteúdo estático legível | Texto do HTML de origem | O conteúdo esperado está faltando ou muito ruidoso. | Mantendo páginas simples no perfil mais leve. |
| Conteúdo gerado por JavaScript | Texto renderizado | O HTML de origem está incompleto ou é uma casca fina. | Ativando renderização por alvo, não globalmente. |
| Contexto de IA ou RAG | Textos ou amostras de Markdown | Cabeçalhos e links melhoram a qualidade da resposta. | Escolhendo Markdown apenas onde a estrutura ajuda. |
| Monitoramento de conteúdo | Texto mais metadados de resposta | URL final, status ou mudanças de tamanho afetam a confiança. | Armazenando evidências de captura com cada instantânea de texto. |
| QA humano | Texto mais capturas de tela selecionadas | Alguém deve verificar o estado visível da página. | Gerando arquivos visuais apenas para amostras importantes. |










