






ScraperFlyAPI de dados web pronta para IA

developer api

API de Parser de HTML para Texto para páginas web públicas

A saída de texto limpa é útil quando um fluxo de trabalho precisa de conteúdo de página legível sem ruído de marcação. ScraperFly pode capturar páginas públicas como conteúdo bruto ou renderizado e retornar texto para busca, QA, monitoramento, resumos, classificação e ingestão leve de IA.

Saída de texto limpa

Extraia texto legível da página sem carregar ruído de marcação

Muitos fluxos de trabalho de scraping não precisam do DOM completo. Eles precisam das partes legíveis de uma página pública: cópia de artigo, descrições de produtos, texto de políticas, detalhes de listagem, conteúdo de suporte ou notas de atualização que podem ser usadas em busca, QA, monitoramento, resumos ou classificação leve de IA.

ScraperFly ajuda as equipes a buscar a página pública, renderizá-la quando o JavaScript cria o conteúdo útil e retornar texto limpo como um formato de saída prático. Isso mantém fluxos de trabalho de conteúdo simples menores, enquanto preserva a opção de solicitar HTML, Markdown, metadados JSON, capturas de tela ou PDFs quando o trabalho precisa de mais estrutura ou prova.
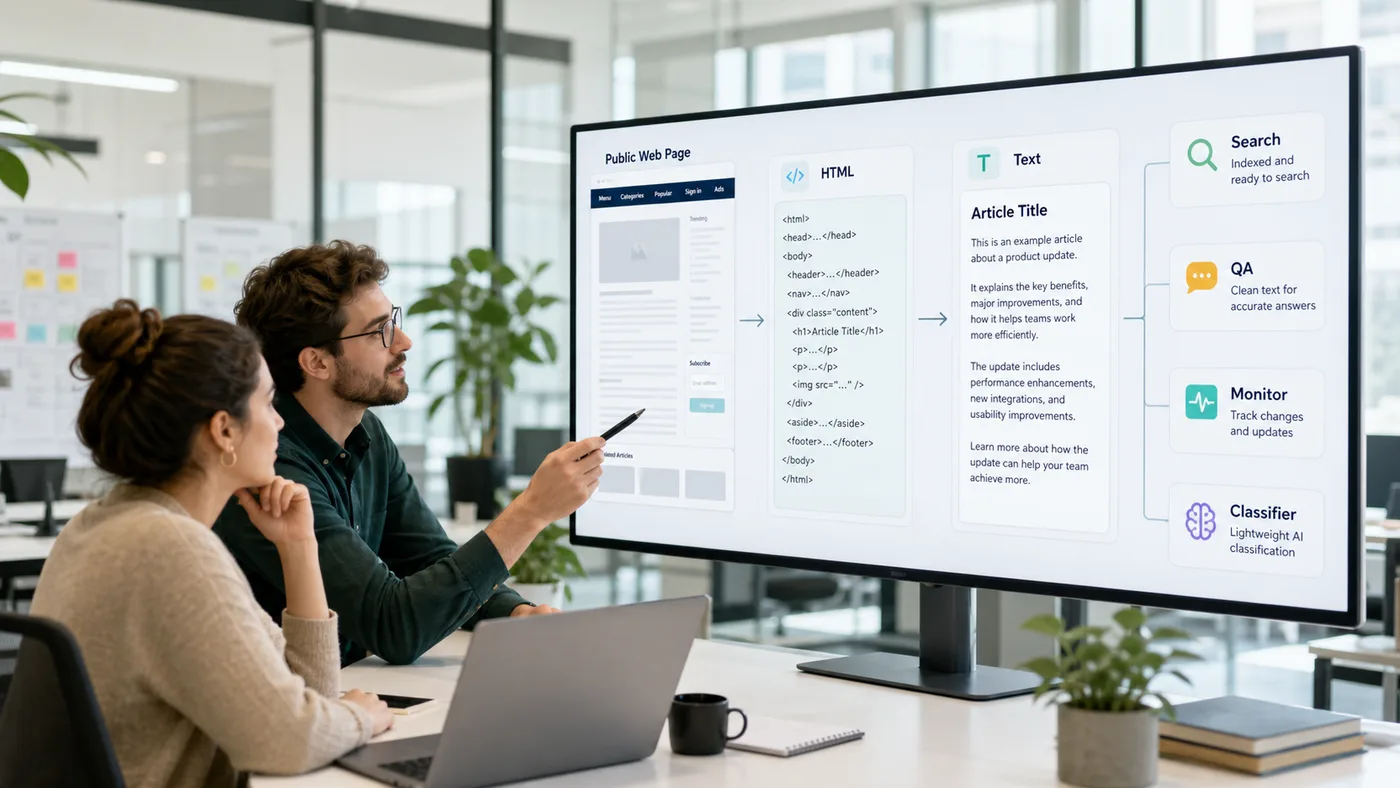
texto limpo índice de busca revisão de QA monitoramento
Equipe de produto convertendo HTML de página web pública em texto limpo para monitoramento de QA e classificação

O que é uma API de parser de HTML para texto?

Uma API de parser de HTML para texto busca uma página web pública e retorna texto simples legível em vez de marcação bruta. O objetivo não é preservar cada relação de DOM. O objetivo é remover código de layout, navegação repetida, scripts, atributos e andaimes visuais para que o conteúdo possa ser inspecionado, indexado, comparado, resumido ou roteado para sistemas posteriores.

A camada de captura ainda decide se o texto é útil. Se o alvo enviar conteúdo significativo no HTML de origem, a saída de texto pode permanecer leve. Se o conteúdo importante aparecer apenas após a execução do JavaScript do lado do navegador, a solicitação pode precisar de renderização antes da conversão de texto. ScraperFly mantém ambos os caminhos disponíveis através de uma única superfície de API.

Resumo prático: use a saída de texto quando o consumidor precisar de conteúdo legível, não da estrutura exata da página.

Quando o texto é melhor que HTML ou Markdown?

Texto é o formato útil mais simples quando um fluxo de trabalho se preocupa mais com palavras do que com estrutura. É uma boa opção para indexação de busca, monitoramento de mudanças, revisão de QA, classificação, detecção de duplicatas, resumos e pré-processamento leve de IA. Ele fornece ao aplicativo conteúdo compacto que é mais fácil de armazenar e comparar do que HTML bruto.

Texto não é ideal quando o fluxo de trabalho precisa de cabeçalhos, links, citações, listas, contexto de tabela ou extração específica de DOM. Nesses casos, Markdown ou HTML podem carregar uma estrutura mais útil. A melhor configuração de produção escolhe o formato de resposta do consumidor posterior em vez de tratar cada página como um scraping genérico.

Formato Melhor adequado para Principal vantagem Quando escolher outra saída
Texto Busca, monitoramento, QA, resumos, classificação, análise compacta. Pequeno, legível e fácil de comparar. Quando cabeçalhos, links ou relações de DOM importam.
Markdown RAG, documentação, revisão editorial, entrada de IA com estrutura legível. Preserva mais a forma do conteúdo do que texto simples. Quando o fluxo de trabalho precisa apenas de prosa compacta.
HTML Seletores, atributos, tabelas, links, inspeção de origem, parsing estruturado. Mantém a marcação da página disponível para regras de extração personalizadas. Quando a marcação bruta cria trabalho de limpeza desnecessário.
Metadados JSON Diagnósticos, registro, evidência de resposta, QA de solicitação. Explica status, URL final, tipo de conteúdo e contexto de captura. Quando o aplicativo precisa do corpo legível real.

Como a renderização de JavaScript afeta a extração de texto?

A conversão de texto só pode limpar o conteúdo que a solicitação captura. Se o HTML de origem já contém o texto útil, a renderização adiciona peso sem melhorar a saída. Se a página envia um shell de aplicativo e preenche o conteúdo visível após a hidratação, a captura renderizada pode tornar o texto final completo.

Um fluxo de trabalho disciplinado testa ambos os estados em alvos reais. Comece com a captura de origem, inspecione o texto e, em seguida, ative a renderização quando a cópia importante estiver faltando. Se o conteúdo chegar tarde, uma configuração de espera pode ser importante. Se a página mudar por idioma, cookie ou região, cabeçalhos, sessões ou roteamento de país podem afetar o texto capturado mais do que a própria renderização.

Para páginas que requerem execução do navegador, a API de renderização de JavaScript explica a decisão de renderização. Para comparar texto com HTML, Markdown, JSON, capturas de tela e PDFs, use o guia de formatos de resposta.

O que as equipes devem validar antes de escalar a extração de texto?

Texto limpo é fácil de consumir, o que torna texto ruim fácil de perder. Antes de agrupar um grande conjunto de URLs, valide se o conteúdo principal está presente, a navegação repetida foi reduzida, o idioma está correto, os redirecionamentos não mudaram a página e os avisos importantes ou detalhes de preço não desapareceram durante a limpeza.

A validação é especialmente importante para monitoramento e fluxos de trabalho de IA. Um classificador, índice de busca ou resumidor pode processar felizmente texto incompleto, a menos que o registro de captura explique o que aconteceu. Armazene a URL final, status, tipo de conteúdo, tamanho da resposta, configuração de renderização e formato de saída com cada resultado para que a equipe possa separar mudanças de alvo de erros de extração.

Verificação Por que isso importa Sinal útil
Corpo principal presente Busca, resumos e monitoramento precisam do conteúdo real, não apenas do texto de layout. Compare a saída de texto com amostras de origem ou renderizadas.
Nível de ruído Navegação e boilerplate repetido podem distorcer classificadores e resumos. Revise frases repetidas em várias URLs.
Idioma e região Os alvos podem variar a cópia por país, idioma, moeda ou estado de consentimento. Registre cabeçalhos, roteamento de país, URL final e amostras de conteúdo visível.
Tamanho da resposta Saída de texto muito pequena pode revelar redirecionamentos, bloqueios suaves ou estados renderizados vazios. Defina faixas de tamanho esperadas para cada tipo de alvo.
Adequação do formato Alguns fluxos de trabalho precisam de links, tabelas ou estrutura de citação. Mude para Markdown ou HTML quando texto simples remover contexto demais.

Onde a saída de texto se encaixa em fluxos de trabalho de produção?

A saída de texto é útil quando o resultado do scraping alimenta um sistema que lê, compara ou classifica conteúdo em vez de extrair campos DOM precisos. Um trabalho de monitoramento pode comparar instantâneas de texto. Um pipeline de busca pode indexar cópia legível. Um processo de QA pode inspecionar se uma página pública mudou. Um fluxo de trabalho leve de IA pode classificar ou resumir conteúdo sem carregar marcação no prompt.

ScraperFly mantém esse fluxo de trabalho prático porque a saída de texto é uma opção no mesmo modelo de solicitação. As equipes podem testar o alvo no API Builder, escolher a saída de texto, adicionar renderização apenas quando necessário e manter HTML ou capturas de tela disponíveis para depuração quando o texto sozinho não puder explicar o resultado.

Resumo prático: a saída de texto é mais forte quando remove trabalho de limpeza e deixa evidências suficientes para depurar conteúdo ausente.

Como a conversão de texto permanece acessível?

A conversão de HTML para texto pode permanecer leve quando a resposta de origem já contém o conteúdo. O custo aumenta quando um fluxo de trabalho adiciona renderização de navegador, tempo de espera, sessões, roteamento de país, entrega premium, capturas de tela, PDFs ou tentativas repetidas. O padrão eficiente é começar simples, inspecionar a saída e adicionar controles apenas quando melhorarem o texto capturado.

Isso torna a saída de texto uma boa opção para projetos irregulares e sistemas recorrentes. As equipes podem validar alguns alvos com créditos gratuitos, usar créditos pay-as-you-go para trabalho de limpeza ocasional e mover trabalhos de extração ou monitoramento previsíveis para créditos mensais quando o perfil de solicitação estiver comprovado. A página de preços explica como esse caminho escala sem forçar cada experimento em uma assinatura.


HTML para texto

Transforme HTML público em texto legível sem manter um limpador separado

A saída de texto ajuda as equipes a passar do acesso bruto à página para conteúdo utilizável mais rapidamente. Busque a página, renderize apenas quando necessário e retorne texto mais limpo para busca, monitoramento, resumos, QA e fluxos de trabalho leves de IA.

HTML
Entrada

Capture o HTML de origem ou renderizado primeiro

O resultado do texto depende de se o conteúdo útil existe no HTML de origem ou aparece após a renderização do JavaScript.

format=htmlrenderizar
TXT
Saída

Retorne texto legível para sistemas posteriores

Texto limpo é mais fácil de indexar, comparar, resumir, classificar ou monitorar do que marcação bruta cheia de navegação e código de layout.

format=texttexto limpo
FIT
Verificação de adequação

Amostre páginas reais antes de escalar a conversão

Algumas amostras de alvo revelam se a saída de texto inclui o conteúdo principal, perde seções de JavaScript ou precisa de um formato de resposta diferente.

exemplovalidarescalar

Controles que moldam a extração de texto

url

A página pública para buscar e limpar em texto.

format=text

O modo de saída para texto simples legível.

render

Renderização do navegador quando o HTML fonte não inclui o conteúdo útil.

headers

Contexto opcional quando o alvo altera a resposta por sinal do cliente.

exemplo de cURL

Gere Markdown com a mesma forma de solicitação que você pode mover para produção

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Ajuste de texto

Verifique se a página pode produzir texto útil antes de escalar a conversão

A extração de texto depende da qualidade da fonte. Marcação estática, conteúdo JavaScript, ruído de navegação, variantes de idioma, redirecionamentos e tamanho da resposta afetam se a saída é completa o suficiente para pesquisa, monitoramento, QA ou fluxos de trabalho de IA.

Resposta HTML bruta mapeada para dados visíveis da página
01

Disponibilidade de HTML bruto

Verifique se os campos que você precisa já estão presentes na primeira resposta HTML.

Melhor primeiro teste para páginas simples, artigos, documentos, listagens e detalhes de produtos.

Comparação antes e depois da renderização do JavaScript
02

Dependência de JavaScript

Compare HTML bruto com o DOM renderizado ou captura de tela antes de ativar a renderização do navegador.

Use renderização quando o HTML bruto é apenas uma casca e scripts criam o conteúdo útil.

Cookies, consentimento, sessão e contexto de acesso para scraping
03

Estado e contexto de acesso

Identifique se cookies, consentimento, limites de login, paginação ou o mesmo estado do visitante afetam a resposta.

Use sessões e cabeçalhos quando a continuidade muda os dados que você recebe.

Variações de conteúdo regional entre países e rotas
04

Variação geo/conteúdo

Teste se país, idioma, moeda, inventário, SERP, anúncios ou reputação da rota mudam o resultado.

Use roteamento geo ou premium apenas quando o alvo provar que a resposta varia por rota.

Verificações antes de converter HTML em texto

Onde está o campo alvo?

Verifique se o campo existe no HTML bruto, DOM renderizado, uma chamada de API, dados estruturados, um arquivo ou um estado de interação posterior.

O que muda na resposta?

Amostre algumas URLs e compare status, URL final, comprimento do conteúdo, redirecionamentos, estados vazios e diferenças nos resultados visíveis.

Qual contexto é necessário?

Marque qualquer dependência de consentimento, localidade, cookies, cabeçalhos, limite de autenticação, paginação, filtros ou solicitações anteriores.

Como é a falha?

Defina os sinais para respostas bloqueadas, parciais, obsoletas, redirecionadas, vazias, com tempo esgotado ou com região incompatível antes de escalar.

Como o comportamento do alvo altera a saída de texto

Modo de busca

A disponibilidade de HTML bruto decide se a primeira solicitação pode permanecer simples ou precisa de renderização, esperas, capturas de tela ou extração.

Contexto da solicitação

Os requisitos de estado decidem se é necessário adicionar cabeçalhos, cookies, sessões, manuseio de consentimento ou um perfil de visitante estável.

Escolha de roteamento

Descobertas geográficas e de reputação decidem se o roteamento padrão é suficiente ou se uma rota de país/premium é justificada.

Regras de validação

Estados de falha conhecidos se tornam verificações para novas tentativas, escalonamento, revisão de QA e decisão de quando um perfil mais leve ainda está completo.

Limpeza eficiente

Use a solicitação mais leve que retorne texto utilizável

A conversão de HTML para texto geralmente é eficiente quando o HTML bruto contém o conteúdo. Renderização, roteamento, sessões, esperas, capturas de tela, PDFs ou cabeçalhos são atualizações úteis apenas quando melhoram o texto final.

Um pedido HTML leve retornando uma resposta simples
01

Fetch básico

Use um fetch básico quando o HTML público já contém os campos que você precisa.

Perfil de pedido mais leve; mantenha-o quando a resposta estiver completa.

Renderização JavaScript produzindo um DOM completo
02

Renderização

Use renderização quando o HTML bruto é uma casca e o JavaScript completa a página.

Perfil mais pesado; use-o apenas quando a saída do navegador alterar o resultado.

Várias solicitações preservando cookies e estado do visitante
03

Sessão com estado

Use sessões quando cookies, consentimento, local ou paginação alterarem a resposta.

Perfil de estado mais pesado; preserve-o apenas quando a continuidade for importante.

Roteamento de solicitações através de rotas geográficas e de maior qualidade
04

Roteamento e geo premium

Use roteamento premium ou geográfico apenas quando a origem, país, reputação ou conteúdo regional alterarem o resultado.

Perfil de roteamento mais pesado; aplique-o apenas a alvos que provem que precisam.

O que pode tornar a conversão de texto mais pesada

Mais trabalho de infraestrutura

Renderização de navegador, escolhas de roteamento e esperas mais longas significam que a plataforma precisa fazer mais do que retornar uma simples resposta.

Mais incerteza no alvo

Redirecionamentos, estados vazios, limites de taxa e páginas de desafio frequentemente requerem opções de entrega mais robustas ou tentativas novamente.

Mais estado a preservar

Cookies, sessões, consentimento e fluxos de múltiplas páginas adicionam partes móveis que um fetch sem estado simples não possui.

Mais evidências a retornar

Capturas de tela, PDFs, saída renderizada e artefatos de resposta mais ricos são úteis, mas são mais pesados do que HTML simples.

Como manter a extração de texto previsível

Amostre antes de escalar

Teste um pequeno conjunto de URLs primeiro e agrupe alvos pelo perfil mais leve que retorna dados completos.

Não renderize por padrão

Inspecione o HTML bruto antes de ativar a renderização. Muitas páginas públicas já contêm os dados que você precisa.

Escalone com base em evidências

Suba apenas quando a resposta mostrar conteúdo ausente, dependência de estado, variação geográfica ou problemas de roteamento.

Meça resultados úteis

Otimize em torno de registros válidos entregues, não no volume bruto de solicitações. Um perfil mais leve é melhor apenas quando permanece completo.

PERGUNTAS FREQUENTES SOBRE SAÍDA DE TEXTO

Perguntas comuns sobre fluxos de trabalho de raspagem de HTML para texto

Respostas práticas para equipes decidindo quando o texto simples é o formato de resposta certo, quando a renderização é necessária e quando HTML, Markdown, metadados ou prova visual são uma melhor opção.

Respostas rápidas
FORMAT

Escolhendo texto

Quando o texto é melhor que HTML?

Texto é melhor quando o fluxo de trabalho precisa de conteúdo legível para busca, revisão, monitoramento, resumos ou classificação em vez de relacionamentos DOM.

Quando o Markdown é melhor que o texto?

Markdown é melhor quando cabeçalhos, links, listas e estrutura de seção legível devem permanecer visíveis.

CAPTURE

Fonte e renderização

A saída de texto precisa de renderização?

Apenas quando conteúdo útil aparece após a execução do JavaScript. Comece com a captura da fonte e renderize quando o texto estiver incompleto.

Os cabeçalhos ou sessões podem afetar o texto?

Sim. Algumas páginas públicas mudam o conteúdo por idioma, estado de cookie, referenciador ou continuidade de sessão.

QUALITY

Validação

Como sei se o texto está completo?

Revise o conteúdo principal, URL final, status, tamanho da resposta, idioma, navegação repetida e algumas amostras de origem ou renderizadas.

E se o contexto importante desaparecer?

Mude para Markdown quando a estrutura legível importa, ou HTML quando o DOM exato e os atributos importam.

COST

Execuções eficientes

Como evito solicitações de texto pesadas?

Use captura bruta quando retornar texto completo, depois adicione renderização, esperas, sessões ou roteamento apenas quando melhorarem a saída.

Posso manter capturas de tela ou PDFs também?

Sim. Use-os quando o texto precisar de prova visual, evidência de QA, registros de arquivo ou revisão de conformidade.





