






SAÍDA MARKDOWN
Transforme páginas públicas em Markdown que seu pipeline pode realmente ler
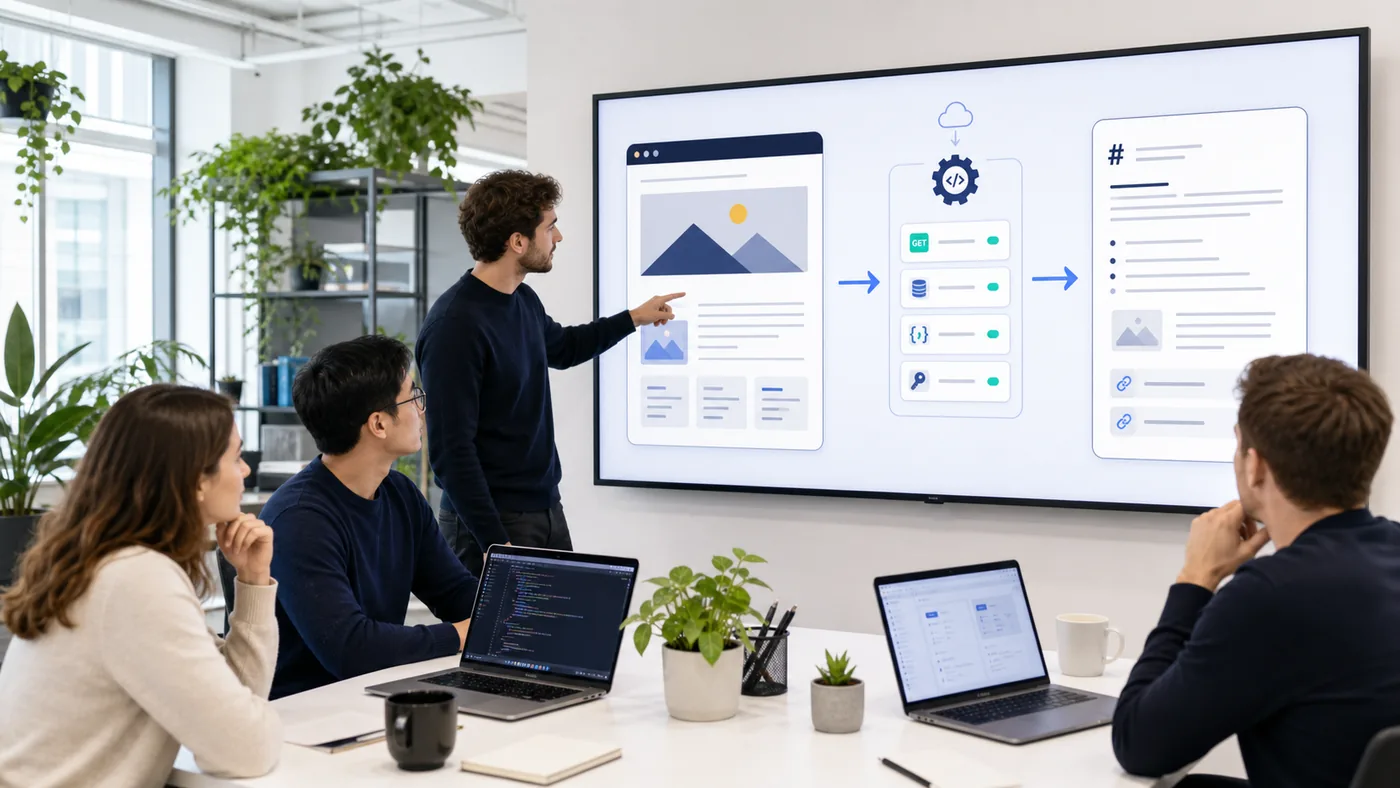
ScraperFly oferece às equipes um caminho prático de uma URL pública para Markdown limpo. Em vez de enviar a marcação bruta da página para um prompt de IA, ferramenta de documentação, fila de revisão de conteúdo ou índice de busca, seu aplicativo pode solicitar uma resposta que mantenha títulos, parágrafos, listas e links úteis em uma forma legível.
A parte importante é o controle. Comece com um pedido leve, inspecione o que o alvo retorna e, em seguida, habilite a renderização do navegador, esperas, sessões, cabeçalhos, segmentação por país ou roteamento mais forte apenas quando esses controles melhorarem o Markdown que seu fluxo de trabalho recebe.
O que é uma API de página da web para Markdown?
Uma API de página da web para Markdown busca uma URL pública e retorna o conteúdo da página capturada como Markdown. A resposta é destinada a sistemas que precisam de conteúdo legível em vez de infraestrutura de navegador: ingestão RAG, agentes de IA, busca interna, revisão editorial, importações de documentação, notas de monitoramento e análise de conteúdo leve.
Markdown é útil porque fica entre HTML bruto e texto simples. Ele pode preservar títulos, fluxo de parágrafo, listas e links sem forçar cada consumidor subsequente a entender a aninhamento DOM, navegação repetida, atributos, scripts, estilos ou ruído de modelo.
Isso não é o mesmo que prometer extração perfeita de artigos ou extração de esquema personalizado. Uma resposta Markdown deve ser tratada como um formato de conteúdo limpo. Se seu produto precisa de campos de produto exatos, linhas de crédito, datas, preços, classificações ou estrutura em nível de seletor, valide esses campos separadamente ou mantenha HTML e metadados disponíveis para o analisador.
Resumo prático: use página para Markdown quando o consumidor precisa de conteúdo de página legível, não de evidência exata do DOM.
Quando as equipes devem usar Markdown em vez de HTML ou texto?
Markdown é mais forte quando o conteúdo da página será lido, dividido, resumido, revisado, indexado ou passado para um fluxo de trabalho de modelo de linguagem. Ele dá ao sistema receptor mais estrutura do que texto simples, mas menos ruído do que HTML bruto.
HTML ainda é a melhor opção quando seletores, atributos, tabelas aninhadas, links exatos ou relacionamentos DOM importam. Texto simples é melhor quando o fluxo de trabalho precisa apenas de cópia legível compacta. Metadados JSON ajudam com diagnósticos de solicitação. Capturas de tela e PDFs ajudam quando o estado visual é a prova.
| Fluxo de trabalho | Por que Markdown ajuda | Quando outro formato é melhor |
|---|---|---|
| Ingestão RAG e IA | Mantém títulos, listas, links e seções legíveis para uma divisão mais limpa. | Use HTML quando a extração depender de seletores ou atributos ocultos. |
| Revisão editorial | Torna o conteúdo da página pública mais fácil para os humanos escanearem e anotarem. | Use captura de tela ou PDF quando layout e prova visual importam. |
| Importação de documentação | Muda seções da página para um formato que ferramentas de documentação podem lidar naturalmente. | Use texto quando apenas cópia simples for necessária. |
| Indexação de busca | Preserva estrutura útil sem adicionar boilerplate HTML ao índice. | Use metadados JSON para rastrear URL final, status, tipo de conteúdo e contexto da solicitação. |
| Notas de monitoramento | Captura mudanças legíveis na página sem armazenar um artefato renderizado completo toda vez. | Use capturas de tela para regressões visuais, layouts quebrados ou evidências de aprovação. |
Resumo prático: escolha Markdown quando a estrutura ajuda o leitor ou modelo, e mantenha HTML ou formatos visuais quando a prova precisa ser exata.
Como a renderização muda a saída Markdown?
Um conversor Markdown só pode trabalhar com o conteúdo que a solicitação captura. Muitas páginas públicas enviam conteúdo útil na primeira resposta HTML. Essas páginas devem permanecer simples: busque a URL, solicite Markdown e evite a execução do navegador, a menos que a saída prove que algo está faltando.
Outras páginas enviam uma estrutura HTML fina e constroem o conteúdo útil após a execução do JavaScript. Nesse caso, a renderização JavaScript pode capturar o estado da página renderizada antes que a resposta seja convertida em Markdown. Isso torna o Markdown mais completo, mas também torna a solicitação mais pesada, então a renderização deve ser uma decisão baseada em evidências.
Evidências úteis incluem o HTML de origem, HTML renderizado, URL final, tamanho da resposta, código de status, estado da captura de tela e alguns exemplos representativos do alvo. Se o Markdown já estiver completo a partir da captura de origem, mantenha o perfil leve. Se seções importantes aparecerem apenas após a execução do navegador, renderize esse padrão de URL intencionalmente.
Resumo prático: renderize para a completude do Markdown, não porque a renderização está disponível.
Como a página para Markdown é diferente de um analisador HTML para Markdown?
A frase API de analisador HTML para Markdown geralmente começa com HTML capturado e foca na conversão. Uma API de página da web para Markdown começa mais cedo no fluxo de trabalho: aceita uma URL pública, busca a página, lida com controles de solicitação e, em seguida, retorna Markdown como o formato de resposta escolhido.
Essa diferença importa na produção. A captura de página pode envolver redirecionamentos, cabeçalhos, cookies, sessões, segmentação por país, tempos de espera, roteamento por proxy, renderização JavaScript, verificações de tipo de conteúdo e limites de tamanho de resposta. Um conversor sozinho não resolve essas questões de entrega. ScraperFly permite que o mesmo modelo de solicitação passe de captura de origem simples para um estado de página mais completo quando o alvo prova que é necessário.
Se sua equipe já tem HTML confiável e só precisa de conversão, um fluxo de trabalho focado em analisadores pode ser suficiente. Se o problema começa com a entrega de URL pública e continua em conteúdo legível, a página para Markdown é o modelo mental mais completo.
O que as equipes devem verificar antes de escalar a captura de Markdown?
Uma boa saída Markdown não é apenas uma questão de formatação. Depende da página alvo, do estado da resposta, do conteúdo que seu sistema downstream espera e da quantidade de ruído que a página adiciona em torno das seções úteis.
- URL final e status. Redirecionamentos, erros suaves, páginas de consentimento ou páginas de desafio podem produzir Markdown legível que ainda é o conteúdo errado.
- Conteúdo de origem versus renderizado. Compare a captura bruta com a captura renderizada antes de tornar a execução do navegador o padrão.
- Estrutura de títulos. Verifique se os títulos refletem o conteúdo útil ou repetem principalmente seções de navegação e modelo.
- Links e listas. Certifique-se de que links importantes, itens de lista e limites de seção sobrevivam à conversão em uma forma que seu aplicativo possa usar.
- Boilerplate repetido. Navegação, rodapés, banners de cookies, recomendações e anúncios ainda podem aparecer em Markdown e devem ser tratados antes da indexação.
- Tabelas e layouts complexos. Markdown pode simplificar estruturas complexas. Mantenha HTML disponível quando a forma da tabela ou relacionamentos DOM exatos importarem.
Essas verificações mantêm a saída honesta. Elas também evitam que uma equipe trate o Markdown como uma camada mágica de limpeza quando o verdadeiro problema é entrega, renderização, seleção de alvo ou um requisito de extração downstream.
Como as equipes devem escolher entre Markdown e outros formatos do ScraperFly?
A abordagem mais segura é testar o mesmo alvo através de vários formatos de resposta no API Builder. Use Markdown para estrutura legível, texto para cópia compacta, HTML para controle de analisador, metadados JSON para diagnósticos, capturas de tela para QA visual e PDFs para registros portáteis.
| Formato | Melhor ajuste | Regra de decisão |
|---|---|---|
| Markdown | IA, RAG, docs, revisão e fluxos de trabalho de conteúdo legível. | Use-o quando títulos, links e fluxo de seção melhorarem a experiência do consumidor. |
| HTML | Seletores, análise DOM, atributos, tabelas e relacionamentos de origem exatos. | Use-o quando o analisador precisar de precisão estrutural. |
| Texto | Busca leve, resumos e processamento de linguagem simples. | Use-o quando a estrutura não for necessária. |
| Metadados JSON | Registro, verificações de status, URL final, tipo de conteúdo e diagnósticos de solicitação. | Use-o ao lado de formatos de conteúdo para facilitar o diagnóstico da solicitação. |
| Captura de tela ou PDF | Prova visual, QA, arquivo, conformidade ou revisão humana. | Use arquivos visuais quando a aparência importar mais do que texto legível por máquina. |
Para uma comparação mais ampla de formatos, revise o guia de formatos de resposta da API de web scraping. Para fluxos de trabalho específicos de IA, conecte decisões de Markdown com a página Scraping API para RAG e valide se seu pipeline de conteúdo precisa de Markdown, texto, HTML, metadados ou uma mistura.
Resumo prático: não padronize um formato muito cedo; teste o alvo e escolha a resposta que seu produto pode usar imediatamente.
Como o ScraperFly pode manter os fluxos de trabalho Markdown previsíveis?
ScraperFly é útil quando a conversão de Markdown faz parte de um fluxo de trabalho maior de dados da web pública. A API pode manter páginas simples leves, adicionar renderização quando o JavaScript cria conteúdo útil, preservar o contexto da solicitação com cabeçalhos e sessões, roteamento através de entrega específica de país ou mais forte quando necessário, e retornar formatos alternativos quando Markdown não é suficiente.
Essa flexibilidade importa tanto para custo quanto para qualidade. Uma página que converte limpidamente a partir do HTML de origem não deve carregar o mesmo perfil de solicitação que uma página renderizada que precisa de esperas, continuidade de sessão ou prova visual. Conecte a decisão de saída ao peso da solicitação e use preços apenas depois que o comportamento do alvo estiver claro.
Se o objetivo é extração de conteúdo em vez de formatação Markdown, compare esta página com a API de analisador de conteúdo da web. Se o objetivo é um artefato portátil, use as páginas PDF ou de captura de tela. O melhor fluxo de trabalho de página para Markdown é específico o suficiente para ser útil e flexível o suficiente para evitar infraestrutura desnecessária.



