






Рабочий процесс на стороне сервера
Сосредоточьтесь на оркестрации с Node.js, пока ScraperFly обрабатывает захват
Node.js — это естественное место для серверных задач, очередей, маршрутов API, агентов, панелей управления и событийно-ориентированных рабочих процессов. Он не должен превращаться в пользовательскую платформу браузера, прежде чем ваша команда узнает, подходит ли ответ публичной страницы.
ScraperFly предоставляет Node.js сервисам чистый уровень захвата: получите публичный URL, выберите HTML, текст, Markdown, метаданные JSON, скриншот или PDF, и добавьте рендеринг, сессии, заголовки, маршрутизацию по странам, ожидания или более сильную доставку только тогда, когда цель докажет, что эти параметры улучшают результат.
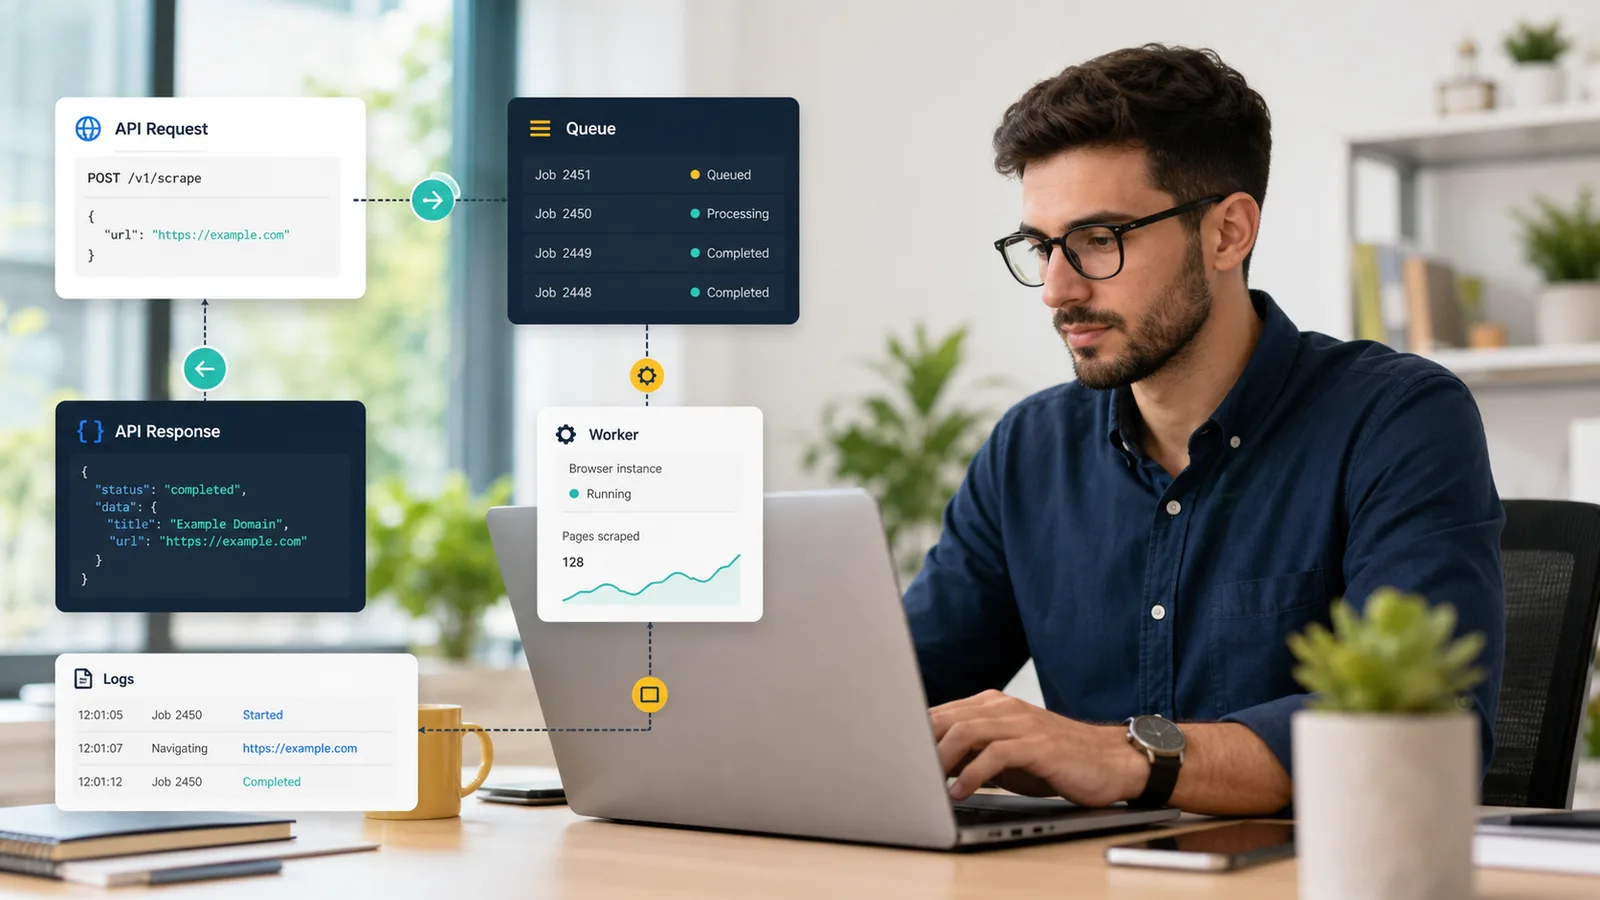
Как работает API веб-скрапинга на Node.js?
Рабочий процесс API веб-скрапинга на Node.js отправляет публичный целевой URL и параметры запроса из серверного сервиса в размещенный уровень захвата. API получает страницу, применяет рендеринг или маршрутизацию по мере необходимости и возвращает ответ, который ваше приложение на Node.js может обработать. Ваш код остается ответственным за парсинг, валидацию, поведение очереди, хранение, оповещения и логику продукта.
Эта граница упрощает обслуживание сервера. Вместо смешивания автоматизации браузера, обработки прокси, повторных попыток, преобразования ответов и извлечения полей в одном сервисе, приложение на Node.js может вызывать один интерфейс запроса и оставлять остальную часть конвейера явной. Работник может захватить страницу, проверить статус и метаданные, разобрать необходимые поля и отправить результат в базу данных или систему downstream.
Практическое замечание: используйте ScraperFly для надежного захвата публичных страниц и позвольте Node.js управлять специфическим для приложения рабочим процессом вокруг ответа.
Что должно доказать первое обращение к веб-скрапингу на Node.js?
Первый запрос должен доказать целевую страницу и формат ответа, прежде чем код станет повторно используемым. Отправьте один представительный URL, держите профиль запроса легким и проверьте результат. Проверьте окончательный URL, статус, тип контента, размер ответа, тело и наличие полей, необходимых вашему парсеру. Если исходный HTML уже содержит полезный контент, сервер может оставаться простым. Если страница является оболочкой приложения или отсутствуют важные поля, сравните отрендеренный вывод, прежде чем превращать каждую задачу в запрос браузера.
Это важно, потому что команды Node.js часто быстро переходят от успешного теста к очереди или работнику. Если первый запрос перегружен рендерингом, премиум маршрутизацией, долгими ожиданиями или визуальным выводом, этот дорогой профиль может стать стандартным, прежде чем кто-либо узнает, какой вариант действительно имел значение. Лучший рабочий процесс доказывает один тип страницы за раз и связывает каждый контроль с доказательствами.
| Проверка на стороне сервера | Что это доказывает | Что должно делать задание Node.js дальше |
|---|---|---|
| Исходный ответ | Содержит ли сырой HTML полезные поля | Держите задание легким, когда захват исходника достаточно. |
| Отрендеренный ответ | Изменяет ли JavaScript контент | Включите рендеринг только для шаблонов, которые требуют выполнения в браузере. |
| Метаданные ответа | Статус, окончательный URL, тип контента, размер и доказательства запроса | Сохраните это с журналами заданий перед парсингом или повторной попыткой. |
| Формат вывода | Нужен ли downstream потребителю разметка, читаемый контент, метаданные или визуальное доказательство | Выберите форму ответа перед созданием конвертеров. |
| Тип ошибки | Является ли проблема вводом, авторизацией, поведением цели, ограничением по скорости, сетью или рендерингом | Исправьте конфигурацию, повторите с задержкой или эскалируйте намеренно. |
Какой формат ответа должен запрашивать Node.js?
Лучший формат — это тот, который ваш сервер может использовать без дополнительной очистки. HTML полезен, когда парсеру нужна структура DOM, ссылки, атрибуты, таблицы или встроенные метаданные. Отрендеренный HTML полезен, когда выполнение в браузере создает окончательный DOM. Текст и Markdown лучше, когда рабочий процесс требует читаемого контента для поиска, резюме, контекста агента, RAG-поглощения или обзора контента. Метаданные JSON полезны для журналов и операционных решений. Скриншоты и PDF лучше для QA, одобрений, мониторинга, архивов или визуальных доказательств.
Не выбирайте HTML повсюду только потому, что он знаком. Сервис на Node.js, который подает LLM, может извлечь выгоду из Markdown. Работник мониторинга может нуждаться в метаданных плюс скриншоте. Парсер может нуждаться в сыром HTML для селекторов. Архив соответствия может нуждаться в PDF-выводе. Тестируйте форму ответа на раннем этапе, чтобы сервис не наращивал уровень конвертера, который API может избежать.
Для более глубокого решения формата используйте руководство по форматам ответов API веб-скрапинга перед жестким кодированием вашей модели сервера.
| Потребитель Node.js | Формат для тестирования | Почему это подходит | На что обратить внимание |
|---|---|---|---|
| Сервис парсера | HTML или отрендеренный HTML | Сохраняет селекторы, ссылки, атрибуты и отношения DOM | Требует специфического для цели извлечения и валидации. |
| Работник поиска или ИИ | Текст или Markdown | Чистый читаемый контент с меньшим шумом в макете | Может не сохранить достаточно структуры для точного извлечения полей. |
| Мониторинг очереди | Метаданные JSON | Делает статус, окончательный URL, размер ответа и тип контента видимыми | Не заменяет парсинг целевых данных. |
| QA или одобрения | Скриншот | Показывает, как выглядела отрендеренная публичная страница | Тяжелее, чем машинно-читаемый вывод. |
| Архив или запись обзора | Создает переносимый визуальный документ | Менее удобно для автоматического парсинга. |
Когда сервис на Node.js должен включать рендеринг, сессии, заголовки или маршрутизацию?
Включайте параметры, когда доказательства цели показывают реальную необходимость. Используйте рендеринг JavaScript, когда исходный HTML неполный и полезный контент появляется после выполнения в браузере. Используйте заголовки, когда публичная цель ожидает законный контекст запроса, такой как язык, принятый тип контента или поведение реферера. Используйте сессии, когда связанные запросы зависят от общих куки или состояния. Используйте маршрутизацию по странам, когда публичный контент меняется в зависимости от региона, валюты, языка, доступности или поведения перенаправления. Используйте более сильную маршрутизацию, когда повторные образцы показывают, что простой путь не может получить пригодный ответ.
Эти параметры не должны существовать как молчаливые значения по умолчанию в общем помощнике. Серверная очередь может обрабатывать множество типов страниц, и не все из них заслуживают одного и того же профиля запроса. Держите профили явными: статические страницы, страницы с тяжелым JavaScript, региональные страницы, состояния потока и задания с визуальными доказательствами должны быть достаточно отдельными, чтобы стоимость и сбои оставались понятными.
Для страниц, созданных браузером, ознакомьтесь с API рендеринга JavaScript. Для общего состояния используйте API сессий. Для контекста запроса смотрите пользовательские заголовки. Для решений по пути доставки сравните страницу API веб-скрапинга с ротацией прокси.
Как работники Node.js должны обрабатывать сбои при скрапинге?
Работники Node.js нуждаются в сбоях, на которые можно действовать. Неправильный URL, недействительный ключ, неподдерживаемый формат или несовместимый параметр файла должны остановить задание и указать на конфигурацию. Тайм-аут, ограничение по скорости, ошибка 5xx на стороне сервера, проблема с подключением, неожиданное перенаправление, тонкая HTML-оболочка или тайм-аут рендеринга должны быть зафиксированы с профилем запроса и обработаны с ограниченной повторной попыткой или другим тестом захвата. Рассматривайте каждый сбой как доказательство, а не просто как строку исключения.
Это особенно важно в очередях. Один плохой профиль может умножиться на сотни заданий, если логика повторной попытки слишком широка. Сохраняйте метаданные ответа рядом с каждым результатом задания: статус, окончательный URL, тип контента, размер ответа, формат вывода, выбор рендеринга, выбор маршрутизации, время ожидания и количество повторных попыток. Когда сбои группируются по типу цели, команда может исправить профиль, а не гадать внутри кода приложения.
Раздел по обработке ошибок, который можно повторно использовать, расширяет эти группы, но правило для сервера простое: остановите ошибки конфигурации, осторожно повторяйте временные сбои и эскалируйте только тогда, когда повторные образцы оправдывают более тяжелый запрос.
Как очереди веб-скрапинга на Node.js могут оставаться предсказуемыми?
Предсказуемые очереди начинаются с классификации страниц. Отделите простые HTML-задания от отрендеренных страниц, потоков, зависящих от сессий, региональных целей, случаев премиум маршрутизации, захватов скриншотов и архивов PDF. Каждый класс должен иметь свой собственный профиль запроса, ожидания параллелизма, поведение повторной попытки и ведение журнала. Это позволяет небольшому скрапу не наследовать стоимость самого тяжелого целевого объекта в системе.
Модель кредитов ScraperFly поддерживает такой стиль работы, потому что команды могут тестировать небольшие объемы, держать неравномерные проекты на кредитах по мере использования и переводить повторяющиеся рабочие нагрузки на месячные кредиты, когда объем становится ясным. Важный шаг — знать, какие профили ваши реальные цели требуют, прежде чем увеличивать параллелизм.
Используйте цены после тестирования реальных URL, а не до. Правильная оценка зависит от того, являются ли ваши задания в основном сырым HTML, отрендеренным HTML, потоками на основе сессий, премиум маршрутами, визуальными файлами или их смесью.
Что должно принадлежать Node.js после захвата?
Node.js должен управлять рабочим процессом, уникальным для вашего продукта: очередями, работниками, повторными попытками, модулями парсера, правилами валидации, дедупликацией, хранением, вебхуками, оповещениями, панелями управления и интеграциями downstream. ScraperFly должен управлять уровнем захвата публичных страниц: доставка запросов, рендеринг по мере необходимости, сессии, заголовки, маршрутизация, форматы ответов, скриншоты, PDF и доказательства ответов.
Эта граница дает серверу стабильный контракт. Если парсинг ломается, проверьте захваченный ответ и обновите селекторы. Если захват ломается, отрегулируйте профиль запроса. Если очередь растет, настройте параллелизм и классы заданий, не переписывая инфраструктуру браузера. Сервис остается скучным в лучшем смысле: четкие входные данные, четкие выходные данные и меньше скрытых движущихся частей.
С чего должна начать команда Node.js?
Начните с одной реальной публичной цели в API Builder или cURL, затем перенесите проверенный запрос в Node.js. Сначала протестируйте сырой HTML, сравните отрендеренный вывод, когда контент отсутствует, выберите формат ответа, который может использовать ваш сервер, и запишите достаточно метаданных, чтобы объяснить будущие сбои.
После того как первый тип страницы будет работать, добавляйте партии целенаправленно. Держите профили запросов видимыми в коде, избегайте одного глобального "тяжелого скрапа" помощника и позвольте очереди масштабироваться вокруг доказательств из реальных ответов.












