






Основной уровень API
Создайте профиль запроса, прежде чем ваш продукт будет зависеть от данных
API для веб-скрапинга предоставляет вашему продукту надежный способ получения публичных веб-страниц, проверки ответа и возврата полезного вывода без необходимости владеть всеми движущими частями инфраструктуры скрапинга. Ваша команда отправляет целевой URL и четкий профиль запроса. ScraperFly обрабатывает уровень захвата, а затем возвращает HTML, текст, Markdown, метаданные JSON, скриншоты или PDF в формате, который может использовать ваш рабочий процесс.
Практическое преимущество заключается в контроле. Простая страница должна оставаться легким HTML-запросом. Страницу на JavaScript можно отобразить, когда полезный контент отсутствует в исходном HTML. Сложная цель может добавить сессии, заголовки, маршрутизацию по странам или премиум-доставку после того, как ответ подтвердит, что эти элементы необходимы. Этот путь позволяет сделать тестирование дешевле, поведение в производстве легче объяснить, а время инженеров сосредоточить на продукте, а не на обслуживании браузеров и прокси.
Что на самом деле заменяет API для веб-скрапинга?
API для веб-скрапинга заменяет инфраструктуру захвата вокруг получения публичных страниц. Без него команде часто приходится поддерживать HTTP-клиентов, браузерных работников, пулы прокси, логику повторных попыток, правила таймаута, пересылку заголовков, состояние сессий, конвертеры вывода, захват скриншотов, генерацию PDF, логи и мониторинг для каждой цели. Эта работа может быть полезной для очень специализированной платформы, но редко является основной ценностью продукта, которому нужны данные.
ScraperFly перемещает этот операционный уровень за одну поверхность API. Приложение по-прежнему владеет тем, что имеет значение на нижнем уровне: выбор целей, парсинг полей, проверка качества данных, хранение записей, сравнение изменений, генерация оповещений или подача в системы ИИ и аналитики. ScraperFly сосредотачивается на получении ответа с публичной страницы в надежном формате, чтобы следующая система начинала с доказательства, а не с хрупкого самодельного запроса.
Практическое резюме: используйте API для веб-скрапинга, когда вашему продукту нужны доказательства публичной страницы, а не еще одна внутренняя платформа для работы с браузером, прокси, повторными попытками и конвертацией.
Как должен быть построен первый запрос?
Первый запрос должен быть намеренно скучным. Отправьте публичный URL, запросите наименьший полезный вывод и проверьте результат. Если исходный HTML содержит контент, необходимый вашему парсеру, оставьте запрос простым. Если страница возвращает только тонкую оболочку приложения, пустую разметку или контент, который появляется после выполнения JavaScript на фронтенде, включите рендеринг для этой цели. Если ответ меняется в зависимости от языка, состояния согласия, местоположения или предыдущих шагов, то оцените заголовки, куки, сессии или маршрутизацию по странам.
Это та же логика, которая отражена в блоке построителя запросов на странице ниже: создайте один надежный запрос, затем добавляйте элементы управления только тогда, когда цель докажет, что они необходимы. Суть не в том, чтобы скрыть продвинутые функции. Суть в том, чтобы каждую функцию прикрепить к причине. Рендеринг решает проблемы, созданные браузером. Сессии сохраняют состояние между связанными запросами. Заголовки несут законный контекст запроса. Премиум или маршрутизация по странам помогают, когда доказательства доставки показывают, что стандартный путь недостаточен. Скриншоты и PDF создают визуальные доказательства, когда машинно-читаемый вывод сам по себе не может рассказать полную историю.
| Решение по запросу | Начать с | Добавить больше, когда | Почему это важно |
|---|---|---|---|
| Основной захват публичной страницы | URL плюс HTML-вывод | Исходный HTML неполный или непригодный | Держит первый тест быстрым, дешевым и легким для отладки. |
| Контент, созданный на JavaScript | Сравнение необработанного HTML | Браузер изменяет полезный контент | Рендеринг становится контролем на основе доказательств, а не стандартным налогом. |
| Состояние или региональные страницы | Простой запрос с метаданными ответа | Язык, куки, состояние маршрута или местоположение изменяют ответ | Сессии, заголовки и маршрутизация остаются связанными с поведением цели. |
| Рабочие процессы проверки, QA или архивации | Машинно-читаемый вывод | Кому-то нужно доказательство того, как выглядела страница | Скриншоты и PDF дополняют парсируемые данные, а не заменяют их. |
Какой формат ответа должен возвращать API?
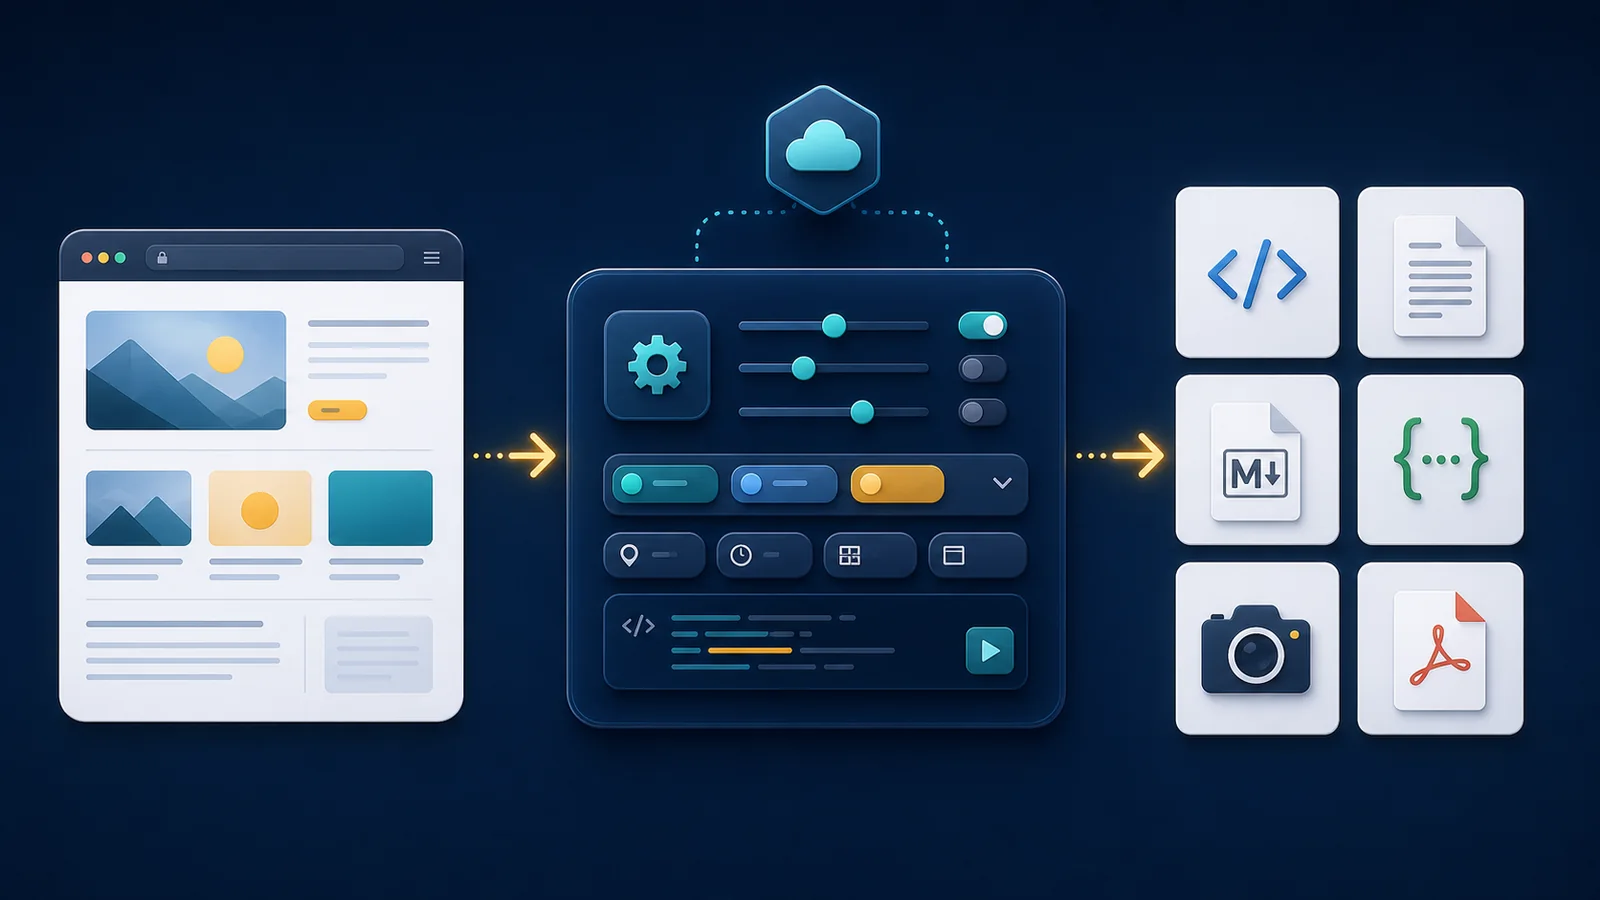
Лучший формат ответа — это тот, который ваша следующая система может использовать с наименьшими затратами на очистку. HTML подходит, когда важны селекторы, таблицы, ссылки, атрибуты или отношения DOM. Отрендеренный HTML полезен, когда JavaScript на фронтенде создает разметку, необходимую вашему парсеру. Текст легче, когда рабочий процесс нуждается только в читаемом контенте страницы. Markdown помогает ИИ, RAG, суммированию, документации и рабочим процессам проверки, потому что заголовки и ссылки остаются более понятными, чем простой текст.
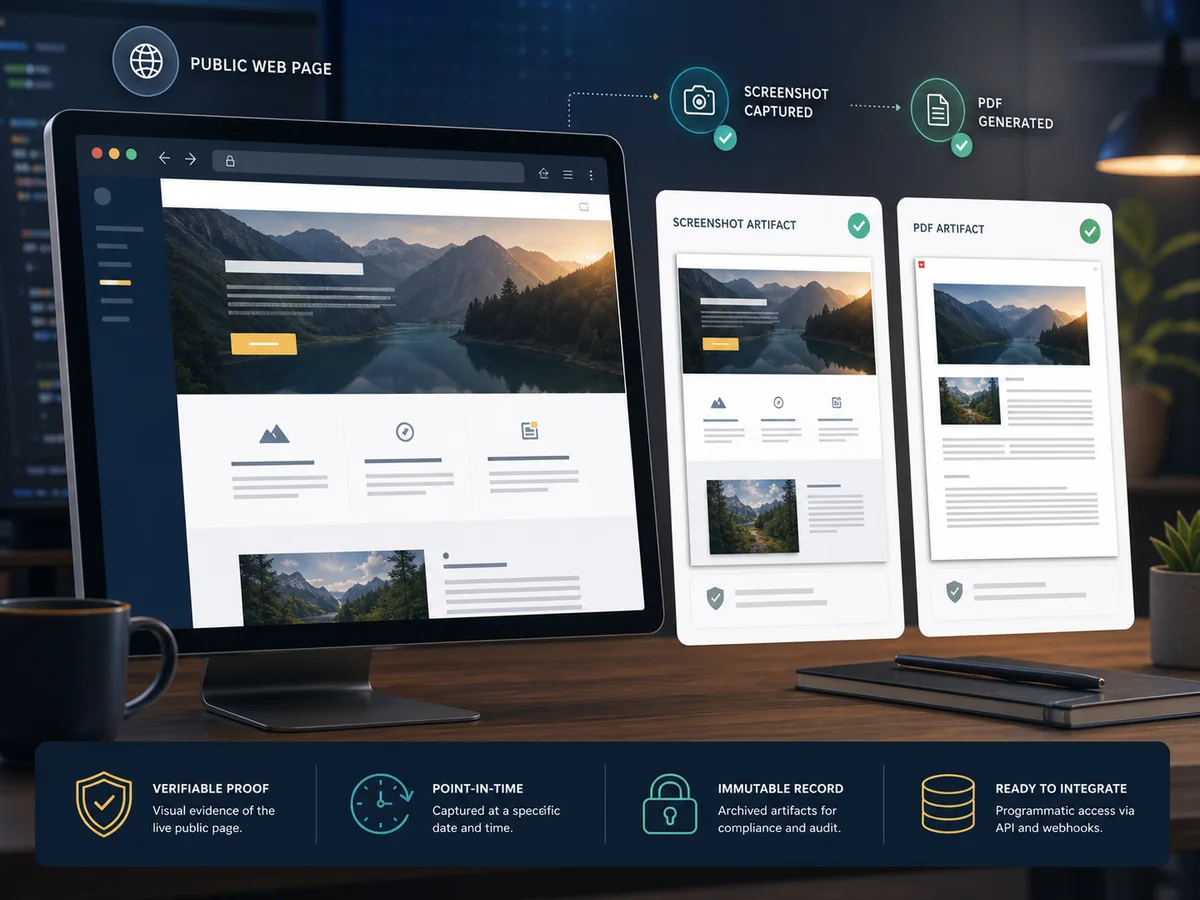
Метаданные JSON полезны для операционного контекста: статус, конечный URL, тип контента, время и детали ответа, которые помогают в логах и отладке. Это не заменяет пользовательский экстракция. Скриншоты и PDF служат другой цели: визуальным доказательством. Они помогают с мониторингом, QA, проверкой соответствия, одобрениями и архивами, но они тяжелее и обычно менее удобны для машинного парсинга.
| Вывод | Лучше всего подходит для | Основное преимущество | Компромисс |
|---|---|---|---|
| Необработанный или отрендеренный HTML | Парсинг DOM, селекторы, таблицы, ссылки | Сохраняет структуру и отношения страниц | Требует логики парсера и очистки на нижнем уровне |
| Текст | Поиск, индексация, легкий анализ | Компактный и легкий для обработки | Удаляет большую часть структурного контекста |
| Markdown | ИИ, RAG, резюме, проверка контента | Сохраняет читаемые заголовки, списки и ссылки | Не идеален для точного извлечения DOM |
| Метаданные JSON | Логи, диагностика, маршрутизация рабочего процесса | Упрощает проверку доказательств запроса | Не заменяет извлечение полей, специфичных для цели |
| Скриншот или PDF | QA, мониторинг, одобрения, архивы | Показывает, как выглядела отрендеренная страница | Тяжелее и менее удобно для парсинга |
Когда важны рендеринг, сессии, заголовки и маршрутизация прокси?
Продвинутые элементы управления важны, когда они решают конкретную проблему цели. Рендеринг браузера важен, когда данные создаются после выполнения JavaScript. Ожидания важны, когда браузер загружает правильное состояние поздно. Заголовки важны, когда публичная цель ожидает законный контекст, такой как язык, тип контента, реферер или конкретный шаблон user-agent. Сессии важны, когда связанные запросы зависят от общих куки или состояния маршрута. Маршрутизация по странам важна, когда публичный контент меняется в зависимости от местоположения, валюты, доступности или регулирования. Премиум-маршрутизация важна, когда доказательства ответа показывают, что стандартная доставка не возвращает пригодную страницу.
Этот порядок важен. Включение всего сразу может сделать запрос более дорогим, медленным и трудным для диагностики. Лучший рабочий процесс — протестировать репрезентативные страницы, сравнить размер и содержание ответа, проверить конечный URL и статус, а затем выбрать наименьший профиль запроса, который надежно производит необходимый артефакт. Это также делает восстановление в производстве более ясным: если цель начинает возвращать перенаправление, таймаут, пустую оболочку или неожиданный тип контента, команда знает, какую часть профиля запроса нужно проверить.
Практическое резюме: добавляйте рендеринг, сессии, заголовки, маршрутизацию или визуальный вывод, когда ответ доказывает, что они улучшают качество захвата, а не потому, что они доступны.
Как ScraperFly снижает риск на пути к покупке?
Проект по скрапингу часто начинается с неопределенности. Команда может не знать, является ли цель статической, насыщенной JavaScript, чувствительной к местоположению, зависимой от сессий или трудной для доставки. Заключение этой работы в тяжелую инфраструктуру или большой повторяющийся план до тестирования цели создает риск. ScraperFly предлагает более простой путь: начните с бесплатных кредитов, проверьте реальные страницы, покупайте кредиты, когда проект в них нуждается, и переходите на ежемесячные кредиты, когда повторяющийся спрос станет ясным.
Эта модель соответствует техническому рабочему процессу. Легкий запрос должен оставаться легким. Более тяжелый отрендеренный или маршрутизированный запрос следует использовать, когда он создает ценность. Визуальные файлы должны генерироваться, когда кому-то нужно визуальное доказательство. Конструктор API поддерживает ту же логику покупки, потому что позволяет команде проверить реальный запрос перед написанием кода или масштабированием партий. Контроль затрат — это не только вопрос ценообразования; это привычка проектирования запросов.
Что должно оставаться на нижнем уровне API для веб-скрапинга?
ScraperFly не следует рассматривать как волшебный экстрактор, который превращает каждую публичную страницу в идеальный набор данных. API захватывает вывод публичной страницы и предоставляет элементы управления для рендеринга, маршрутизации, сессий, заголовков, форматов и визуальных доказательств. Ваш продукт по-прежнему решает, что означают данные. Сопоставление полей, нормализация сущностей, дедупликация, проверки качества, оповещения, оценка, хранение и бизнес-логика остаются на нижнем уровне, где им и место.
Эта граница делает продукт более надежным. API для веб-скрапинга должен помогать разработчику получать надежные исходные доказательства, а затем позволять приложению применять свои собственные правила. Это особенно важно для ИИ, мониторинга, аналитики и автоматизации, где плохие исходные доказательства могут привести к плохим резюме, ложным оповещениям, дублирующим записям или дорогим повторным попыткам.
Куда должна идти команда после понимания основ?
Следующий шаг — создать реальный запрос, а не теоретическую архитектуру. Используйте Конструктор API, чтобы протестировать публичный URL, сравнить форматы вывода и решить, нужна ли странице рендеринг, сессии, заголовки, маршрутизация или визуальный захват. Если основной вопрос — форма вывода, просмотрите страницу форматов ответа API для веб-скрапинга. Если страница насыщена JavaScript, сравните результат с рекомендациями API рендеринга JavaScript. Если состояние имеет значение для запросов, страница API сессий объясняет, когда полезен общий контекст.
Как только профиль запроса будет подтвержден, переместите его в бэкэнд, рабочий процесс, агента, парсер, монитор или архив, которому нужны данные. Это основное обещание ScraperFly: один практический уровень API для публичных веб-данных с элементами управления, которые остаются видимыми с первого теста до производства.












