






Adequação da plataforma
Mantenha a captura focada quando seu produto possui a lógica de dados
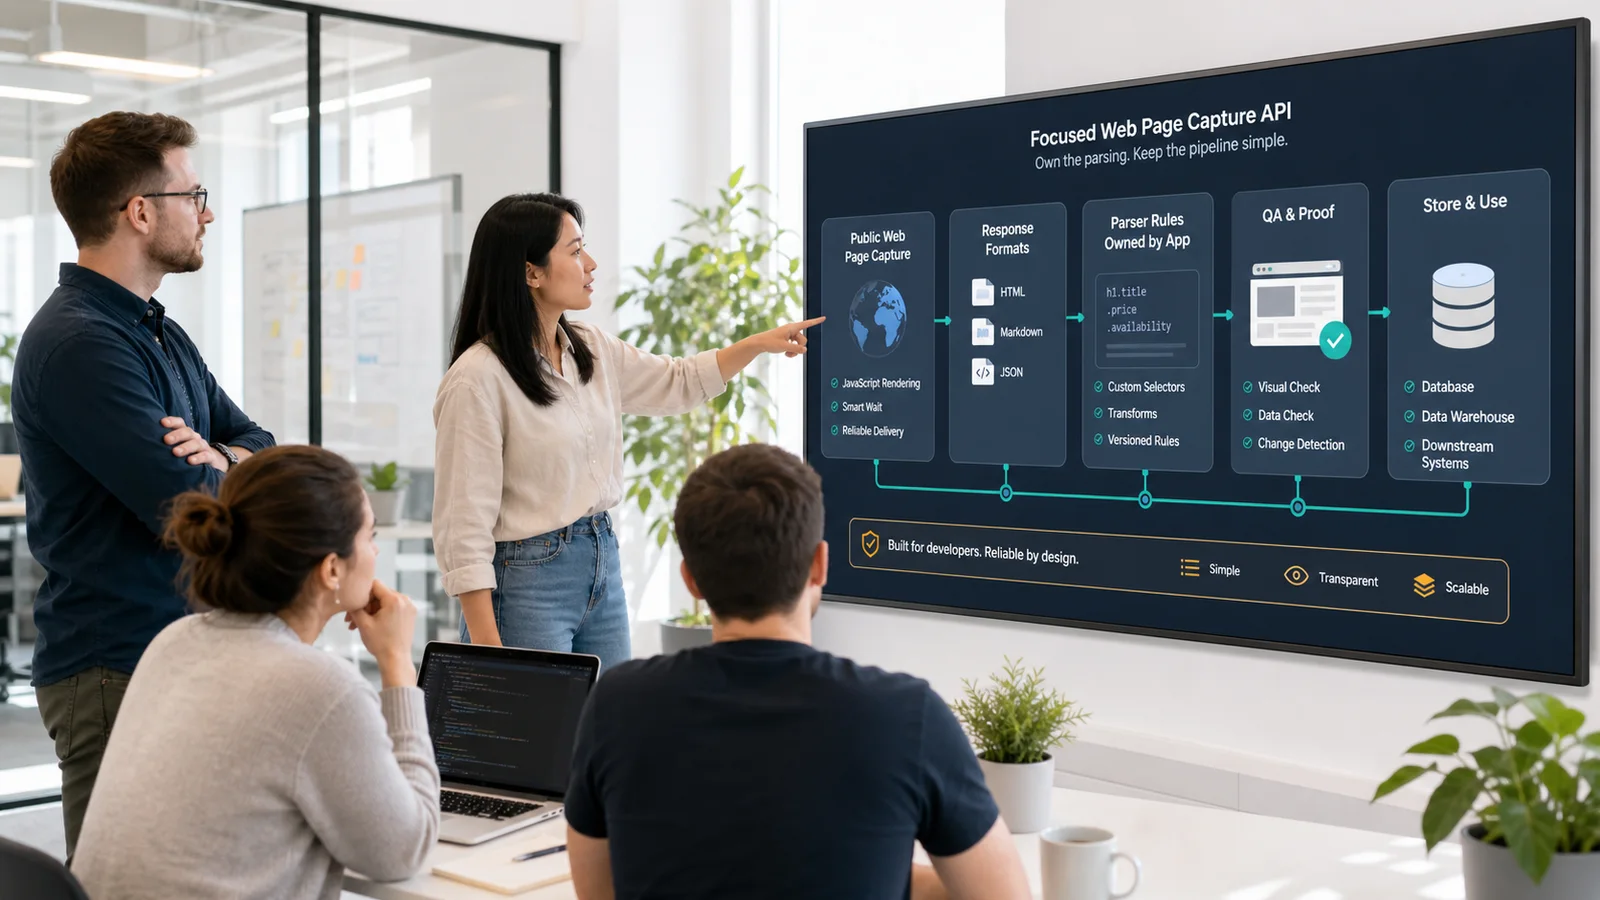
A Zyte é frequentemente avaliada por equipes que buscam uma plataforma de scraping e extração mais ampla. Isso pode ser útil quando a decisão de compra inclui extração gerenciada, esquemas de dados predefinidos, operações de crawling e entrega de dados em nível de plataforma. O ScraperFly atende a uma necessidade diferente e muito prática: sua equipe quer uma API de captura de páginas públicas confiável, mantendo as regras de parsing, enriquecimento, QA, armazenamento, monitoramento e lógica de produto dentro de sua própria pilha.
Essa distinção é importante. Muitas equipes não precisam mover todo o fluxo de trabalho de dados para uma plataforma gerenciada. Elas precisam buscar páginas públicas de forma confiável, comparar a saída bruta e renderizada, escolher o formato de resposta certo, manter o custo da solicitação visível e enviar o resultado para sistemas que já controlam. O ScraperFly mantém essa camada de captura direta, flexível e fácil de testar antes que o volume de produção cresça.
O que uma alternativa à Zyte deve resolver?
Uma alternativa útil à Zyte deve deixar claro o modelo operacional. Você está comprando uma plataforma de dados gerenciada ampla ou precisa de uma camada de API focada que captura páginas públicas e retorna evidências que sua própria aplicação pode usar? A resposta muda a página, o fluxo de trabalho e o modelo de custo.
O ScraperFly é mais forte quando a equipe quer manter o controle. Os desenvolvedores podem começar com HTML fonte, habilitar a renderização JavaScript quando o código do lado do cliente altera o conteúdo útil, usar cabeçalhos ou sessões quando o contexto da solicitação é importante, escolher direcionamento de país ou roteamento mais forte quando o comportamento alvo provar que é necessário e retornar a resposta como HTML, texto, Markdown, metadados JSON, captura de tela ou PDF.
Isso torna a primeira decisão de produção menor. Em vez de comprar uma plataforma de extração completa antes que o alvo seja compreendido, a equipe pode validar o comportamento de captura primeiro e decidir quais parsing, enriquecimento, revisão ou armazenamento devem acontecer downstream.
Onde uma plataforma gerenciada se torna mais do que você precisa?
Plataformas de scraping gerenciadas podem ser atraentes porque combinam muitas camadas: entrega, renderização, roteamento de proxy, extração, esquemas e operações de dados. O trade-off é que o fluxo de trabalho pode se tornar maior do que o problema real. Se sua aplicação já possui regras de parser, verificações de validação, modelos de dados e armazenamento, uma plataforma mais ampla pode adicionar decisões que sua equipe não quer delegar.
O ScraperFly mantém a fronteira de captura limpa. A API lida com a solicitação de página pública e a forma da resposta. Seu produto mantém a lógica de domínio: quais campos importam, como os registros são validados, quais mudanças são importantes, onde os dados são armazenados e como os sistemas downstream os consomem.
| Camada de fluxo de trabalho | Abordagem de plataforma ampla | Abordagem do ScraperFly |
|---|---|---|
| Captura de página | Frequentemente agrupada com extração e fluxos de trabalho de plataforma. | Solicitação de API focada com controles de entrega explícitos e formatos de resposta. |
| Renderização | Pode ser parte de uma decisão de fonte de extração maior. | Habilitar renderização de navegador quando o HTML fonte não contém o conteúdo que você precisa. |
| Lógica de extração | Pode ser gerenciada ou orientada por esquema dentro da plataforma. | Sua aplicação possui seletores, regras de parsing, validação, enriquecimento e armazenamento. |
| Formatos de saída | Frequentemente otimizados em torno de registros extraídos ou saídas de plataforma. | Retornar HTML, texto, Markdown, metadados JSON, capturas de tela ou PDFs dependendo do próximo passo. |
| Controle de custo | A precificação pode refletir a complexidade do alvo, renderização, extração e compromissos de conta. | Comece grátis, mantenha capturas simples leves e adicione controles mais pesados apenas após a evidência do alvo apoiá-los. |
Como as equipes devem testar o ScraperFly em comparação com a Zyte?
Use alvos reais em vez de listas de verificação de recursos. Uma comparação se torna útil quando a equipe pode ver o que cada página retorna, quais controles mudam o resultado e qual formato de resposta é mais fácil para o produto consumir. Comece com a URL pública. Capture o HTML fonte. Compare a saída renderizada quando a resposta fonte é fina. Verifique status, URL final, tipo de conteúdo, tamanho da resposta, redirecionamentos e prova visual quando a página é sensível ao estado do navegador.
Então decida quanto de propriedade da plataforma o fluxo de trabalho realmente precisa. Se a equipe quer uma camada de extração gerenciada pelo fornecedor para registros padronizados, essa é uma forma de compra. Se a equipe quer manter a extração e a lógica de negócios em seu próprio código enquanto usa uma API para captura, renderização, roteamento, capturas de tela, PDFs e formatação de resposta, o ScraperFly é a opção mais limpa.
Qual forma de resposta pertence à produção?
O formato de resposta não é uma opção cosmética. Ele decide quanto código sua equipe escreve após a captura ser bem-sucedida. HTML é útil quando os parsers precisam de estrutura DOM, atributos, links, tabelas ou metadados incorporados. Texto é útil para pesquisa leve, indexação e monitoramento. Markdown funciona bem quando uma estrutura legível por humanos ajuda na revisão de conteúdo, RAG, sumarização e ferramentas internas. Metadados JSON fornecem contexto para operações de registro e depuração. Capturas de tela e PDFs fornecem evidências visuais quando layout, conformidade, QA ou fluxos de trabalho de arquivo são importantes.
O ScraperFly permite que a equipe escolha essa forma antes de construir conversores. Esta é uma das principais razões para avaliá-lo como uma alternativa à Zyte: a API de captura deve facilitar o próximo passo de engenharia, não apenas provar que o alvo pode ser alcançado.
| Necessidade de produção | Saída útil do ScraperFly | Por que ajuda |
|---|---|---|
| Seletores e regras de parser | HTML bruto ou renderizado | Preserva a estrutura da página, atributos, cabeçalhos, links e relacionamentos DOM. |
| Revisão de conteúdo ou ingestão de IA | Texto ou Markdown | Reduz o ruído de layout e fornece material de leitura mais limpo para sistemas downstream. |
| Depuração e observabilidade | Metadados JSON | Mostra status, URL final, tipo de conteúdo, tempo e outros contextos em torno da solicitação. |
| QA, conformidade ou arquivos | Captura de tela ou PDF | Captura como a página pública renderizada apareceu no momento da solicitação. |
Por que escolher o ScraperFly como a alternativa à Zyte?
Escolha o ScraperFly quando a equipe quiser um caminho de compra mais estreito e controlado pelo desenvolvedor. Você pode validar páginas públicas com créditos gratuitos, manter alvos fáceis em perfis de solicitação leves, adicionar controles de renderização ou roteamento onde a evidência do alvo os apoia e enviar formatos de resposta úteis para os sistemas que sua equipe já confia.
O caminho prático é simples: teste o alvo no API Builder, compare a saída fonte e renderizada com a API de renderização JavaScript, escolha a saída certa na página de formatos de resposta e verifique preços após o perfil de solicitação ser real. Essa é uma maneira mais tranquila de comprar infraestrutura de scraping porque a decisão segue evidências, não suposições.















