






ScraperFlyWebdaten-API für KI

alternatives

Zyte-Alternative für API-first öffentliche Seitenaufnahme

ScraperFly ist eine praktische Zyte-Alternative für Teams, die eine fokussierte Capture-API anstelle einer umfassenderen verwalteten Datenplattform wünschen: öffentliche Seiten abrufen, Rendering und Routing nur bei Bedarf auswählen und HTML, Text, Markdown, JSON-Metadaten, Screenshots oder PDFs in die Systeme zurückgeben, die Ihr Team bereits besitzt.

Plattformanpassung

Halten Sie die Erfassung fokussiert, wenn Ihr Produkt die Datenlogik besitzt

Zyte wird oft von Teams bewertet, die nach einer umfassenderen Scraping- und Extraktionsplattform suchen. Das kann nützlich sein, wenn die Kaufentscheidung verwaltete Extraktion, vordefinierte Datenschemata, Crawling-Operationen und plattformübergreifende Datenlieferung umfasst. ScraperFly erfüllt ein anderes, sehr praktisches Bedürfnis: Ihr Team möchte eine zuverlässige API zur Erfassung öffentlicher Seiten, während es Parsing-Regeln, Anreicherung, Qualitätssicherung, Speicherung, Überwachung und Produktlogik in seinem eigenen Stack behält.

Diese Unterscheidung ist wichtig. Viele Teams müssen den gesamten Datenworkflow nicht in eine verwaltete Plattform überführen. Sie müssen öffentliche Seiten zuverlässig abrufen, Roh- und gerendertes Ergebnis vergleichen, das richtige Antwortformat wählen, die Kosten der Anfragen sichtbar halten und das Ergebnis in Systeme senden, die sie bereits kontrollieren. ScraperFly hält diese Erfassungsebene direkt, flexibel und einfach zu testen, bevor das Produktionsvolumen wächst.
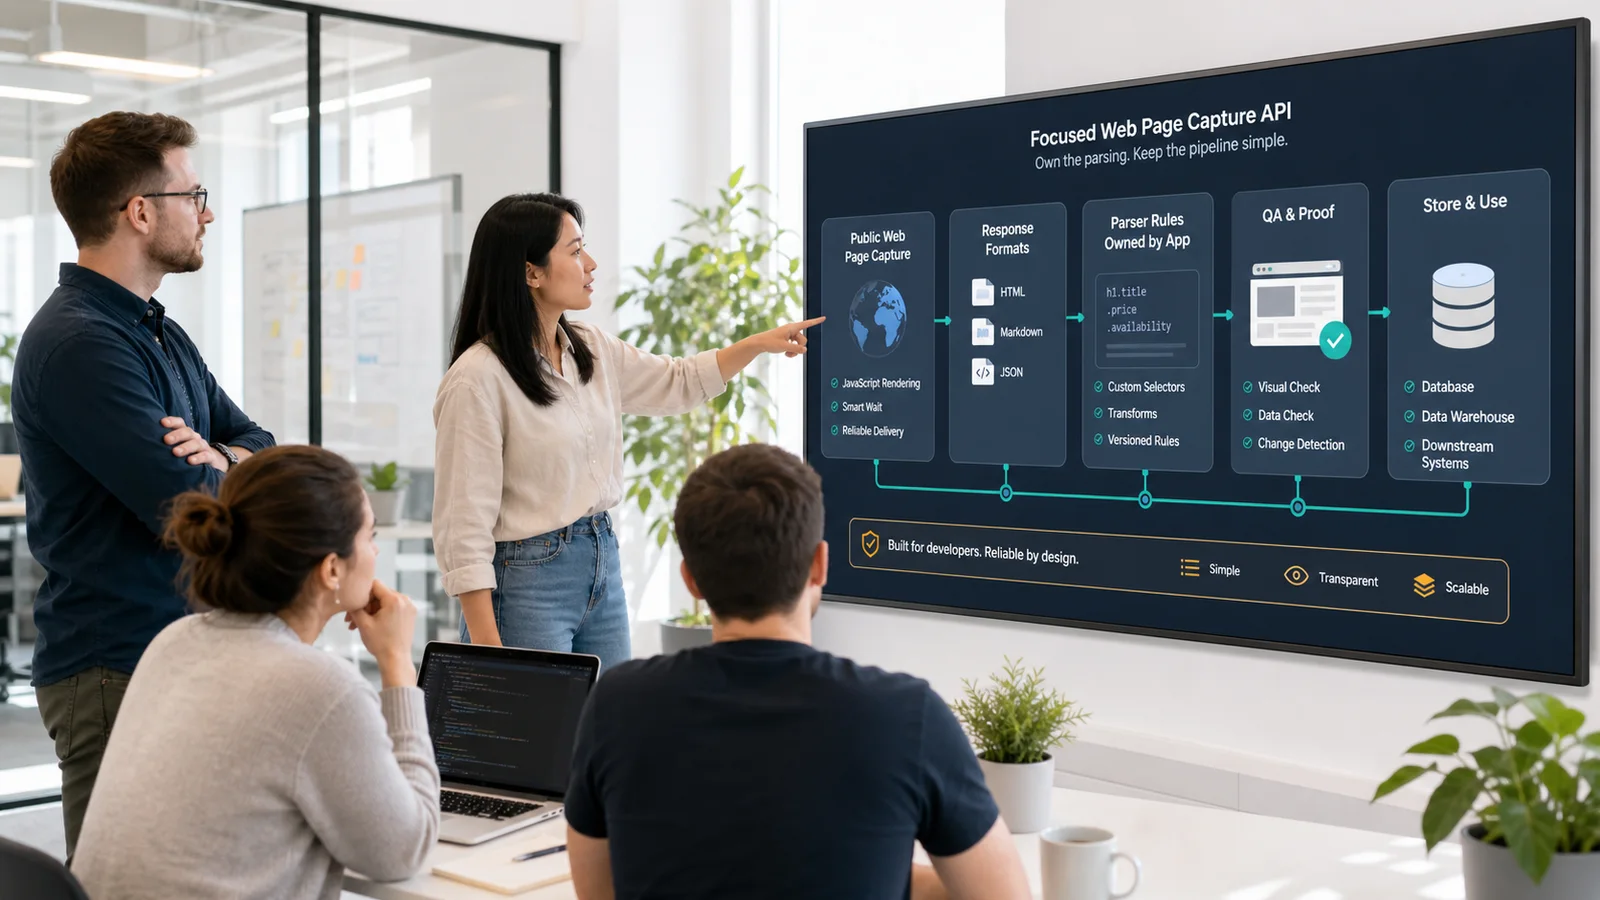
entwicklergesteuertes Workflow Erfassung zuerst Formate für nachgelagerte Systeme
Team überprüft einen fokussierten Workflow zur Erfassung von Webseiten mit Antwortformaten und nachgelagerten Parser-Regeln
ScraperFly hält die Seitenaufnahme, das Rendering, das Routing und die Antwortformate klar, während Ihre Anwendung die Extraktionsregeln und Geschäftslogik besitzt.

Was sollte eine Zyte-Alternative lösen?

Eine nützliche Zyte-Alternative sollte das Betriebsmodell klar machen. Kaufen Sie eine umfassende verwaltete Datenplattform oder benötigen Sie eine fokussierte API-Schicht, die öffentliche Seiten erfasst und Beweise zurückgibt, die Ihre eigene Anwendung nutzen kann? Die Antwort verändert die Seite, den Workflow und das Kostenmodell.

ScraperFly ist am stärksten, wenn das Team die Kontrolle behalten möchte. Entwickler können mit dem Quell-HTML beginnen, JavaScript-Rendering aktivieren, wenn der clientseitige Code den nützlichen Inhalt ändert, Header oder Sitzungen verwenden, wenn der Anfragekontext wichtig ist, Länderauswahl oder stärkere Routing-Optionen wählen, wenn sich das Zielverhalten als notwendig erweist, und die Antwort als HTML, Text, Markdown, JSON-Metadaten, Screenshot oder PDF zurückgeben.

Das macht die erste Produktionsentscheidung kleiner. Anstatt eine vollständige Extraktionsplattform zu kaufen, bevor das Ziel verstanden wird, kann das Team zuerst das Erfassungsverhalten validieren und entscheiden, welche Parsing-, Anreicherungs-, Überprüfungs- oder Speicherprozesse nachgelagert stattfinden sollen.

Praktische Erkenntnis: Wählen Sie ScraperFly, wenn die Hauptaufgabe die zuverlässige Erfassung öffentlicher Seiten plus verwendbare Antwortformate ist, nicht das Auslagern jeder Datenverarbeitungsentscheidung.

Wann wird eine verwaltete Plattform mehr als nötig?

Verwaltete Scraping-Plattformen können attraktiv sein, weil sie viele Schichten kombinieren: Lieferung, Rendering, Proxy-Routing, Extraktion, Schemata und Datenoperationen. Der Nachteil ist, dass der Workflow größer werden kann als das eigentliche Problem. Wenn Ihre Anwendung bereits Parser-Regeln, Validierungsprüfungen, Datenmodelle und Speicherung hat, kann eine breitere Plattform Entscheidungen hinzufügen, die Ihr Team nicht abgeben möchte.

ScraperFly hält die Erfassungsgrenze sauber. Die API verarbeitet die Anfrage für die öffentliche Seite und die Form der Antwort. Ihr Produkt behält die Domänenlogik: welche Felder wichtig sind, wie Datensätze validiert werden, welche Änderungen wichtig sind, wo Daten gespeichert werden und wie nachgelagerte Systeme sie konsumieren.

Workflow-Ebene Breiter Plattformansatz ScraperFly-Ansatz
Seitenaufnahme Oft gebündelt mit Extraktion und Plattform-Workflows. Fokussierte API-Anfrage mit expliziten Lieferkontrollen und Antwortformaten.
Rendering Kann Teil einer größeren Entscheidung zur Extraktionsquelle sein. Aktivieren Sie das Browser-Rendering, wenn das Quell-HTML nicht den benötigten Inhalt enthält.
Extraktionslogik Kann innerhalb der Plattform verwaltet oder schema-gesteuert sein. Ihre Anwendung besitzt Selektoren, Parsing-Regeln, Validierung, Anreicherung und Speicherung.
Ausgabeformate Oft optimiert für extrahierte Datensätze oder Plattformausgaben. Geben Sie HTML, Text, Markdown, JSON-Metadaten, Screenshots oder PDFs zurück, je nach nächstem Schritt.
Kostenkontrolle Die Preisgestaltung kann die Zielkomplexität, das Rendering, die Extraktion und die Kontoverpflichtungen widerspiegeln. Starten Sie kostenlos, halten Sie einfache Erfassungen leicht und fügen Sie schwerere Kontrollen erst hinzu, wenn die Zielbeweise sie unterstützen.

Wie sollten Teams ScraperFly gegen Zyte testen?

Verwenden Sie echte Ziele anstelle von Funktionschecklisten. Ein Vergleich wird nützlich, wenn das Team sehen kann, was jede Seite zurückgibt, welche Kontrollen das Ergebnis ändern und welches Antwortformat für das Produkt am einfachsten zu konsumieren ist. Beginnen Sie mit der öffentlichen URL. Erfassen Sie das Quell-HTML. Vergleichen Sie das gerenderte Ergebnis, wenn die Quellantwort dünn ist. Überprüfen Sie den Status, die endgültige URL, den Inhaltstyp, die Antwortgröße, Weiterleitungen und visuelle Beweise, wenn die Seite empfindlich auf den Browserstatus reagiert.

Entscheiden Sie dann, wie viel Plattformbesitz der Workflow wirklich benötigt. Wenn das Team eine vom Anbieter verwaltete Extraktionsschicht für standardisierte Datensätze möchte, ist das eine Art von Kauf. Wenn das Team die Extraktions- und Geschäftslogik in seinem eigenen Code behalten möchte, während es eine API für Erfassung, Rendering, Routing, Screenshots, PDFs und Antwortformatierung verwendet, ist ScraperFly die sauberere Wahl.

Welche Antwortform gehört in die Produktion?

Das Antwortformat ist keine kosmetische Option. Es entscheidet, wie viel Code Ihr Team nach dem erfolgreichen Erfassen schreibt. HTML ist nützlich, wenn Parser die DOM-Struktur, Attribute, Links, Tabellen oder eingebettete Metadaten benötigen. Text ist nützlich für leichte Suche, Indizierung und Überwachung. Markdown funktioniert gut, wenn eine für Menschen lesbare Struktur bei der Inhaltsüberprüfung, RAG, Zusammenfassung und internen Tools hilft. JSON-Metadaten geben den Operationen Kontext für Protokollierung und Debugging. Screenshots und PDFs bieten visuelle Beweise, wenn Layout, Compliance, QA oder Archiv-Workflows wichtig sind.

ScraperFly ermöglicht es dem Team, diese Form auszuwählen, bevor Konverter erstellt werden. Dies ist einer der Hauptgründe, es als Zyte-Alternative zu bewerten: Die Capture-API sollte den nächsten Engineering-Schritt erleichtern, nicht nur beweisen, dass das Ziel erreicht werden kann.

Produktionsbedarf Nützliche ScraperFly-Ausgabe Warum es hilft
Selektoren und Parser-Regeln Roh- oder gerendertes HTML Bewahrt die Seitenstruktur, Attribute, Überschriften, Links und DOM-Beziehungen.
Inhaltsüberprüfung oder KI-Eingabe Text oder Markdown Reduziert Layoutgeräusche und gibt nachgelagerten Systemen klarere Lesematerialien.
Debugging und Beobachtbarkeit JSON-Metadaten Zeigt Status, endgültige URL, Inhaltstyp, Timing und anderen Kontext rund um die Anfrage.
QA, Compliance oder Archive Screenshot oder PDF Erfasst, wie die gerenderte öffentliche Seite zum Zeitpunkt der Anfrage aussah.

Warum ScraperFly als Zyte-Alternative wählen?

Wählen Sie ScraperFly, wenn das Team einen schmaleren, entwicklergesteuerten Kaufweg wünscht. Sie können öffentliche Seiten mit kostenlosen Credits validieren, einfache Ziele mit leichten Anfrageprofilen beibehalten, Rendering- oder Routing-Kontrollen hinzufügen, wo Zielbeweise sie unterstützen, und nützliche Antwortformate in die Systeme senden, denen Ihr Team bereits vertraut.

Der praktische Weg ist einfach: Testen Sie das Ziel im API Builder, vergleichen Sie Quell- und gerendertes Ergebnis mit der JavaScript-Rendering-API, wählen Sie die richtige Ausgabe von der Antwortformatseite und überprüfen Sie Preise, nachdem das Anfrageprofil real ist. Das ist ein ruhigerer Weg, um Scraping-Infrastruktur zu kaufen, da die Entscheidung auf Beweisen und nicht auf Annahmen basiert.


Vergleichsanpassung

Wählen Sie ScraperFly, wenn fokussierte Erfassung eine größere Plattformentscheidung übertrifft.

ScraperFly ist am stärksten, wenn Ihr Team Extraktion, Validierung, Speicherung und Produktlogik in seinem eigenen Stack behalten möchte, während es sich auf eine API für die Erfassung öffentlicher Seiten, Rendering, Routing-Kontrollen, Antwortformate, Screenshots, PDFs und kostenbewusstes Testen verlässt.

Glückliches Team, das ein Projekt auf einem Laptop validiert
01 / Einfach starten

Einfacher, kostenloser Start ohne Druck durch Rechnungsstellung

ScraperFly gibt Ihnen die Möglichkeit, zuerst das echte Ziel zu testen. Verwenden Sie kostenlose Credits, um zu überprüfen, ob die Seite funktioniert, ob die Daten vorhanden sind und welche Kontrollen tatsächlich benötigt werden, bevor Sie Geld für einen Plan ausgeben. Das macht das erste Experiment leicht: kein Beschaffungsprozess, kein erzwungener Abonnement, kein Raten Ihres monatlichen Volumens am ersten Tag.

Kostenlose CreditsKeine Karte für erste TestsValidieren, bevor Sie skalieren
Lächelnder Profi, der erfolgreich mit einem Laptop arbeitet
02 / Klug ausgeben

Erschwingliche, flexible Abrechnung für reale Scraping-Volumen

Nicht jede Scraping-Arbeitslast ist eine klare monatliche Kurve. Einige Projekte steigen, einige pausieren, und einige werden erst wiederkehrend, nachdem die Daten ihren Wert beweisen. ScraperFly unterstützt diese Realität mit einem Pay-as-you-go-Weg plus monatlichen Kreditplänen, wenn ein stetiges Volumen sinnvoll ist. Sie können kaufen, was Sie benötigen, die Kosten im Blick behalten und vermeiden, einen kleinen Test in ein übergroßes Abonnement zu verwandeln.

Bezahlen nach BedarfMonatlich, wenn sinnvollKostenkontrolle
Entwickler, der strukturierten Output von einem Laptop vorbereitet
03 / Schneller versenden

Antwortvorverarbeitung, die Aufräumarbeiten entfernt

Ein günstiger Abruf reicht nicht aus, wenn Ihr Team immer noch Konverter, Cleaner, Screenshots, PDF-Erfassung und LLM-bereite Formatierung darum herum bauen muss. ScraperFly kann die Antwort als HTML, reinen Text, Markdown, strukturiertes JSON, PDF oder Bildausgabe zurückgeben, sodass Ihre Pipeline näher am endgültigen Asset in einer Anfrage liegt. Weniger Klebekode, weniger bewegliche Teile, schnellere Lieferung.

HTMLTextMarkdownJSONPDFBild

ScraperFly vs Zyte für entwicklergesteuerte Scraping-Workflows.

Der richtige Vergleich dreht sich um Besitz. ScraperFly bietet Entwicklern eine fokussierte Erfassungsebene und nützliche Ausgaben, ohne den gesamten Datenworkflow in ein breiteres verwaltetes Plattformmodell zu zwingen.

EntscheidungspunktScraperFly-VorteilTypischer Wettbewerbsnachteil
Erstes ExperimentBeginnen Sie mit kostenlosen Credits und validieren Sie das tatsächliche Ziel, bevor Sie Geld ausgeben. Sie können nachweisen, ob rohes HTML, Rendering, Premium-Routing oder Länderauswahl tatsächlich benötigt wird.Testversionen drängen Sie oft schnell zu einem wiederkehrenden Plan oder verbergen die tatsächlichen Kosten, bis Add-Ons in die Anfrage eingehen.
AbrechnungsmodellVerwenden Sie Pay-as-you-go-Credits für unregelmäßige Arbeiten und wechseln Sie erst zu monatlichen Credits, wenn die Arbeitslast vorhersehbar wird. Dies hält kleine Tests und projektbasiertes Scraping erschwinglich.Viele Tools sind auf monatliche Abonnements, feste Kontingente oder Stufengrenzen optimiert, die sich schwer anfühlen können, bevor das Volumen nachgewiesen ist.
AnfragegewichtHalten Sie einfache Seiten einfach. Aktivieren Sie JavaScript-Rendering, Premium-Routing, Sitzungen, Header, Wartezeiten oder Länderrouting nur, wenn die Antwortbeweise zeigen, dass sie wichtig sind.Vergleichbare Kontrollen können existieren, sind jedoch oft in höheren Stufen, Standardwerten oder komplexeren Preisprofilen gebündelt.
AusgabeformateGeben Sie die Antwort in der Form zurück, die Ihr Produkt benötigt: HTML für Parser, Text oder Markdown für Inhalts-Pipelines, JSON für strukturierte Metadaten und PDF/Bildausgaben für visuelle Nachweise.Einige Anbieter konzentrieren sich hauptsächlich auf den Zugang und überlassen das Formatieren, Erfassen, Bereinigen und die nachgelagerte Vorbereitung Ihrem eigenen Code.
Entwickler-WorkflowEine API-Oberfläche kann Zieltests, Eskalation, Rendering, Routing, Sitzungen, Header, Antwortformatierung und Statusprüfungen abdecken. Der Weg vom Prototyp zur Produktion bleibt kompakt.Proxy-first-Tools, Akteur-Marktplätze und Crawler-Plattformen können leistungsstark sein, erfordern jedoch oft mehr Klebercode oder ein schwereres Betriebsmodell.
Beste PassformTeams, die praktische Webdatenbereitstellung wünschen: klein anfangen, Kosten pro nützlichem Ergebnis messen und nur die Kontrollen skalieren, die das Ergebnis verbessern.Teams mit festen Hochvolumenverträgen, benutzerdefinierter Proxy-Infrastruktur oder breiten Marktplatz-Crawler-Bedürfnissen bevorzugen möglicherweise eine spezialisiertere Plattform.

Zielbeweise

Entscheiden Sie, was die Seite benötigt, bevor Sie das Plattformgewicht wählen.

Eine Bewertung der Zyte-Alternative sollte mit der Quelle selbst beginnen: Gibt die Seite nützliches HTML zurück, ändert das Rendering das Ergebnis, verändert Geografie den Inhalt, beeinflussen Header oder Sitzungen die Kontinuität und welches Antwortformat benötigt das nachgelagerte System tatsächlich?

Roh-HTML-Antwort, die auf sichtbare Seitendaten abgebildet ist
01

Verfügbarkeit von Roh-HTML

Überprüfen Sie, ob die benötigten Felder bereits in der ersten HTML-Antwort vorhanden sind.

Bester erster Test für einfache Seiten, Artikel, Dokumente, Listen und Produktdetails.

Vergleich vor und nach der JavaScript-Rendering
02

JavaScript-Abhängigkeit

Vergleichen Sie das Roh-HTML mit dem gerenderten DOM oder Screenshot, bevor Sie das Browser-Rendering aktivieren.

Verwenden Sie Rendering, wenn das Roh-HTML nur eine Hülle ist und Skripte den nützlichen Inhalt erstellen.

Cookies, Zustimmung, Sitzung und Zugriffs-Kontext für das Scraping
03

Status & Zugriffs-Kontext

Identifizieren Sie, ob Cookies, Zustimmung, Anmeldegrenzen, Pagination oder der gleiche Besucherstatus die Antwort beeinflussen.

Verwenden Sie Sitzungen und Header, wenn die Kontinuität die Daten, die Sie erhalten, verändert.

Regionale Inhaltsvariationen über Länder und Routen hinweg
04

Geo-/Inhaltsvariation

Testen Sie, ob Land, Sprache, Währung, Inventar, SERP, Anzeigen oder Routenreputation das Ergebnis verändern.

Verwenden Sie Geo- oder Premium-Routing nur, wenn sichergestellt ist, dass die Antwort je nach Route variiert.

Überprüfungen, bevor Sie einen Erfassungsworkflow wählen.

Wo befindet sich das Ziel-Feld?

Finden Sie heraus, ob das Feld im Roh-HTML, im gerenderten DOM, einem API-Aufruf, strukturierten Daten, einer Datei oder einem späteren Interaktionszustand vorhanden ist.

Was ändert die Antwort?

Probieren Sie einige URLs aus und vergleichen Sie Status, endgültige URL, Inhaltslänge, Weiterleitungen, leere Zustände und sichtbare Ergebnisunterschiede.

Welcher Kontext ist erforderlich?

Markieren Sie alle Abhängigkeiten von Zustimmung, Gebietsschema, Cookies, Headern, Authentifizierungsgrenzen, Paginierung, Filtern oder vorherigen Anfragen.

Wie sieht ein Fehler aus?

Definieren Sie die Signale für blockierte, teilweise, veraltete, umgeleitete, leere, zeitüberschreitende oder regionsfremde Antworten, bevor Sie skalieren.

Wie sich das Seitenverhalten auf die ScraperFly-Anfrage auswirkt.

Abrufmodus

Die Verfügbarkeit von Roh-HTML entscheidet, ob die erste Anfrage einfach bleiben kann oder Rendering, Wartezeiten, Screenshots oder Extraktion benötigt.

Anfragekontext

Statusanforderungen entscheiden, ob Header, Cookies, Sitzungen, Zustimmungsverwaltung oder ein stabiler Besucherprofil hinzugefügt werden müssen.

Routing-Wahl

Geo- und Reputationsfunde entscheiden, ob das Standard-Routing ausreicht oder eine Länder-/Premium-Route gerechtfertigt ist.

Validierungsregeln

Bekannte Fehlerzustände werden zu Prüfungen für Wiederholungen, Eskalationen, QA-Überprüfungen und zur Entscheidung, wann ein leichteres Profil dennoch vollständig ist.

Entwicklergesteuerter Workflow

Erstellen Sie Erfassungsanfragen, die Parsing und Geschäftslogik in Ihrem Stack beibehalten

ScraperFly kümmert sich um die Erfassung öffentlicher Seiten, während Ihre Anwendung die Extraktionsregeln, Validierung, Anreicherung, Überwachung, Speicherung und Produktentscheidungen besitzt.

API
Erfassen

Verwenden Sie eine fokussierte API für die Anfrageebene

Halten Sie URL, Ausgabeformat, Rendering, Routing, Sitzungen, Header und Länder-Kontext für das Engineering-Team sichtbar.

apicurl
DATA
Eigene Logik

Halten Sie die Extraktionsregeln im Nachgang

Verwenden Sie die ScraperFly-Ausgabe als Quellbeweis, während Ihr eigener Code die Feldzuordnung, Validierung und Anreicherung steuert.

htmlJSON
QA
Beweis

Fügen Sie visuelle Aufzeichnungen hinzu, wenn die Überprüfung sie benötigt

Screenshots und PDFs helfen QA, Überwachung, Compliance und Archiv-Workflows zu überprüfen, was die öffentliche Seite angezeigt hat.

ScreenshotPDF

Kontrollen, die wichtig sind, wenn man Zyte-Alternativen vergleicht

url

Die öffentliche Seite, die erfasst wird.

format

Die Ausgabestruktur für Parsing, Überprüfung, Archivierung oder Nachweis.

render

Browserausführung, wenn nützliche Inhalte clientseitig sind.

country

Regionale Routenführung, wenn der Quellinhalt je nach Markt variiert.

cURL-Beispiel

Generieren Sie Markdown mit derselben Anfrageform, die Sie in die Produktion überführen können.

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Eskalationspfad

Fügen Sie Browser-, Routing- und Anfragekontext nur hinzu, wenn Beweise dies unterstützen

Einige öffentliche Seiten benötigen mehr als einen einfachen Abruf. ScraperFly ermöglicht es Teams, auf Rendering, Wartezeiten, Sitzungen, Header, Länderauswahl oder stärkere Routenführung zu eskalieren, ohne diese Kontrollen für jede Quelle zur Standardoption zu machen.

Eine einfache HTTP-Anfrage, die eine saubere HTML-Antwort zurückgibt
01

Einfaches HTML-Anfrage

Verwenden Sie dies zuerst für öffentliche Seiten, die bereits die erforderlichen Daten im ursprünglichen HTML enthalten.

Eine Seite, die von einer leeren HTML-Hülle zu einem gerenderten DOM wechselt, nachdem JavaScript ausgeführt wurde
02

JavaScript-Rendering

Aktivieren Sie das Rendering, wenn der Server eine Hülle zurückgibt, aber der nützliche Seiteninhalt erscheint erst, nachdem JavaScript ausgeführt wurde.

Header, Cookies und Sitzungsstatus werden über zwei Anfragen hinweg beibehalten.
03

Header, Cookies & Sitzungen

Verwenden Sie Besucherstatuskontrollen, wenn das Ziel Kontinuität zwischen Anfragen erwartet oder unterschiedliche Inhalte zurückgibt, nachdem Zustimmung, Standort oder Navigationsstatus festgelegt sind.

Eine Anfrage, die über einen ausgewählten Länder- und höher reputierten Proxy-Pfad geleitet wird
04

Premium-Proxy & Geo

Erhöhen Sie das Routing, wenn die Antwort von der Anfrageherkunft, IP-Reputation oder Zielgeografie abhängt.

Ein Browser-Automatisierungsfluss mit Such-, Filter-, Scroll- und Datenerfassungs-Schritten.
05

Browserfluss

Verwenden Sie einen vollständigen Browserfluss, wenn die Daten hinter Interaktionen stehen, anstatt einer einzelnen Anfrage: Suchfelder, Filter, Scrollen, Tabs oder mehrstufige Navigation.

Escalate when:

01

Einfaches HTML-Anfrage

die rohe Antwort enthält die benötigten Felder, Statuscodes sind stabil, und die Seitengröße/Inhalte brechen nach wiederholten Überprüfungen nicht zusammen.

  • Produktdetails, Artikeltext, Dokumentation oder Auflistungen sind in der HTML-Antwort sichtbar.
  • Die endgültige URL, der Status und die Inhaltslänge bleiben über eine kleine Stichprobe hinweg konsistent.
  • Es ist keine Einwilligungswand, kein Besucherstatus oder kein clientseitiger API-Aufruf für die Ziel-Felder erforderlich.
02

JavaScript-Rendering

das rohe HTML besteht größtenteils aus Platzhaltern, das gerenderte DOM enthält die Ziel-Felder oder wichtige Daten kommen durch clientseitige Anfragen.

  • Roh-HTML hat App-Container, Lade-Skelette oder leere Produktgitter.
  • Die Browserinspektion zeigt die Felder, nachdem die Skripte abgeschlossen sind.
  • Screenshots sehen korrekt aus, während die HTML-Antwort allein unvollständig ist.
03

Header, Cookies & Sitzungen

Pagination, Bewertungen, Filter oder Zustimmungsflüsse hängen vom gleichen Besucher-Kontext über mehrere Anfragen hinweg ab.

  • Die erste Anfrage setzt Cookies, die spätere Antworten ändern.
  • Standort, Zustimmung, Währung, Warenkorb oder Filterstatus müssen beibehalten werden.
  • Die Seite leitet um oder wird leer, wenn Anfragen statuslos erscheinen.
04

Premium-Proxy & Geo

die gleiche URL verhält sich je nach Region unterschiedlich, gibt 403/429 von einem Pfad zurück oder zeigt standortspezifische Preise, Verfügbarkeit, SERP, Anzeigen oder Katalogdaten.

  • Datacenter-ähnlicher Verkehr erhält Blockierungen, während eine Route mit höherem Ruf funktioniert.
  • Land, Sprache, Währung, Inventar oder Suchergebnisse ändern sich je nach Geo.
  • Wiederholte Anfragen lösen Ratenlimits oder Challenge-Seiten auf bestimmten Routen aus.
05

Browserfluss

Die Ziel-Daten erscheinen erst nach benutzerähnlichen Navigationsschritten oder geschützten Bereichen wie Bewertungen, Profilen, Verfeinerungen der Suchergebnisse oder speziellen Datenfeldern, die sich anders verhalten als einfache Detailseiten.

  • Eine Klick-, Scroll-, Such- oder Filteraktion ist erforderlich, bevor die Felder erscheinen.
  • Bewertungen, Profile oder dynamische Ergebnisseiten laden in separaten Schritten.
  • Einfachere Abruf-/Renderversuche geben teilweise Inhalte, Challenge-Seiten oder instabile Zustände zurück.

Stay lower & Credit impact:

01

Einfaches HTML-Anfrage

Stay lower: die Seite gibt bereits vollständige Daten zurück. Das Hinzufügen von Rendering oder Premium-Routing hier erhöht nur die Latenz und den Kreditverbrauch, ohne das Ergebnis zu verbessern.

Credit impact: niedrigstes Anfrageprofil, da es Browserarbeit und spezielles Routing vermeidet.

02

JavaScript-Rendering

Stay lower: die Felder sind bereits im rohen HTML vorhanden. Eine modern aussehende Seite bedeutet nicht automatisch, dass JavaScript-Rendering erforderlich ist.

Credit impact: höher als einfaches HTML, da Browserarbeit, Wartezeit und Seitenressourcen beteiligt sind.

03

Header, Cookies & Sitzungen

Stay lower: Öffentliche Inhalte sind stabil ohne Status. Erfinden Sie keine Sitzungen für Seiten, die sauber als anonymes HTML abgerufen werden können.

Credit impact: in der Regel moderat; die größeren Kosten sind operationale Komplexität und Wiederholungsdisziplin.

04

Premium-Proxy & Geo

Stay lower: das Ziel ist global konsistent und akzeptiert normales Routing. Premium- und Geo-Routing sollten an Beweise gebunden sein, nicht als Standard-Blanketeinstellung verwendet werden.

Credit impact: kann den Kreditverbrauch und die Latenz erhöhen, daher sollte sie nur auf die URL-Gruppen angewendet werden, die sie tatsächlich benötigen.

05

Browserfluss

Stay lower: Eine einzelne HTML- oder gerenderte Anfrage gibt bereits das Ziel zurück. Browserflüsse sind das stärkste Werkzeug in dieser Hierarchie, nicht der Standard-Ausgangspunkt.

Credit impact: höchstes Anfrageprofil, da es Browserlaufzeit, Wartezeiten, Navigation und oft schwerere Routen kombiniert.

Eskalieren Sie durch Beweise, nicht durch Gewohnheit

  • Für die meisten öffentlichen Websites reicht eine einfache HTML-Anfrage oder leichtes JavaScript-Rendering aus. Beginnen Sie dort, überprüfen Sie die Antwort und entscheiden Sie erst dann, ob der nächste Schritt gerechtfertigt ist.
  • Anti-Bot-Signale sind normalerweise in der Antwort sichtbar: unerwartete 403- oder 429-Status, plötzliche Weiterleitungen, winzige oder leere HTMLs, Challenge-Seiten, CAPTCHA-Bildschirme, Anmelde- oder Zustimmungsloops und Inhalte, die nach wiederholten Anfragen verschwinden.
  • Große, stark frequentierte Ziele wie Amazon, Google, LinkedIn, Instagram, TikTok und große Marktplätze schützen oft einige Bereiche aggressiv. Sie können Rendering, Sitzungen, sorgfältige Routen oder einen Browserfluss erfordern, und jedes Ziel benötigt sein eigenes Testprofil.
  • Der Schutz ist nicht einheitlich, selbst innerhalb einer Website. Produkt-/Detailseiten können mit einem leichteren Profil geöffnet werden, während Bewertungen, Profile, Suchseiten, preissensitive Ansichten, Verfügbarkeitsfelder oder kontobezogene Daten eine stärkere Eskalation erfordern können.
  • Geo- und Premium-Proxy-Einstellungen beeinflussen sowohl das, was Sie erhalten, als auch wie teuer das Anfrageprofil wird. Verwenden Sie sie, wenn länderspezifische Inhalte, IP-Ruf oder wiederholte Blockierungen beweisen, dass sie wichtig sind.
  • Das praktische Ziel ist nicht, jede ScraperFly-Steuerung zu aktivieren. Das Ziel ist es, das ausreichende Niveau zu finden, das vollständige, wiederholbare Daten zurückgibt, während die Nutzung von Credits, Latenz und Fehlermodi unter Kontrolle bleibt.

Kostenmodell

Beginnen Sie mit dem kleinsten nützlichen Erfassungsprofil, bevor die wiederkehrenden Ausgaben steigen

ScraperFly unterstützt einen risikoärmeren Weg: kostenlose Credits für die erste Validierung, nutzungsabhängige Bezahlung für unregelmäßige Arbeiten und monatliche Credits, wenn die Quellliste und das Anfrageprofil vorhersehbar werden.

Eine leichte HTML-Anfrage, die eine einfache Antwort zurückgibt
01

Einfacher Abruf

Verwenden Sie einen einfachen Abruf, wenn das öffentliche HTML bereits die benötigten Felder enthält.

Leichtestes Anfrageprofil; behalten Sie es, wenn die Antwort vollständig ist.

JavaScript-Rendering, das ein vollständiges DOM erzeugt
02

Rendering

Verwenden Sie Rendering, wenn rohes HTML eine Hülle ist und JavaScript die Seite vervollständigt.

Schwereres Profil; verwenden Sie es nur, wenn die Browserausgabe das Ergebnis ändert.

Mehrere Anfragen, die Cookies und den Besucherstatus beibehalten
03

Zustandsbehaftete Sitzung

Verwenden Sie Sitzungen, wenn Cookies, Zustimmung, Sprache oder Paginierung die Antwort ändern.

Schwereres Zustandsprofil; bewahren Sie es nur, wenn Kontinuität wichtig ist.

Anforderungsrouting über Geo- und hochwertigere Routen
04

Premium-Routing & Geo

Verwenden Sie Premium-Routing oder Geo nur, wenn Herkunft, Land, Ruf oder regionale Inhalte das Ergebnis ändern.

Schwerstes Routing-Profil; wenden Sie es nur auf Ziele an, die nachweisen, dass sie es benötigen.

Was einen Zyte-Alternativen-Workflow schwerer machen kann

Mehr Infrastrukturarbeit

Browser-Rendering, Routing-Entscheidungen und längere Wartezeiten bedeuten, dass die Plattform mehr tun muss, als nur eine einfache Antwort zurückzugeben.

Mehr Zielunsicherheit

Weiterleitungen, leere Zustände, Ratenlimits und Challenge-Seiten erfordern oft stärkere Lieferoptionen oder Wiederholungen.

Mehr Zustand zu bewahren

Cookies, Sitzungen, Einwilligungen und mehrseitige Abläufe fügen bewegliche Teile hinzu, die ein einfacher zustandsloser Abruf nicht hat.

Mehr Beweise zurückzugeben

Screenshots, PDFs, gerenderte Ausgaben und reichhaltigere Antwortartefakte sind nützlich, aber sie sind schwerer als einfaches HTML.

Wie man die Ausgaben mit den Erfassungsbeweisen in Einklang hält

Beispiel vor der Skalierung

Testen Sie zuerst eine kleine URL-Gruppe und gruppieren Sie Ziele nach dem leichtesten Profil, das vollständige Daten zurückgibt.

Standardmäßig nicht rendern

Überprüfen Sie das rohe HTML, bevor Sie das Rendering aktivieren. Viele öffentliche Seiten enthalten bereits die Daten, die Sie benötigen.

Eskalieren Sie anhand von Beweisen

Steigen Sie nur auf, wenn die Antwort fehlende Inhalte, Zustandsabhängigkeit, geo-variationen oder Routing-Probleme zeigt.

Nützliche Ergebnisse messen

Optimieren Sie basierend auf gültigen gelieferten Datensätzen, nicht auf dem Rohanfragevolumen. Ein leichteres Profil ist nur dann am besten, wenn es vollständig bleibt.

Alternative FAQ

Häufige Fragen zur Auswahl von ScraperFly als Zyte-Alternative

Praktische Antworten für Teams, die eine fokussierte Capture-API mit breiteren verwalteten Scraping- und Extraktionsplattformen vergleichen.

Zyte-Alternative Antworten

Wahl des Betriebsmodells

Für Teams, die entscheiden, ob sie eine verwaltete Extraktion oder eine gezielte Erfassung benötigen.

Wann passt ScraperFly besser?

Wenn Ihr Team das Parsen, die Validierung und die Speicherung selbst übernehmen möchte, während es eine API für die Erfassung öffentlicher Seiten und Antwortformate verwendet.

Wann könnte eine breitere Plattform passen?

Wenn die Kaufentscheidung Anbieter-gesteuerte Extraktionsschemata, Crawling-Operationen oder ein größeres Datenliefermodell umfasst.

Antwortformate

Für Teams, die erfasste Seiten in bestehende Systeme einspeisen.

Mit welchem Format sollte ich beginnen?

Beginnen Sie mit dem Format, das Ihr nächstes System verwenden kann: HTML für Parser, Markdown oder Text für Inhalts-Workflows, Metadaten für Debugging oder Screenshots und PDFs als Nachweis.

Macht ScraperFly die Feldextraktion für mich?

ScraperFly konzentriert sich auf Erfassungs- und Antwortformate. Ihre Anwendung kann zielgruppenspezifische Parsing-, Validierungs- und Anreicherungsregeln übernehmen.

Rendering und Routing

Für Teams, die entscheiden, wann sie Anfragen schwerer machen.

Sollte jede Seite Rendering verwenden?

Nein. Verwenden Sie Rendering, wenn der Quell-HTML nützliche Inhalte vermisst, die nach der Ausführung im Browser erscheinen.

Wann sollte Routing eskaliert werden?

Eskalieren Sie, wenn Beweise in der Antwort auf Zugriffsfehler, geografische Unterschiede, Weiterleitungen oder Seitenverhalten hinweisen, die eine einfache Lieferung nicht lösen kann.

Budget und Skalierung

Für Teams, die Ziele testen, bevor das Volumen vorhersehbar ist.

Kann ich testen, bevor ich mich verpflichte?

Ja. Beginnen Sie mit kostenlosen Credits und testen Sie nach Verbrauch, bevor Sie vorhersehbare wiederkehrende Arbeitslasten auf monatliche Credits umstellen.

Wie vermeide ich es, zu viel zu bezahlen?

Halten Sie einfache Erfassungen leicht und fügen Sie Rendering, Routing, Screenshots, PDFs oder andere schwerere Kontrollen nur dort hinzu, wo sie die Antwort verbessern.













