






ScraperFlyAPI веб-данных для AI

alternatives

Альтернатива Zyte для API-ориентированного захвата публичных страниц

ScraperFly — это практичная альтернатива Zyte для команд, которые хотят сосредоточиться на API захвата, а не на более широкой управляемой платформе данных: получайте публичные страницы, выбирайте рендеринг и маршрутизацию только по мере необходимости и возвращайте HTML, текст, Markdown, JSON метаданные, скриншоты или PDF в системы, которые уже есть у вашей команды.

Совместимость платформы

Сосредоточьтесь на захвате, когда ваш продукт управляет логикой данных

Zyte часто оценивается командами, рассматривающими более широкую платформу для скрапинга и извлечения данных. Это может быть полезно, когда решение о покупке включает управляемое извлечение, предопределенные схемы данных, операции обхода и доставку данных на уровне платформы. ScraperFly подходит для другой, очень практичной задачи: вашей команде нужен надежный API для захвата публичных страниц, сохраняя правила парсинга, обогащение, контроль качества, хранение, мониторинг и бизнес-логику внутри своего стека.

Это различие имеет значение. Многие команды не нуждаются в переносе всего рабочего процесса данных на управляемую платформу. Им нужно надежно получать публичные страницы, сравнивать сырые и отрендеренные результаты, выбирать правильный формат ответа, держать стоимость запросов на виду и отправлять результат в системы, которые они уже контролируют. ScraperFly сохраняет этот уровень захвата прямым, гибким и легким для тестирования до того, как объем производства вырастет.
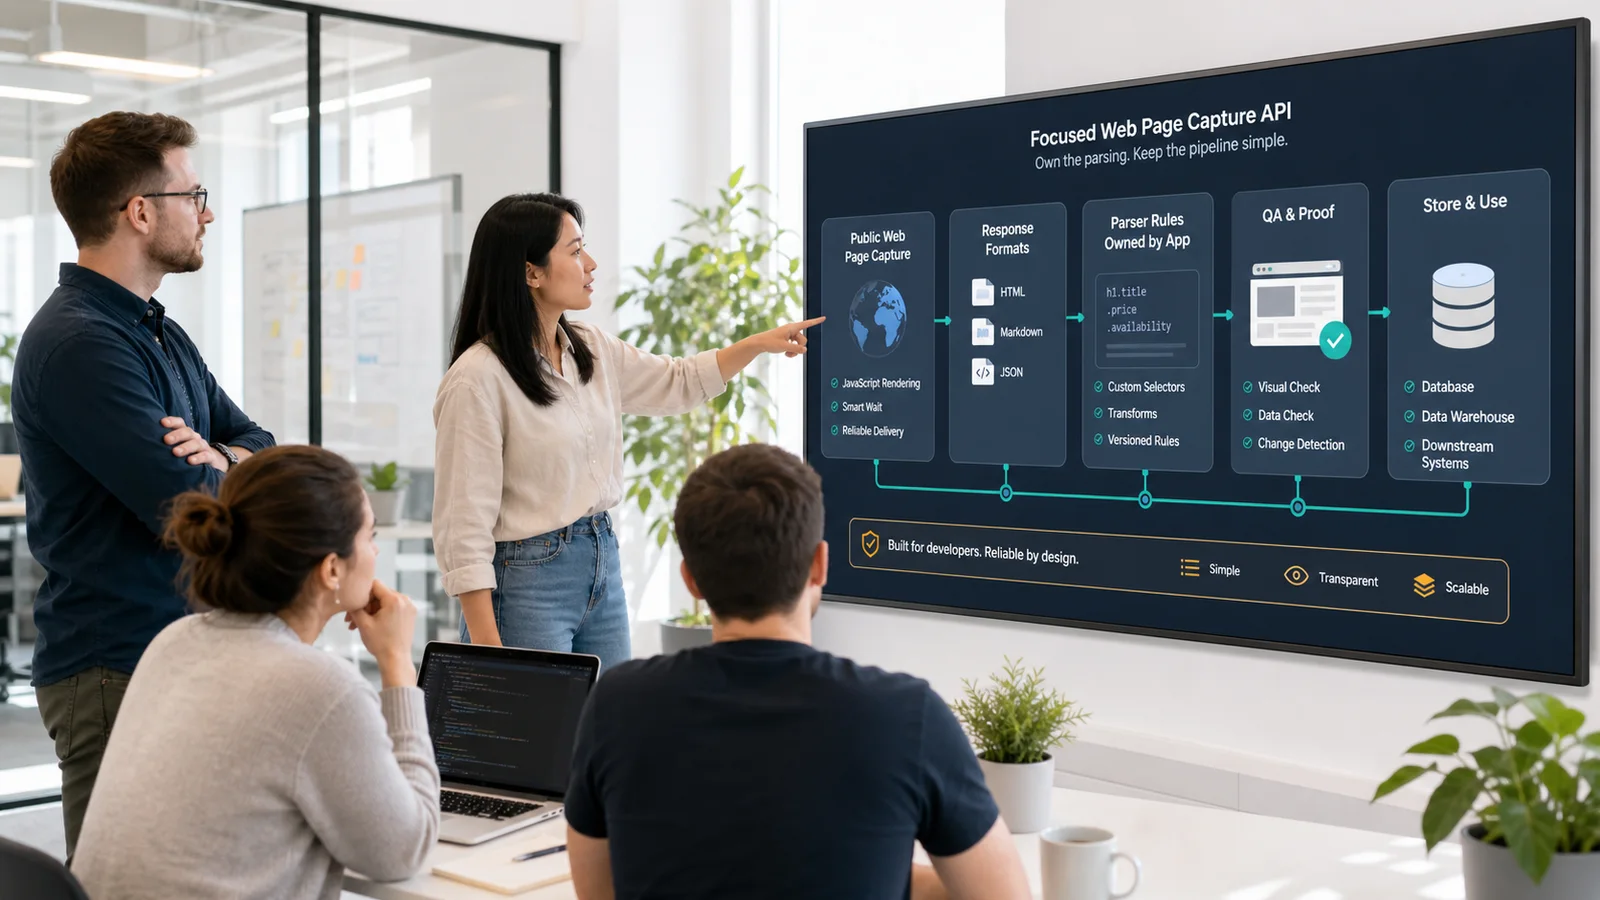
рабочий процесс, управляемый разработчиком сначала захват форматы для downstream-систем
Команда рассматривает рабочий процесс API захвата веб-страниц с фокусом на форматах ответов и правилах парсинга downstream
ScraperFly сохраняет захват страниц, рендеринг, маршрутизацию и форматы ответов ясными, в то время как ваше приложение управляет правилами извлечения и бизнес-логикой.

Что должно решать альтернативное решение Zyte?

Полезная альтернатива Zyte должна четко обозначать операционную модель. Вы покупаете широкую управляемую платформу данных или вам нужен сосредоточенный уровень API, который захватывает публичные страницы и возвращает доказательства, которые ваше собственное приложение может использовать? Ответ меняет страницу, рабочий процесс и модель затрат.

ScraperFly наиболее эффективен, когда команда хочет сохранить контроль. Разработчики могут начать с исходного HTML, включить рендеринг JavaScript, когда клиентский код изменяет полезный контент, использовать заголовки или сессии, когда контекст запроса имеет значение, выбирать целевую страну или более сильную маршрутизацию, когда целевое поведение доказывает, что это необходимо, и возвращать ответ в виде HTML, текста, Markdown, JSON-метаданных, скриншота или PDF.

Это делает первое производственное решение меньшим. Вместо того чтобы покупать полную платформу извлечения до того, как цель будет понята, команда может сначала проверить поведение захвата и решить, какие парсинг, обогащение, проверка или хранение должны происходить downstream.

Практическое резюме: выбирайте ScraperFly, когда основная задача заключается в надежном захвате публичных страниц плюс полезные форматы ответов, а не в аутсорсинге каждого решения по обработке данных.

Когда управляемая платформа становится больше, чем вам нужно?

Управляемые платформы для скрапинга могут быть привлекательными, потому что они объединяют множество уровней: доставка, рендеринг, маршрутизация прокси, извлечение, схемы и операции с данными. Компромисс заключается в том, что рабочий процесс может стать больше, чем сама проблема. Если ваше приложение уже имеет правила парсинга, проверки валидации, модели данных и хранение, более широкая платформа может добавить решения, которые ваша команда не хочет передавать.

ScraperFly сохраняет границу захвата чистой. API обрабатывает запрос публичной страницы и форму ответа. Ваш продукт сохраняет доменную логику: какие поля важны, как записи проверяются, какие изменения важны, где хранятся данные и как downstream-системы их потребляют.

Уровень рабочего процесса Широкий подход платформы Подход ScraperFly
Захват страниц Часто объединен с извлечением и рабочими процессами платформы. Сосредоточенный API-запрос с явными контролями доставки и форматами ответов.
Рендеринг Может быть частью более крупного решения по источнику извлечения. Включите рендеринг браузера, когда исходный HTML не содержит нужного вам контента.
Логика извлечения Может управляться или основываться на схемах внутри платформы. Ваше приложение управляет селекторами, правилами парсинга, валидацией, обогащением и хранением.
Форматы вывода Часто оптимизированы вокруг извлеченных записей или выходов платформы. Возвращайте HTML, текст, Markdown, JSON-метаданные, скриншоты или PDF в зависимости от следующего шага.
Контроль затрат Цены могут отражать целевую сложность, рендеринг, извлечение и обязательства по аккаунту. Начните бесплатно, держите простые захваты легкими и добавляйте более тяжелые контроли только после того, как целевое доказательство поддерживает их.

Как командам протестировать ScraperFly против Zyte?

Используйте реальные цели вместо контрольных списков функций. Сравнение становится полезным, когда команда может видеть, что возвращает каждая страница, какие контролы изменяют результат и какой формат ответа проще всего использовать для продукта. Начните с публичного URL. Захватите исходный HTML. Сравните отрендеренный вывод, когда исходный ответ тонкий. Проверьте статус, конечный URL, тип контента, размер ответа, перенаправления и визуальные доказательства, когда страница чувствительна к состоянию браузера.

Затем решите, сколько владения платформой действительно нужно рабочему процессу. Если команде нужен управляемый поставщиком уровень извлечения для стандартизированных записей, это одна категория покупки. Если команде нужно сохранить извлечение и бизнес-логику в своем коде, используя API для захвата, рендеринга, маршрутизации, скриншотов, PDF и форматирования ответов, ScraperFly является более чистым вариантом.

Какой формат ответа должен быть в производстве?

Формат ответа не является косметической опцией. Он определяет, сколько кода ваша команда напишет после успешного захвата. HTML полезен, когда парсеры нуждаются в структуре DOM, атрибутах, ссылках, таблицах или встроенных метаданных. Текст полезен для легкого поиска, индексации и мониторинга. Markdown хорошо работает, когда читаемая человеком структура помогает в обзоре контента, RAG, обобщении и внутренних инструментах. JSON-метаданные дают контекст операций для ведения журнала и отладки. Скриншоты и PDF предоставляют визуальные доказательства, когда важны макет, соблюдение норм, контроль качества или архивные рабочие процессы.

ScraperFly позволяет команде выбрать эту форму перед созданием конвертеров. Это одна из основных причин оценить его как альтернативу Zyte: API захвата должен облегчить следующий инженерный шаг, а не просто доказать, что цель может быть достигнута.

Потребность в производстве Полезный вывод ScraperFly Почему это помогает
Селекторы и правила парсинга Сырой или отрендеренный HTML Сохраняет структуру страницы, атрибуты, заголовки, ссылки и отношения DOM.
Обзор контента или поглощение AI Текст или Markdown Снижает шум макета и предоставляет downstream-системам более чистый материал для чтения.
Отладка и наблюдаемость JSON-метаданные Показывает статус, конечный URL, тип контента, время и другой контекст вокруг запроса.
Контроль качества, соблюдение норм или архивы Скриншот или PDF Записывает, как отрендеренная публичная страница выглядела в момент запроса.

Почему стоит выбрать ScraperFly в качестве альтернативы Zyte?

Выбирайте ScraperFly, когда команда хочет более узкий, более контролируемый разработчиком путь покупки. Вы можете проверять публичные страницы с помощью бесплатных кредитов, держать легкие цели на легких профилях запросов, добавлять рендеринг или маршрутизацию, где целевое доказательство поддерживает их, и отправлять полезные форматы ответов в системы, которым ваша команда уже доверяет.

Практический путь прост: протестируйте цель в API Builder, сравните исходный и отрендеренный вывод с помощью JavaScript rendering API, выберите правильный вывод на странице форматов ответов и проверьте цены после того, как профиль запроса станет реальным. Это более спокойный способ покупки инфраструктуры для скрапинга, потому что решение основывается на доказательствах, а не на предположениях.


Сравнительная пригодность

Выбирайте ScraperFly, когда сосредоточенный захват важнее, чем более крупное решение платформы.

ScraperFly наиболее эффективен, когда ваша команда хочет сохранить извлечение, валидацию, хранение и бизнес-логику в своем стеке, полагаясь на один API для захвата публичных страниц, рендеринга, контроля маршрутизации, форматов ответов, скриншотов, PDF и тестирования с учетом затрат.

Счастливая команда, проверяющая проект на ноутбуке
01 / Начните легко

Легкий, бесплатный старт перед любым давлением по оплате

ScraperFly дает вам возможность сначала протестировать реальную цель. Используйте бесплатные кредиты, чтобы проверить, работает ли страница, присутствуют ли данные и какие элементы управления действительно нужны, прежде чем вы потратите деньги на план. Это делает первый эксперимент легким: никаких закупочных циклов, никакой принудительной подписки, никаких предположений о вашем месячном объеме в первый день.

Бесплатные кредитыНет карты для первых тестовПроверяйте перед масштабированием
Улыбающийся профессионал, успешно работающий с ноутбуком
02 / Тратьте разумно

Доступная, гибкая оплата за реальный объем скрапинга

Не каждая нагрузка для скрапинга представляет собой аккуратную месячную кривую. Некоторые проекты резко возрастают, некоторые приостанавливаются, а некоторые становятся регулярными только после того, как данные докажут свою ценность. ScraperFly поддерживает эту реальность с помощью модели оплаты по мере использования и ежемесячных кредитных планов, когда стабильный объем имеет смысл. Вы можете купить то, что вам нужно, держать расходы под контролем и избежать превращения небольшого теста в чрезмерную подписку.

Оплата по мере использованияЕжемесячно, когда это полезноКонтроль затрат
Разработчик, подготавливающий структурированный вывод с ноутбука
03 / Доставка быстрее

Предварительная обработка ответа, которая убирает работу по очистке

Дешевый запрос недостаточен, если вашей команде все еще нужно создавать конвертеры, очистители, скриншоты, захват PDF и форматирование, готовое для LLM. ScraperFly может вернуть ответ в формате HTML, чистого текста, Markdown, структурированного JSON, PDF или изображения, так что ваш конвейер приближается к конечному активу за один запрос. Меньше кода склеивания, меньше движущихся частей, более быстрая доставка.

HTMLТекстMarkdownJSONPDFИзображение

ScraperFly против Zyte для рабочих процессов скрапинга, управляемых разработчиками.

Правильное сравнение касается владения. ScraperFly предоставляет разработчикам сосредоточенный уровень захвата и полезные выходы, не заставляя весь рабочий процесс данных переходить в более широкую управляемую платформу.

Точка принятия решенияПреимущество ScraperFlyТипичный компромисс конкурента
Первый экспериментНачните с бесплатных кредитов и проверьте реальную цель перед расходами. Вы можете доказать, нужны ли на самом деле сырой HTML, рендеринг, премиум маршрутизация или таргетинг по странам.Тестовые версии часто быстро подталкивают вас к подписке или скрывают истинную стоимость, пока дополнительные функции не войдут в запрос.
Модель биллингаИспользуйте кредиты по мере необходимости для нерегулярной работы, затем переходите на ежемесячные кредиты только тогда, когда объем работы станет предсказуемым. Это делает небольшие тесты и проектный скрапинг доступными.Многие инструменты оптимизированы под ежемесячные подписки, фиксированные лимиты или уровни, которые могут казаться тяжелыми, прежде чем объем будет доказан.
Вес запросаДержите простые страницы простыми. Включайте рендеринг JavaScript, премиум маршрутизацию, сессии, заголовки, ожидания или маршрутизацию по странам только тогда, когда доказательства ответа говорят, что это важно.Сравнимые элементы управления могут существовать, но они часто объединены в более высокие уровни, по умолчанию или более сложные ценовые профили.
Форматы выводаВозвращайте ответ в формате, который нужен вашему продукту: HTML для парсеров, текст или Markdown для контентных потоков, JSON для структурированных метаданных и PDF/изображение для визуального доказательства.Некоторые провайдеры сосредотачиваются в основном на доступе и оставляют форматирование, захват, очистку и подготовку на вашем собственном коде.
Рабочий процесс разработчикаОдна API поверхность может охватывать тестирование целей, эскалацию, рендеринг, маршрутизацию, сессии, заголовки, форматирование ответов и проверки статуса. Путь от прототипа до производства остается компактным.Инструменты с приоритетом прокси, рынки актеров и платформы для краулеров могут быть мощными, но часто требуют больше связующего кода или более тяжелой операционной модели.
Лучшее соответствиеКоманды, которые хотят практической доставки веб-данных: начните с малого, измеряйте стоимость за полезный результат и масштабируйте только те элементы управления, которые улучшают результат.Команды с фиксированными контрактами на большой объем, кастомной прокси-инфраструктурой или широкими потребностями в краулинге рынка могут предпочесть более специализированную платформу.

Доказательства цели

Решите, что требуется странице, прежде чем выбирать вес платформы.

Оценка альтернативы Zyte должна начинаться с самого источника: возвращает ли страница полезный HTML, изменяет ли рендеринг результат, влияет ли география на контент, влияют ли заголовки или сессии на непрерывность, и какой формат ответа на самом деле нужен downstream-системе?

Сырой HTML-ответ, сопоставленный с видимыми данными страницы
01

Доступность сырого HTML

Проверьте, присутствуют ли необходимые вам поля уже в первом HTML-ответе.

Лучший первый тест для простых страниц, статей, документов, списков и деталей продуктов.

Сравнение до и после рендеринга JavaScript
02

Зависимость от JavaScript

Сравните сырой HTML с отрендеренным DOM или скриншотом перед включением рендеринга браузера.

Используйте рендеринг, когда сырой HTML является лишь оболочкой, а скрипты создают полезный контент.

Cookies, согласие, контекст сессии и доступа для скрапинга
03

Состояние и контекст доступа

Определите, влияют ли cookies, согласие, границы входа, пагинация или состояние одного и того же посетителя на ответ.

Используйте сессии и заголовки, когда непрерывность изменяет данные, которые вы получаете.

Региональные вариации контента по странам и маршрутам
04

Гео/вариация контента

Проверьте, изменяет ли страна, язык, валюта, запасы, SERP, реклама или репутация маршрута результат.

Используйте гео- или премиум-маршрутизацию только тогда, когда цель подтверждает, что ответ варьируется в зависимости от маршрута.

Проверки перед выбором рабочего процесса захвата.

Где находится целевое поле?

Узнайте, существует ли поле в сыром HTML, отрендеренном DOM, вызове API, структурированных данных, файле или состоянии взаимодействия позже.

Что изменяет ответ?

Выберите несколько URL-адресов и сравните статус, конечный URL, длину контента, перенаправления, пустые состояния и различия в видимых результатах.

Какой контекст необходим?

Отметьте любую зависимость от согласия, локали, файлов cookie, заголовков, границ аутентификации, пагинации, фильтров или предыдущих запросов.

Как выглядит неудача?

Определите сигналы для заблокированных, частичных, устаревших, перенаправленных, пустых, истекших или несоответствующих регионам ответов перед масштабированием.

Как поведение страницы формирует запрос ScraperFly.

Режим получения

Доступность сырого HTML определяет, может ли первый запрос оставаться простым или требует рендеринга, ожиданий, скриншотов или извлечения.

Контекст запроса

Требования состояния определяют, нужно ли добавлять заголовки, файлы cookie, сессии, обработку согласия или стабильный профиль посетителя.

Выбор маршрута

Гео и репутационные данные определяют, достаточно ли стандартного маршрута или оправдан ли маршрут по стране/премиум.

Правила валидации

Известные состояния неудачи становятся проверками для повторных попыток, эскалации, проверки качества и решения о том, когда более легкий профиль все еще полный.

Рабочий процесс, принадлежащий разработчику

Создавайте запросы на захват, которые сохраняют парсинг и бизнес-логику в вашем стеке

ScraperFly обрабатывает захват публичных страниц, в то время как ваше приложение управляет правилами извлечения, валидацией, обогащением, мониторингом, хранением и принятием продуктовых решений.

API
Захват

Используйте специализированный API для уровня запросов

Держите URL, формат вывода, рендеринг, маршрутизацию, сессии, заголовки и контекст страны на виду у инженерной команды.

apicurl
DATA
Владейте логикой

Держите правила извлечения на нижнем уровне

Используйте вывод ScraperFly в качестве источника доказательств, в то время как ваш собственный код контролирует сопоставление полей, валидацию и обогащение.

htmljson
QA
Доказательство

Добавляйте визуальные записи, когда обзор требует их

Скриншоты и PDF-файлы помогают QA, мониторингу, соблюдению норм и архивным рабочим процессам проверять, что показывала публичная страница.

скриншотpdf

Контроль, который имеет значение при сравнении альтернатив Zyte

url

Публичная страница, которая захватывается.

format

Форма вывода для парсинга, обзора, архивации или подтверждения.

render

Выполнение в браузере, когда полезный контент находится на стороне клиента.

country

Региональная маршрутизация, когда исходный контент варьируется в зависимости от рынка.

пример cURL

Генерируйте Markdown с той же формой запроса, которую вы можете использовать в производстве

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Путь эскалации

Добавляйте браузер, маршрутизацию и контекст запроса только тогда, когда это подтверждено доказательствами

Некоторые публичные страницы требуют больше, чем простой запрос. ScraperFly позволяет командам переходить к рендерингу, ожиданиям, сессиям, заголовкам, таргетингу по странам или более сильной маршрутизации, не делая эти параметры по умолчанию для каждого источника.

Простой HTTP-запрос, возвращающий чистый HTML-ответ
01

Запрос простого HTML

Используйте это в первую очередь для публичных страниц, которые уже содержат необходимые данные в начальном HTML.

Страница, изменяющаяся с пустой HTML-оболочки на отрендеренный DOM после выполнения JavaScript
02

Рендеринг JavaScript

Включите рендеринг, когда сервер возвращает оболочку, но полезное содержимое страницы появляется только после выполнения JavaScript.

Заголовки, куки и состояние сессии сохраняются между двумя запросами.
03

Заголовки, куки и сессии

Используйте управление состоянием посетителя, когда цель ожидает непрерывности между запросами или возвращает различный контент после установки согласия, локали или состояния навигации.

Запрос, направленный через выбранную страну и путь прокси с высокой репутацией
04

Премиум прокси и гео

Эскалируйте маршрутизацию, когда ответ зависит от источника запроса, репутации IP или целевой географии.

Автоматизация браузера с поиском, фильтрами, прокруткой и шагами захвата данных.
05

Поток браузера

Используйте полный поток браузера, когда данные находятся за взаимодействием, а не за одним запросом: поля поиска, фильтры, прокрутка, вкладки или многошаговая навигация.

Escalate when:

01

Запрос простого HTML

сырой ответ содержит необходимые поля, коды состояния стабильны, а размер/содержимое страницы не меняются после повторных проверок.

  • Детали продукта, текст статьи, документация или списки видны в HTML-ответе.
  • Конечный URL, статус и длина содержимого остаются постоянными в небольшой выборке.
  • Не требуется стена согласия, состояние посетителя или вызов клиентского API для целевых полей.
02

Рендеринг JavaScript

сырой HTML в основном состоит из заполнителей, отрендеренный DOM содержит целевые поля, или ключевые данные поступают через клиентские запросы.

  • Сырой HTML содержит контейнеры приложений, скелеты загрузки или пустые сетки продуктов.
  • Инспекция браузера показывает поля после завершения скриптов.
  • Скриншоты выглядят корректно, в то время как HTML-ответ сам по себе неполный.
03

Заголовки, куки и сессии

пагинация, отзывы, фильтры или потоки согласия зависят от одного и того же контекста посетителя в нескольких запросах.

  • Первый запрос устанавливает куки, которые изменяют последующие ответы.
  • Локаль, согласие, валюта, корзина или состояние фильтра должны быть сохранены.
  • Страница перенаправляет или очищается, когда запросы выглядят без состояния.
04

Премиум прокси и гео

один и тот же URL ведет себя по-разному в зависимости от региона, возвращает 403/429 с одного маршрута или показывает цены, доступность, SERP, рекламу или данные каталога, специфичные для местоположения.

  • Трафик, похожий на датацентр, получает блокировки, в то время как маршрут с более высокой репутацией работает.
  • Страна, язык, валюта, инвентарь или результаты поиска меняются в зависимости от геолокации.
  • Повторные запросы вызывают ограничения по скорости или страницы с вызовами на определенных маршрутах.
05

Поток браузера

целевые данные появляются только после шагов навигации, похожих на действия пользователя, или защищенные области, такие как отзывы, профили, уточнения результатов поиска или специальные панели данных ведут себя иначе, чем простые страницы с деталями.

  • Требуется действие клика, прокрутки, поиска или фильтрации, прежде чем поля появятся.
  • Отзывы, профили или динамические страницы результатов загружаются в отдельных шагах.
  • Более простые попытки получения/рендеринга возвращают частичное содержимое, страницы с вызовами или нестабильные состояния.

Stay lower & Credit impact:

01

Запрос простого HTML

Stay lower: страница уже возвращает полные данные. Добавление рендеринга или премиум-маршрутизации здесь только увеличивает задержку и использование кредитов без улучшения результата.

Credit impact: самый низкий профиль запроса, так как он избегает работы браузера и специальной маршрутизации.

02

Рендеринг JavaScript

Stay lower: поля уже присутствуют в сыром HTML. Современный сайт не означает автоматически, что требуется рендеринг JavaScript.

Credit impact: выше, чем простой HTML, так как вовлечены работа браузера, время ожидания и ресурсы страницы.

03

Заголовки, куки и сессии

Stay lower: публичный контент стабилен без состояния. Не выдумывайте сессии для страниц, которые можно получить чистым анонимным HTML.

Credit impact: обычно умеренные; большая стоимость заключается в операционной сложности и дисциплине повторных попыток.

04

Премиум прокси и гео

Stay lower: цель глобально согласована и принимает нормальную маршрутизацию. Премиум и гео маршрутизация должны быть связаны с доказательствами, а не использоваться как стандартная настройка по умолчанию.

Credit impact: может увеличить использование кредита и задержку, поэтому применяйте его к группам URL, которые действительно нуждаются в этом.

05

Поток браузера

Stay lower: один HTML или отрендеренный запрос уже возвращает цель. Потоки браузера являются самым мощным инструментом в этой лестнице, а не отправной точкой по умолчанию.

Credit impact: самый высокий профиль запросов, так как он сочетает в себе время выполнения браузера, ожидания, навигацию и часто более тяжелую маршрутизацию.

Эскалируйте на основе доказательств, а не привычек

  • Для большинства публичных веб-сайтов достаточно простого HTML-запроса или легкого рендеринга JavaScript. Начните с этого, проверьте ответ, и только затем решите, оправдан ли следующий шаг.
  • Сигналы против ботов обычно видны в ответе: неожиданные статусы 403 или 429, резкие перенаправления, крошечный или пустой HTML, страницы с вызовами, экраны CAPTCHA, циклы входа или согласия и контент, который исчезает после повторных запросов.
  • Крупные высоконагруженные цели, такие как Amazon, Google, LinkedIn, Instagram, TikTok и крупные торговые площадки, часто агрессивно защищают некоторые поверхности. Они могут требовать рендеринга, сессий, тщательной маршрутизации или потока браузера, и каждая цель требует своего собственного тестового профиля.
  • Защита не является однородной даже внутри одного сайта. Страницы с продуктами/деталями могут открываться с более легким профилем, в то время как отзывы, профили, страницы поиска, чувствительные к цене представления, панели доступности или данные, связанные с аккаунтом, могут требовать более сильной эскалации.
  • Настройки гео и премиум-прокси влияют как на то, что вы получаете, так и на то, насколько дорогим становится профиль запроса. Используйте их, когда контент, специфичный для страны, репутация IP или повторные блокировки доказывают свою важность.
  • Практическая цель не в том, чтобы включить все элементы управления ScraperFly. Цель состоит в том, чтобы найти достаточный уровень, который возвращает полные, повторяемые данные, при этом контролируя использование кредитов, задержку и режимы отказа.

Модель затрат

Начните с самого маленького полезного профиля захвата, прежде чем расходы начнут расти

ScraperFly поддерживает менее рискованный путь: бесплатные кредиты для первой проверки, оплата по мере использования для нерегулярной работы и ежемесячные кредиты, когда список источников и профиль запросов становятся предсказуемыми.

Легкий HTML-запрос, возвращающий простой ответ
01

Базовый запрос

Используйте базовый запрос, когда публичный HTML уже содержит необходимые вам поля.

Самый легкий профиль запроса; сохраняйте его, когда ответ завершен.

Рендеринг JavaScript, создающий полный DOM
02

Рендеринг

Используйте рендеринг, когда сырой HTML является оболочкой, а JavaScript завершает страницу.

Более тяжелый профиль; используйте его только когда вывод браузера изменяет результат.

Несколько запросов с сохранением cookies и состояния посетителя
03

Состояние сессии

Используйте сессии, когда cookies, согласие, локализация или пагинация изменяют ответ.

Более тяжелый профиль состояния; сохраняйте его только когда важна непрерывность.

Маршрутизация запросов через гео и более качественные маршруты
04

Премиум маршрутизация и гео

Используйте премиум маршрутизацию или гео только когда источник, страна, репутация или региональный контент изменяют результат.

Самый тяжелый профиль маршрутизации; применяйте его только к целям, которые доказывают, что они в этом нуждаются.

Что может сделать рабочий процесс альтернативы Zyte более тяжелым

Больше инфраструктурной работы

Рендеринг в браузере, выбор маршрутов и более длительное ожидание означают, что платформе нужно делать больше, чем просто возвращать простой ответ.

Больше неопределенности цели

Перенаправления, пустые состояния, ограничения по скорости и страницы с вызовами часто требуют более сильных вариантов доставки или повторных попыток.

Больше состояния для сохранения

Cookies, сессии, согласие и многостраничные потоки добавляют движущиеся части, которых нет у простого безстатусного запроса.

Больше доказательств для возврата

Скриншоты, PDF-файлы, отрендеренный вывод и более богатые артефакты ответа полезны, но они тяжелее, чем простой HTML.

Как поддерживать расходы в соответствии с доказательствами захвата

Протестируйте перед масштабированием

Сначала протестируйте небольшой набор URL и группируйте цели по самому легкому профилю, который возвращает полные данные.

Не рендерить по умолчанию

Проверьте сырой HTML перед включением рендеринга. Многие публичные страницы уже содержат необходимые вам данные.

Эскалируйте по фактам

Переходите на более высокий уровень только когда ответ показывает отсутствие контента, зависимость состояния, гео-вариации или проблемы с маршрутизацией.

Измеряйте полезные результаты

Оптимизируйте на основе действительных записей, а не объема сырых запросов. Более легкий профиль лучше всего, только когда он остается полным.

Часто задаваемые вопросы о альтернативе

Распространенные вопросы о выборе ScraperFly в качестве альтернативы Zyte

Практические ответы для команд, сравнивающих специализированный API захвата с более широкими управляемыми платформами парсинга и извлечения.

Ответы альтернатив Zyte

Выбор операционной модели

Для команд, решающих, нужно ли им управляемое извлечение или целенаправленный захват.

Когда ScraperFly подходит лучше?

Когда ваша команда хочет владеть парсингом, валидацией и хранением, используя один API для захвата публичных страниц и форматов ответов.

Когда может подойти более широкая платформа?

Когда решение о покупке включает схемы извлечения, управляемые поставщиком, операции обхода или более крупную модель доставки данных.

Форматы ответа

Для команд, отправляющих захваченные страницы в существующие системы.

С какого формата мне начать?

Начните с формата, который может использовать ваша следующая система: HTML для парсеров, Markdown или текст для рабочих процессов контента, метаданные для отладки или скриншоты и PDF для доказательства.

ScraperFly делает извлечение полей за меня?

ScraperFly сосредоточен на форматах захвата и ответов. Ваше приложение может владеть специфическими для цели правилами парсинга, валидации и обогащения.

Рендеринг и маршрутизация

Для команд, решающих, когда делать запросы более тяжелыми.

Должна ли каждая страница использовать рендеринг?

Нет. Используйте рендеринг, когда исходный HTML не содержит полезного контента, который появляется после выполнения в браузере.

Когда следует эскалировать маршрутизацию?

Эскалируйте, когда доказательства ответа показывают сбои доступа, различия в географии, перенаправления или поведение страницы, которое простая доставка не может решить.

Бюджет и масштаб

Для команд, тестирующих цели, прежде чем объем станет предсказуемым.

Могу ли я протестировать перед обязательством?

Да. Начните с бесплатных кредитов и тестирования по мере необходимости, прежде чем переводить предсказуемые повторяющиеся нагрузки на ежемесячные кредиты.

Как мне избежать переплаты?

Держите простые захваты легкими и добавляйте рендеринг, маршрутизацию, скриншоты, PDF или другие более тяжелые элементы только там, где они улучшают ответ.













