






Форматы ответа API для веб-скрапинга — это формы вывода, возвращаемые после захвата публичной страницы, включая HTML, текст, Markdown, метаданные JSON, скриншоты и PDF. Правильный формат зависит от последующей задачи: парсинга разметки, подачи в AI-пipeline, проверки контента, мониторинга изменений, архивирования доказательств или сохранения визуальной записи.
Ранний выбор формата ответа предотвращает ненужную очистку. Это также помогает командам избежать создания конвертеров, инструментов захвата браузера и логики обработки, прежде чем они поймут, что на самом деле нужно продукту.
ScraperFly позволяет разработчикам тестировать несколько форматов вывода на одном и том же публичном целевом URL. Это делает выбор формата инженерным решением, основанным на реальных ответах, а не предположениях.
Что такое форматы ответа API для веб-скрапинга?
Формат ответа API для веб-скрапинга определяет, как захваченная публичная страница возвращается клиентскому приложению.
Целевой объект может быть одинаковым, но ответ может служить очень разным рабочим процессам. HTML сохраняет структуру страницы. Текст удаляет большую часть разметки. Markdown сохраняет читаемую структуру для рабочих процессов с контентом. Метаданные JSON описывают запрос и контекст страницы. Скриншоты и PDF сохраняют визуальные доказательства.
Формат отделен от метода захвата. Страница может быть получена через обычный HTTP-запрос или отрендерена в браузере перед созданием выбранного вывода.
| Формат | Лучше всего для | Не идеально для | Пример вывода | Пользователь на downstream |
|---|---|---|---|---|
| Сырой HTML | Парсинг DOM, селекторы, ссылки, атрибуты | Чистый ввод контента без предварительной обработки | Тело ответа HTML | Разработчик бэкенда |
| Отрендеренный HTML | Содержимое DOM, сгенерированное JavaScript | Статические страницы, которые уже содержат необходимые данные | HTML, сгенерированный браузером | Инженер по скрапингу |
| Простой текст | Индексация поиска, легкий анализ, простая проверка | Рабочие процессы, которым нужны заголовки, ссылки или макет | Чистый читаемый текст | Команда данных или поиска |
| Markdown | Подача AI/RAG, редакторская проверка, документация | Точный парсинг DOM | Заголовки, абзацы, списки, ссылки | Команда продукта AI |
| Метаданные JSON | Статус, финальный URL, тип контента, контекст запроса | Произвольный извлечение полей из цели | Структурированный контекст ответа | Инженер платформы |
| Скриншот | Визуальная QA, мониторинг, доказательства макета | Структурированные данные, которые можно искать | Изображение артефакта | Команда QA или мониторинга |
| Архивирование, одобрение, переносимые записи | Тонкая парсинг контента | Документ для загрузки | Команда соблюдения или операций |
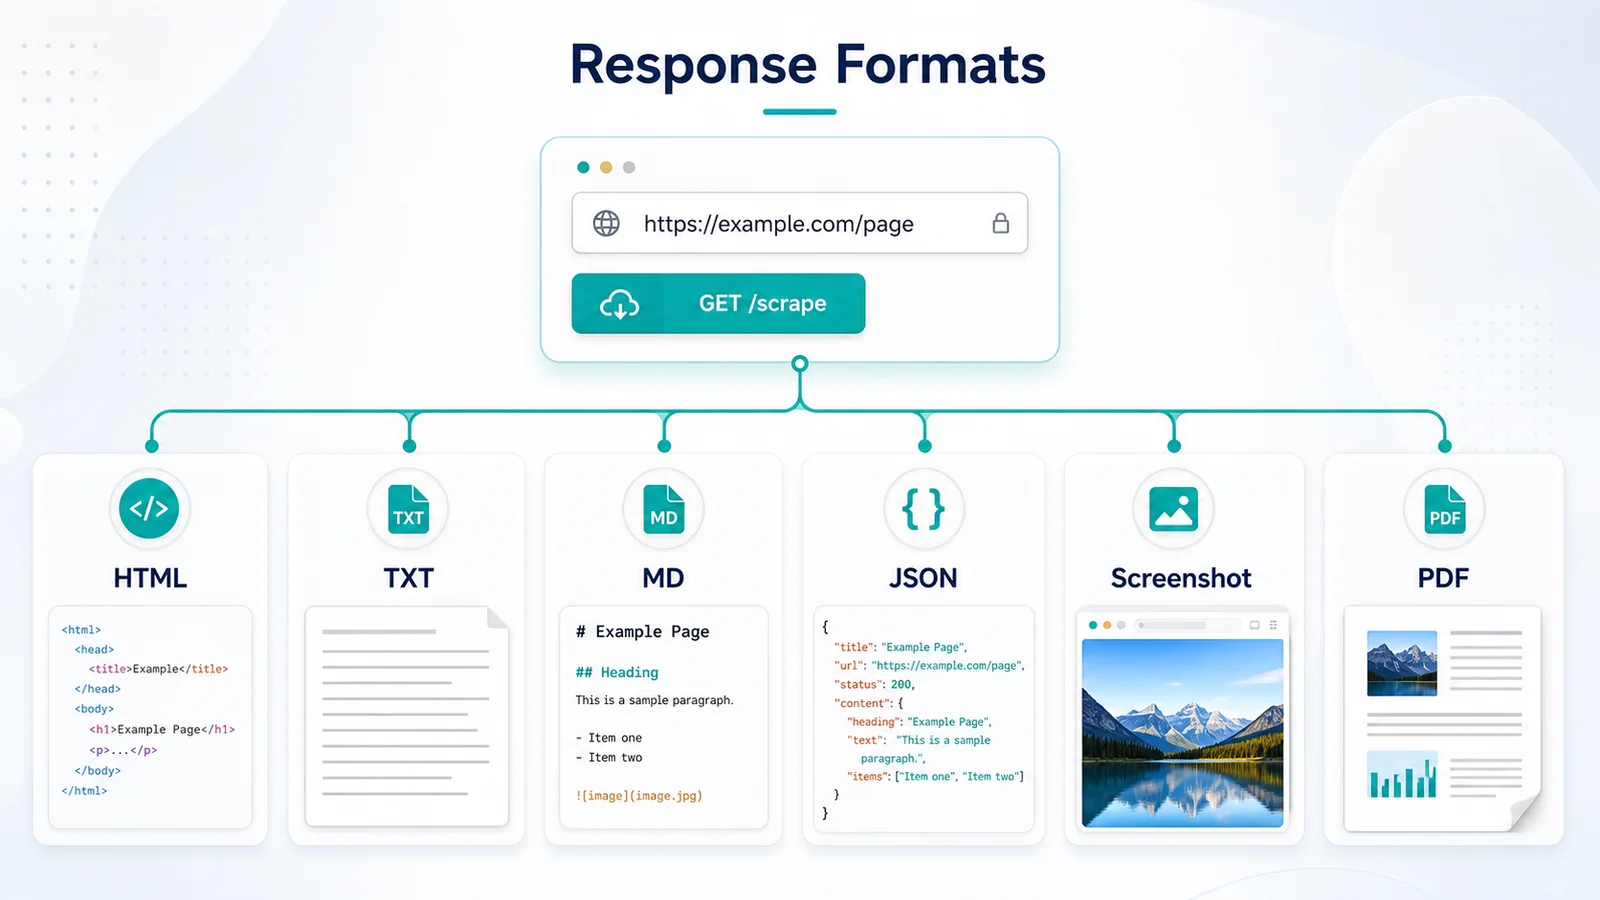
Практическое резюме: рассматривайте формат вывода как часть архитектуры приложения, а не как косметическую опцию API.
Почему формат ответа важен после захвата страницы?
Запрос — это только начало рабочего процесса скрапинга. Ответ все еще должен перейти в парсер, индекс поиска, AI pipeline, систему мониторинга, архив или интерфейс продукта.
Плохой выбор формата смещает работу вниз по потоку.
Например, отправка сырого HTML в AI ingestion pipeline может потребовать удаления шаблонов, фильтрации навигации, очистки ссылок и нормализации контента. Возвращение простого текста в парсер может удалить отношения DOM, необходимые для идентификации цен, заголовков, таблиц или атрибутов продукта.
Та же проблема возникает в визуальных рабочих процессах. Команда, которой нужно доказательство того, как страница выглядела, может сначала захватить HTML, а затем поддерживать отдельные рабочие процессы Playwright или Puppeteer для генерации скриншотов. Подходящий визуальный вывод может устранить этот дополнительный уровень.
Выбор формата влияет на:
- сколько очистки выполняет приложение;
- сохраняется ли структура страницы;
- насколько легко разработчикам отлаживать результат;
- подходит ли ответ для автоматизированной обработки;
- сколько хранилища и пропускной способности использует pipeline;
- необходим ли отдельный конвертер или рабочий процесс браузера.
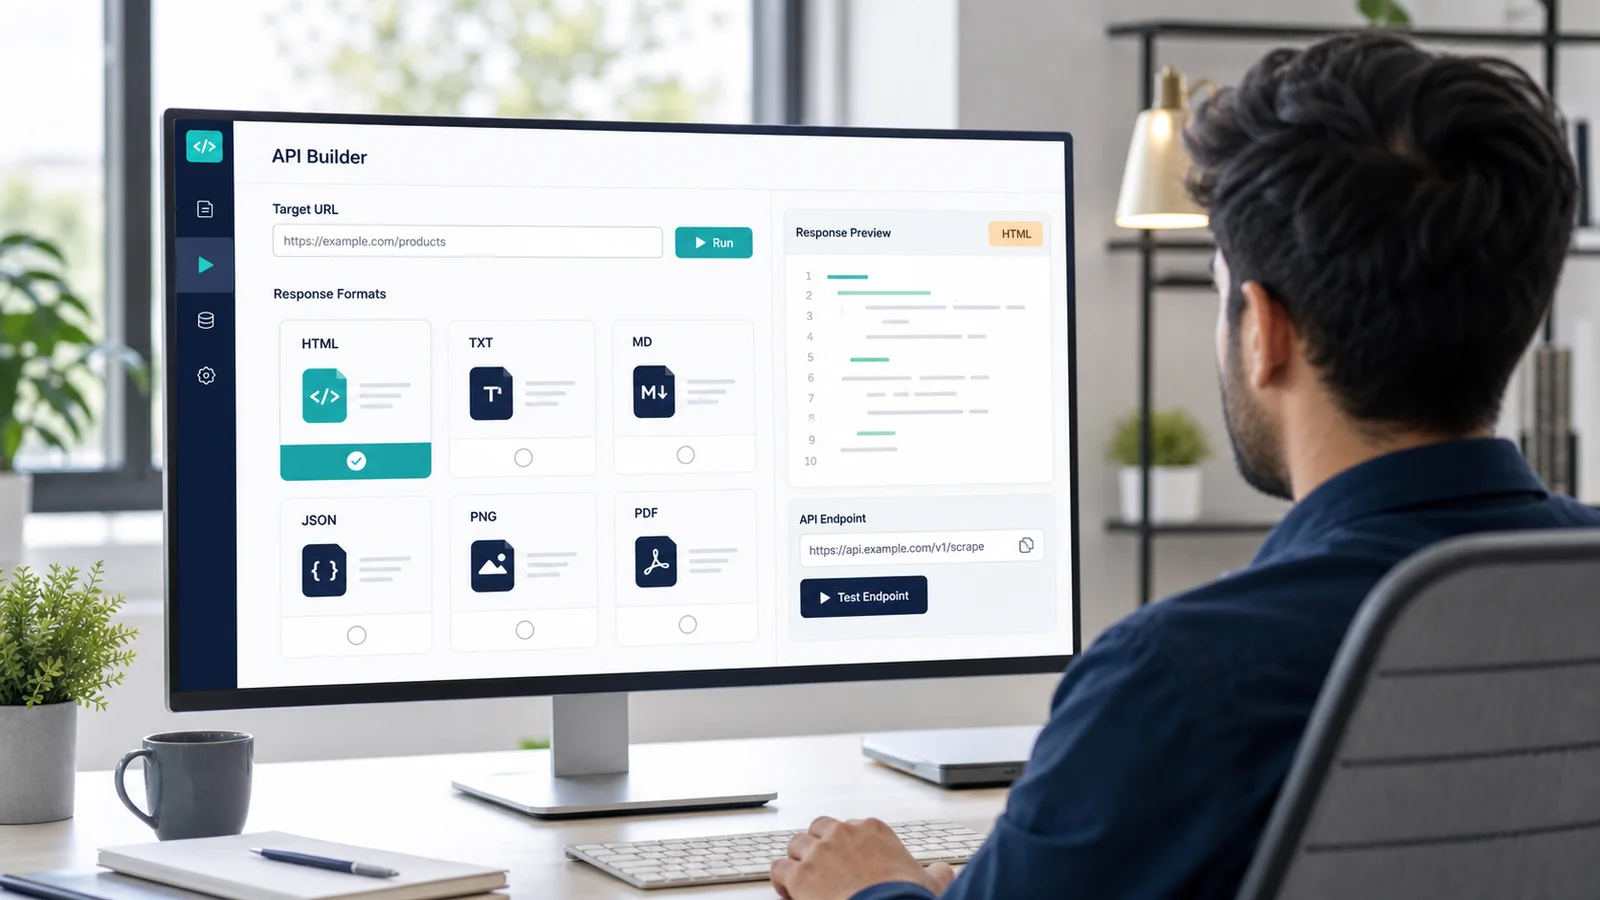
Перед написанием кода трансформации протестируйте цель через API Builder. Сравните тело ответа, структуру контента, размер и удобство использования по форматам.
Практическое резюме: выбирайте формат перед созданием конвертеров, потому что последующая очистка может стоить больше инженерного времени, чем оригинальный запрос.
Когда рабочий процесс скрапинга должен использовать вывод HTML?
HTML — это правильный формат, когда приложению нужна оригинальная структура страницы.
Парсер может проверять теги, классы, атрибуты, заголовки, ссылки, таблицы, встроенные метаданные и отношения DOM. Это делает HTML подходящим для логики извлечения, где приложение уже знает, какие элементы важны.
Общие рабочие процессы с HTML включают:
- извлечение полей продукта с помощью селекторов;
- поиск ссылок для краулера;
- парсинг структурированных таблиц;
- чтение канонических тегов или метаданных;
- идентификация секций страницы по иерархии DOM;
- хранение исходной разметки для последующей обработки.
Сырой HTML — это начальный ответ сервера. Обычно это самое легкое место для начала.
Отрендеренный HTML — это DOM, созданный после того, как браузер запустил JavaScript страницы. Это важно, когда требуемое содержимое отсутствует в оригинальном ответе.
| Вопрос | Сырой HTML | Отрендеренный HTML |
|---|---|---|
| Откуда он берется? | Первоначальный HTTP-ответ | DOM, сгенерированный браузером |
| Запускается ли JavaScript? | Нет | Да |
| Лучше всего для | Статические и серверно-рендеренные страницы | Клиентские приложения, рендеренные браузером |
| Типичная задержка | Ниже | Выше |
| Относительный вес запроса | Легче | Тяжелее |
| Основной риск | Отсутствие контента, сгенерированного браузером | Использование браузера, когда это не нужно |
| Метод валидации | Поиск в ответе необходимого контента | Сравнение отрендеренного DOM с сырым HTML |
HTML не автоматически лучше, потому что он содержит больше информации. Он может включать навигацию, скрипты, стили, код отслеживания и несвязанные элементы страницы. Этот шум приемлем, когда парсеру нужна структурная контроль, но неэффективен, когда цель — читаемый контент.
Практическое резюме: используйте HTML, когда структура DOM является входом для вашей логики, и выбирайте отрендеренный HTML только тогда, когда JavaScript создает необходимый вам контент.
Когда текст и Markdown лучше, чем HTML?
Текст и Markdown полезны, когда последующий рабочий процесс нуждается в читаемом контенте страницы, а не в полном контроле DOM.
Простой текст удаляет большую часть визуальной и структурной разметки. Он хорошо подходит для анализа ключевых слов, индексации поиска, сравнения контента, простой классификации и рабочих процессов, где заголовки или ссылки не являются обязательными.
Markdown сохраняет больше смысла. Заголовки, абзацы, списки и ссылки остаются легче интерпретируемыми, чем в плоском тексте. Это часто делает Markdown полезным для:
- Подготовка документов RAG;
- Подача LLM;
- Редакторская проверка;
- Импорт базы знаний;
- Контекст подсказки;
- Анализ документации;
- Миграция контента.
Markdown не является заменой для точного парсинга HTML. Если приложению необходимо идентифицировать цену продукта по конкретному селектору, отличить навигационные ссылки от ссылок в теле или проверить атрибуты, HTML остается более безопасным выбором.
Качество Markdown также зависит от исходной страницы. Чистые редакционные страницы обычно конвертируются более предсказуемо, чем высокоинтерактивные макеты, панели управления, сложные таблицы или страницы с фрагментированным контентом.
| Рабочий процесс | Рекомендуемый формат | Дополнительный формат | Почему |
|---|---|---|---|
| Пользовательский парсер | HTML | Метаданные JSON | Сохраняет селекторы и отношения DOM |
| Подача AI/RAG | Markdown | Текст или HTML | Сохраняет читаемую иерархию и ссылки |
| Индексация поиска | Текст | Markdown | Снижает разметку и шум обработки |
| Мониторинг контента | Текст или HTML | Скриншот | Поддерживает машинное сравнение и визуальную проверку |
| Проверка QA | Скриншот | HTML | Показывает отрендеренный вид с исходными доказательствами |
| Архив | HTML или скриншот | Создает переносимую запись | |
| Отчетность | Текст или Markdown | Скриншот | Поддерживает резюме с визуальным контекстом |
Хороший рабочий процесс AI может использовать более одного формата. Markdown может предоставить читаемый контент, в то время как метаданные JSON фиксируют финальный URL, тип контента, статус и контекст захвата.
Практическое резюме: используйте текст для компактного читаемого контента, Markdown для сохраненной структуры документа и HTML, когда извлечение зависит от DOM.
Что команды должны ожидать от вывода метаданных JSON?
Метаданные JSON предоставляют структурированный контекст о захвате и ответе. Они не превращают каждую целевую страницу в пользовательскую бизнес-схему автоматически.
Полезные метаданные могут включать информацию, такую как:
- статус запроса;
- целевой URL;
- финальный URL после перенаправлений;
- тип контента;
- размер ответа;
- время или контекст запроса;
- выбранный формат ответа;
- подробности захвата или маршрутизации, поддерживаемые API.
Эта структура ценна для ведения журналов, мониторинга, отладки и координации последующей обработки. Pipeline может использовать метаданные, чтобы решить, следует ли парсить, хранить, повторять или отклонять тело.
Тем не менее, метаданные JSON не следует путать с произвольным извлечением схемы.
Например, ответ JSON не обязательно означает, что API автоматически идентифицирует каждое название продукта, цену, рейтинг, автора, компанию или поле статьи на любом веб-сайте. Извлечение, специфичное для цели, все еще требует логики парсера, поддерживаемых функций извлечения или отдельного слоя трансформации.
Практическая схема — это комбинирование метаданных с другим ответом:
- HTML плюс метаданные для рабочих процессов парсера;
- Markdown плюс метаданные для подачи AI;
- скриншот плюс метаданные для доказательств QA;
- PDF плюс метаданные для архивных записей.
Практическое резюме: используйте метаданные JSON, чтобы понять запрос и контекст страницы, а не как предположение, что каждая страница станет пользовательским структурированным набором данных.
Когда скриншоты и PDF являются правильным выводом API для скрапинга?
Скриншоты и PDF подходят, когда визуальный вид является частью доказательства.
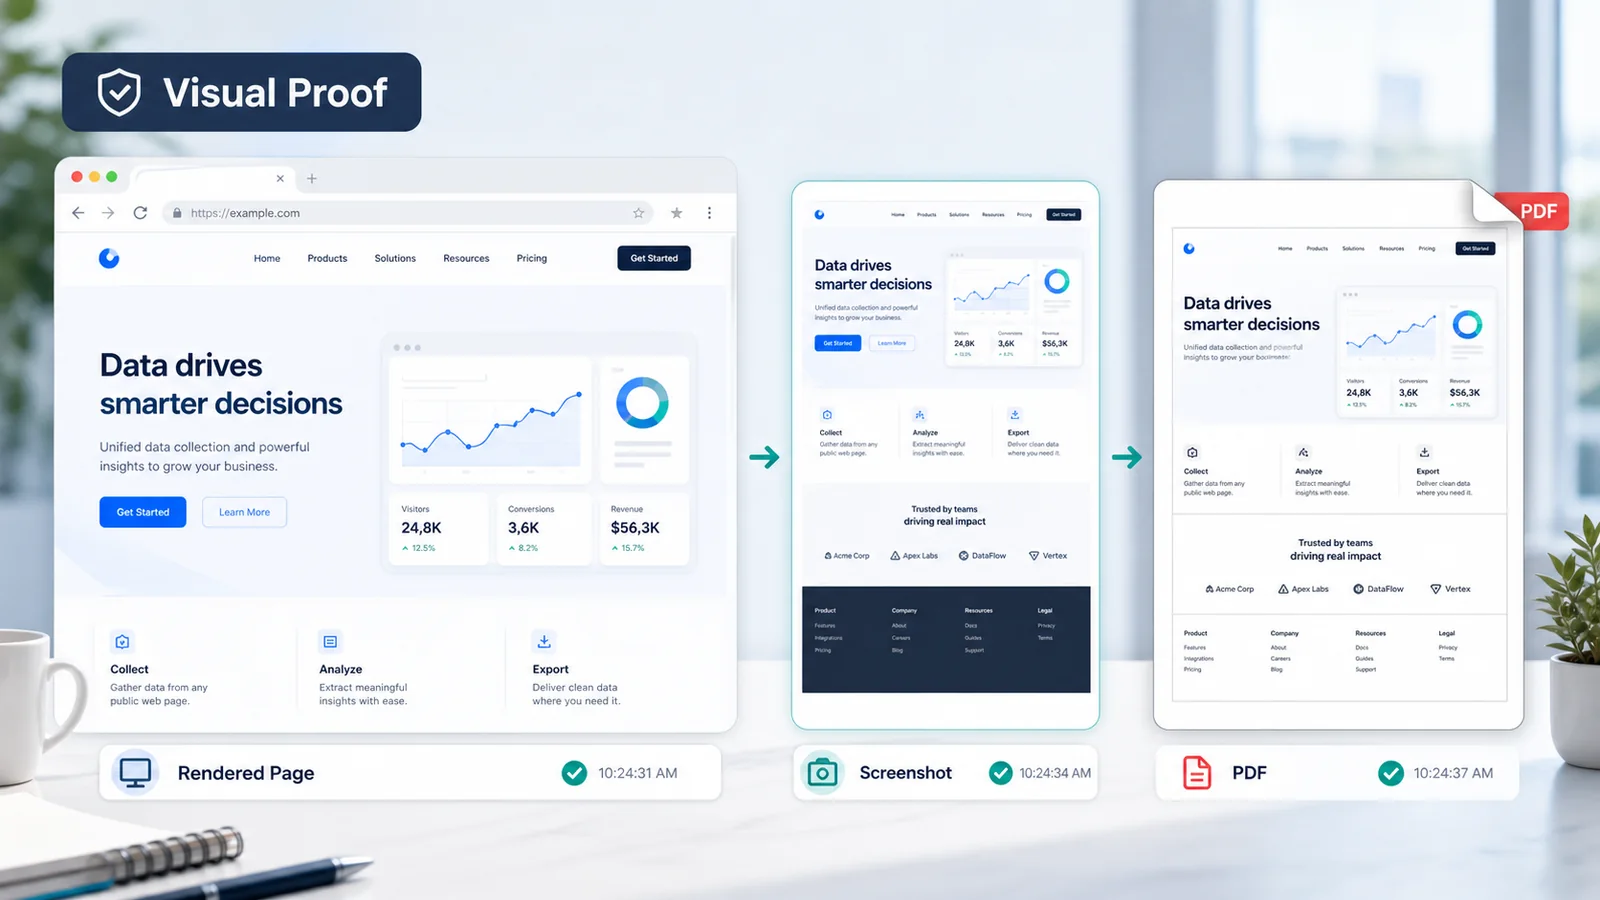
HTML и текст могут показать, какой контент был возвращен, но они могут не доказать, как браузер отображал страницу. Скриншот может захватить макет, видимые ошибки, экраны согласия, отсутствующие компоненты, изменения в адаптивности или регионально-специфическую презентацию.
Скриншоты полезны для:
- визуального регрессионного мониторинга;
- QA отрендеренной страницы;
- верификации макета;
- проверки кампаний и целевых страниц;
- воспроизведения проблем;
- рабочих процессов одобрения человеком.
PDF лучше, когда результат должен быть сохранен, передан, распечатан, проверен или сохранен как артефакт, похожий на документ. Они могут поддерживать архив, проверку соблюдения, одобрение и ведение оперативных записей.
| Формат доказательства | Лучшее использование | Основное преимущество | Основное ограничение |
|---|---|---|---|
| Скриншот | Визуальная QA и доказательства состояния страницы | Показывает, что появилось в области просмотра | Неудобно для структурированного поиска |
| Архив, проверка и переносимые записи | Сохраняет артефакт, похожий на документ | Больше и труднее парсить | |
| HTML | Доказательства источника и DOM | Структура, читаемая машиной | Может не соответствовать окончательному визуальному виду |
| Текст или Markdown | Доказательства контента | Легко искать и анализировать | Теряет визуальный макет |
Визуальный вывод должен дополнять данные, читаемые машиной, а не заменять их. Рабочий процесс мониторинга может автоматически сравнивать HTML или текст и генерировать скриншот только тогда, когда обнаруживается значительное изменение.
Скриншоты и PDF также тяжелее, чем простой текст или сырой HTML. Проверьте текущие варианты кредитов на Цены перед генерацией визуальных артефактов для каждого запроса.
Практическое резюме: выбирайте скриншоты для визуального состояния и PDF для переносимых записей, сохраняя HTML или текст, когда системе также нужны доказательства, читаемые машиной.
Как рендеринг JavaScript изменяет качество формата ответа?
Рендеринг JavaScript улучшает качество вывода только тогда, когда цель зависит от выполнения браузера.
Сырой HTTP-ответ может содержать полную статью, страницу продукта или страницу документации. В этом случае рендеринг добавляет задержку и вес запроса, не улучшая выбранный формат.
Другие страницы возвращают оболочку приложения и загружают контент после того, как браузер запускается. Ответ Markdown или скриншот, созданный до появления этого контента, может быть неполным. Рендеринг позволяет браузеру построить DOM перед тем, как ScraperFly произведет запрашиваемый вывод.
Общие признаки того, что рендеринг может быть необходим, включают:
- сырой HTML не содержит видимого текста страницы;
- списки или таблицы появляются только после загрузки страницы;
- клиентские фреймворки вставляют основной контент;
- скриншот показывает пустую оболочку;
- цель загружает данные через фоновые запросы;
- задержанные компоненты требуют контролируемого ожидания.
Не предполагайте, что вывод Markdown, скриншота или PDF автоматически требует рендеринга. Решение должно исходить из поведения цели.
Сначала протестируйте страницу без рендеринга. Найдите необходимый контент. Затем сравните ответ с запросом, включающим браузер, используя API рендеринга JavaScript.
Практическое резюме: рендеринг улучшает формат только тогда, когда выполнение браузера изменяет контент, из которого этот формат построен.
Формат для производства должен быть выбран из требований downstream назад.
Используйте этот процесс принятия решений:
- Определите потребителя. Определите, идет ли ответ к парсеру, LLM, индексу поиска, проверяющему QA, архиву или системе мониторинга.
- Определите необходимые доказательства. Решите, нужны ли рабочему процессу структура DOM, читаемый контент, контекст запроса, визуальный вид или переносимая запись.
- Сначала протестируйте сырой захват. Подтвердите, существует ли необходимый контент без рендеринга браузера.
- Сравните форматы на одной цели. Оцените HTML, текст, Markdown, метаданные или визуальный вывод, используя тот же публичный URL.
- Измерьте очистку. Выберите ответ, который требует наименьшей надежной пользовательской трансформации.
- Проверьте размер и вес ответа. Избегайте хранения или генерации большего объема данных, чем использует приложение.
- Документируйте профиль запроса. Запишите выбранный формат, настройки рендеринга, ожидания, маршрутизацию, заголовки и ожидаемый вывод.
Выбранный формат может отличаться в зависимости от группы целей. Редакционные страницы могут подходить для Markdown, страницы электронной коммерции могут требовать HTML, а визуальный мониторинг может комбинировать текст со скриншотами.
Один глобальный профиль ответа удобен, но редко оптимален для смешанной производственной нагрузки.
Практическое резюме: выбирайте форматы по классу рабочего процесса, проверяйте их на репрезентативных целях и записывайте проверенный профиль запроса перед масштабированием.
Как форматы ответа влияют на стоимость и вес запроса?
Форматы ответа влияют на пропускную способность, хранилище, время обработки и кредиты API.
Базовый ответ HTML или текст обычно легче, чем скриншот или PDF, отрендеренные браузером. Разница становится важной при производственном объеме.
| Профиль вывода | Относительный вес | Стоимость оправдана, когда | Избегайте, когда |
|---|---|---|---|
| Сырой HTML | Легкий | Требуется DOM или исходная разметка | Нужен только читаемый контент |
| Простой текст | Легкий | Цель — компактная обработка контента | Структура и ссылки имеют значение |
| Markdown | Легкий до умеренного | Рабочие процессы AI или редакции выигрывают от иерархии | Требуется точный парсинг DOM |
| Метаданные JSON | Легкий | Контекст запроса поддерживает операции | Ожидается, что он заменит парсинг |
| Отрендеренный HTML | Выше | JavaScript создает необходимый контент | Сырой HTML уже полный |
| Скриншот | Выше | Требуется визуальное доказательство или QA | Каждый запрос обрабатывается только машиной |
| Выше | Требуется переносимая архивная запись | Артефакт никогда не проверяется или не сохраняется |
Контроль затрат должен начинаться с репрезентативных целей. Группируйте запросы по формату и потребности в рендеринге, а не оценивайте каждый URL, как будто он требует самого тяжелого профиля.
Кредиты ScraperFly позволяют связать вес запроса с включенными контролями. Команды могут начать с бесплатного теста, сравнить форматы и оценить фактическую нагрузку, используя калькулятор стоимости кредитов API для веб-скрапинга.
Практическое резюме: резервируйте отрендеренные и файловые выводы для рабочих процессов, которые используют их дополнительные доказательства.
Какие ошибки команды должны избегать при выборе вывода API для скрапинга?
Самая распространенная ошибка — это выбор знакомого формата вместо формата, который нужен продукту.
Избегайте этих шаблонов:
Отправка HTML повсюду. Сырая разметка добавляет ненужную очистку к контенту и AI-пайплайнам.
Использование текста для точного извлечения. Простой текст удаляет отношения DOM, от которых могут зависеть парсеры.
Предположение, что Markdown идеален для каждой страницы. Сложные таблицы, интерактивные компоненты и необычные макеты могут не конвертироваться чисто.
Отношение к метаданным JSON как к пользовательскому извлечению. Структурированный контекст запроса не является тем же самым, что и специфическая для цели бизнес-схема.
Генерация скриншотов для машинных рабочих процессов. Визуальные файлы добавляют вес, но предоставляют мало ценности, когда ни один человек или система визуального сравнения не использует их.
Использование PDF в качестве входа для парсера. PDF полезны как записи, но редко являются самым эффективным источником для структурированного извлечения.
Рендеринг каждого запроса. Выполнение браузера должно решать продемонстрированную проблему с контентом.
Создание конвертеров перед тестированием форматов. Команда может потратить дни на воспроизведение вывода, который API уже может вернуть.
Использование одного формата для каждой цели. Разные типы страниц и downstream-потребители часто нуждаются в разных профилях.
Тестируйте репрезентативные страницы через API Builder, сравнивайте вывод и выбирайте на основе удобства использования, а не популярности формата.
Практическое резюме: проверьте ответ с его реальным downstream-потребителем, прежде чем привязывать архитектуру производства.
ВОПРОСЫ ПОКУПАТЕЛЯ
Распространенные вопросы перед выбором формата ответа
Ответьте на практические вопросы оценки вокруг HTML, текста, Markdown, метаданных JSON, скриншотов, PDF, рендеринга, веса запроса и производственной удобства.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ О ВЫВОДЕMarkdown, текст и AI-пайплайны
Выбирайте читаемый вывод, когда потребителем являются поиск, RAG, редакторская проверка или легкий анализ контента.
Является ли Markdown всегда лучшим форматом для AI или RAG-пайплайна?
Нет. Markdown полезен, когда заголовки, списки и ссылки улучшают контекст документа. Простой текст может быть лучше для компактной обработки, в то время как HTML может потребоваться, когда контент должен быть сначала выбран из конкретных элементов DOM.
Может ли одно приложение использовать разные форматы ответа для разных целей?
Да. Производственное приложение может классифицировать цели по рабочему процессу. Страницы документации могут использовать Markdown, страницы продуктов могут использовать HTML, а цели визуального мониторинга могут использовать скриншоты.
HTML плюс контекст ответа
Используйте структурированный контекст для отладки, маршрутизации и ведения журналов запросов, не притворяясь, что метаданные являются пользовательским экстрактором.
Может ли API для скрапинга вернуть HTML и метаданные для одного и того же рабочего процесса?
Да, рабочий процесс может использовать содержимое страницы вместе с контекстом ответа. HTML поддерживает парсинг, в то время как метаданные могут фиксировать статус, финальный URL, тип контента, размер ответа и другие детали запроса, поддерживаемые API.
Автоматически ли извлекает JSON-вывод продукты или поля статьи?
Нет. Метаданные JSON описывают захват или ответ. Их не следует интерпретировать как автоматическое извлечение произвольных полей, таких как цены, авторы, рейтинги или атрибуты продукта.
Скриншоты, PDF и отрендеренный вывод
Добавляйте визуальные артефакты, когда важны проверка, архив или доказательства внешнего вида, а не для каждого запроса только для машин.
Следует ли генерировать скриншоты для каждой контролируемой страницы?
Обычно нет. Читаемый машиной HTML или текст лучше для автоматизированного сравнения. Скриншоты наиболее ценны, когда изменение требует визуального подтверждения, проверки человеком или доказательства макета.
В чем разница между отрендеренным HTML и скриншотом?
Отрендеренный HTML содержит DOM после выполнения браузера и остается подходящим для парсинга. Скриншот — это изображение, показывающее, как страница выглядела визуально. Эти два формата отвечают на разные вопросы.
Когда рабочий процесс скрапинга должен использовать вывод PDF?
Используйте PDF, когда захваченная страница должна стать переносимым документом для проверки, одобрения, архивирования или ведения записей. Используйте HTML, текст или Markdown, когда автоматизированная обработка является основной необходимостью.
Тестирование перед интеграцией
Сравните форматы на репрезентативных целях перед тем, как команда создаст конвертеры или масштабирует тяжелый профиль.
Как разработчики должны сравнивать форматы перед интеграцией?
Запустите один и тот же репрезентативный целевой URL через API Builder, используя несколько форматов. Сравните структуру, отсутствующий контент, размер ответа, потребности в рендеринге, требования к очистке и удобство использования downstream перед выбором производственного профиля.
Тестируйте форму ответа перед тем, как привязывать архитектуру
Пайплайн скрапинга становится легче поддерживать, когда API возвращает форму, которую продукт может использовать немедленно.
ScraperFly позволяет командам захватывать публичные страницы в виде HTML, текста, Markdown, метаданных JSON, скриншотов или PDF через одну модель запроса. Начните с репрезентативной цели, сравните форматы в API Builder, включайте рендеринг браузера только тогда, когда это необходимо, и сохраняйте визуальные выводы для рабочих процессов, которые используют визуальные доказательства.
Лучший формат ответа — это не тот, который содержит больше данных. Это тот, который устраняет ненужную обработку, сохраняя доказательства, которые нужны вашему приложению.









