






Рабочий процесс JSON-ответа
Возвращайте контекст страницы в формате JSON, не притворяясь, что каждая цель имеет одинаковую схему
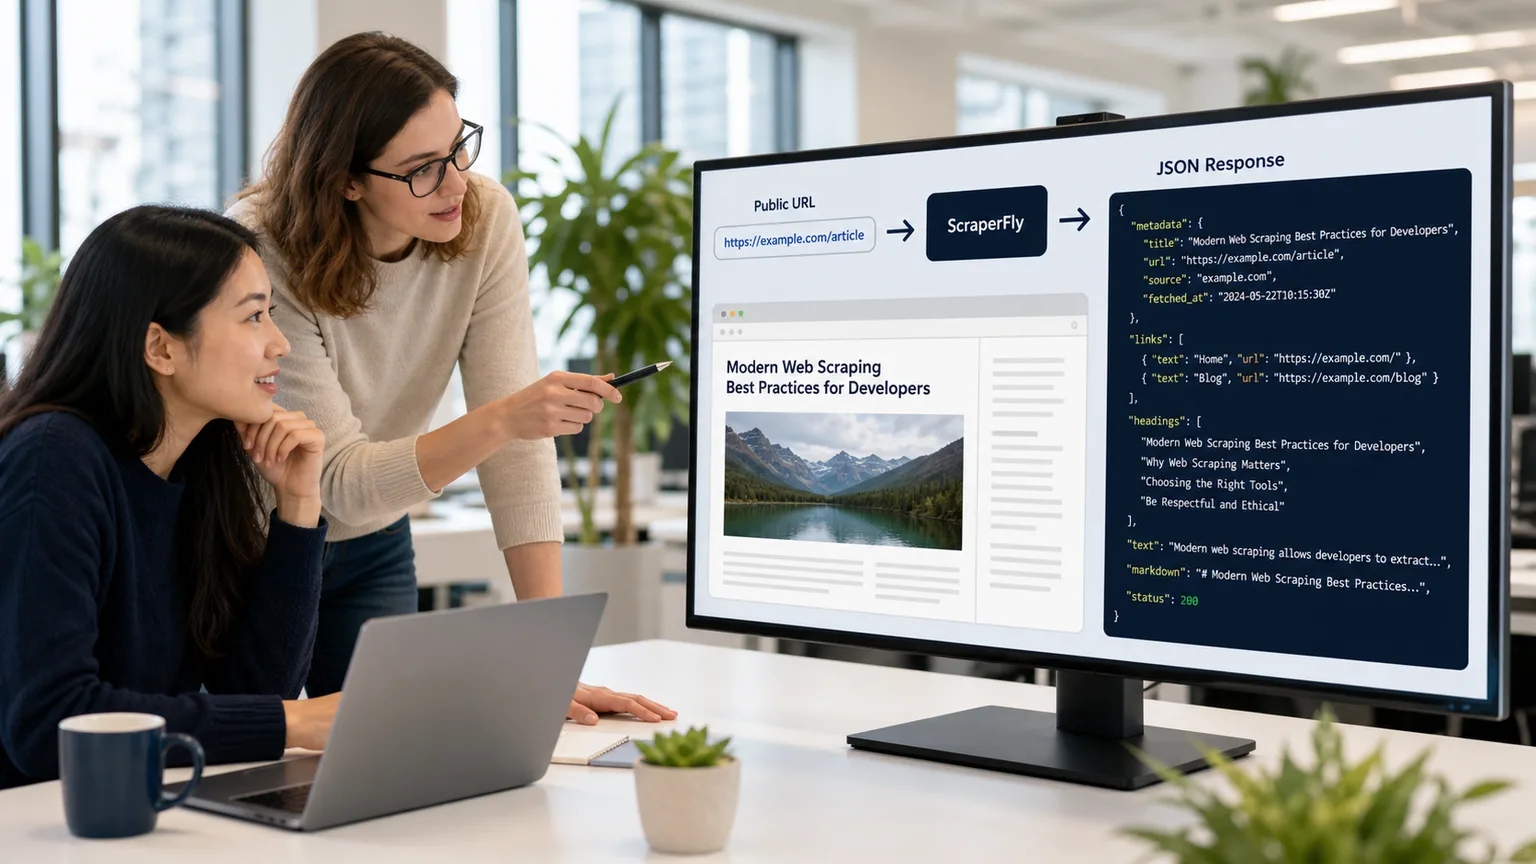
Рабочий процесс «веб-сайт в JSON» полезен, когда вашему приложению нужен предсказуемый ответ, обрамляющий данные публичной страницы. ScraperFly помогает разработчикам захватывать страницу, сохранять доказательства запроса и возвращать поддерживаемый контекст, такой как метаданные, ссылки, заголовки, текст, Markdown, статус, конечный URL и детали ответа.
Важная граница — это честность. ScraperFly может подготовить ответ публичной страницы и упростить его программную проверку, но ваш продукт все равно должен владеть специфической для цели экстракцией для пользовательских полей, таких как цены, доступность, рейтинги, имена авторов или внутренние бизнес-единицы.
Что значит «скрапить веб-сайт в JSON»?
Скрапинг веб-сайта в JSON означает получение публичного URL и возврат полезного контекста страницы в структурированном ответе, который ваше приложение может прочитать. Вместо того чтобы передавать каждой системе на downstream необработанный блок HTML, ответ API может содержать метаданные, ссылки, заголовки, читаемый текст, Markdown, статус запроса, конечный URL, тип контента и другие доказательства ответа в полях, которые легче регистрировать, проверять, сравнивать и маршрутизировать.
Это не делает каждый веб-сайт чистой таблицей базы данных. Публичные страницы не имеют одной схемы. Страница продукта, статья, список в каталоге, страница результатов поиска и страница документации все имеют разные структуры. ScraperFly предоставляет вашей команде стабильный уровень захвата и поддерживаемые формы ответа; ваш парсер все равно решает, какие специфические для цели поля важны для вашего случая использования.
Практическое резюме: используйте вывод «веб-сайт в JSON» для контекста страницы и доказательств запроса, затем добавьте пользовательскую логику экстракции, где бизнес-схема специфична для цели.
Когда JSON — это правильная форма ответа?
JSON — это правильная форма, когда потребителем является серверная служба, рабочий процесс очереди, мониторинг, агент, конвейер данных или внутренний инструмент, который ожидает предсказуемых ключей. Это помогает, когда вашему рабочему процессу нужно хранить конечный URL, статус, метаданные страницы, обнаруженные ссылки, заголовки, текст, Markdown и диагностику рядом с захваченным контентом. Это упрощает отладку и маршрутизацию на downstream, потому что приложению не нужно догадываться о каждой детали из одной строки HTML.
HTML по-прежнему является лучшим основным входом, когда важны селекторы, атрибуты, структура таблицы, отношения DOM или встроенное состояние. Текст и Markdown часто лучше, когда цель — поиск, резюмирование, классификация, обзор или поглощение ИИ. JSON наиболее силен, когда он оборачивает эти полезные выводы с отслеживаемым контекстом.
| Форма ответа | Используйте, когда | Что избегать |
|---|---|---|
| JSON-контекст | Вашему серверу нужны метаданные, ссылки, заголовки, текст, Markdown и доказательства запроса в предсказуемых полях | Не рассматривайте JSON на уровне страницы как автоматическую пользовательскую экстракцию. |
| Необработанный HTML | Вашему парсеру нужны селекторы, атрибуты, таблицы, ссылки или встроенная структура источника | Не преобразовывайте в текст слишком рано, если важны отношения DOM. |
| Сгенерированный HTML | Полезный публичный контент появляется только после выполнения JavaScript | Не рендерите каждую страницу, прежде чем убедиться, что ответ источника неполный. |
| Текст | Вам нужен компактный читаемый контент для поиска, индексации или простого сравнения | Не используйте простой текст, когда требуются структурированные отношения страницы. |
| Markdown | Вы хотите читаемые заголовки, списки и ссылки для ИИ или рабочих процессов обзора | Не ожидайте, что Markdown сохранит каждый селектор или деталь макета. |
| Скриншот или PDF | Вам нужно визуальное доказательство, обзор QA, архивный вывод или читаемая человеком запись | Не используйте визуальные файлы в качестве основного входа парсера, когда достаточно машинно-читаемых данных. |
Какие поля JSON полезны в производственных рабочих процессах?
Полезный JSON начинается с отслеживаемости. Ваше приложение должно знать, какой URL был запрошен, куда в конечном итоге попал запрос, какой статус вернулся, какой тип контента был возвращен и насколько велик был ответ. Эти доказательства помогают отделить реальное изменение цели от перенаправления, тонкого ответа, страницы блокировки, таймаута или неподдерживаемого формата.
Контекст страницы идет следующим. Метаданные, заголовки, описания, заголовки, канонические подсказки, ссылки, чистый текст и Markdown могут помочь конвейеру решить, что парсить, индексировать, резюмировать, архивировать или отправлять в другую службу. Для рабочих процессов ИИ и RAG метаданные JSON плюс Markdown могут быть сильнее, чем простой текст, потому что ответ содержит читаемый контент и операционный контекст вместе.
Специфические для цели поля идут после этого. Если вашему продукту нужны цена, SKU, автор, рейтинг, должность, местоположение, дата события или доступность, создайте этот уровень экстракции вокруг целевых страниц, которые вы действительно поддерживаете. ScraperFly помогает получать и подготавливать ответ; ваше приложение определяет бизнес-схему.
Как командам тестировать вывод «веб-сайт в JSON»?
Начните с одного публичного целевого URL в API Builder. Сначала захватите ответ источника, проверьте возвращенный контекст и подтвердите, какие поля действительно присутствуют. Затем сравните альтернативные форматы: HTML для работы парсера, текст или Markdown для читаемого контента, метаданные JSON для диагностики и визуальный вывод, когда рецензенту нужно доказательство.
Если страница насыщена JavaScript, сравните исходный вывод с API рендеринга JavaScript или рабочим процессом API сгенерированного HTML. Рендеринг имеет смысл, когда он добавляет контент, который нужен вашему продукту. Если рендеринг не улучшает ответ, проверьте время, перенаправления, контекст запроса или поведение цели перед повторной попыткой.
| Шаг тестирования | Вопрос для ответа | Решение, которое он поддерживает |
|---|---|---|
| Получите публичный URL | Успешен ли ответ и попадает ли он на ожидаемый конечный URL? | Подтвердите, что цель доступна, прежде чем начинать работу парсера. |
| Проверьте исходный HTML | Содержит ли начальный ответ поля или контент, которые вам нужны? | Сохраняйте запрос легким, когда захват источника достаточно. |
| Сравните форматы вывода | Является ли HTML, текст, Markdown или контекст JSON лучшей формой для downstream? | Избегайте создания конвертеров вокруг неправильного формата. |
| Рендерите только при необходимости | Добавляет ли выполнение браузера значимый публичный контент? | Используйте рендеринг для реальных пробелов в контенте, а не как налог по умолчанию. |
| Определите пользовательскую экстракцию | Какие специфические для цели бизнес-поля нужны вашему приложению? | Сохраняйте ScraperFly в качестве уровня захвата, а ваш парсер в качестве уровня схемы. |
Как «веб-сайт в JSON» отличается от API парсера?
API парсера обычно подразумевает, что служба понимает специфическую для цели схему и возвращает пользовательские сущности. Ответ «веб-сайт в JSON» отличается. Он предоставляет вашему приложению структурированный контекст страницы и доказательства захвата, чтобы ваш собственный парсер мог принимать более обоснованные решения. Это различие делает рабочий процесс надежным, потому что публичные веб-сайты слишком различаются, чтобы притворяться, что каждая цель может быть сведена к одному и тому же объекту JSON.
Если вашей команде нужен чистый читаемый контент, сравните API парсинга контента веб-сайта, API парсера HTML в текст и API парсера HTML в Markdown. Если вам нужен парсинг на уровне DOM, начните с API скрапинга HTML или API парсера HTML для веб-скрапинга.
Как ScraperFly делает рабочие процессы JSON практичными?
ScraperFly делает рабочий процесс практичным, позволяя одному и тому же пути API начинать просто и добавлять управление, когда цель доказывает, что они необходимы. Публичная страница, которая возвращает полезный исходный HTML, может оставаться легкой. Страница, рендеренная клиентом, может использовать выполнение браузера. Маршрут с потребностями публичного контекста может добавлять заголовки, куки, таргетинг по странам или сессии. Рабочий процесс обзора может добавлять скриншоты или PDF. Каждый выбор должен улучшать ответ, а не просто увеличивать вес запроса.
Это важно для стоимости и поддерживаемости. Команды часто перегружают конвейеры «веб-сайт в JSON», пропуская каждую цель через браузер, преобразовывая все в один и тот же формат, а затем обнаруживая, что downstream парсер все еще нуждается в специфических для цели правилах. ScraperFly предоставляет вам средства захвата, форматы ответов и доказательства, чтобы сначала выбрать меньший путь. Страница цены и калькулятор стоимости кредитов API веб-скрапинга могут помочь оценить влияние, прежде чем объем вырастет.
Практическое резюме: лучший рабочий процесс «веб-сайт в JSON» предоставляет разработчикам четкий ответ, поддерживает вес запроса в соответствии с целью и оставляет пользовательскую бизнес-экстракцию там, где она принадлежит: в логике приложения.










