






Разметка, готовая для парсера
Получите надежный HTML перед тем, как правила извлечения будут зависеть от него
Парсер HTML так же надежен, как и исходный код страницы, который он получает. Если запрос возвращает тонкую оболочку, перенаправление, заблокированное резервное решение или разметку, которая появляется только после выполнения JavaScript, селекторы и правила извлечения могут не сработать, даже если сам парсер правильный.
ScraperFly предоставляет командам более чистую отправную точку: получайте публичные страницы в виде сырого HTML, когда разметка уже присутствует, переключайтесь на отрендеренный HTML, когда полезный DOM создается браузером, и сохраняйте доказательства ответа, чтобы решения по парсингу основывались на фактическом состоянии страницы.
Что такое API парсера HTML для веб-скрапинга?
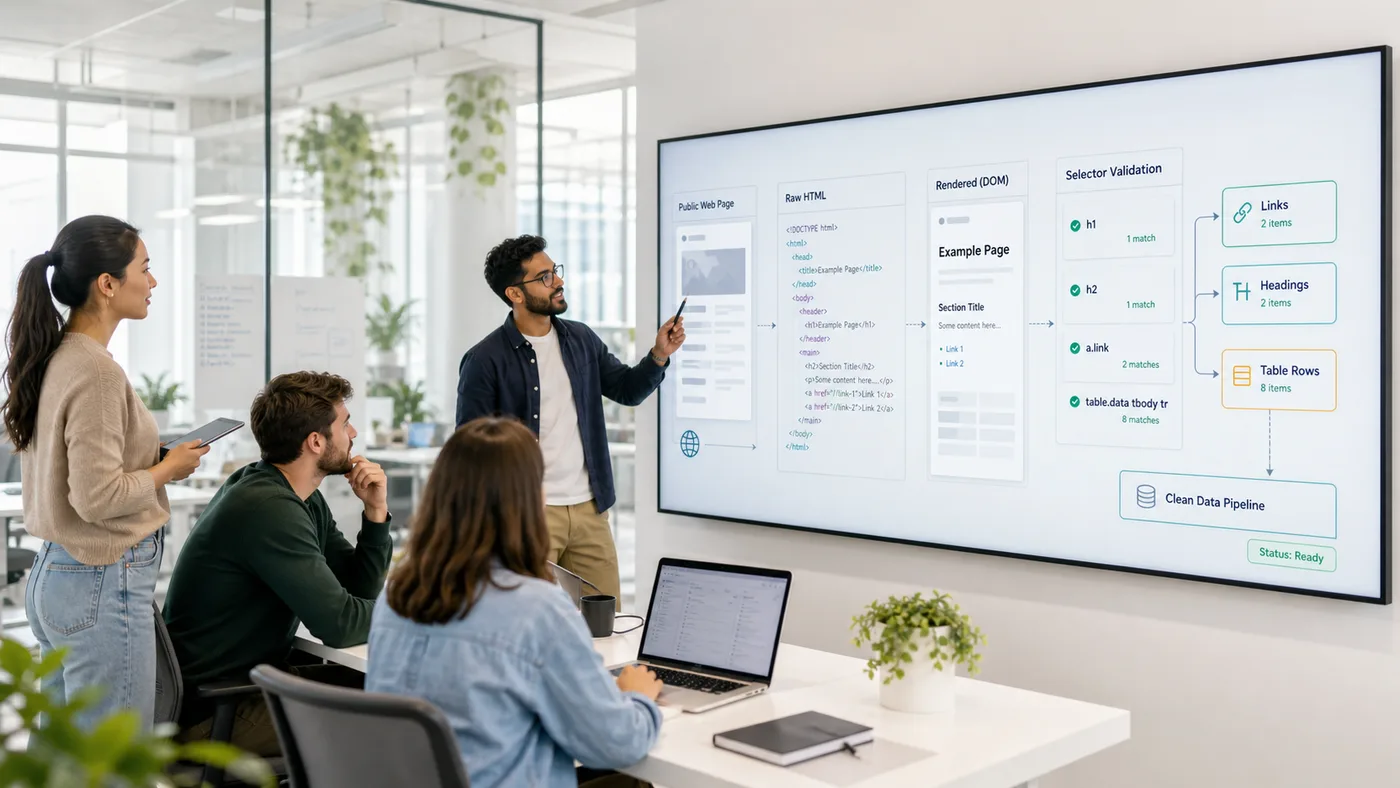
Рабочий процесс API парсера HTML начинается с получения публичной страницы и предоставления вашему приложению разметки, которую оно может проверить. Затем парсер извлекает ссылки, заголовки, таблицы, метаданные, карточки продуктов, разделы статей, пагинацию, встроенные данные или другие элементы страницы из этого захваченного источника.
Практическая задача заключается не только в парсинге. Важно захватить правильную версию страницы перед началом парсинга. Некоторые цели предоставляют полезную разметку в начальном HTML-ответе. Другие отправляют пустую оболочку приложения и строят DOM в браузере. Некоторые возвращают другую страницу в зависимости от заголовков, куки, региона или маршрутизации. ScraperFly обрабатывает этот слой захвата, чтобы ваш парсер мог работать с проверенным ответом, а не с хрупким клеем браузера.
Когда парсер должен использовать сырой HTML или отрендеренный HTML?
Сырой HTML является лучшей отправной точкой, когда цель сразу отправляет полезную разметку. Он легче, быстрее для проверки и проще для сравнения между образцами. Отрендеренный HTML полезен, когда начальный источник содержит только контейнер маршрута, скрипт гидратации, узлы-заполнители или контент, загружаемый поздно, который появляется после выполнения браузера.
Решение должно приниматься для каждой цели, а не глобально. Если каждый URL по умолчанию проходит через браузер, рабочий процесс становится тяжелее, прежде чем команда узнает, улучшает ли рендеринг захваченный источник. Лучший подход — сначала получить исходный HTML, сравнить его с ожидаемыми полями, а затем включить рендеринг только для страниц, где парсер не может увидеть нужную разметку.
| Входные данные парсера | Используйте это, когда | Основное преимущество | Важная проверка |
|---|---|---|---|
| Сырой HTML | Начальный ответ содержит ссылки, поля, таблицы или блоки контента. | Легкий и простой в отладке. | Подтвердите, что разметка присутствует, прежде чем писать селекторы. |
| Отрендеренный HTML | JavaScript создает полезный DOM после загрузки исходного ответа. | Фиксирует состояние страницы, созданное браузером. | Используйте рендеринг только тогда, когда он изменяет ответ. |
| Текст или Markdown | Нижележащий рабочий процесс нуждается в читаемом контенте, а не в отношениях DOM. | Чистый ввод для обзора контента, поиска и рабочих процессов ИИ. | Не используйте это, когда важны селекторы или атрибуты. |
| JSON метаданные | Приложение нуждается в контексте ответа для логирования, QA или решений по маршрутизации. | Предоставляет операционные доказательства вокруг захвата. | Это дополняет парсинг; это не заменяет специфические для цели правила извлечения. |
Что должны проверять команды перед масштабированием правил парсера?
Правила парсера часто выглядят стабильными на одном образце, а затем ломаются на наборе URL. Решение — проверить форму ответа перед масштабированием: убедитесь, что те же разделы существуют, ожидаемые ссылки присутствуют, таблицы сохраняют предсказуемую структуру, пагинация видима, и ответ не перенаправил тихо на другой тип страницы.
ScraperFly помогает, сохраняя видимыми элементы управления запросом. Вы можете сравнивать сырой и отрендеренный вывод, сохранять конечный URL и статус, проверять размер ответа и использовать скриншоты, когда визуальное доказательство имеет значение. Это упрощает диагностику сбоев селекторов: парсер может определить, изменилась ли цель, переместилась ли разметка, требовался ли JavaScript или захват вернул неправильную страницу.
| Точка проверки | Почему это важно | Безопасное действие для парсера |
|---|---|---|
| Ожидаемый контейнер | Парсер нуждается в стабильном разделе для начала. | Проверьте, содержит ли сырой или отрендеренный HTML контейнер. |
| Ссылки и пагинация | Многие обходы терпят неудачу, когда отсутствуют ссылки на следующую страницу или они преобразованы. | Проверьте href и элементы управления страницами на образцах. |
| Таблицы и списки | Данные могут смещать столбцы, метки или вложенность между шаблонами. | Сравните структуру перед сопоставлением полей. |
| Статус и конечный URL | Парсер может получить стену входа, страницу перенаправления или мягкую блокировку. | Записывайте доказательства ответа с каждым разобранным результатом. |
| Формат ответа | Парсинг DOM, прием текста и визуальный QA требуют разных выходов. | Выбирайте HTML, текст, Markdown, JSON, скриншот или PDF в зависимости от потребителя. |
Где ScraperFly вписывается в конвейер парсинга HTML?
ScraperFly находится перед вашим парсером. Ваше приложение отправляет целевой URL и профиль запроса, а затем получает форму ответа, которую ваш конвейер может использовать: сырой HTML для парсинга источника, отрендеренный HTML для страниц, созданных браузером, чистый текст или Markdown для рабочих процессов контента, JSON метаданные для диагностики или скриншоты и PDF для визуальных доказательств.
Это разделение ценно. Ваша команда сохраняет контроль над селекторами, правилами извлечения, проверкой, хранением и бизнес-логикой. ScraperFly обрабатывает слой получения, рендеринг браузера, когда это действительно необходимо, контекст сессии и заголовков, варианты маршрутизации и форматы ответов. Результат — более четкая граница между "получить правильный источник страницы" и "извлечь данные, которые нам важны".
Для более широкого взгляда на поддерживаемые выходы сравните форматы ответов API веб-скрапинга. Чтобы протестировать профиль запроса перед написанием производственного кода, используйте публичный API Builder.
Как команды могут поддерживать стабильность парсинга HTML в производстве?
Парсинг в производстве нуждается в доказательствах, а не только в селекторах. Храните целевой URL, конечный URL, статус, тип контента, размер ответа, настройки рендеринга, элементы управления временем и выбранный формат вывода с каждым захватом. Эти поля значительно упрощают разделение ошибок парсера от изменений цели, проблем с доставкой и пробелов в рендеринге JavaScript.
Когда парсер начинает пропускать поля, избегайте немедленного переписывания логики извлечения. Сначала проверьте, содержит ли захваченная разметка все ожидаемые источники. Если да, обновите парсер. Если нет, скорректируйте профиль запроса: отрендерите страницу, дождитесь позднего контента, сохраните состояние сессии, добавьте легитимные заголовки, выберите маршрутизацию по стране или используйте более надежную доставку для целей, которые доказывают, что они в этом нуждаются.
Как это делает скрапинг дешевле в эксплуатации?
Парсинг HTML становится дорогим, когда команды используют самый тяжелый профиль запроса для каждой страницы. ScraperFly поддерживает более практичный путь: начните с легкого захвата HTML, проверьте, содержит ли разметка полезные данные, а затем добавьте рендеринг браузера, ожидания, сессии, заголовки, таргетинг по стране, премиум маршрутизацию, скриншоты или PDF только тогда, когда цель докажет, что эти элементы управления улучшают результат.
Это особенно полезно для проектов с смешанными целями. Простые публичные страницы могут оставаться на простых захватах. Страницы с тяжелым JavaScript могут использовать отрендеренный HTML. Страницы, которым нужны доказательства, могут добавить выход в виде скриншота или PDF. Неровные проекты могут использовать кредиты по мере необходимости, в то время как предсказуемые производственные нагрузки могут перейти на ежемесячные кредиты, когда шаблон становится ясным. Страница цены подробно объясняет этот путь.







