






Односторінкові додатки
Захоплюйте стан маршруту після завершення рендерингу додатку
Односторінкові додатки можуть повертати дійсну відповідь, поки корисна сторінка ще не з'явилася. Перший HTML часто містить кореневий елемент, скрипти, контейнери маршрутів та заповнювачі. Реальний контент з'являється лише після маршрутизації на стороні клієнта, асинхронного завантаження даних, гідратації або завантаження «лінивих» секцій у браузері.
ScraperFly допомагає командам захоплювати публічні маршрути SPA з доказами: порівнюйте сирий HTML та рендерений вихід, чекайте лише тоді, коли це важливо, вибирайте формат відповіді, який може використовувати ваш робочий процес, та зберігайте повне сканування додатку, парсинг, порівняння та зберігання у вашій системі.
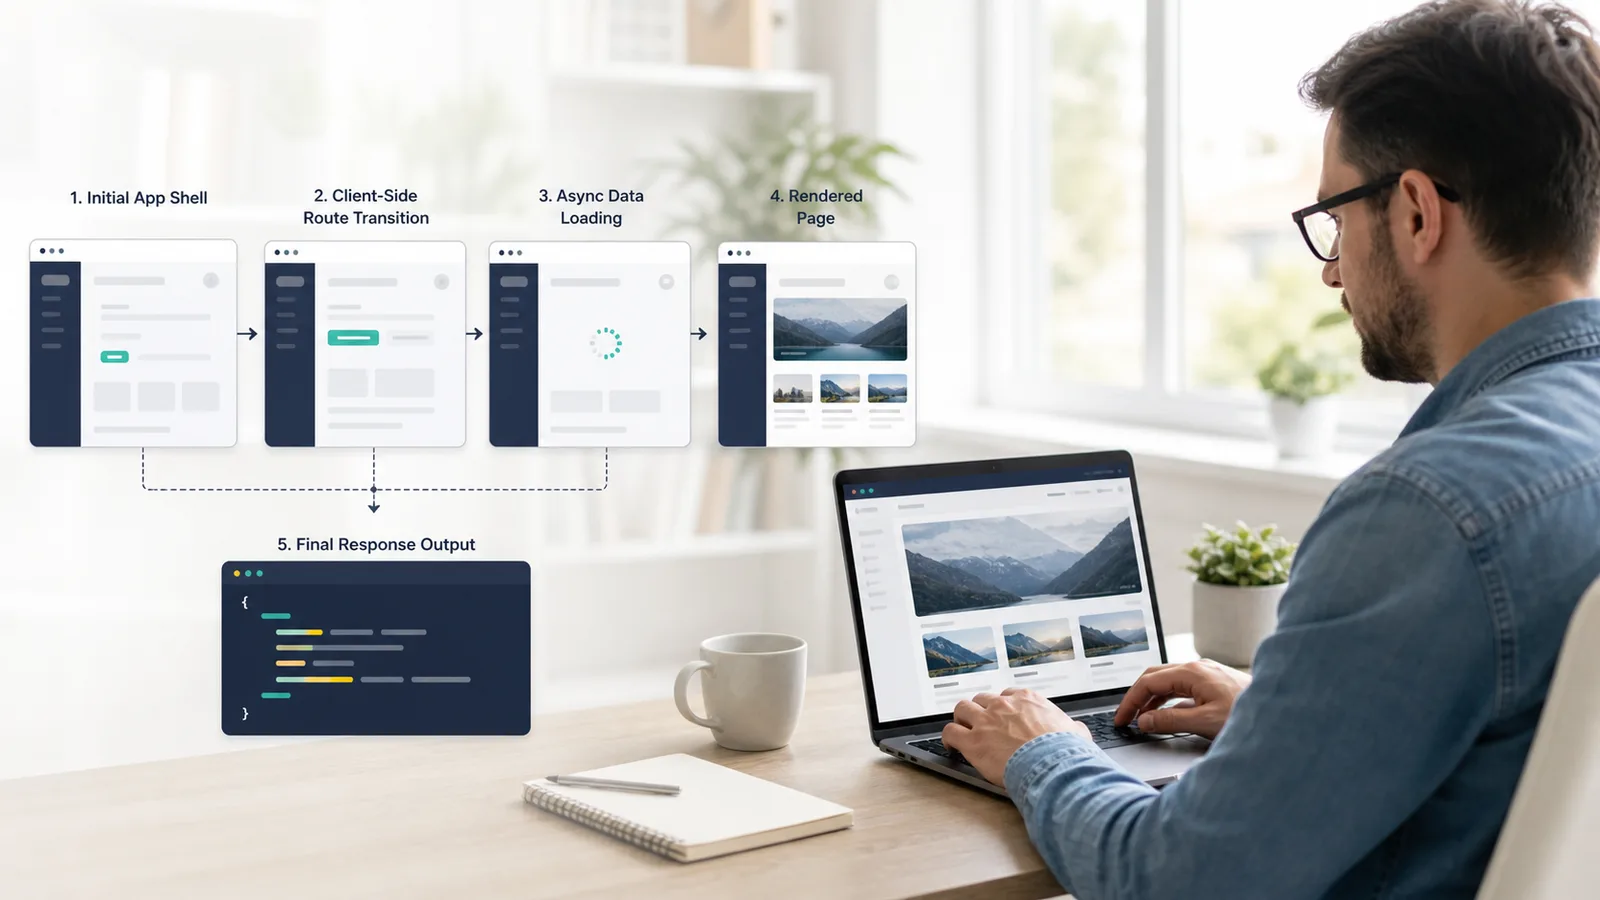
Що таке API для збору даних з веб-сайту SPA?
API для збору даних з веб-сайту SPA захоплює публічні маршрути односторінкових додатків через хостинговий шар запитів. API може отримати початковий HTML, виконати JavaScript браузера за потреби, дочекатися стабілізації стану маршруту та повернути результат у вигляді рендереного HTML, тексту, Markdown, метаданих JSON, скріншоту або PDF. Ваш додаток все ще володіє вибором маршруту, логікою витягування, валідацією, зберіганням, моніторингом та бізнес-рішеннями.
Ця відмінність важлива, оскільки односторінковий додаток не є звичайним багатосторінковим сайтом з точки зору скребка. URL може бути розпізнаний, сервер може повернути статус 200, а вихідний HTML може бути занадто тонким для робочого процесу. Корисний контент може залежати від браузера, який виконує додаток і завантажує дані маршруту після першої відповіді.
Практична порада: збирайте маршрути SPA, доводячи стан рендереної сторінки, а не припускаючи, що перша відповідь HTML містить дані.
Чому SPA важче збирати, ніж статичні сторінки?
Статичні та серверно-рендерені сторінки часто розміщують корисний контент безпосередньо в вихідному HTML. SPA часто цього не роблять. Вони можуть завантажувати контент маршруту за допомогою JavaScript, повторно використовувати одну оболонку документа для багатьох переглядів, отримувати дані після навігації, гідратувати компоненти, завантажувати секції «ліниво» або показувати стан резерву до появи фінального контенту. Парсер, побудований на основі початкової відповіді, може пропустити точний контент, який бачить користувач у браузері.
SPA також полегшують неправильне тлумачення помилок. Порожнє тіло може бути нормальною оболонкою додатку, проблемою з часом, перенаправленням, відсутнім публічним маршрутом, заблокованим активом, регіонально специфічною відповіддю або реальною проблемою з ціллю. Правильний робочий процес порівнює докази з вихідного HTML, рендереного HTML, скріншотів, метаданих, фінального URL, розміру відповіді та часу перед повторною спробою або ескалацією.
| Поведение SPA | Що це означає | Найкраще рішення для захоплення |
|---|---|---|
| Початковий HTML є лише оболонкою додатку | Контент маршруту, ймовірно, формується в браузері | Тестуйте рендерений вихід перед написанням правил парсера. |
| Рендерений DOM містить цільові поля | Виконання браузера змінює результат | Використовуйте рендеринг для цього класу маршруту. |
| Рендерений вигляд з'являється пізно | Асинхронні дані або «ліниві» секції потребують більше часу | Додайте час очікування навмисно та зафіксуйте причину. |
| Вихід маршруту змінюється в залежності від стану або регіону | Cookies, заголовки, сесії або місцезнаходження можуть впливати на публічний вигляд | Додайте контекст запиту лише там, де зразки доводять, що це важливо. |
| Скріншот показує контент, але вихід парсера порожній | Формат або логіка витягування можуть бути неправильними | Порівняйте рендерений HTML, текст, Markdown та метадані перед повторною спробою. |
Коли ScraperFly повинен рендерити маршрут SPA?
Рендеруйте маршрут SPA, коли корисний публічний контент з'являється лише після виконання JavaScript. Це поширено для оболонок додатків, переходів маршрутів на стороні клієнта, продуктових сіток, публічних інформаційних панелей, результатів пошуку, фільтрів, «лінивих» статей, профільних сторінок та сторінок, які отримують дані після першого завантаження. Рендеринг надає вашому робочому процесу сторінку після того, як браузер побудував стан.
Рендеринг повинен бути прив'язаний до класу маршруту, а не до всього сайту за замовчуванням. Деякі маршрути можуть відкривати корисні метадані або серверно-рендерений контент у вихідному HTML. Інші потребують рендерингу та очікувань. Інші потребують скріншотів для візуального контролю якості. Розглядайте кожен представницький маршрут як доказ і зберігайте профіль запиту таким легким, як дозволяє маршрут.
Для сторінок, специфічних для фреймворку, порівняйте посібники React та Vue: збирати дані з веб-сайтів React та збирати дані з веб-сайтів Vue. Для більш широких рішень щодо захоплення браузера використовуйте API рендерингу JavaScript.
Який формат відповіді повинен вибрати робочий процес SPA?
Рендерений HTML є правильним вибором, коли парсеру потрібен фінальний DOM, посилання, атрибути, контент маршруту, таблиці, картки або вихід компонентів. Текст і Markdown корисні, коли маршрут повинен постачати дані для пошуку, класифікації, резюме, споживання RAG або перегляду контенту. Метадані JSON допомагають операціям, оскільки вони фіксують статус, фінальний URL, тип контенту, розмір відповіді та контекст запиту. Скріншоти та PDF корисні, коли людям потрібні візуальні докази рендереного маршруту.
Вихід повинен відповідати споживачу. Моніторинг може вимагати метаданих плюс скріншот. Парсер на стороні сервера може потребувати рендереного HTML. Потік споживання AI може віддати перевагу Markdown. Робочий процес перегляду може потребувати PDF. Ранній вибір цього запобігає тому, щоб команда будувала конвертери навколо неправильного відповіді.
| Використання SPA | Вихід для тестування | Чому це підходить | Майте на увазі |
|---|---|---|---|
| Парсинг DOM маршруту | Рендерений HTML | Захоплює сторінку після маршрутизації та рендерингу на стороні клієнта | Витягування полів все ще належить до нижнього потоку. |
| AI або контентні робочі процеси | Текст або Markdown | Повертає читабельний контент з меншим шумом макета | Може не зберігати достатньо структури для селекторів. |
| Налагодження та журнали | JSON метадані | Робить докази відповіді видимими для завдань та моніторингу | Не замінює специфічний для цілі парсинг. |
| Візуальний контроль якості | Скріншот | Показує, чи маршрут рендерив очікуваний стан | Важчий, ніж вихід, зручний для машин. |
| Архів або затвердження | Створює портативний запис рендереної сторінки | Зазвичай не є найкращим входом для парсера. |
Як слід використовувати очікування, сесії, заголовки та маршрутизацію?
SPA часто потребують контролю часу, але очікування повинні вирішувати реальну проблему завантаження. Додайте поведінку очікування, коли маршрут рендериться до завершення асинхронного контенту, «лінивих» секцій або викликів даних на фронтенді. Використовуйте сесії, коли пов'язані публічні маршрути залежать від спільного стану. Використовуйте заголовки, коли законний контекст запиту впливає на відповідь. Використовуйте маршрутизацію за країною, коли маршрут змінюється в залежності від регіону, мови, валюти, доступності або поведінки перенаправлення. Використовуйте більш сильну доставку лише тоді, коли повторні докази показують, що простий шлях не може повернути придатну сторінку.
Чистий шаблон полягає в тому, щоб тестувати один контроль за раз. Якщо очікування покращує відповідь, зберігайте його прив'язаним до цього класу маршруту. Якщо сесії важливі, зберігайте їх у межах пов'язаних запитів. Якщо потрібні візуальні докази, запитуйте скріншоти там, де люди насправді переглядають результат. Уникайте перетворення кожного захоплення SPA на найдорожчий можливий запит.
Використовуйте сесії для безперервності стану, кастомні заголовки для контексту запиту, та контроль маршрутизації, коли шлях доставки впливає на публічну відповідь.
Чи навігація ScraperFly автоматично по всьому SPA?
Ні. ScraperFly захоплює надані публічні маршрути та повертає відповідь у форматі, який ви запитуєте. Ваш робочий процес повинен вирішити, які маршрути відвідувати, як знаходити URL, які поля витягувати, як порівнювати зміни, де зберігати дані та як обробляти сповіщення або аналіз нижнього потоку. Ця межа зберігає обіцянку чіткою та корисною.
Це зазвичай краща архітектура. API обробляє захоплення сторінок, рендеринг, очікування, файли, формати та контролі доставки. Ваша система володіє картою маршрутів та специфічним значенням продукту. Якщо маршрут неповний, ви можете налаштувати захоплення. Якщо парсинг не вдається, ви можете налаштувати витягування. Дві проблеми залишаються окремими.
Як можна зберегти доступність збору даних з SPA?
Робота браузера є важчою, ніж просте захоплення HTML, тому контроль витрат починається з класифікації маршрутів. Зберігайте статичні або серверно-рендерені маршрути легкими. Рендеруйте маршрути, які доводять, що JavaScript змінює результат. Додавайте очікування лише тоді, коли асинхронний контент потребує їх. Резервуйте скріншоти, PDF, сесії, маршрутизацію за країною та більш сильну доставку для робочих процесів, які насправді використовують ці контролі.
ScraperFly підтримує цей шлях, оскільки ви можете почати безкоштовно, протестувати представницькі маршрути SPA, купити кредити для нерівномірних проектів та перевести повторювані навантаження на місячні кредити, як тільки мікс сторінок стане відомим. Рішення про покупку стає легшим, коли команда знає, які маршрути легкі, які рендерені, а які потребують додаткових доказів або маршрутизації.
Перегляньте ціни після тестування реальних маршрутів SPA, щоб оцінка відображала фактичні профілі запитів, а не загальні припущення.
З чого повинна почати команда?
Почніть у API Builder з одного реального публічного маршруту SPA. Спочатку запитайте вихідний HTML. Якщо контент відсутній, увімкніть рендеринг і порівняйте вихід. Додавайте очікування лише якщо рендерений маршрут все ще захоплює занадто рано. Потім виберіть формат, який потрібен вашому робочому процесу: рендерений HTML для парсерів, Markdown або текст для читабельного контенту, JSON метадані для журналів, скріншот або PDF для візуальних доказів.
Якщо профіль запиту підтверджено, перемістіть його в cURL, Python, Node.js, чергу на стороні сервера, завдання моніторингу або робочий процес агента. Зберігайте цей профіль видимим, щоб майбутні помилки можна було налагоджувати на основі доказів відповіді, а не здогадок.












