






Рендеринг React
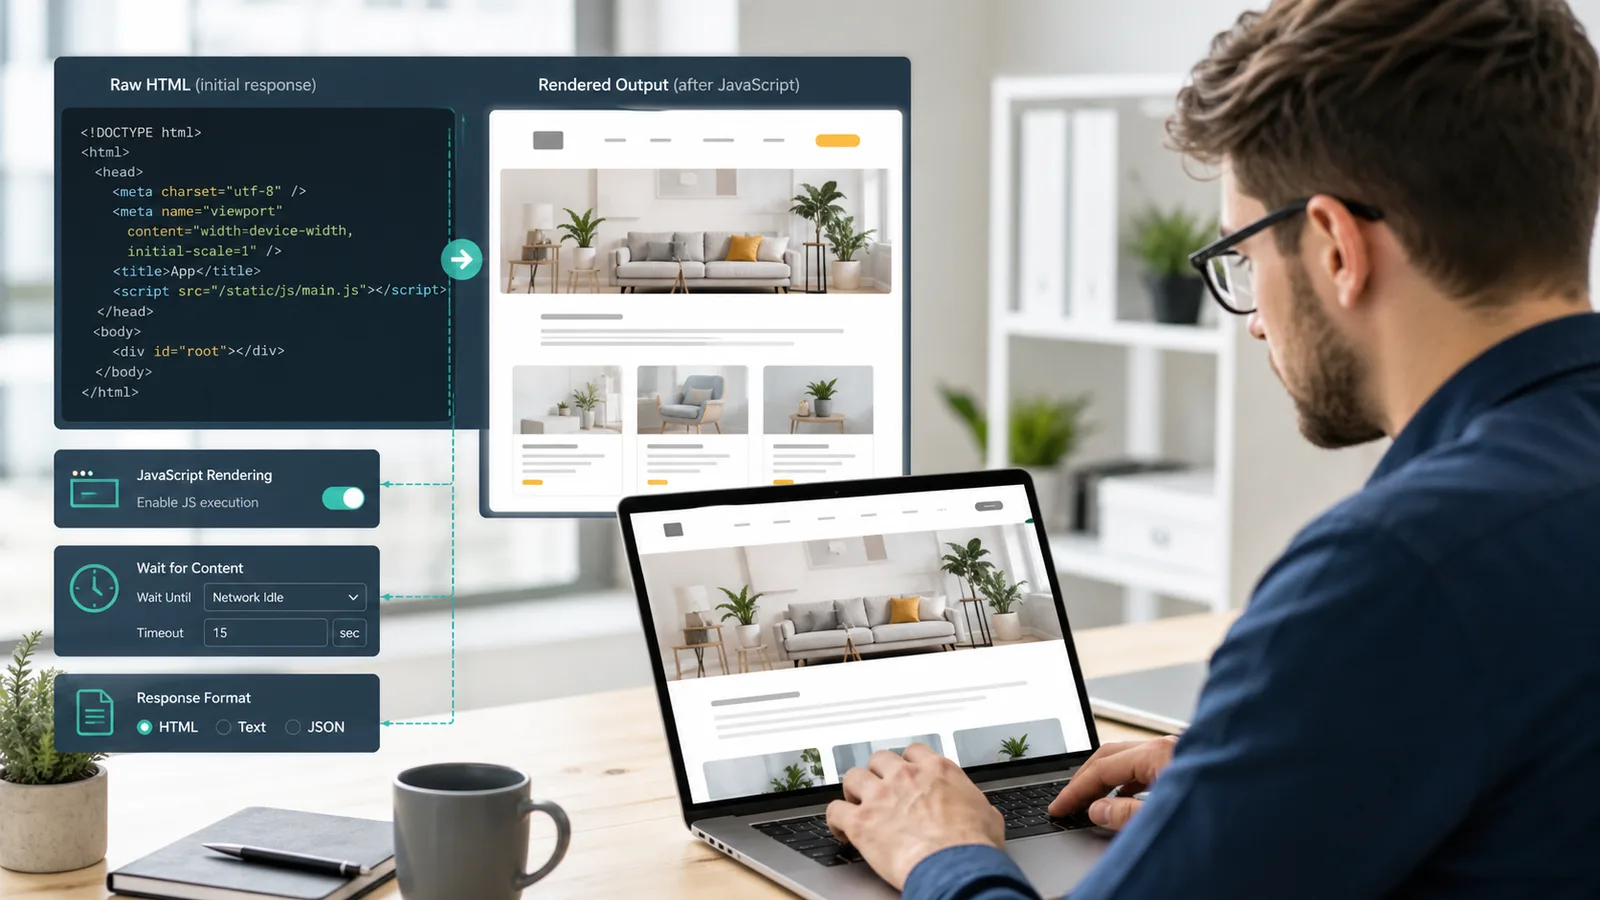
Порівняйте вихідний HTML з відрендереним виходом перед скрапінгом додатку
React веб-сайти можуть виглядати завершеними в браузері, тоді як перша HTML відповідь містить лише невелику оболонку додатку. ScraperFly допомагає командам довести цю різницю перед тим, як вони створять логіку парсера, чергу робітників або інфраструктуру браузера навколо неправильної відповіді.
Почніть з вихідного HTML, перевірте, що насправді повертає ціль, а потім увімкніть рендеринг браузера, затримки, сесії, заголовки, маршрутизацію за країною або візуальний вихід лише тоді, коли відрендерована сторінка React надає вашому робочому процесу кращі докази.
Чому React веб-сайти відрізняються в скрапінгу?
React веб-сайти часто відокремлюють першу відповідь сервера від сторінки, яку врешті-решт бачить користувач. Вихідний HTML може містити кореневий елемент, теги скриптів, метадані маршруту, дані гідратації або невелику заповнювач. Корисні картки продуктів, розділи статей, результати пошуку, ціни, таблиці, відгуки, фільтри або контент профілю можуть з'явитися лише після виконання JavaScript у браузері.
Це не означає, що кожна сторінка React потребує найважчого профілю скрапінгу. Деякі React додатки все ще відкривають корисні метадані, вбудовану стан, контент, відрендерений на сервері, або структуровані вантажі у початковій відповіді. Інші потребують відрендерованого HTML, оскільки контент створюється на стороні клієнта. Практичний робочий процес полягає в порівнянні обох станів перед тим, як вирішити, як сторінка повинна бути захоплена.
Практичний висновок: Скрапінг React повинен починатися з доказів, а не з припущень про те, чи потрібен сторінці браузер.
Що слід перевірити перед рендерингом сторінки React?
Перша перевірка - це вихідна відповідь. Шукайте корисний контент, а не просто успішний код статусу. Відповідь 200 все ще може бути порожньою оболонкою, якщо сторінка очікує, що браузер отримає дані, гідратує компоненти та побудує фінальний DOM. Перевірте тіло, розмір відповіді, вантажі скриптів, метадані, фінальне URL та чи з'являються цільові поля в HTML, який отримує ваш парсер.
Якщо вихідний HTML вже містить потрібні поля, зберігайте запит простим. Якщо вихідний HTML не містить корисного контенту, порівняйте відрендерований вихід. Якщо відрендерований вихід змінює DOM значущим чином, рендеринг виправданий. Якщо відрендерований вихід все ще порожній, проблема може бути в таймінгу, маршрутизації, заблокованих ресурсах, поганому маршруті, недоступному публічному контенті або сторінці, яка потребує іншого робочого процесу.
| Сигнал React | Що це означає | Найкращий наступний крок |
|---|---|---|
| Вихідний HTML містить цільовий контент | Сторінку, ймовірно, можна захопити без рендерингу браузера | Використовуйте легкий HTML запит і створіть парсер з вихідних доказів. |
| Вихідний HTML в основному є кореневим елементом і скриптами | Сторінка, ймовірно, створює корисний контент у браузері | Перевірте відрендерований HTML перед написанням логіки витягування. |
| Відрендерований DOM містить цільові поля | Виконання JavaScript змінює результат скрапінгу | Використовуйте рендеринг для цього типу сторінки та зафіксуйте, чому це потрібно. |
| Відрендерована сторінка все ще неповна | Проблема може бути в таймінгу, контексті запиту, маршрутизації або поведінці цілі | Перевірте таймінг очікування, статус, фінальне URL, розмір відповіді та візуальні докази. |
| Візуальна сторінка відрізняється за регіоном або штатом | Маршрут може залежати від місця розташування, куків, заголовків або безперервності сесії | Додайте контекст навмисно, а не робіть кожен запит важчим. |
Коли ScraperFly повинен рендерити React веб-сайт?
Увімкніть рендеринг, коли корисний публічний контент з'являється після виконання JavaScript на стороні клієнта. Загальні приклади включають React продуктові сітки, результати пошуку, інформаційні панелі з публічними даними, статті на основі маршруту, ліниві секції, віджети відгуків, блоки цін, фільтри та сторінки, де перша HTML відповідь містить заповнювачі замість фінального контенту.
Рендеринг повинен бути точним. Не вмикайте його лише тому, що сайт використовує React; вмикайте його, тому що сирий відповідь не містить того, що потрібно робочому процесу, а відрендерована відповідь містить. Це дозволяє простим сторінкам залишатися швидкими та доступними, при цьому надаючи сторінкам, побудованим у браузері, середовище, яке їм потрібно.
Для більш широких рішень щодо захоплення браузера використовуйте посібник з API рендерингу JavaScript та сторінку API скрапінгу безголового браузера. Для цілей з пріоритетом на вихід порівняйте підхід HTML API скрапінгу перед тим, як зробити рендеринг за замовчуванням.
Який формат виходу найкраще підходить після рендерингу React?
Відрендерений HTML є найкращим вибором, коли ваш парсер потребує фінального DOM, селекторів, атрибутів, посилань, таблиць, карток продуктів або контенту маршруту. Текст і Markdown краще, коли сторінка React повинна подавати пошуку, резюме, контекст AI, огляд документації або споживання RAG без шуму макета. JSON метадані корисні для ведення журналу доказів запиту. Скриншоти та PDF корисні, коли людині потрібно перевірити, як виглядала відрендерена сторінка.
Цей вибір слід зробити перед створенням конвертерів. Скрапінг React, який подає парсер, може потребувати відрендерованого HTML. Скрапінг React, який подає LLM, може бути кращим у вигляді Markdown. Робочий процес моніторингу може потребувати метаданих плюс скриншот. Робочий процес відповідності або QA може потребувати PDF. ScraperFly дозволяє запиту повертати форму, яку може використовувати наступна система відразу.
| Робочий процес React | Вихід для тестування | Чому це допомагає | Коли цього слід уникати |
|---|---|---|---|
| Парсинг DOM | Відрендерений HTML | Повертає сторінку після того, як React створює корисну розмітку | Коли вихідний HTML вже містить цільові поля. |
| Споживання контенту | Текст або Markdown | Видаляє більшу частину шуму макета перед обробкою пошуку або AI | Коли точні селектори або відносини DOM мають значення. |
| Діагностика | JSON метадані | Показує статус, фінальне URL, тип контенту, розмір відповіді та контекст запиту | Коли робочий процес очікує, що витягнуті цільові поля будуть самостійно. |
| Візуальна QA | Скриншот | Підтверджує, як виглядала відрендерена публічна сторінка | Коли робочий процес потребує лише тексту, зчитуваного машиною. |
| Архів або затвердження | Створює портативний запис для огляду | Коли контент потребує частого автоматизованого парсингу. |
Як слід обробляти затримки, сесії, заголовки та маршрутизацію?
Сторінки React можуть зазнавати невдачі з причин, які виглядають схожими ззовні. Сторінка може потребувати додаткового часу очікування, оскільки дані завантажуються після початкового рендерингу. Вона може потребувати заголовків, оскільки публічний маршрут очікує контексту мови або контенту. Вона може потребувати сесій, оскільки пов'язані запити залежать від спільних куків або стану. Вона може потребувати маршрутизації за країною, оскільки контент змінюється за регіоном, валютою або доступністю. Вона може потребувати більш потужної доставки, коли простий шлях постійно повертає непридатний вихід.
Правильна відповідь - не вмикати все. Додавайте один контроль за раз і порівнюйте результат. Якщо затримка виправляє відсутній контент, зафіксуйте причину таймінгу. Якщо сесії змінюють відповідь, зберігайте їх лише для цього пов'язаного потоку. Якщо регіон змінює сторінку, зберігайте маршрутизацію за країною, пов'язаною з ціллю. Робочий процес скрапінгу React легше керувати, коли кожен увімкнений контроль має видиму причину.
Використовуйте сесії для стану публічних потоків, кастомні заголовки для легітимного контексту запиту, і контролі маршрутизації, коли шлях доставки змінює результат.
Які невдачі є поширеними при скрапінгу React веб-сайтів?
Найпоширеніша невдача - це трактування порожньої вихідної відповіді як цільового блоку, коли насправді це просто нормальна оболонка React. Інша поширена невдача - це занадто швидкий рендеринг і захоплення сторінки до того, як дані на стороні клієнта закінчать завантаження. Команди також стикаються з перенаправленнями маршрутів, контентом, що змінюється за регіоном, надмірними відповідями, відсутніми публічними даними, непідтримуваними виборами виходу та робочими процесами, які очікують, що API автоматично витягне стан програми.
Добре оброблення помилок утримує ці випадки окремо. Порівняйте вихідний HTML, відрендерений HTML, стан скриншота, фінальне URL, статус, розмір відповіді та таймінг очікування. Виправте неправильно сформовані входи та непідтримувані опції замість того, щоб повторно їх пробувати. Повторіть тимчасові невдачі з обмеженим відступом. Ескалюйте маршрутизацію лише тоді, коли повторні докази показують, що простий шлях недостатній.
Блок обробки помилок нижче надає ширшу структуру невдач. Для сторінок React ключем є розрізнення "браузер ще не побудував сторінку" від "ціль повернула погану сторінку" та "профіль запиту неправильний."
Як може залишитися доступним скрапінг React?
Рендеринг є потужним, але робота браузера є важчою, ніж простий HTML запит. Витрати залишаються передбачуваними, коли команди класифікують цілі перед масштабуванням: сирі HTML сторінки, відрендерені React сторінки, сторінки, які потребують затримок, регіональні маршрути, потоки, що залежать від сесій, візуальні QA захоплення та PDF архіви. Кожен клас повинен мати свій власний профіль запиту, а не успадковувати один дорогий за замовчуванням.
Ось де шлях ScraperFly є практичним. Почніть безкоштовно, протестуйте реальні React сторінки, зберігайте прості захоплення легкими та використовуйте важчі контролі лише там, де вони змінюють відповідь. Одноразовий проект може залишатися гнучким з кредитами, тоді як повторювані відрендерені навантаження можуть перейти на місячний план, як тільки профіль буде підтверджено.
Перегляньте ціни після тестування реальних цілей, а не до цього. Корисна оцінка базується на тому, скільки сторінок насправді потребують рендерингу, затримок, візуального виходу, сесій або більш потужної доставки.
З чого повинна почати команда?
Почніть у API Builder з одного публічного React URL. Спочатку запитайте вихідний HTML. Якщо корисний контент відсутній, увімкніть рендеринг і порівняйте результат. Потім виберіть формат відповіді, який може використовувати ваш робочий процес: відрендерений HTML для парсерів, текст або Markdown для зчитуваного контенту, JSON метадані для діагностики, скриншот або PDF для візуальних доказів.
Якщо профіль запиту підтверджено, перенесіть його в cURL, Python, Node.js, бекенд чергу, моніторингову задачу або робочий процес агента. Зберігайте профіль явним, щоб майбутні невдачі можна було діагностувати з доказів, а не з припущень.












