






Одностраничные приложения
Захват состояния маршрута после завершения рендеринга приложения
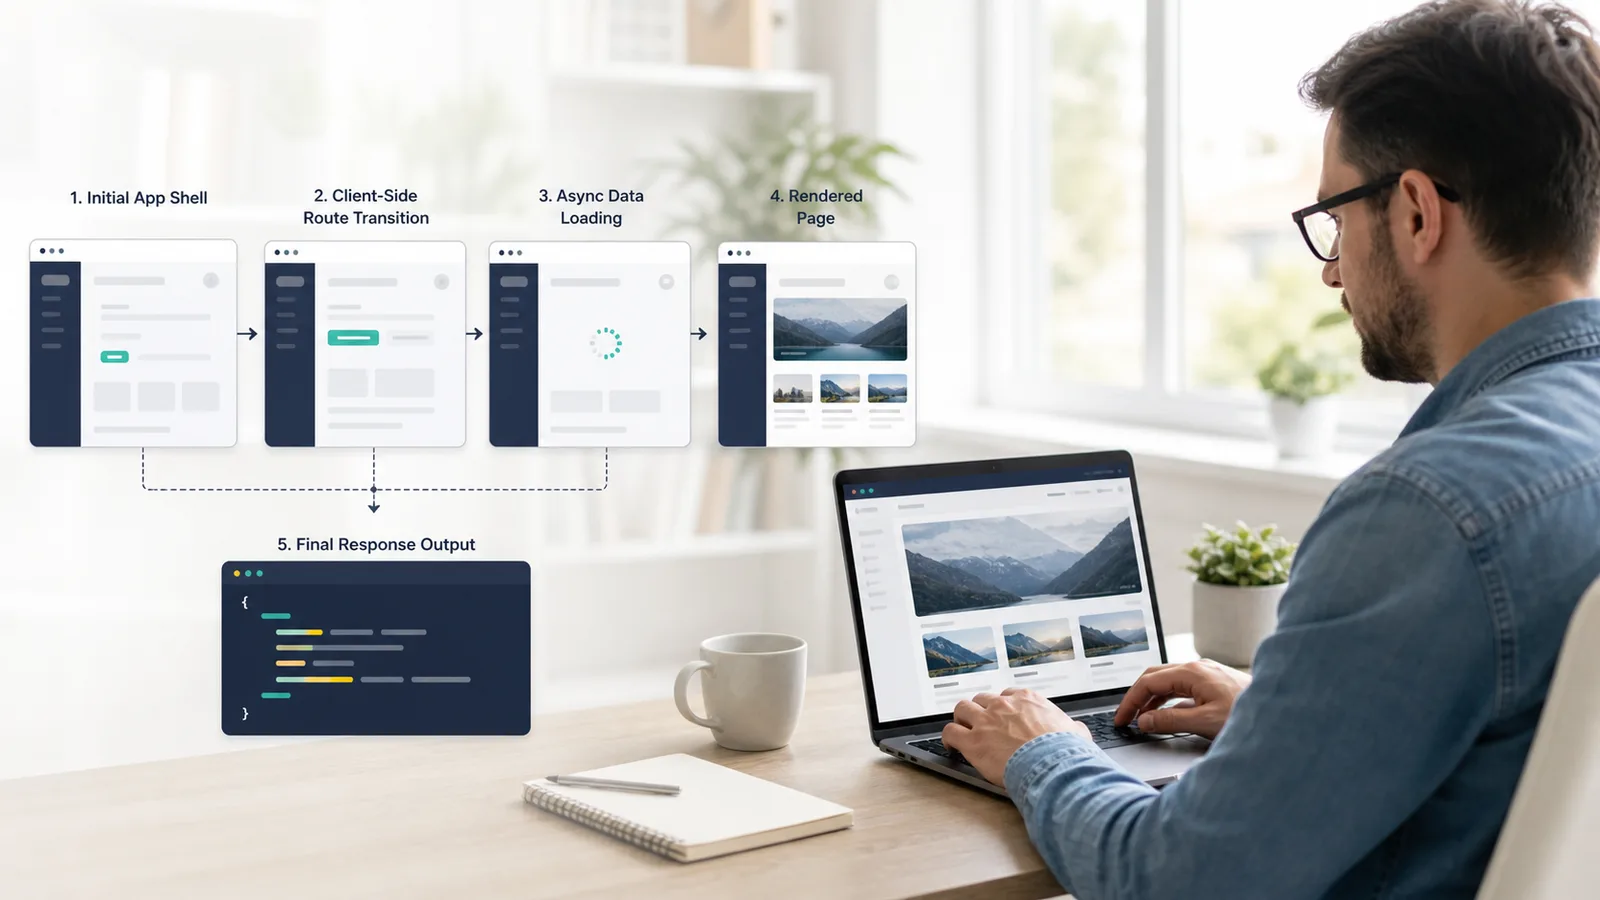
Одностраничные приложения могут возвращать действительный ответ, пока полезная страница еще не загружена. Первый HTML часто содержит корневой элемент, скрипты, контейнеры маршрутов и заполнители. Реальный контент появляется только после клиентской маршрутизации, асинхронной загрузки данных, гидратации или ленивых секций в браузере.
ScraperFly помогает командам захватывать публичные маршруты SPA с доказательствами: сравнивайте сырой HTML и отрендеренный вывод, ждите только тогда, когда это имеет значение, выбирайте формат ответа, который может использовать ваш рабочий процесс, и сохраняйте полное сканирование приложения, парсинг, сравнение и хранение в вашей системе.
Что такое API для скрапинга веб-сайтов SPA?
API для скрапинга веб-сайтов SPA захватывает публичные маршруты одностраничных приложений через хостинговый уровень запросов. API может получать начальный HTML, выполнять JavaScript браузера при необходимости, ждать, пока состояние маршрута установится, и возвращать результат в виде отрендеренного HTML, текста, Markdown, метаданных JSON, скриншота или PDF. Ваше приложение по-прежнему отвечает за выбор маршрута, логику извлечения, валидацию, хранение, мониторинг и бизнес-решения.
Это различие имеет значение, потому что одностраничное приложение не является обычным многопользовательским сайтом с точки зрения скрапера. URL может разрешаться, сервер может возвращать статус 200, а исходный HTML может быть слишком тонким для рабочего процесса. Полезный контент может зависеть от браузера, выполняющего приложение и загружающего данные маршрута после первого ответа.
Практическое замечание: скрапируйте маршруты SPA, доказывая состояние отрендеренной страницы, а не предполагая, что первый HTML-ответ содержит данные.
Почему SPAs сложнее скрапировать, чем статические страницы?
Статические и серверно-рендеренные страницы часто помещают полезный контент непосредственно в исходный HTML. SPAs часто этого не делают. Они могут загружать контент маршрута с помощью JavaScript, повторно использовать одну оболочку документа для многих представлений, получать данные после навигации, гидратировать компоненты, лениво загружать секции или показывать состояние резервирования перед появлением окончательного контента. Парсер, построенный на основе начального ответа, может пропустить точный контент, который пользователь видит в браузере.
SPAs также делают ошибки легче неправильно интерпретировать. Пустое тело может быть нормальной оболочкой приложения, проблемой с таймингом, перенаправлением, отсутствующим публичным маршрутом, заблокированным активом, ответом, специфичным для региона, или реальной проблемой с целью. Правильный рабочий процесс сравнивает доказательства из исходного HTML, отрендеренного HTML, скриншотов, метаданных, окончательного URL, размера ответа и времени перед повторной попыткой или эскалацией.
| Поведение SPA | Что это значит | Лучшее решение для захвата |
|---|---|---|
| Первый HTML - это только оболочка приложения | Содержимое маршрута, вероятно, создается в браузере | Тестируйте отрендеренный вывод перед написанием правил парсера. |
| Отрендеренный DOM содержит целевые поля | Выполнение браузера изменяет результат | Используйте рендеринг для этого класса маршрутов. |
| Отрендеренный вид появляется поздно | Асинхронные данные или ленивые секции требуют больше времени | Добавьте время ожидания намеренно и запишите, почему. |
| Вывод маршрута изменяется в зависимости от состояния или региона | Cookies, заголовки, сессии или местоположение могут повлиять на публичный вид | Добавьте контекст запроса только там, где образцы доказывают, что это имеет значение. |
| Скриншот показывает контент, но вывод парсера пуст | Формат или логика извлечения могут быть неверными | Сравните отрендеренный HTML, текст, Markdown и метаданные перед повторной попыткой. |
Когда ScraperFly должен рендерить маршрут SPA?
Рендерите маршрут SPA, когда полезный публичный контент появляется только после выполнения JavaScript. Это часто встречается для оболочек приложений, переходов маршрутов на стороне клиента, продуктовых сеток, публичных панелей управления, результатов поиска, фильтров, ленивых секций статей, страниц профилей и страниц, которые загружают данные после первой загрузки. Рендеринг дает вашему рабочему процессу страницу после того, как браузер построил состояние.
Рендеринг должен быть привязан к классу маршрута, а не ко всему сайту по умолчанию. Некоторые маршруты могут раскрывать полезные метаданные или серверно-рендеренный контент в исходном HTML. Другим требуется рендеринг и ожидания. Другим нужны скриншоты для визуального контроля качества. Рассматривайте каждый представительный маршрут как доказательство и держите профиль запроса таким легким, как позволяет маршрут.
Для страниц, специфичных для фреймворка, сравните руководства по React и Vue: скрапировать веб-сайты React и скрапировать веб-сайты Vue. Для более широких решений по захвату браузера используйте API рендеринга JavaScript.
Какой формат ответа должен выбрать рабочий процесс SPA?
Отрендеренный HTML - правильный выбор, когда парсеру нужны окончательный DOM, ссылки, атрибуты, содержимое маршрута, таблицы, карточки или вывод компонентов. Текст и Markdown полезны, когда маршрут должен подавать данные для поиска, классификации, резюме, RAG-поглощения или обзора контента. Метаданные JSON помогают операциям, потому что они фиксируют статус, окончательный URL, тип контента, размер ответа и контекст запроса. Скриншоты и PDF полезны, когда людям нужно визуальное подтверждение отрендеренного маршрута.
Вывод должен соответствовать потребителю. Мониторинговая задача может потребовать метаданные плюс скриншот. Бэкенд-парсер может потребовать отрендеренный HTML. Поток поглощения AI может предпочесть Markdown. Рабочий процесс обзора может потребовать PDF. Ранний выбор предотвращает создание конвертеров вокруг неправильного ответа.
| Случай использования SPA | Вывод для тестирования | Почему это подходит | Имейте в виду |
|---|---|---|---|
| Парсинг DOM маршрута | Отрендеренный HTML | Захватывает страницу после маршрутизации и рендеринга на стороне клиента | Извлечение полей все еще принадлежит нижестоящему уровню. |
| AI или контентные рабочие процессы | Текст или Markdown | Возвращает читаемый контент с меньшим шумом в макете | Может не сохранить достаточно структуры для селекторов. |
| Отладка и журналы | Метаданные JSON | Делает доказательства ответа видимыми для задач и мониторинга | Не заменяет парсинг, специфичный для цели. |
| Визуальный контроль качества | Скриншот | Показывает, отрендерил ли маршрут ожидаемое состояние | Требует больше ресурсов, чем машинно-читаемый вывод. |
| Архив или одобрение | Создает переносимый отчет об отрендеренной странице | Обычно не лучший ввод для парсера. |
Как следует использовать ожидания, сессии, заголовки и маршрутизацию?
SPAs часто нуждаются в контроле времени, но ожидания должны решать реальную проблему загрузки. Добавьте поведение ожидания, когда маршрут рендерится до завершения асинхронного контента, ленивых секций или вызовов данных на фронтенде. Используйте сессии, когда связанные публичные маршруты зависят от общего состояния. Используйте заголовки, когда законный контекст запроса влияет на ответ. Используйте маршрутизацию по странам, когда маршрут изменяется в зависимости от региона, языка, валюты, доступности или поведения перенаправления. Используйте более сильную доставку только тогда, когда повторные доказательства показывают, что простой путь не может вернуть используемую страницу.
Чистый шаблон - тестировать один контроль за раз. Если ожидание улучшает ответ, оставьте его привязанным к этому классу маршрута. Если сессии важны, держите их в рамках связанных запросов. Если требуется визуальное подтверждение, запрашивайте скриншоты там, где люди действительно проверяют результат. Избегайте превращения каждого захвата SPA в самый дорогой возможный запрос.
Используйте сессии для непрерывности состояния, пользовательские заголовки для контекста запроса и контроль маршрутизации, когда путь доставки влияет на публичный ответ.
ScraperFly автоматически навигирует по всему SPA?
Нет. ScraperFly захватывает предоставленные публичные маршруты и возвращает ответ в запрашиваемом формате. Ваш рабочий процесс должен решать, какие маршруты посещать, как обнаруживать URL, какие поля извлекать, как сравнивать изменения, где хранить данные и как обрабатывать оповещения или анализ на нижестоящем уровне. Эта граница сохраняет обещание ясным и полезным.
Это обычно лучшая архитектура. API обрабатывает захват страниц, рендеринг, ожидания, файлы, форматы и контроль доставки. Ваша система владеет картой маршрутов и специфическим значением продукта. Если маршрут неполный, вы можете скорректировать захват. Если парсинг не удался, вы можете скорректировать извлечение. Эти две проблемы остаются отдельными.
Как можно сделать скрапинг SPA доступным?
Работа браузера требует больше ресурсов, чем простой захват HTML, поэтому контроль затрат начинается с классификации маршрутов. Держите статические или серверно-рендеренные маршруты легкими. Рендерите маршруты, которые доказывают, что JavaScript изменяет результат. Добавляйте ожидания только тогда, когда асинхронный контент требует их. Резервируйте скриншоты, PDF, сессии, маршрутизацию по странам и более сильную доставку для рабочих процессов, которые действительно используют эти элементы управления.
ScraperFly поддерживает этот путь, потому что вы можете начать бесплатно, протестировать представительные маршруты SPA, купить кредиты для неравномерных проектов и перевести повторяющиеся рабочие нагрузки на ежемесячные кредиты, как только известен состав страниц. Решение о покупке становится проще, когда команда знает, какие маршруты легкие, какие отрендеренные и какие требуют дополнительного подтверждения или маршрутизации.
Просмотрите цены после тестирования реальных маршрутов SPA, чтобы оценка отражала фактические профили запросов, а не общие предположения.
С чего должна начать команда?
Начните в API Builder с одного реального публичного маршрута SPA. Сначала запросите исходный HTML. Если контент отсутствует, включите рендеринг и сравните вывод. Добавьте ожидания только если отрендеренный маршрут все еще захватывает слишком рано. Затем выберите формат, который нужен вашему рабочему процессу: отрендеренный HTML для парсеров, Markdown или текст для читаемого контента, метаданные JSON для журналов, скриншот или PDF для визуального подтверждения.
Как только профиль запроса будет подтвержден, переместите его в cURL, Python, Node.js, очередь бэкенда, задачу мониторинга или рабочий процесс агента. Держите этот профиль видимым, чтобы будущие ошибки можно было отлаживать на основе доказательств ответа, а не предположений.












