






ScraperFlyAPI de datos web lista para IA

use cases

API de Scraping para Monitoreo de Disponibilidad de Stock en páginas públicas

ScraperFly proporciona a los equipos de inventario, comercio electrónico y monitoreo una capa de captura práctica para páginas de disponibilidad pública. Preserva evidencia de producto, variante, vendedor, mercado y visual antes de que los sistemas posteriores etiqueten un producto como disponible, no disponible, cambiado o listo para revisión.

Evidencia de disponibilidad

Captura el estado de la página antes de que las señales de stock tomen decisiones

El monitoreo de stock se vuelve poco confiable cuando la capa de captura no puede explicar lo que vio. Un producto puede parecer disponible en una variante, agotado en otra, oculto detrás de JavaScript, diferente por ubicación, o temporalmente reemplazado por una página de error suave. ScraperFly ofrece a los equipos una forma controlada de capturar páginas de productos públicas antes de que los sistemas posteriores etiqueten un artículo como en stock, fuera de stock, cambiado o listo para revisión.

El objetivo no es convertir a ScraperFly en una base de datos de inventario o un sistema de alertas. El objetivo es evidencia de fuente más limpia: HTML cuando la señal de disponibilidad ya está en el marcado, salida renderizada cuando el código del frontend crea el estado final, metadatos para diagnósticos, y capturas de pantalla o PDFs cuando un humano necesita prueba de lo que mostró la página.
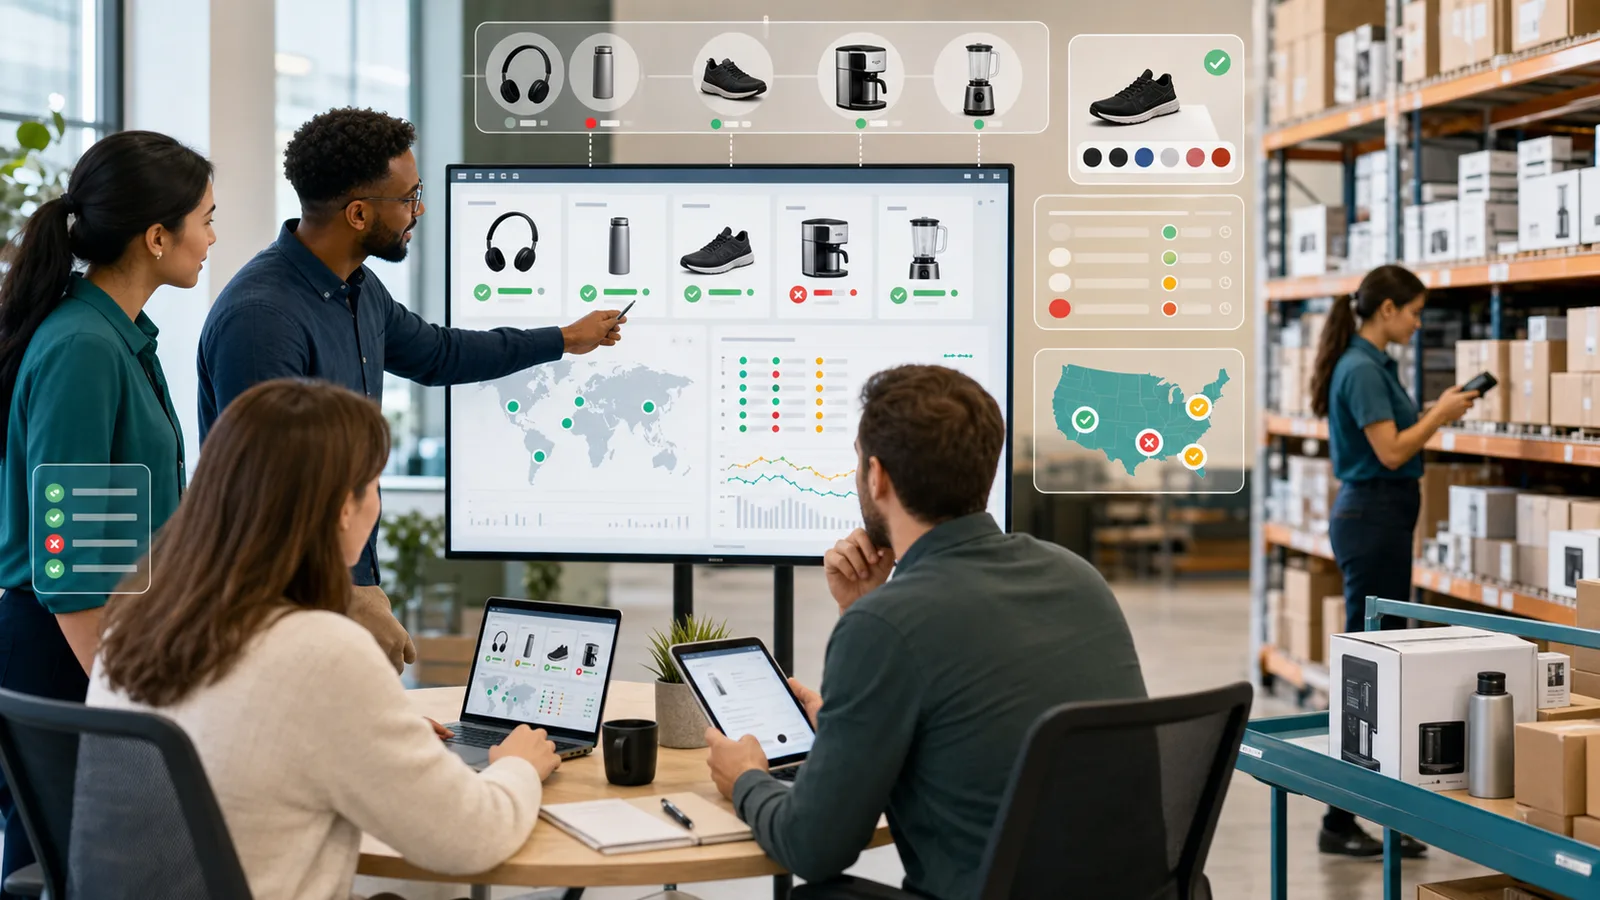
prueba de disponibilidadcontexto de varianteverificaciones regionales
Equipo de operaciones minoristas revisando evidencia pública de disponibilidad de stock a través de productos y regiones

¿Qué es una API de scraping para monitoreo de disponibilidad de stock?

Una API de scraping para monitoreo de disponibilidad de stock es una capa de captura para páginas de productos públicas. Recupera la página, devuelve la respuesta en un formato utilizable y proporciona a tu aplicación suficiente contexto para decidir si se puede confiar en una señal de disponibilidad. El sistema posterior aún posee la lógica de monitoreo real: horarios, comparaciones, alertas, umbrales, coincidencias de productos, mapeo de variantes, reglas de almacén y decisiones comerciales.

Este límite es importante. Las páginas de productos públicas no siempre son fuentes de datos ordenadas. La disponibilidad puede aparecer en HTML fuente, DOM renderizado, datos incrustados, etiquetas de botones, widgets de recogida en tienda, paneles de entrega, selectores de variantes, módulos de vendedores o plantillas específicas de región. Un flujo de trabajo confiable comienza preservando la evidencia de la página pública, luego construye analizadores y reglas de alerta sobre esa evidencia en lugar de adivinar a partir de un solo campo frágil.

Conclusión práctica: usa ScraperFly para capturar claramente el estado de la página pública, luego deja que tu propio sistema de monitoreo decida qué significa la señal de disponibilidad.

¿Qué evidencia de disponibilidad deberían capturar los equipos?

El registro útil es más amplio que un simple valor verdadero o falso. Un trabajo de monitoreo debería saber qué producto fue verificado, qué variante fue seleccionada, qué vendedor o contexto de tienda se aplicó, qué región o idioma influyó en la página, qué formato de respuesta se utilizó y cómo se veía la página cuando se capturó la señal. Sin ese contexto, una alerta puede volverse ruidosa rápidamente: un color está agotado pero el producto no, la recogida no está disponible pero la entrega está abierta, un vendedor de mercado cambió, o la solicitud llegó a una página de respaldo en lugar de a la página del producto real.

ScraperFly ayuda manteniendo visible el perfil de la solicitud. Los equipos pueden comparar HTML fuente con salida renderizada, preservar la URL final y los metadatos de respuesta, solicitar texto o Markdown para flujos de trabajo de revisión, y agregar capturas de pantalla o PDFs para prueba visual cuando los cambios de disponibilidad necesitan verificación humana.

Área de evidencia Qué capturar Por qué es importante
Identidad del producto URL, título, SKU, URL canónica, vendedor de mercado Previene que las alertas mezclen productos similares o páginas duplicadas.
Contexto de variante Tamaño, color, configuración, tamaño del paquete, opción seleccionada La disponibilidad a menudo cambia a nivel de variante, no a nivel de producto.
Señal de disponibilidad Texto de disponibilidad, botones deshabilitados, insignia de stock, estado de recogida o entrega Proporciona al analizador posterior múltiples señales para comparar.
Contexto de mercado País, idioma, moneda, tienda, área de entrega, estado de cookies La disponibilidad pública puede cambiar según la geografía y el contexto de sesión.
Prueba de captura Estado, URL final, tamaño de respuesta, captura de pantalla, PDF, marca de tiempo Facilita la investigación de falsos positivos después de que se activa una alerta.

¿Por qué ocurren señales de stock falsas?

Las señales de stock falsas generalmente provienen de un desajuste entre lo que el sistema de monitoreo cree que capturó y lo que la página pública realmente devolvió. Una solicitud puede recibir un código de estado exitoso pero aún así aterrizar en una pantalla de consentimiento, selector de ubicación, página de región no soportada, shell de aplicación vacío, página de familia de productos genérica, página de producto eliminado, o error temporal en el upstream. Un selector de variante puede predeterminar un tamaño popular en lugar del tamaño previsto. Una página de mercado puede cambiar de vendedores. Un módulo de entrega puede requerir contexto regional antes de mostrar una respuesta real.

La solución no es hacer que cada solicitud sea más pesada. La solución es preservar suficiente evidencia para diagnosticar la falla. Compara HTML crudo y HTML renderizado. Verifica la URL final, el tamaño de respuesta, el tipo de contenido y el estado. Usa capturas de pantalla para estados visuales disputados. Agrega sesiones solo cuando la continuidad cambie la respuesta. Agrega enrutamiento por país solo cuando la salida regional importe. Reintenta fallos temporales con retroceso limitado, pero no reintentes URLs inválidas, formatos no soportados o errores de autenticación como si fueran cambios de stock.

¿Cuándo debería el monitoreo de stock usar renderizado, sesiones, encabezados o enrutamiento por país?

Usa renderizado de JavaScript cuando la señal de disponibilidad aparezca solo después de la ejecución del navegador. Esto es común para páginas de productos con selectores de variantes del lado del cliente, módulos de recogida en tienda, paneles de entrega, widgets de inventario cargados de forma perezosa, o frontends que hidratan el estado de stock después de la respuesta inicial. Comienza comparando HTML crudo y HTML renderizado. Si el renderizado no cambia la evidencia de disponibilidad, mantén la solicitud más ligera.

Usa sesiones cuando las solicitudes relacionadas dependan de un estado compartido, como una tienda seleccionada, región, preferencia de cookies o interacción pública de múltiples pasos. Usa encabezados cuando la página espere un contexto de solicitud legítimo como idioma o tipo de contenido aceptado. Usa enrutamiento por país cuando la disponibilidad, precios, entrega, moneda o contenido de la tienda cambien por región. Usa entrega más fuerte solo cuando la evidencia de respuesta muestre que el camino simple es inestable.

Para una configuración más profunda, revisa la API de renderizado de JavaScript, API de sesiones, API de scraping de encabezados personalizados, y la guía de orientación por país cuando la página pública cambie por mercado.

¿Qué formato de respuesta se adapta al monitoreo de stock?

HTML es el punto de partida natural cuando tu analizador necesita estructura de página, botones, atributos, datos incrustados, tarjetas de productos o selectores de variantes. HTML renderizado es útil cuando el navegador crea el DOM final. Texto y Markdown son útiles para revisión, QA e inspección rápida cuando un humano necesita entender lo que dijo la página sin leer el marcado. Los metadatos JSON ayudan en el registro y la investigación porque el sistema de monitoreo puede almacenar estado, URL final, forma de respuesta y diagnósticos con el resultado analizado.

Las capturas de pantalla y los PDFs son útiles cuando la disponibilidad necesita prueba visual. No suelen ser la mejor entrada para el analizador, pero son valiosos para alertas disputadas, revisiones de cumplimiento, instantáneas de QA y evidencia de antes y después. En la práctica, muchos equipos almacenan salida legible por máquina para automatización y salida visual solo para eventos seleccionados donde la prueba importa.

Formato Usarlo para Mejor ajuste de disponibilidad
HTML o HTML renderizado Analizadores, selectores, datos incrustados, módulos de variantes Fuente primaria para extracción de productos y stock.
Texto o Markdown Revisión humana, resúmenes, QA, inspección asistida por IA Evidencia legible cuando el marcado es demasiado ruidoso para la revisión.
Metadatos JSON Diagnósticos, URL final, estado, tipo de contenido, registro Contexto operativo para explicar alertas de stock.
Captura de pantalla o PDF Prueba visual, archivos, cambios disputados, registros de QA Evidencia para alertas seleccionadas y verificación humana.

¿Qué debería permanecer en el sistema posterior a ScraperFly?

ScraperFly no debería ser tratado como una plataforma completa de monitoreo de stock. No programa cada verificación, decide reglas de coincidencia de productos, reserva inventario, alerta a los comercializadores, interpreta sistemas de inventario privados, o garantiza que el contenido de la página pública sea igual al stock real del almacén. Esas decisiones pertenecen a la aplicación que conoce el catálogo, las tiendas, las reglas, los umbrales y el proceso comercial.

Esta separación es saludable. ScraperFly captura la evidencia de la página pública. Tu sistema de monitoreo aplica lógica de producto, deduplicación, mapeo de variantes, umbrales de alerta, almacenamiento, paneles de control y reglas de escalamiento. Mantener esas responsabilidades separadas facilita la auditoría del flujo de trabajo porque cada alerta puede señalar de vuelta a la respuesta que la creó.

¿Cómo deberían los equipos comenzar con ScraperFly?

Comienza con una pequeña muestra representativa: una página de producto simple, una página de producto con muchas variantes, una página regional, una página de mercado o de múltiples vendedores, y una página conocida como fuera de stock. Prueba estas en el API Builder antes de escribir lógica de producción. Captura HTML primero, compara la salida renderizada solo cuando la respuesta fuente esté incompleta, y decide qué formatos realmente necesita tu analizador, proceso de QA y archivo.

Una vez que el perfil de la solicitud esté probado, escala con cuidado. Mantén páginas sencillas en solicitudes más ligeras, agrupa plantillas pesadas en JavaScript por separado, y reserva capturas de pantalla, PDFs, sesiones, enrutamiento por país o entrega más fuerte para objetivos que hayan demostrado una necesidad real. Al planificar verificaciones recurrentes, revisa precios para que el peso de la solicitud, la frecuencia de verificación y el valor de monitoreo se mantengan alineados.

Los flujos de trabajo relacionados a menudo comparten las mismas decisiones de captura. Los equipos de catálogo de productos pueden usar la guía de extracción de datos de productos, los equipos de comercio electrónico pueden comparar patrones más amplios de scraping de comercio electrónico, y los equipos que ajustan la forma de salida pueden revisar formatos de respuesta antes de construir convertidores.


Monitoreo de disponibilidad de stock

Rastrea señales de stock públicas sin pagar de más antes de que se demuestre el comportamiento objetivo

El monitoreo de disponibilidad se vuelve costoso cuando cada página de producto utiliza el perfil de solicitud más pesado desde el primer día. ScraperFly permite a los equipos comenzar con muestras reales, probar dónde viven las señales de stock, y luego agregar renderizado, enrutamiento, sesiones o prueba visual solo donde la tienda lo requiera.

Equipo feliz validando un proyecto en una laptop
01 / Comienza fácil

Inicio fácil y gratuito antes de cualquier presión de facturación

ScraperFly te da espacio para probar el objetivo real primero. Usa créditos gratuitos para verificar si la página funciona, si los datos están presentes y qué controles son realmente necesarios antes de comprometer dinero a un plan. Eso hace que el primer experimento se sienta ligero: sin bucle de adquisición, sin suscripción forzada, sin adivinar tu volumen mensual desde el primer día.

Créditos gratuitosSin tarjeta para las primeras pruebasValida antes de escalar
Profesional sonriente trabajando con éxito en una laptop
02 / Gasta inteligentemente

Facturación asequible y flexible para el volumen de scraping del mundo real

No toda carga de trabajo de scraping es una curva mensual ordenada. Algunos proyectos aumentan, algunos se detienen y algunos solo se convierten en recurrentes después de que los datos demuestran su valor. ScraperFly apoya esa realidad con un camino de pago por uso más planes de crédito mensuales cuando el volumen constante tiene sentido. Puedes comprar lo que necesitas, mantener los costos visibles y evitar convertir una pequeña prueba en una suscripción sobredimensionada.

Pago por usoMensual cuando sea útilControl de costos
Desarrollador preparando salida estructurada desde una laptop
03 / Envía más rápido

Preprocesamiento de respuestas que elimina el trabajo de limpieza

Una obtención barata no es suficiente si tu equipo aún tiene que construir convertidores, limpiadores, capturas de pantalla, captura de PDF y formateo listo para LLM a su alrededor. ScraperFly puede devolver la respuesta como HTML, texto limpio, Markdown, JSON estructurado, PDF o salida de imagen, para que tu canal se acerque al activo final en una sola solicitud. Menos código de pegamento, menos partes móviles, entrega más rápida.

HTMLTextoMarkdownJSONPDFImagen

Dónde encaja ScraperFly en el monitoreo de stock

La ventaja práctica es la captura flexible: controles de solicitud visibles, múltiples formatos de respuesta y rutas de crédito que funcionan tanto para pruebas desiguales como para verificaciones recurrentes.

Punto de decisiónVentaja de ScraperFlyCompromiso típico de competidores
Primer experimentoComienza con créditos gratuitos y valida el objetivo real antes de gastar. Puedes comprobar si realmente se necesita HTML en bruto, renderización, enrutamiento premium o segmentación por país.Las pruebas a menudo te empujan rápidamente hacia un plan recurrente o ocultan el verdadero costo hasta que los complementos entran en la solicitud.
Modelo de facturaciónUtiliza créditos de pago por uso para trabajos irregulares, y luego pasa a créditos mensuales solo cuando la carga de trabajo se vuelve predecible. Esto mantiene las pruebas pequeñas y el scraping basado en proyectos asequible.Muchas herramientas están optimizadas en torno a suscripciones mensuales, asignaciones fijas o puertas de nivel que pueden sentirse pesadas antes de que se demuestre el volumen.
Peso de la solicitudMantén las páginas simples simples. Activa la renderización de JavaScript, el enrutamiento premium, las sesiones, los encabezados, las esperas o el enrutamiento por país solo cuando la evidencia de la respuesta indique que son importantes.Pueden existir controles comparables, pero a menudo están agrupados en niveles más altos, predeterminados o perfiles de precios más complejos.
Formatos de salidaDevuelve la respuesta en la forma que tu producto necesita: HTML para analizadores, texto o Markdown para tuberías de contenido, JSON para metadatos estructurados, y salida en PDF/imágenes para prueba visual.Algunos proveedores se centran principalmente en el acceso y dejan el formato, la captura, la limpieza y la preparación posterior a tu propio código.
Flujo de trabajo del desarrolladorUna superficie de API puede cubrir pruebas de objetivos, escalamiento, renderización, enrutamiento, sesiones, encabezados, formateo de respuestas y verificaciones de estado. El camino desde el prototipo hasta la producción se mantiene compacto.Las herramientas centradas en proxies, los mercados de actores y las plataformas de rastreo pueden ser poderosas, pero a menudo requieren más código de pegamento o un modelo operativo más pesado.
Mejor ajusteEquipos que desean entrega práctica de datos web: comienza pequeño, mide el costo por resultado útil y escala solo los controles que mejoran el resultado.Los equipos con contratos fijos de alto volumen, infraestructura de proxy personalizada o necesidades amplias de rastreo de mercado pueden preferir una plataforma más especializada.

Campos de disponibilidad

Captura evidencia de stock con contexto de producto, variante, vendedor y mercado

Los datos de disponibilidad útiles incluyen nombre del producto, SKU, variante, precio, estado de stock, vendedor, ubicación, opción de entrega, marca de tiempo, URL de origen y prueba de página cuando una alerta necesita confianza humana.

Comercio

Convierte las páginas de comercio público en inteligencia de precios e inventario

Rastrea los precios de los competidores, cambios de stock, vendedores, ofertas de mercado, tarifas de viaje y cambios en el catálogo antes de que afecten los ingresos.

Laptop con gráficos analíticos para monitoreo de precios
Comercio

Monitoreo de precios de comercio electrónico

Observa los precios de los competidores, descuentos, estado de stock, términos de envío y movimientos de vendedores para que los equipos de precios puedan reaccionar antes de que los cambios en el mercado se vuelvan invisibles.

Useful fields: precio, descuento, stock, vendedor, envío

Persona navegando productos en un smartphone
Comercio

Enriquecimiento de catálogo de productos

Completa títulos, descripciones, especificaciones, imágenes, variantes e identificadores faltantes de páginas de productos públicos y catálogos de fabricantes.

Useful fields: título, descripción, especificaciones, imágenes, SKU

Pasillo de gran almacén que representa las operaciones del mercado
Comercio

Inteligencia de vendedores del mercado

Compara la presencia de vendedores, modelos de cumplimiento, profundidad de surtido, calificaciones y cambios de oferta en los mercados.

Useful fields: vendedor, calificación, oferta, cumplimiento, surtido

Trabajador de almacén organizando estantes de inventario
Comercio

Seguimiento de inventario y disponibilidad

Detecta faltantes de stock, disponibilidad de recogida, inventario regional, promesas de entrega y brechas de disponibilidad de productos antes que los clientes.

Useful fields: stock, región, recogida, entrega, marca de tiempo

Persona con bolsas de compras revisando un smartphone
Comercio

Protección de marca

Encuentra vendedores no autorizados, precios sospechosos, señales de falsificación, reclamaciones incorrectas de productos y listados riesgosos en mercados públicos.

Useful fields: vendedor, precio, reclamaciones, imágenes, mercado

Escena de restaurante y hospitalidad al aire libre ocupada
Comercio

Monitoreo de viajes y hospitalidad

Recopila disponibilidad de habitaciones, tarifas, comodidades, términos de cancelación, señales de demanda local y contexto de reseñas a través de superficies de reserva.

Useful fields: tarifa, disponibilidad, comodidades, política, calificación

Teléfono mostrando una interfaz de compras en línea
Comercio

Clasificados y seguimiento de segunda mano

Monitorea nuevos listados, precios de venta, actividad de vendedores, condición del artículo, ubicación y antigüedad de la publicación en mercados de reventa.

Useful fields: listado, precio, condición, vendedor, ubicación

Portátil mostrando gráficos financieros y análisis
Comercio

Comparación de precios y re-precio

Convierte instantáneas de precios de competidores en entradas de re-precio, brechas de surtido, alertas de margen e informes de posición en el mercado.

Useful fields: competidor, precio, rango, disponibilidad, cambio

Crecimiento

Encuentra señales de demanda antes de que aparezcan en tus propios análisis

Monitorea resultados de búsqueda, anuncios, páginas de competidores, directorios de negocios, actividad de contratación y señales de leads para ver hacia dónde se mueve la atención.

Portátil mostrando panel de análisis para monitoreo SEO
Crecimiento

Monitoreo de SERP y SEO

Rastrea posiciones, fragmentos, anuncios, paquetes locales, idioma, dispositivo y diferencias geográficas para ver cómo cambia la visibilidad en la superficie de búsqueda real.

Useful fields: rango, URL, fragmento, anuncios, geo

Laptop abierta en una página de noticias o contenido
Crecimiento

Monitoreo de contenido de competidores

Observa los cambios en la página, encabezados, CTAs, esquema, enlaces internos y el inventario de contenido sin esperar auditorías manuales.

Useful fields: encabezado, CTA, esquema, enlaces, texto actualizado

Manos sosteniendo un teléfono con contenido de redes sociales
Crecimiento

Inteligencia de anuncios

Recopila copias de anuncios públicos, patrones creativos, páginas de destino, regiones, tiempos y actividad de anunciantes para la investigación de campañas.

Useful fields: copia, creativo, página de aterrizaje, región, fecha

Personas de negocios intercambiando documentos en una oficina
Crecimiento

Generación de leads y enriquecimiento de empresas

Crea listas de cuentas y enriquece los registros de empresas con dominios, ubicaciones, industrias, contactos públicos, señales de contratación y pistas tecnológicas.

Useful fields: empresa, dominio, industria, ubicación, señales

Pequeña cafetería local en la acera
Crecimiento

Datos de directorios de negocios locales

Recopila nombres, categorías, direcciones, horarios, sitios web, calificaciones y recuentos de reseñas de páginas de directorios públicos.

Useful fields: nombre, categoría, dirección, horarios, calificación

Trabajadores de oficina revisando documentos profesionales
Crecimiento

Inteligencia del mercado laboral

Rastrear títulos de trabajo, habilidades, rangos salariales, antigüedad, políticas de trabajo remoto y velocidad de contratación en páginas de carrera y bolsas de trabajo.

Useful fields: título, salario, habilidades, ubicación, antigüedad

Voz

Convertir conversaciones públicas en señales de producto y reputación

Recopilar reseñas, menciones en medios, discusiones comunitarias, publicaciones públicas y señales de creadores para entender lo que dicen los clientes y los mercados.

Persona leyendo un periódico mientras trabaja en una computadora portátil
Voz

Monitoreo de noticias y medios

Recopilar artículos, autores, fechas, temas, entidades, enlaces y metadatos de fuentes para flujos de trabajo de reputación, investigación y alertas.

Useful fields: título, autor, fecha, fuente, entidades

Personas comprando y revisando un smartphone juntas
Voz

Seguimiento de reseñas y sentimientos

Captura tendencias de calificación, temas de quejas, patrones de elogios, respuestas de negocios y contexto de producto-ubicación de reseñas públicas.

Useful fields: calificación, reseña, tema, respuesta, fecha

Persona navegando en una aplicación de redes sociales en un smartphone
Voz

Monitoreo de redes sociales y web pública

Monitorea publicaciones públicas, participación, hashtags, marcas de tiempo y contexto de perfil donde la política y el acceso a la fuente lo permitan.

Useful fields: publicación, participación, hashtag, perfil, tiempo

Persona leyendo artículos de noticias en una habitación
Voz

Inteligencia de comunidades y foros

Encuentra preguntas recurrentes, quejas, solicitudes de funciones y lenguaje problemático de comunidades públicas y foros de soporte.

Useful fields: pregunta, tema, queja, conteo de respuestas, fecha

Espacio de trabajo con laptop, café y periódico
Voz

Descubrimiento de creadores e influenciadores

Crea listas de descubrimiento a partir de páginas de perfil público, temas de contenido, señales de audiencia, cadencia de publicaciones y señales de colaboración.

Useful fields: perfil, tema, señal de audiencia, cadencia, enlace

Registros

Facilita el monitoreo de registros públicos y listados a gran escala

Extrae licitaciones, avisos legales, presentaciones, datos financieros y listados de bienes raíces en conjuntos de datos que los equipos pueden buscar, comparar y revisar.

Profesionales intercambiando documentos comerciales
Registros

Contratación pública y licitaciones

Rastrear compradores, presupuestos, plazos, requisitos, adjuntos, adjudicaciones y cambios a través de portales de licitaciones y avisos públicos.

Useful fields: comprador, presupuesto, plazo, requisitos, adjudicación

Profesionales discutiendo documentos legales en una oficina
Registros

Monitoreo regulatorio y legal

Monitorear avisos, registros públicos, fechas efectivas, versiones de documentos, entidades afectadas y cambios relevantes para el cumplimiento.

Useful fields: aviso, entidad, fecha, documento, estado

Profesionales revisando documentos financieros
Registros

Investigación financiera y de mercados públicos

Recopila presentaciones, divulgaciones, tablas, noticias, metadatos de instrumentos y contexto financiero público para pipelines de investigación.

Useful fields: presentación, tabla, emisor, fecha, métrica

Llaves de casas y efectivo para datos del mercado inmobiliario
Registros

Listados inmobiliarios y datos del mercado

Rastrea precios de listado, direcciones, atributos de propiedad, detalles del agente, estado, historial y contexto del vecindario.

Useful fields: precio, dirección, habitaciones, agente, estado

Productos de datos

Construye productos de datos a partir de páginas raspadas, no de volcado de páginas

Limpia, normaliza, valida, enriquece, compara y entrega datos web públicos en bases de datos, paneles, alertas y pipelines de LLM.

Pantalla de laptop con código de programación
Productos de datos

Canales de datos web listos para LLM

Convierte páginas públicas en texto limpio, Markdown, fragmentos, metadatos, citas y señales de frescura para recuperación o flujos de trabajo de modelos.

Useful fields: texto limpio, Markdown, fragmento, URL de origen, marca de tiempo

Racks de servidores en centros de datos para flujos de trabajo de bases de datos
Productos de datos

Extracción estructurada a base de datos

Convierte HTML, PDFs, tablas y texto de página en registros tipados que pueden ser almacenados, consultados, unidos y auditados más tarde.

Useful fields: JSON, tipo, fuente, esquema, ID de registro

Laptop con interfaz de codificación y análisis de datos
Productos de datos

Detección de cambios y alertas

Compara instantáneas y alerta a los equipos cuando cambian precios, stock, rango, contenido, estado o lenguaje regulatorio.

Useful fields: valor anterior, nuevo valor, delta, umbral, alerta

Pantalla de computadora con código y datos coloridos
Productos de datos

Enriquecimiento y normalización de entidades

Normalizar IDs de productos, nombres de empresas, ubicaciones, personas, categorías, unidades, monedas y mapeos de taxonomía.

Useful fields: entidad, ID canónico, categoría, unidad, confianza

Primer plano de un rack de servidores con indicadores azules
Productos de datos

Validación de calidad de datos

Verifique los campos requeridos, tipos de datos, rangos, duplicados, evidencia de origen y registros sospechosos antes de su uso posterior.

Useful fields: campo requerido, tipo, rango, evidencia, confianza

Laptop con editor de código para alimentación de informes de datos
Productos de datos

Alimentaciones de informes y paneles

Alimenta paneles de BI, informes de mercado, tarjetas de puntuación operativas y análisis recurrentes con datos web que se actualizan según lo programado.

Useful fields: métrica, dimensión, período, fuente, actualizar

¿Por qué raspar páginas de stock?

Las verificaciones de disponibilidad necesitan evidencia, no solo una etiqueta frágil

Una página de producto pública puede cambiar por variante, país, vendedor, tienda, dispositivo, estado de cookies o tiempo de frontend. Capturar el estado completo de la página proporciona a los monitores posteriores una base más sólida para alertas.

  • Rellena los vacíos dejados por las APIsMuchas fuentes exponen páginas públicas útiles, pero no hay una API completa para los campos exactos, geos, filtros o historiales que un equipo necesita.
  • Monitorea el cambio a lo largo del tiempoLas extracciones recurrentes crean un historial de precios, contenido, disponibilidad, clasificaciones, reseñas, avisos y movimientos de mercado.
  • Compara entre fuentesEl scraping hace posible la comparación entre sitios cuando los mercados, directorios, portales y editores estructuran los datos de manera diferente.
  • Crea registros utilizablesLa salida útil no es un volcado de página; es un registro normalizado, con fuente y marca de tiempo, en el que los sistemas posteriores pueden confiar.
Ajuste de ScraperFly

Una capa de captura para páginas de productos que se comportan de manera diferente

ScraperFly ayuda a los equipos a mantener objetivos fáciles ligeros mientras agrega renderizado, sesiones, encabezados, enrutamiento o capturas de pantalla solo donde la evidencia de disponibilidad demuestra que esos controles importan.

Una API para fuentes variadas

Utiliza el mismo patrón de integración en tiendas, páginas de búsqueda, directorios, documentos, listados públicos y tuberías de productos de datos.

Controles de entrega cuando se necesitan

Renderización, sesiones, encabezados, geo y enrutamiento de proxies se pueden agregar para objetivos que los necesiten sin reconstruir el flujo de trabajo.

Salida que soporta el post-procesamiento

HTML, capturas de pantalla, texto limpio, Markdown y rutas de extracción estructuradas ayudan a los equipos a pasar de la recuperación de páginas a registros utilizables.

Menos infraestructura de scraping que poseer

Los equipos pueden centrarse en campos, validación, frescura y lógica empresarial en lugar de flotas de navegadores, casos límite de enrutamiento y plomería de reintentos.

Comportamiento objetivo de stock

Verifica variantes, vendedores, ubicación y estado de la página antes de confiar en alertas de stock

Las páginas de stock pueden variar por tamaño, color, vendedor, almacén, país, idioma, estado de cookies, dispositivo, promoción, tiempo de JavaScript y comportamiento de productos eliminados. La precisión del monitoreo depende de preservar ese contexto.

Respuesta HTML cruda mapeada a datos visibles de la página
01

Disponibilidad de HTML crudo

Verifica si los campos que necesitas ya están presentes en la primera respuesta HTML.

Mejor primera prueba para páginas simples, artículos, documentos, listados y detalles de productos.

Comparación antes y después de la renderización de JavaScript
02

Dependencia de JavaScript

Compara HTML crudo con el DOM renderizado o captura de pantalla antes de activar la renderización del navegador.

Usa la renderización cuando el HTML crudo es solo una estructura y los scripts crean el contenido útil.

Cookies, consentimiento, contexto de sesión y acceso para scraping
03

Estado y contexto de acceso

Identifica si las cookies, el consentimiento, los límites de inicio de sesión, la paginación o el mismo estado del visitante afectan la respuesta.

Usa sesiones y encabezados cuando la continuidad cambia los datos que recibes.

Variaciones de contenido regional a través de países y rutas
04

Variación geo/contenido

Prueba si el país, idioma, moneda, inventario, SERP, anuncios o la reputación de la ruta cambian el resultado.

Usa enrutamiento geo o premium solo cuando el objetivo demuestra que la respuesta varía según la ruta.

Preguntas que protegen la precisión del monitoreo de stock

¿Dónde está el campo objetivo?

Encuentra si el campo existe en HTML crudo, DOM renderizado, una llamada API, datos estructurados, un archivo o un estado de interacción posterior.

¿Qué cambia la respuesta?

Muestra algunas URL y compara el estado, la URL final, la longitud del contenido, redirecciones, estados vacíos y diferencias en los resultados visibles.

¿Qué contexto se requiere?

Marca cualquier dependencia en consentimiento, localización, cookies, encabezados, límites de autenticación, paginación, filtros o solicitudes anteriores.

¿Cómo se ve el fallo?

Define las señales para respuestas bloqueadas, parciales, obsoletas, redirigidas, vacías, con tiempo de espera o desajustadas por región antes de escalar.

¿Qué cambios en el perfil de solicitud?

Modo de obtención

La disponibilidad de HTML crudo decide si la primera solicitud puede permanecer simple o necesita renderizado, esperas, capturas de pantalla o extracción.

Contexto de la solicitud

Los requisitos de estado deciden si agregar encabezados, cookies, sesiones, manejo de consentimiento o un perfil de visitante estable.

Elección de enrutamiento

Los hallazgos geográficos y de reputación deciden si el enrutamiento estándar es suficiente o si se justifica una ruta de país/premium.

Reglas de validación

Los estados de fallo conocidos se convierten en verificaciones para reintentos, escalación, revisión de QA y decidir cuándo un perfil más ligero sigue siendo completo.

Constructor de solicitudes de stock

Construye verificaciones de disponibilidad repetibles con el formato de salida que cada alerta necesita

Utiliza HTML para parsers personalizados, texto o Markdown para revisiones legibles, metadatos JSON para diagnósticos y capturas de pantalla cuando el estado del stock o la selección de variantes necesitan confirmación visual.

HTML
Respuesta cruda

HTML crudo para analizadores y rastreadores

Utiliza el camino más rápido para páginas estáticas, listados, documentos y páginas de productos. Obtén primero el HTML fuente original, luego activa el renderizado del navegador cuando JavaScript cree el marcado que tu scraper necesita.

formato=htmlrender=falserender=true
TXT
Datos limpios

Texto, Markdown y JSON

Salta la capa de limpieza después del acceso a la página. Devuelve texto legible para agentes, Markdown para indicaciones y RAG, o JSON estructurado con metadatos, enlaces, encabezados, texto limpio y Markdown listo para tu canal.

formato=textformato=markdownformato=json
PDF
Archivos visuales

Capturas de pantalla y PDFs

Captura lo que un navegador real ve cuando necesitas evidencia de QA, prueba archivada, verificaciones de regresión visual, informes descargables o registros de páginas compartibles para clientes y equipos internos.

format=screenshotformat=pdfdescargar

Controles que mantienen las solicitudes predecibles

url

La página objetivo para obtener, renderizar, limpiar o capturar.

format

Selecciona la respuesta que tu producto necesita: html, texto, markdown, json, captura de pantalla o pdf.

premium

Escalar a enrutamiento más fuerte para bloques, objetivos inestables o contenido sensible a la geolocalización.

render

Ejecuta Chromium para SPAs, marcado inyectado por JS, capturas de pantalla, PDFs y páginas solo para navegador.

country

Solicita una ruta específica de país cuando el contenido cambia según la ubicación.

keep_headers

Reenvía el contexto de solicitud seleccionado, como user-agent, cookie, idioma y referer.

render_wait

Dale al contenido dinámico una espera controlada adicional antes de la extracción o captura.

download

Devuelve artefactos visuales como archivos descargables cuando la salida es captura de pantalla o PDF.

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Recuperación de disponibilidad

Convierte las fallas en el monitoreo de stock en acciones siguientes más claras

Un estado de producto faltante no siempre es un cambio de stock. Puede ser una redirección, un contenedor de JavaScript vacío, un desajuste regional, un límite de tasa o una respuesta temporal de la tienda. Trata esas señales como evidencia para que las alertas sigan siendo útiles.

contenedor vacío429redireccióndesajuste de región
Desarrollador revisando código y parámetros de solicitud de API en una laptop

01 / Configuración de solicitud y acceso

Corrige primero los errores de solicitud

Algunas fallas no son problemas del objetivo en absoluto. Ocurren antes de que ScraperFly pueda hacer un intento de entrega significativo: una URL faltante o mal formada, un formato de salida no soportado, un tipo de archivo visual incompatible, una clave de API faltante, una clave inválida, o una clave que ha sido pausada o deshabilitada. Estos errores son señales de configuración, no señales de reintento: detén el flujo de trabajo, señala al desarrollador el campo exacto que necesita corrección, y mantén los créditos enfocados en pruebas reales del objetivo en lugar de entradas incorrectas repetidas.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Valida la URL y la codificación antes de enviar un lote.

  • Usa salidas soportadas: HTML, texto, Markdown, JSON, captura de pantalla o PDF.
  • Ajusta los tipos de archivo de captura de pantalla al tipo de salida de imagen y el tipo de archivo PDF a la salida PDF.
  • Trata las claves de API faltantes o inválidas como trabajo de configuración, no como trabajo de reintento.
Tablero de negocios con gráficos, documentos y planificación de uso en un escritorio

02 / Créditos, límites y concurrencia

Separar límites de fallos

Una carga de trabajo puede fallar porque la cuenta no tiene créditos utilizables, se ha alcanzado el límite del plan mensual, o la concurrencia es demasiado agresiva para el plan actual y la mezcla de objetivos. ScraperFly hace visibles esos límites como señales operativas, no como fallas misteriosas de raspado. Eso mantiene la decisión de compra práctica: comienza gratis, prueba el objetivo, compra créditos de pago por uso para trabajos irregulares, pasa a créditos mensuales cuando el volumen se vuelve predecible, y usa retroceso cuando la presión de solicitud es el verdadero problema.

usage_limit_reachedrate_limitedcreditsretroceso
  • Usar el estado de la cuenta para verificar créditos restantes antes de ejecuciones grandes.
  • Reintentar límites de tasa con retroceso en lugar de aumentar la presión de inmediato.
  • Mantener proyectos únicos en pago por uso cuando el volumen es desigual.
  • Mover trabajos recurrentes predecibles a créditos mensuales cuando el patrón esté comprobado.
Sala de servidores que representa rutas de entrega, enrutamiento e infraestructura de red

03 / Entrega objetivo y red

Encontrar fallos de entrega primero

Muchas plataformas de scraping colapsan los problemas de entrega en un fallo de solicitud vago. En producción, eso no es suficiente. El equipo necesita saber si la solicitud se agotó, si el objetivo ascendente devolvió un error temporal del servidor, si la conexión falló, si la respuesta fue demasiado grande, si las redirecciones fueron a algún lugar inesperado, o si la página regresó como un HTML pequeño sin contenido útil. ScraperFly convierte esos fallos en evidencia de entrega: prueba primero el perfil ligero, compara el estado y el tamaño de la respuesta, luego decide si la siguiente solicitud necesita retroceso, otra ruta, proxy premium, segmentación por país, o una captura más estrecha.

tiempo de espera5xxredireccionesrespuesta_demasiado_grande
  • Reintentar fallos temporales de red y ascendentes con una política de retroceso controlada.
  • Comparar URL final, estado, tipo de contenido y tamaño de respuesta entre muestras.
  • Escalar el enrutamiento solo cuando la respuesta demuestre que el camino simple es inestable.
  • Tratar respuestas sobredimensionadas como un problema de alcance antes de escalar el mismo perfil.
Pantalla de seguridad digital que representa señales de anti-bot y acceso protegido

04 / Bloques de anti-bot, geográficos y de acceso

Leer bloques antes de la escalación

Una pantalla de error 403, 401, 429, CAPTCHA, desafío WAF, muro de inicio de sesión, bucle de consentimiento o desajuste específico de región no es solo un error; es una pista sobre lo que el sitio espera del visitante. Los competidores a menudo empujan a los equipos hacia un perfil predeterminado más pesado, pero eso puede agotar el presupuesto sin demostrar la solución. El mejor camino de ScraperFly es la escalación basada en evidencia: preservar encabezados realistas cuando el contexto importa, usar sesiones cuando la continuidad cambia la respuesta, habilitar renderizado cuando el contenido útil es generado por el navegador, y elegir enrutamiento premium o por país cuando la reputación o la geografía cambian el resultado.

403429CAPTCHAdesajuste de país
  • Usar enrutamiento premium cuando la reputación de IP es el cuello de botella comprobado.
  • Usar segmentación por país cuando el idioma, la moneda, el inventario o los resultados de búsqueda cambian según el mercado.
  • Usar encabezados, cookies y sesiones cuando el estado del visitante cambia la respuesta.
  • Reducir la concurrencia y agregar retroceso cuando las solicitudes repetidas activan la limitación del objetivo.
Desarrollador preparando código y artefactos de salida en una laptop

05 / Calidad de renderizado y salida

Enviar artefactos utilizables

Un estado 200 no es lo mismo que un raspado utilizable. El HTML crudo puede ser un shell de aplicación vacío, Markdown puede omitir el artículo principal, JSON puede carecer de metadatos esperados, el texto puede incluir ruido, las capturas de pantalla pueden estar en blanco, y la salida en PDF o imagen puede fallar si el paso del navegador se agota. ScraperFly es valioso porque la misma solicitud de API puede pasar de HTML crudo a DOM renderizado, texto limpio, Markdown, JSON, captura de pantalla o PDF, y luego ser verificada contra el artefacto que tu producto realmente necesita. Eso reduce el código de pegamento, las importaciones fallidas y las ejecuciones por lotes costosas que solo descubren una mala salida después del hecho.

render_timeoutbrowser_render_failedcampos JSONsalida PDF/imágenes
  • Habilitar renderizado cuando el HTML crudo es solo un shell y el contenido útil aparece después de JavaScript.
  • Valida texto, Markdown y JSON contra los campos esperados antes de agrupar.
  • Utiliza captura de pantalla o salida en PDF cuando la prueba visual o la evidencia de auditoría son importantes.
  • Considera los artefactos en blanco o parciales como fallos de calidad incluso cuando el estado HTTP es exitoso.

Preguntas frecuentes sobre stock

Preguntas comunes sobre flujos de trabajo de monitoreo de disponibilidad de stock

Respuestas prácticas para equipos que utilizan páginas de productos públicas como evidencia de fuente para verificaciones de disponibilidad, revisión de reabastecimiento y monitoreo de flujos de trabajo.

Respuestas de stock
Señales

Evidencia del estado del stock

Preguntas sobre lo que realmente dice la página antes de que se cree una alerta.

¿Puede ScraperFly decidir si un producto está en stock?

ScraperFly captura la evidencia de la página pública. Tu aplicación debe interpretar el estado del stock, variantes, umbrales y reglas de alerta.

¿Por qué una etiqueta de stock no es suficiente?

La disponibilidad puede depender de la variante, vendedor, método de entrega, tienda, país o opción seleccionada. La evidencia de la página circundante hace que la señal sea más fácil de confiar.

Contexto

Variantes y regiones

Preguntas sobre páginas que cambian según la tienda, el mercado o la opción de producto seleccionada.

¿Cuándo importa el enrutamiento por país?

Úsalo cuando la disponibilidad pública, moneda, entrega, idioma o contenido de la tienda cambien por región y el monitor necesite una vista de mercado específica.

¿Cuándo ayudan las sesiones?

Las sesiones ayudan cuando la elección de la tienda, el estado de consentimiento, las cookies o un paso público anterior cambian la respuesta de disponibilidad.

Salida

Formatos para monitoreo

Preguntas sobre cómo elegir evidencia legible por máquina y visual.

¿Qué salida debería usar un parser?

Comienza con HTML o HTML renderizado cuando los selectores y la estructura de la página son importantes. Usa texto o Markdown para revisiones y capturas de pantalla o PDFs para pruebas visuales.

¿Debería cada alerta almacenar una captura de pantalla?

Generalmente no. Almacena pruebas visuales para cambios disputados, muestras de QA, aprobaciones o eventos de alto valor donde un humano pueda necesitar verificar lo que mostró la página.

Operaciones

Reintentos y control de costos

Preguntas sobre cómo escalar verificaciones recurrentes sin hacer que cada solicitud sea pesada.

¿Debería cada página de producto usar renderización?

No. Compara primero el HTML fuente y habilita la renderización solo cuando JavaScript crea la evidencia de disponibilidad que tu flujo de trabajo necesita.

¿Cómo evitan los equipos falsas alertas?

Mantén los perfiles de solicitud consistentes, almacena evidencia de respuesta, muestrea páginas representativas, usa reintentos limitados para fallos temporales y separa la captura de la interpretación de stock.


































