






ScraperFlyAPI de datos web lista para IA

rendering

API de Página Web a PDF para capturas de páginas renderizadas

ScraperFly convierte páginas públicas en artefactos PDF cuando un flujo de trabajo necesita un registro visual duradero: paquetes de aprobación, archivos, evidencia de soporte, revisión de cumplimiento, entrega al cliente o QA estilo documento. Renderiza páginas JavaScript cuando es necesario y mantiene formatos de respuesta más ligeros disponibles cuando un archivo no es necesario.

ARTIFACTOS PDF

Captura la página como un PDF cuando el resultado necesita ser revisado, compartido o archivado

ScraperFly ofrece a los equipos una forma centrada en la API para convertir una URL pública en un artefacto PDF. Esto es útil cuando la salida no es solo datos para un analizador, sino un registro duradero para aprobaciones, verificaciones de cumplimiento, entrega al cliente, evidencia de soporte, control de calidad interno o archivos de páginas.

La solicitud puede mantenerse práctica. Prueba el objetivo, renderiza JavaScript solo cuando la página lo necesite, espera contenido tardío solo cuando las muestras demuestren que el tiempo importa, y mantén HTML, texto, Markdown, metadatos JSON o capturas de pantalla disponibles cuando PDF no sea la salida correcta.
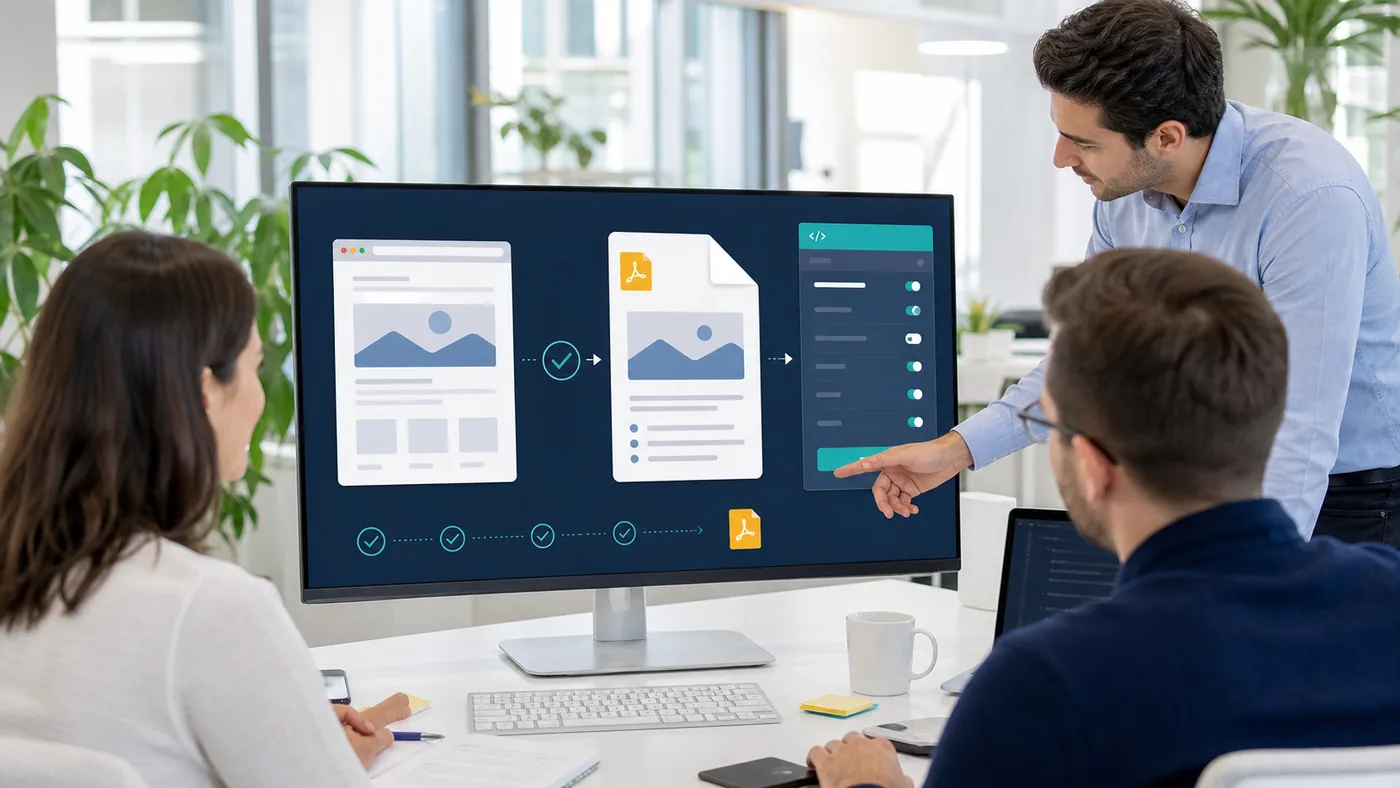
URL a PDFpágina renderizadaartefacto descargable
Equipo revisando un flujo de trabajo de API que convierte una página web pública en un artefacto PDF

¿Qué es una API de página web a PDF?

Una API de página web a PDF acepta una URL pública y devuelve una representación PDF de la página capturada. En lugar de ejecutar una granja de navegadores, construir un renderizador de PDF, gestionar la entrega de proxies y coser el manejo de archivos en el backend, la aplicación puede solicitar un artefacto de estilo documento de un flujo de trabajo de API alojado.

La captura de PDF es diferente de la salida normal de scraping. HTML, texto, Markdown y JSON son formatos amigables para máquinas. PDF es un formato amigable para revisiones. Es valioso cuando un humano, cliente, auditor, equipo de soporte o proceso posterior necesita un registro portátil de cómo se veía la página pública después de que se completó la solicitud.

Esta distinción mantiene la página honesta. Un PDF no debe reemplazar el análisis estructurado cuando el producto necesita campos, enlaces, precios, encabezados o metadatos. Debe usarse cuando un artefacto de archivo facilita la aprobación, archivo, compartición o inspección del flujo de trabajo.

Conclusión práctica: usa la salida PDF cuando el siguiente paso necesite un registro documental, no solo datos extraídos de la página.

¿Cuándo es mejor PDF que una captura de pantalla?

Las capturas de pantalla son una prueba visual rápida de un estado del navegador. Los PDFs son mejores cuando la página capturada necesita comportarse como un documento. Un PDF puede adjuntarse a un ticket, almacenarse en un archivo, revisarse por un equipo no técnico, pasarse a un cliente o usarse como un registro duradero para flujos de trabajo de aprobación y cumplimiento.

Para control de calidad de diseño, una captura de pantalla puede ser suficiente. Para un informe dirigido al cliente, una página tipo factura, página de políticas, prueba de resultados de búsqueda, evidencia de listado o paquete de auditoría, PDF a menudo se adapta mejor al flujo de trabajo humano. Le da al equipo un archivo que viaja bien a través de sistemas que ya entienden documentos.

NecesidadUsa PDF cuandoUsa captura de pantalla cuando
RevisiónLa página debe compartirse como un documento o adjuntarse a un flujo de trabajo.El equipo solo necesita un estado visual rápido.
ArchivoLa salida debe convertirse en un registro portátil que pueda almacenarse y recuperarse más tarde.Una miniatura o un instantáneo de diseño es suficiente.
CumplimientoLa captura necesita un artefacto de estilo documento para auditoría o aprobación.La prueba es principalmente control de calidad visual.
Entrega al clienteUn destinatario no técnico espera un archivo tipo PDF.El archivo solo se usa internamente para depuración.
AutomatizaciónLa aplicación enruta documentos entre sistemas.La aplicación compara píxeles o estados visuales.

Para flujos de trabajo que necesitan ambos formatos visuales, la página más amplia API de captura de pantalla de página web y PDF explica cómo elegir entre ellos. Esta página se centra en PDF como el entregable principal.

¿Cómo afecta el renderizado a la captura de PDF?

Un PDF generado a partir del estado incorrecto de la página sigue siendo un mal artefacto. Muchas páginas públicas envían contenido útil completo en la primera respuesta HTML. Otras construyen el contenido importante después de que se ejecuta JavaScript, cambian el contenido por región, muestran superposiciones, cargan secciones de forma diferida o redirigen según el contexto de la solicitud.

ScraperFly puede usar el renderizado del navegador antes de la salida PDF cuando el estado útil de la página pública depende de JavaScript. El tiempo de espera puede ayudar cuando las secciones diferidas necesitan un momento para asentarse. Encabezados, cookies, sesiones, segmentación por país y enrutamiento más fuerte pueden ayudar cuando el objetivo devuelve contenido diferente para diferentes visitantes.

El objetivo no es hacer que cada solicitud PDF sea pesada. El objetivo es demostrar qué perfil de captura crea el artefacto correcto para un patrón objetivo. Compara la respuesta de origen, la respuesta renderizada, el estado de la captura de pantalla, la URL final, el estado y la salida del archivo antes de aplicar la misma configuración a un lote.

Conclusión práctica: renderiza las capturas de PDF cuando JavaScript cambie el documento que necesitas preservar.

¿Qué deben validar los equipos antes de confiar en la salida PDF?

La salida PDF es útil porque es fácil de compartir, pero eso también hace que los errores sean más visibles. Un redireccionamiento incorrecto, pantalla de consentimiento, página en blanco, muro de inicio de sesión, estado de CAPTCHA o sección de carga lenta pueden crear un archivo que parece válido mientras preserva el contenido incorrecto.

  • URL final y estado. Confirma que el PDF provino de la página pública esperada, no de un redireccionamiento, marcador de posición o error suave.
  • Estado renderizado. Verifica si la ejecución de JavaScript cambia la página antes de la captura.
  • Tiempo de espera. Da tiempo suficiente a contenido diferido y transiciones de ruta solo cuando muestras reales demuestren la necesidad.
  • Viewport y forma de la página. Asegúrate de que el diseño capturado se ajuste al registro de estilo documento que tu flujo de trabajo espera.
  • Superposiciones y banners. Los mensajes de consentimiento, modales e intersticiales pueden dominar un PDF si el contexto de la solicitud está incompleto.
  • Contenido versus prueba. Mantén formatos legibles por máquina disponibles cuando la aplicación necesite datos, no un artefacto de documento.

Estas verificaciones ayudan a separar un problema de PDF de un problema de entrega. Si el objetivo devuelve el estado incorrecto de la página, la solución puede ser el renderizado, encabezados, sesiones, segmentación por país, tiempo de espera o enrutamiento. Si el producto necesita campos estructurados, la solución puede ser un formato de respuesta diferente.

¿Cómo es diferente la página web a PDF de HTML scraping o salida Markdown?

HTML scraping es generalmente el punto de partida cuando el producto necesita marcado parseable, selectores, atributos, enlaces, tablas o relaciones DOM exactas. Página web a Markdown es útil cuando el contenido debe trasladarse a AI, RAG, documentación, búsqueda o flujos de trabajo de revisión en una forma legible. PDF es útil cuando la salida debe ser un archivo.

Eso hace que PDF sea un formato de entrega, no el mejor formato universal de scraping. Si tu aplicación quiere calcular precios, extraer campos de productos, comparar encabezados, indexar texto o construir un conjunto de datos, PDF suele ser menos conveniente que HTML, texto, Markdown o metadatos JSON. Si tu aplicación quiere adjuntar una captura de página pública a un flujo de aprobación, archivar un registro o dar a un humano una vista portátil, PDF tiene sentido.

SalidaMejor ajusteCompensación
PDFRevisión, archivo, aprobaciones, paquetes de cumplimiento, entrega al cliente.Menos conveniente para el análisis y generalmente más pesado que la salida de texto.
Captura de pantallaControl de calidad visual, prueba de estado del navegador, verificaciones de diseño, muestras de monitoreo seleccionadas.Gran evidencia visual, pero difícil de consultar como datos.
HTMLAnálisis DOM, selectores, enlaces, atributos, tablas, evidencia exacta de origen.Requiere limpieza y lógica de analizador.
MarkdownAI, RAG, docs, revisión y flujos de trabajo de contenido legible.Puede simplificar estructuras DOM complejas.
Metadatos JSONDiagnósticos de solicitud, URL final, estado, tipo de contenido, registro.No reemplaza la extracción específica del objetivo.

Usa el API Builder para comparar esas salidas en la misma URL objetivo antes de comprometer un flujo de trabajo de producción. Una pequeña cantidad de pruebas evita que un equipo construya flujos de trabajo de documentos alrededor de páginas que solo necesitaban formatos de respuesta más ligeros.

Conclusión práctica: elige PDF cuando el artefacto en sí sea valioso; elige formatos más ligeros cuando el consumidor necesite datos.

¿Cómo puede ScraperFly mantener la captura de PDF práctica?

ScraperFly es útil porque la captura de PDF se mantiene dentro del mismo modelo de solicitud que el resto del flujo de trabajo de scraping web. El equipo puede probar la URL objetivo, inspeccionar la evidencia de respuesta, comparar formatos, habilitar el renderizado cuando JavaScript importa, agregar tiempo de espera cuando el estado de la página es tardío y usar controles de enrutamiento cuando la entrega cambia el resultado.

Eso también mantiene la decisión de compra más clara. Un trabajo de revisión único puede usar créditos de pago por uso. Un proceso de archivo o control de calidad recurrente puede avanzar hacia créditos mensuales una vez que se haya demostrado el comportamiento del objetivo y el peso de la solicitud. Revisa los precios después de que el perfil de captura esté claro, no antes de que el equipo sepa si realmente se necesita la salida PDF.

Si el flujo de trabajo necesita un archivo devuelto de la API, conecta esta página con artefactos descargables. Si el flujo de trabajo necesita prueba visual pero no un documento, compara con la API de captura de pantalla de sitio web. El mejor flujo de trabajo PDF es lo suficientemente específico como para preservar la página correcta y lo suficientemente disciplinado como para no convertir cada scraping en un trabajo de documento.


Página web a PDF

Construye una solicitud de captura de PDF antes de conectar la infraestructura del navegador

Usa ScraperFly para probar la URL pública, compara formatos de respuesta más ligeros, habilita el renderizado solo cuando la página lo necesite y devuelve la salida PDF cuando el flujo de trabajo se beneficie de un artefacto de estilo documento.

PDF
Artefacto PDF

Preserva una página pública renderizada como un archivo portátil

Usa la salida PDF para aprobaciones, archivos, revisión de cumplimiento, evidencia de soporte, entrega al cliente y control de calidad de estilo documento.

format=pdfdescargararchivo
JS
Página renderizada

Captura contenido construido por JavaScript antes de que se cree el PDF

Usa la ejecución del navegador y esperas para páginas donde el HTML de origen está incompleto o el contenido tardío cambia el artefacto final.

render=trueesperarestado de la página
API
Misma ruta de API

Compara PDF con formatos de respuesta más ligeros primero

Mantén HTML, texto, Markdown, metadatos JSON y capturas de pantalla disponibles para que se elija PDF para los trabajos correctos.

htmlmarkdowncaptura de pantalla

Controles que dan forma a la captura de página web a PDF

url

La página pública que ScraperFly debería capturar como un PDF.

format=pdf

Devuelve un artefacto estilo documento en lugar de salida HTML, texto, Markdown, JSON o captura de pantalla.

render

Ejecuta JavaScript del lado del navegador antes de la captura de PDF cuando el HTML fuente está incompleto.

render_wait

Deja que las secciones perezosas, los cambios de ruta o las superposiciones se estabilicen cuando la evidencia de muestra muestra que el tiempo importa.

country

Captura el estado de la página regional cuando la ubicación cambia el contenido, redirige o afecta la disponibilidad.

download

Devuelve el PDF como un artefacto descargable para entrega o almacenamiento.

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Ajuste de PDF

Confirma cuándo un artefacto PDF es más útil que contenido parseado

La captura de PDF es más efectiva cuando el flujo de trabajo necesita un registro estilo documento: aprobación, archivo, cumplimiento, entrega al cliente, revisión visual o prueba de soporte. Cuando la aplicación solo necesita campos, texto, enlaces o metadatos, los formatos de respuesta más ligeros suelen ser mejores.

01

Define por qué existe el archivo

Nombra el flujo de trabajo de revisión, aprobación, archivo, soporte, cumplimiento o entrega que consumirá el PDF.

Útil cuando un humano u otro sistema espera un documento portátil.

02

Prueba el estado de la página antes de la captura

Verifica la URL final, estado, contenido renderizado, tiempo de espera, superposiciones, región y si el objetivo devolvió la página pública esperada.

Útil cuando archivos en blanco, redirecciones o pantallas de consentimiento pueden crear registros falsos.

03

Mantén los formatos de datos disponibles

PDF no es una fuente amigable para parsers. Mantén HTML, texto, Markdown o metadatos JSON cuando el flujo de trabajo necesita contenido legible por máquina.

Útil para productos que necesitan extracción, búsqueda, monitoreo o ingestión de IA.

Verificaciones antes de elegir la salida PDF.

¿Necesita una persona revisar la página como un documento?

Si es así, el PDF puede ajustarse mejor que HTML o JSON en bruto.

¿Necesita la página JavaScript antes de la captura?

Compara los estados de origen y renderizado antes de agregar la ejecución del navegador.

¿Se almacenará o compartirá el archivo?

PDF es útil para archivos, boletos, flujos de aprobación y entrega al cliente.

¿Necesita el producto datos estructurados?

Usa HTML, texto, Markdown o metadatos cuando el parsing sea el trabajo real.

¿Qué cambios en la configuración de la solicitud?

Los flujos de trabajo de documentos necesitan salida de archivo.

Utiliza PDF cuando el resultado debe viajar como un artefacto.

Las páginas dinámicas necesitan evidencia de renderizado.

Renderiza solo cuando JavaScript cambia el contenido del PDF.

Las páginas lentas necesitan esperas medidas.

Agrega tiempo cuando el contenido perezoso o el estado de la ruta afectan el archivo.

Las páginas regionales necesitan contexto de solicitud.

Utiliza país, encabezados o sesiones cuando el estado de la página cambia por el visitante.

Manejo de errores

Convierte los fallos de scraping en soluciones

Cada flujo de trabajo de datos web eventualmente se encuentra con una respuesta mala: una URL faltante, una clave inválida, una estructura HTML vacía, un objetivo 403, un límite de tasa, un tiempo de espera de renderizado, una captura de PDF rota o una carga útil JSON que no contiene los campos que tu producto esperaba. ScraperFly está diseñado para hacer que esos momentos sean diagnosticables. Inspeccionas el estado HTTP, el código de error estable, el perfil de solicitud y el artefacto devuelto, luego eliges el siguiente movimiento útil más económico: corregir la solicitud, agregar créditos, desacelerar, reintentar con retroceso, habilitar el renderizado, cambiar de país, usar enrutamiento premium, preservar encabezados o validar la salida antes de escalar.

Forma de error estableDecisiones de reintentoEscalación consciente de costosValidación de salida
Desarrollador revisando código y parámetros de solicitud de API en una laptop

01 / Configuración de solicitud y acceso

Corrige primero los errores de solicitud

Algunas fallas no son problemas del objetivo en absoluto. Ocurren antes de que ScraperFly pueda hacer un intento de entrega significativo: una URL faltante o mal formada, un formato de salida no soportado, un tipo de archivo visual incompatible, una clave de API faltante, una clave inválida, o una clave que ha sido pausada o deshabilitada. Estos errores son señales de configuración, no señales de reintento: detén el flujo de trabajo, señala al desarrollador el campo exacto que necesita corrección, y mantén los créditos enfocados en pruebas reales del objetivo en lugar de entradas incorrectas repetidas.

missing_urlinvalid_urlunsupported_formatinvalid_api_key
  • Valida la URL y la codificación antes de enviar un lote.
  • Usa salidas soportadas: HTML, texto, Markdown, JSON, captura de pantalla o PDF.
  • Ajusta los tipos de archivo de captura de pantalla al tipo de salida de imagen y el tipo de archivo PDF a la salida PDF.
  • Trata las claves de API faltantes o inválidas como trabajo de configuración, no como trabajo de reintento.
Tablero de negocios con gráficos, documentos y planificación de uso en un escritorio

02 / Créditos, límites y concurrencia

Separar límites de fallos

Una carga de trabajo puede fallar porque la cuenta no tiene créditos utilizables, se ha alcanzado el límite del plan mensual, o la concurrencia es demasiado agresiva para el plan actual y la mezcla de objetivos. ScraperFly hace visibles esos límites como señales operativas, no como fallas misteriosas de raspado. Eso mantiene la decisión de compra práctica: comienza gratis, prueba el objetivo, compra créditos de pago por uso para trabajos irregulares, pasa a créditos mensuales cuando el volumen se vuelve predecible, y usa retroceso cuando la presión de solicitud es el verdadero problema.

usage_limit_reachedrate_limitedcreditsretroceso
  • Usar el estado de la cuenta para verificar créditos restantes antes de ejecuciones grandes.
  • Reintentar límites de tasa con retroceso en lugar de aumentar la presión de inmediato.
  • Mantener proyectos únicos en pago por uso cuando el volumen es desigual.
  • Mover trabajos recurrentes predecibles a créditos mensuales cuando el patrón esté comprobado.
Sala de servidores que representa rutas de entrega, enrutamiento e infraestructura de red

03 / Entrega objetivo y red

Encontrar fallos de entrega primero

Muchas plataformas de scraping colapsan los problemas de entrega en un fallo de solicitud vago. En producción, eso no es suficiente. El equipo necesita saber si la solicitud se agotó, si el objetivo ascendente devolvió un error temporal del servidor, si la conexión falló, si la respuesta fue demasiado grande, si las redirecciones fueron a algún lugar inesperado, o si la página regresó como un HTML pequeño sin contenido útil. ScraperFly convierte esos fallos en evidencia de entrega: prueba primero el perfil ligero, compara el estado y el tamaño de la respuesta, luego decide si la siguiente solicitud necesita retroceso, otra ruta, proxy premium, segmentación por país, o una captura más estrecha.

tiempo de espera5xxredireccionesrespuesta_demasiado_grande
  • Reintentar fallos temporales de red y ascendentes con una política de retroceso controlada.
  • Comparar URL final, estado, tipo de contenido y tamaño de respuesta entre muestras.
  • Escalar el enrutamiento solo cuando la respuesta demuestre que el camino simple es inestable.
  • Tratar respuestas sobredimensionadas como un problema de alcance antes de escalar el mismo perfil.
Pantalla de seguridad digital que representa señales de anti-bot y acceso protegido

04 / Bloques de anti-bot, geográficos y de acceso

Leer bloques antes de la escalación

Una pantalla de error 403, 401, 429, CAPTCHA, desafío WAF, muro de inicio de sesión, bucle de consentimiento o desajuste específico de región no es solo un error; es una pista sobre lo que el sitio espera del visitante. Los competidores a menudo empujan a los equipos hacia un perfil predeterminado más pesado, pero eso puede agotar el presupuesto sin demostrar la solución. El mejor camino de ScraperFly es la escalación basada en evidencia: preservar encabezados realistas cuando el contexto importa, usar sesiones cuando la continuidad cambia la respuesta, habilitar renderizado cuando el contenido útil es generado por el navegador, y elegir enrutamiento premium o por país cuando la reputación o la geografía cambian el resultado.

403429CAPTCHAdesajuste de país
  • Usar enrutamiento premium cuando la reputación de IP es el cuello de botella comprobado.
  • Usar segmentación por país cuando el idioma, la moneda, el inventario o los resultados de búsqueda cambian según el mercado.
  • Usar encabezados, cookies y sesiones cuando el estado del visitante cambia la respuesta.
  • Reducir la concurrencia y agregar retroceso cuando las solicitudes repetidas activan la limitación del objetivo.
Desarrollador preparando código y artefactos de salida en una laptop

05 / Calidad de renderizado y salida

Enviar artefactos utilizables

Un estado 200 no es lo mismo que un raspado utilizable. El HTML crudo puede ser un shell de aplicación vacío, Markdown puede omitir el artículo principal, JSON puede carecer de metadatos esperados, el texto puede incluir ruido, las capturas de pantalla pueden estar en blanco, y la salida en PDF o imagen puede fallar si el paso del navegador se agota. ScraperFly es valioso porque la misma solicitud de API puede pasar de HTML crudo a DOM renderizado, texto limpio, Markdown, JSON, captura de pantalla o PDF, y luego ser verificada contra el artefacto que tu producto realmente necesita. Eso reduce el código de pegamento, las importaciones fallidas y las ejecuciones por lotes costosas que solo descubren una mala salida después del hecho.

render_timeoutbrowser_render_failedcampos JSONsalida PDF/imágenes
  • Habilitar renderizado cuando el HTML crudo es solo un shell y el contenido útil aparece después de JavaScript.
  • Valida texto, Markdown y JSON contra los campos esperados antes de agrupar.
  • Utiliza captura de pantalla o salida en PDF cuando la prueba visual o la evidencia de auditoría son importantes.
  • Considera los artefactos en blanco o parciales como fallos de calidad incluso cuando el estado HTTP es exitoso.
Ajuste de ScraperFly

Recuperación de errores más limpia

ScraperFly ayuda a los equipos a decidir qué corregir, qué reintentar y qué escalar sin convertir cada raspado en el perfil de solicitud más costoso.

Forma de error estable

Utiliza el estado HTTP y el código de error juntos para que la lógica de la aplicación pueda elegir entre corregir la entrada, actualizar credenciales, desacelerar, reintentar o escalar la entrega.

Reintentar solo cuando ayuda

Las fallas de red, los límites de tasa y los errores temporales del servidor pueden usar retroceso. Las URL inválidas, los formatos no soportados y las claves incorrectas deben corregirse una vez.

Escalación consciente de costos

Comienza con el perfil de solicitud ligero, luego agrega renderizado, enrutamiento premium, país, sesiones, encabezados, esperas o captura visual solo cuando la falla lo demuestre.

Valida la salida antes de escalar

Confirma el artefacto real que tu producto necesita: HTML, texto, Markdown, JSON, captura de pantalla o PDF, antes de copiar el mismo perfil en un gran conjunto de URL.

Por qué ScraperFly

Crea artefactos PDF sin mantener una pila separada de navegador y PDF

Los equipos pueden construir sus propios trabajadores de navegador, manejo de proxies, lógica de espera, generación de PDF, reintentos y entrega de archivos. ScraperFly mantiene esas decisiones en un solo flujo de trabajo de API para que el equipo pueda probar el objetivo, elegir PDF solo cuando ayuda, y mantener formatos más ligeros disponibles para trabajos de contenido.

Menos infraestructura

Sin servicio de captura de PDF separado que mantener

Utiliza el mismo modelo de solicitud para HTML, Markdown, capturas de pantalla y PDFs en lugar de unir la automatización del navegador y la generación de archivos.

una APIPDFrenderizado
Mejores decisiones

Prueba la captura de documentos antes de escalarla

Compara PDF con captura de pantalla, HTML, texto, Markdown y metadatos en objetivos reales antes de convertir una clase de página en un flujo de trabajo de archivos.

Constructor de APImuestra primeroelección de formato
Control de costos

Reserva la captura más pesada para páginas que necesitan prueba

Mantén las solicitudes solo de contenido ligeras, luego agrega renderizado, esperas, enrutamiento y salida PDF donde el artefacto ahorra trabajo de revisión o entrega.

paga a medida que avanzasrepresentar cuando sea necesariodescargar

Dónde ScraperFly se adapta mejor a los flujos de trabajo de página web a PDF

La ventaja práctica no es solo crear un PDF. Es crear el artefacto correcto desde el estado de página correcto sin perder evidencia de solicitud o flexibilidad de formato.

Punto de decisiónVentaja de ScraperFlyAlternativa típica
Prueba inicial.Prueba la URL, compara formatos y valida el estado renderizado antes de que el código de producción dependa de un PDF.Los equipos a menudo configuran la automatización del navegador primero y descubren problemas de estado de página después de que la canalización existe.
Elección de salidaUtiliza PDF para flujos de trabajo de documentos, captura de pantalla para prueba visual, y HTML, texto, Markdown o JSON para contenido legible por máquina.Las herramientas PDF a menudo están separadas de la salida de scraping, lo que dificulta las comparaciones de formato.
Páginas dinámicasAgrega renderizado, esperas, encabezados, sesiones, segmentación por país o enrutamiento cuando la evidencia muestra que mejoran el artefacto.La ejecución en el navegador puede convertirse en el predeterminado incluso para páginas simples que no lo necesitan.
Ruta de compraComienza gratis, utiliza créditos de pago por uso para capturas únicas, y mueve trabajos recurrentes de PDF a créditos mensuales cuando se demuestra el volumen.La captura de PDF y la automatización del navegador a menudo empujan a los equipos hacia una infraestructura fija antes de que la carga de trabajo esté clara.

Control de costos de PDF

Utiliza la captura de PDF donde la prueba de archivo ahorra más trabajo del que añade

Las solicitudes PDF pueden ser más pesadas que las simples respuestas HTML, texto, Markdown o JSON porque el flujo de trabajo puede involucrar ejecución de navegador, esperas, renderizado de página, generación de archivos y artefactos descargables. ScraperFly hace visible ese intercambio antes de que el equipo lo escale.

Una solicitud HTML ligera que devuelve una respuesta simple
01

Obtención básica

Utiliza una obtención básica cuando el HTML público ya contiene los campos que necesitas.

Perfil de solicitud más ligero; mantenlo cuando la respuesta esté completa.

Renderizado de JavaScript produciendo un DOM completo
02

Renderización

Utiliza el renderizado cuando el HTML en bruto es una estructura y JavaScript completa la página.

Perfil más pesado; úsalo solo cuando la salida del navegador cambie el resultado.

Varios requests preservando cookies y estado del visitante
03

Sesión con estado

Usa sesiones cuando las cookies, el consentimiento, la localidad o la paginación cambien la respuesta.

Perfil de estado más pesado; conservalo solo cuando la continuidad sea importante.

Enrutamiento de requests a través de rutas geo y de mayor calidad
04

Enrutamiento y geo premium

Usa enrutamiento premium o geo solo cuando el origen, país, reputación o contenido regional cambien el resultado.

Perfil de enrutamiento más pesado; aplícalo solo a objetivos que demuestren que lo necesitan.

¿Qué puede hacer que la captura de PDF sea más pesada?

renderizado del navegador

Necesario cuando JavaScript crea el contenido que pertenece al PDF.

Tiempo de espera

Necesario cuando el contenido perezoso, el estado de la ruta o las superposiciones afectan el artefacto final.

Contexto regional o de sesión

Necesario cuando el contenido de la página cambia por país, idioma, cookies o continuidad.

Salida de archivo

Útil para revisión y archivo, pero más pesado que devolver contenido legible por máquina.

¿Cómo mantener la captura de PDF predecible?

Comienza con la respuesta válida más ligera

Utiliza HTML, texto, Markdown o JSON cuando el flujo de trabajo no necesita un archivo.

Captura PDFs solo para clases de página comprobadas

Aplica la salida de PDF a páginas donde la revisión, prueba, archivo o entrega son importantes.

Renderiza por evidencia

Habilita la ejecución del navegador solo cuando cambie el estado de la página capturado en el PDF.

Utiliza créditos flexibles mientras pruebas

Mantén el trabajo de PDF único en pago por uso y mueve la captura recurrente a créditos mensuales cuando el patrón esté comprobado.

Preguntas frecuentes sobre PDF

Preguntas comunes sobre la conversión de páginas web a PDF

Respuestas prácticas para equipos que deciden cuándo vale la pena usar la salida en PDF, cómo el renderizado afecta la calidad de captura y cómo mantener útiles los artefactos de estilo documental sin hacer que cada raspado sea más pesado.

Preguntas frecuentes sobre PDF
OUTPUT

Elegir PDF

Usa PDF cuando la salida necesita comportarse como un documento.

¿Cuándo es mejor el PDF que una captura de pantalla?

PDF es mejor para archivos, aprobaciones, entrega al cliente, revisión de cumplimiento y registros de estilo documental. Las capturas de pantalla son mejores para verificaciones rápidas del estado visual.

¿Debería cada raspado crear un PDF?

No. Usa PDF cuando el archivo cambia el flujo de trabajo. Usa formatos de respuesta más ligeros para contenido legible por máquina.

RENDERING

Capturando páginas dinámicas

El PDF debería preservar el estado de página correcto.

¿Puede ScraperFly capturar páginas de JavaScript como PDFs?

Sí. Habilita el renderizado cuando contenido público útil aparece solo después de que se ejecute JavaScript del lado del navegador.

¿Puede el tiempo de espera cambiar el PDF?

Sí. Los tiempos de espera pueden ayudar cuando secciones perezosas, superposiciones o transiciones de ruta necesitan tiempo antes de la captura.

WORKFLOW

Archivos versus datos

La salida en PDF complementa la extracción de datos en lugar de reemplazarla.

¿Es un PDF una buena entrada para el parser?

Normalmente no. Utiliza HTML, texto, Markdown o metadatos JSON cuando la aplicación necesita campos, enlaces o contenido legible por máquina.

¿Es esta una plataforma completa de generación de documentos?

No. ScraperFly captura páginas públicas como artefactos. Tu aplicación es responsable del almacenamiento, retención, anotación y ensamblaje de documentos personalizados.

RELIABILITY

Calidad y costo

Valida el perfil de captura antes de que la salida en PDF escale.

¿Qué debo inspeccionar si un PDF está en blanco?

Verifica la URL final, el estado, el estado renderizado, el tamaño de la respuesta, superposiciones, redirecciones, tiempos de espera y si el enrutamiento o los encabezados cambiaron la página.

¿Cómo controlan los equipos el costo de captura de PDF?

Mantén los trabajos de contenido en formatos más ligeros y añade renderizado, esperas, enrutamiento y salida en PDF solo donde el artefacto valga el trabajo adicional de solicitud.






