






ScraperFlyAPI de datos web lista para IA

developer api

API de Página Web a Markdown para contenido listo para IA

ScraperFly convierte páginas públicas en Markdown limpio que mantiene una estructura legible para IA, RAG, documentación, revisión y flujos de trabajo de contenido. Obtén la URL, renderiza solo cuando la página lo necesita y devuelve una salida que tu pipeline puede usar sin construir primero una capa de limpieza personalizada.

SALIDA MARKDOWN

Convierte páginas públicas en Markdown que tu pipeline pueda leer

ScraperFly ofrece a los equipos un camino práctico desde una URL pública hasta un Markdown limpio. En lugar de enviar el marcado de la página en bruto a un aviso de IA, herramienta de documentación, cola de revisión de contenido o índice de búsqueda, tu aplicación puede solicitar una respuesta que mantenga encabezados, párrafos, listas y enlaces útiles en una forma legible.

La parte importante es el control. Comienza con una solicitud ligera, inspecciona lo que devuelve el objetivo, luego habilita la representación del navegador, esperas, sesiones, encabezados, segmentación por país o enrutamiento más fuerte solo cuando esos controles mejoren el Markdown que tu flujo de trabajo recibe.
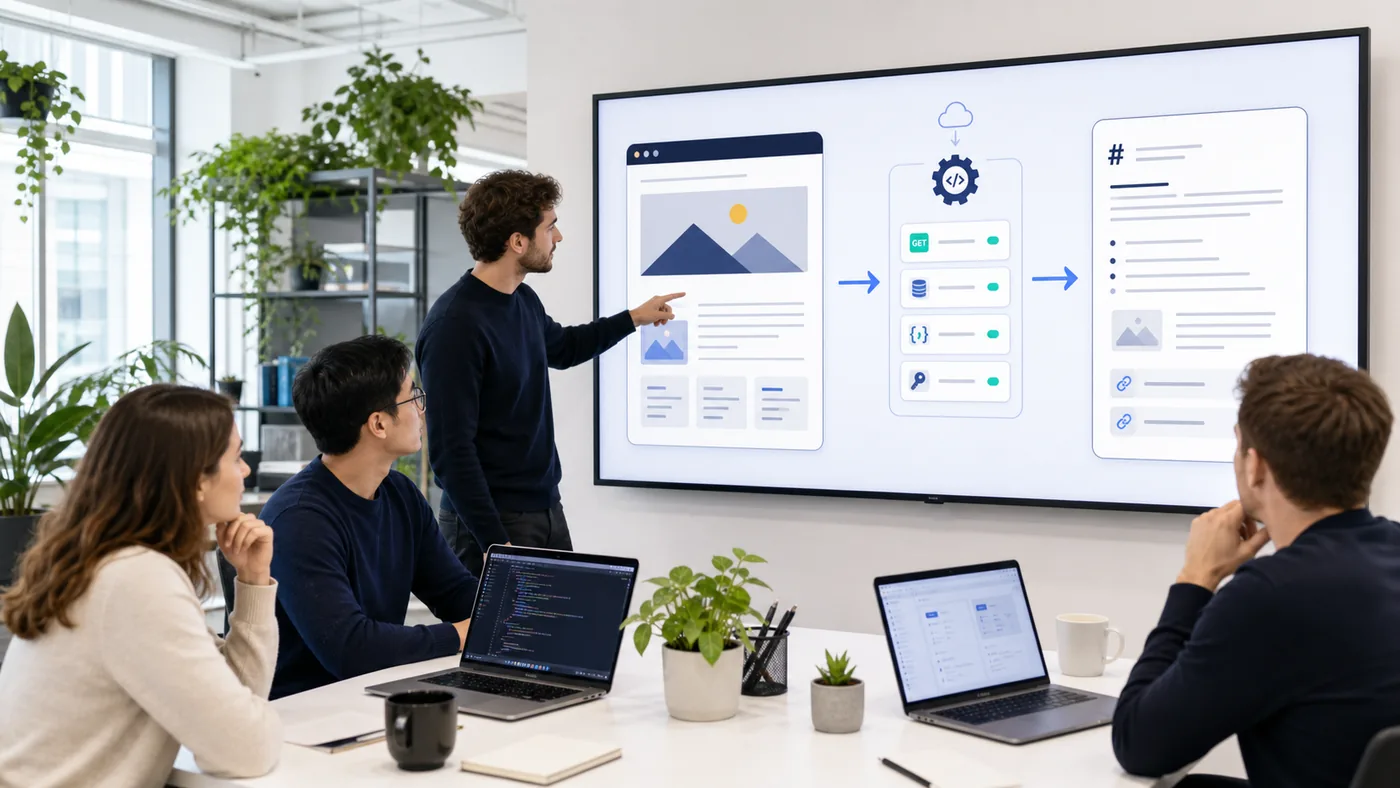
URL a Markdownencabezados y enlacescontenido listo para IA
Equipo revisando un flujo de trabajo que convierte una página web pública en una salida Markdown limpia

¿Qué es una API de página web a Markdown?

Una API de página web a Markdown obtiene una URL pública y devuelve el contenido de la página capturada como Markdown. La respuesta está destinada a sistemas que necesitan contenido legible en lugar de infraestructura de navegador: ingestión de RAG, agentes de IA, búsqueda interna, revisión editorial, importaciones de documentación, notas de monitoreo y análisis de contenido ligero.

Markdown es útil porque se sitúa entre HTML en bruto y texto plano. Puede preservar encabezados, flujo de párrafos, listas y enlaces sin obligar a cada consumidor posterior a entender la anidación del DOM, navegación repetida, atributos, scripts, estilos o ruido de plantilla.

Esto no es lo mismo que prometer una extracción perfecta de artículos o extracción de esquemas personalizados. Una respuesta en Markdown debe ser tratada como un formato de contenido limpio. Si tu producto necesita campos de producto exactos, líneas de autor, fechas, precios, calificaciones o estructura a nivel de selector, valida esos campos por separado o mantén HTML y metadatos disponibles para el analizador.

Conclusión práctica: usa página a Markdown cuando el consumidor necesite contenido de página legible, no evidencia exacta del DOM.

¿Cuándo deberían los equipos usar Markdown en lugar de HTML o texto?

Markdown es más fuerte cuando el contenido de la página será leído, dividido, resumido, revisado, indexado o pasado a un flujo de trabajo de modelo de lenguaje. Le da al sistema receptor más estructura que el texto plano, pero menos ruido que el HTML en bruto.

HTML sigue siendo la mejor opción cuando los selectores, atributos, tablas anidadas, enlaces exactos o relaciones del DOM importan. El texto plano es mejor cuando el flujo de trabajo solo necesita una copia legible compacta. Los metadatos JSON ayudan con el diagnóstico de solicitudes. Las capturas de pantalla y los PDFs ayudan cuando el estado visual es la prueba.

Flujo de trabajoPor qué Markdown ayudaCuándo otro formato es mejor
Ingesta de RAG y IAMantiene encabezados, listas, enlaces y secciones legibles para una división más limpia.Usa HTML cuando la extracción dependa de selectores o atributos ocultos.
Revisión editorialFacilita que los humanos escaneen y anoten el contenido de la página pública.Usa captura de pantalla o PDF cuando el diseño y la prueba visual importen.
Importación de documentaciónMueve secciones de la página a un formato que las herramientas de documentación pueden manejar de forma natural.Usa texto cuando solo se necesite copia plana.
Indexación de búsquedaPreserva una estructura útil sin agregar el código HTML al índice.Usa metadatos JSON para rastrear la URL final, estado, tipo de contenido y contexto de solicitud.
Notas de monitoreoCaptura cambios legibles en la página sin almacenar un artefacto renderizado completo cada vez.Usa capturas de pantalla para regresiones visuales, diseños rotos o evidencia de aprobación.

Conclusión práctica: elige Markdown cuando la estructura ayude al lector o modelo, y mantén HTML o formatos visuales cuando la prueba necesite ser exacta.

¿Cómo cambia la representación la salida de Markdown?

Un convertidor de Markdown solo puede trabajar con el contenido que la solicitud captura. Muchas páginas públicas envían contenido útil en la primera respuesta HTML. Esas páginas deben permanecer simples: obtener la URL, solicitar Markdown y evitar la ejecución del navegador a menos que la salida demuestre que falta algo.

Otras páginas envían una delgada estructura HTML y construyen el contenido útil después de que se ejecuta JavaScript. En ese caso, la representación de JavaScript puede capturar el estado de la página renderizada antes de que la respuesta se convierta en Markdown. Eso hace que el Markdown sea más completo, pero también hace que la solicitud sea más pesada, por lo que la representación debe ser una decisión basada en evidencia.

La evidencia útil incluye el HTML fuente, HTML renderizado, URL final, tamaño de respuesta, código de estado, estado de captura de pantalla y algunas muestras representativas del objetivo. Si el Markdown ya está completo desde la captura de origen, mantén el perfil ligero. Si las secciones importantes aparecen solo después de la ejecución del navegador, renderiza ese patrón de URL intencionalmente.

Conclusión práctica: renderiza para la completitud de Markdown, no porque la representación esté disponible.

¿Cómo es diferente la página a Markdown de un analizador de HTML a Markdown?

La frase API de analizador de HTML a Markdown generalmente comienza con HTML capturado y se centra en la conversión. Una API de página web a Markdown comienza antes en el flujo de trabajo: acepta una URL pública, obtiene la página, maneja controles de solicitud y luego devuelve Markdown como el formato de respuesta elegido.

Esa diferencia importa en producción. La captura de página puede involucrar redirecciones, encabezados, cookies, sesiones, segmentación por país, tiempos de espera, enrutamiento por proxy, representación de JavaScript, verificaciones de tipo de contenido y límites de tamaño de respuesta. Un convertidor por sí solo no resuelve esas preguntas de entrega. ScraperFly permite que el mismo modelo de solicitud pase de una captura de origen simple a un estado de página más completo cuando el objetivo demuestra que es necesario.

Si tu equipo ya tiene HTML confiable y solo necesita conversión, un flujo de trabajo centrado en el analizador puede ser suficiente. Si el problema comienza con la entrega de URL pública y continúa en contenido legible, la página a Markdown es el modelo mental más completo.

¿Qué deberían verificar los equipos antes de escalar la captura de Markdown?

Una buena salida de Markdown no es solo una cuestión de formato. Depende de la página objetivo, el estado de respuesta, el contenido que tu sistema posterior espera y la cantidad de ruido que la página agrega alrededor de las secciones útiles.

  • URL final y estado. Redirecciones, errores suaves, páginas de consentimiento o páginas de desafío pueden producir Markdown legible que aún es el contenido incorrecto.
  • Contenido fuente versus contenido renderizado. Compara la captura en bruto con la captura renderizada antes de hacer que la ejecución del navegador sea la predeterminada.
  • Estructura de encabezados. Verifica si los encabezados reflejan el contenido útil o principalmente repiten la navegación y secciones de plantilla.
  • Enlaces y listas. Asegúrate de que los enlaces importantes, elementos de lista y límites de sección sobrevivan a la conversión en una forma que tu aplicación pueda usar.
  • Boilerplate repetido. La navegación, pies de página, banners de cookies, recomendaciones y anuncios aún pueden aparecer en Markdown y deben ser manejados antes de la indexación.
  • Tablas y diseños complejos. Markdown puede simplificar estructuras complejas. Mantén HTML disponible cuando la forma de la tabla o las relaciones exactas del DOM importen.

Estas verificaciones mantienen la salida honesta. También evitan que un equipo trate Markdown como una capa mágica de limpieza cuando el verdadero problema es la entrega, representación, selección de objetivos o un requisito de extracción posterior.

¿Cómo deberían los equipos elegir entre Markdown y otros formatos de ScraperFly?

El enfoque más seguro es probar el mismo objetivo a través de varios formatos de respuesta en el API Builder. Usa Markdown para una estructura legible, texto para copia compacta, HTML para control del analizador, metadatos JSON para diagnósticos, capturas de pantalla para QA visual y PDFs para registros portátiles.

FormatoMejor ajusteRegla de decisión
MarkdownIA, RAG, docs, revisión y flujos de contenido legible.Úsalo cuando los encabezados, enlaces y flujo de secciones mejoren la experiencia del consumidor.
HTMLSelectores, análisis del DOM, atributos, tablas y relaciones exactas de origen.Úsalo cuando el analizador necesite precisión estructural.
TextoBúsqueda ligera, resúmenes y procesamiento de lenguaje simple.Úsalo cuando la estructura no sea necesaria.
Metadatos JSONRegistro, verificaciones de estado, URL final, tipo de contenido y diagnósticos de solicitud.Úsalo junto a formatos de contenido para facilitar el diagnóstico de la solicitud.
Captura de pantalla o PDFPrueba visual, QA, archivo, cumplimiento o revisión humana.Usa archivos visuales cuando la apariencia importe más que el texto legible por máquina.

Para una comparación más amplia de formatos, revisa la guía de formatos de respuesta de la API de web scraping. Para flujos de trabajo específicos de IA, conecta las decisiones de Markdown con la página de Scraping API para RAG y valida si tu pipeline de contenido necesita Markdown, texto, HTML, metadatos o una mezcla.

Conclusión práctica: no estandarices en un formato demasiado pronto; prueba el objetivo y elige la respuesta que tu producto pueda usar de inmediato.

¿Cómo puede ScraperFly mantener los flujos de trabajo de Markdown predecibles?

ScraperFly es útil cuando la conversión de Markdown es parte de un flujo de trabajo de datos web públicos más grande. La API puede mantener páginas simples ligeras, agregar representación cuando JavaScript crea contenido útil, preservar el contexto de la solicitud con encabezados y sesiones, enrutarse a través de entregas específicas de país o más fuertes cuando sea necesario, y devolver formatos alternativos cuando Markdown no es suficiente.

Esa flexibilidad importa tanto para el costo como para la calidad. Una página que se convierte limpiamente desde HTML fuente no debería llevar el mismo perfil de solicitud que una página renderizada que necesita esperas, continuidad de sesión o prueba visual. Conecta la decisión de salida al peso de la solicitud y usa precios solo después de que el comportamiento del objetivo esté claro.

Si el objetivo es la extracción de contenido en lugar de la formateación de Markdown, compara esta página con la API de analizador de contenido web. Si el objetivo es un artefacto portátil, usa las páginas PDF o de captura de pantalla en su lugar. El mejor flujo de trabajo de página a Markdown es lo suficientemente específico como para ser útil y lo suficientemente flexible como para evitar infraestructura innecesaria.


Flujo de trabajo de la API de Markdown

Construye la solicitud de URL a Markdown antes de escribir el código de limpieza

Usa el API Builder para probar una URL pública real, compara la captura fuente y renderizada, elige la salida de Markdown y mantén formatos alternativos disponibles cuando el consumidor posterior necesite más evidencia que contenido legible.

URL
Entrada de página

Comienza desde la URL pública, no de una suposición del convertidor

Envía la página objetivo a ScraperFly e inspecciona lo que la página realmente devuelve antes de construir suposiciones de Markdown en producción.

urlestadoURL final
MD
Salida legible

Devuelve Markdown para revisión, RAG, docs y flujos de trabajo de IA

Mantén encabezados, párrafos, listas y enlaces en una forma que sea más fácil de leer, dividir, resumir y pasar a sistemas de contenido.

formato=markdownencabezadosenlaces
API
Captura controlada

Agrega renderizado o enrutamiento solo cuando la página lo necesite

Usa representación, esperas, sesiones, encabezados, segmentación por país o enrutamiento más fuerte cuando mejoren el resultado de Markdown en muestras reales.

renderizaresperasenrutamiento

Controles que dan forma a la salida de Markdown

url

La página pública que ScraperFly debe obtener antes de la conversión.

format=markdown

Devuelve Markdown legible en lugar de HTML sin procesar o texto plano.

render

Ejecuta JavaScript del lado del navegador cuando la captura de origen no capta contenido útil.

render_wait

Espera contenido tardío cuando la evidencia de muestra muestra que el tiempo afecta la salida.

country

Solicita un estado de página regional cuando el contenido cambia según la ubicación.

download

Usa artefactos de archivo solo cuando el flujo de trabajo necesite una salida visual o documento guardado.

ejemplo de cURL

Genera Markdown con la misma forma de solicitud que puedes mover a producción

curl "https://scraperfly.com/api/v1?url=https%3A%2F%2Fexample.com&format=markdown" \
  -H "apikey: YOUR_API_KEY"

Preparación de Markdown

Valida el comportamiento de la página antes de escalar la captura de URL a Markdown

La calidad de Markdown depende del estado de la página que ScraperFly captura. Muestra URLs reales para contenido de origen, contenido renderizado, redirecciones, idioma, repetición de texto estándar, preservación de enlaces, tablas y las secciones exactas que tu sistema downstream necesita.

01

Confirma que el contenido existe en la página capturada

Compara HTML de origen y salida renderizada para que el equipo sepa si la captura en bruto es suficiente o si el renderizado de JavaScript está justificado.

Útil cuando las páginas envían estructuras HTML delgadas o secciones cargadas tarde.

02

Verifica encabezados, enlaces y ruido de plantilla repetido

Markdown legible aún necesita validación. La navegación, los pies de página, los banners de consentimiento, los anuncios y las recomendaciones pueden contaminar las tuberías de contenido.

Útil antes de indexar, dividir, resumir o enviar contenido a un agente.

03

Mantén salidas alternas disponibles como prueba

Markdown no es un registro visual y no es una fuente DOM exacta. Mantén HTML, metadatos JSON, capturas de pantalla o PDFs cuando el flujo de trabajo necesite más evidencia.

Útil para depuración, QA, cumplimiento y extracción específica de analizadores.

Preguntas antes de elegir Markdown

¿El HTML fuente ya contiene el contenido útil?

Si es así, mantén la solicitud ligera y evita la ejecución del navegador.

¿La salida renderizada cambia las secciones que importan?

Si es así, habilita la representación para ese patrón de URL en lugar de globalmente.

¿El consumidor usará encabezados y enlaces?

Markdown es más fuerte cuando una estructura legible mejora el trabajo posterior.

¿Los selectores o atributos aún importan?

Mantén HTML en el flujo de trabajo cuando se requiera evidencia exacta del DOM.

¿Qué cambios en la configuración de la solicitud?

Las páginas simples se mantienen ligeras

La captura de origen más la salida en Markdown es suficiente cuando la respuesta inicial contiene el contenido.

Las páginas de JavaScript obtienen renderizado basado en evidencia

Renderiza cuando el Markdown de muestra está incompleto sin la ejecución del navegador.

Las páginas regionales necesitan un contexto coincidente

Utiliza la segmentación por país, encabezados o sesiones cuando el contenido de la página cambia según el contexto del visitante.

La prueba visual se mantiene separada

Utiliza salida de captura de pantalla o PDF cuando los humanos necesitan revisar cómo se veía la página.

Por qué ScraperFly

Elige la captura de Markdown sin bloquear cada raspado en un flujo de trabajo de rastreo pesado

Muchas herramientas tratan Markdown como una característica de rastreo todo o nada o dejan a los equipos unir recolectores, navegadores, convertidores y scripts de limpieza. ScraperFly mantiene Markdown dentro del mismo modelo de solicitud que HTML, texto, metadatos JSON, capturas de pantalla, PDFs, representación y controles de enrutamiento.

Inicio fácil

Prueba Markdown en objetivos reales primero

Comienza con créditos gratuitos, compara formatos de respuesta y demuestra si Markdown realmente elimina trabajo antes de comprometer tiempo de ingeniería.

créditos gratuitosConstructor de APIURLs de muestra
Salida flexible

Mantén cada forma de respuesta cercana

Usa Markdown para contenido legible, HTML para analizadores, texto para copias ligeras, JSON para diagnósticos y archivos visuales como prueba.

MarkdownHTMLJSON
Costo inteligente

Agrega controles más estrictos solo con evidencia

La representación, esperas, sesiones, segmentación por país y enrutamiento premium están disponibles cuando mejoran el estado de la página, no forzadas como predeterminadas.

representar cuando sea necesarioenrutamientocontrol de costos

Dónde ScraperFly se adapta mejor a los flujos de trabajo de Markdown

El ajuste más fuerte es un equipo que quiere contenido de página legible sin perder control sobre la captura, elección de formato, peso de la solicitud y contexto de depuración.

Punto de decisiónVentaja de ScraperFlyAlternativa típica
Primera pruebaPrueba la URL, inspecciona la salida y compara Markdown con HTML, texto, JSON, captura de pantalla o PDF antes de escribir código.A menudo comienza con un rastreador fijo, una biblioteca de conversión o una decisión de plan antes de que se demuestre el comportamiento objetivo.
Páginas de JavaScriptHabilita el renderizado solo cuando la captura de origen no capte contenido útil y Markdown mejore después de la ejecución del navegador.El renderizado puede ser predeterminado, empaquetado o poco claro, lo que puede hacer que las páginas simples sean más pesadas de lo necesario.
Prueba de salidaMantén las opciones de Markdown, HTML, metadatos, captura de pantalla y PDF cerca del mismo flujo de trabajo de solicitud.Markdown legible puede estar separado de los metadatos de depuración o la evidencia visual.
Control de costosConecta el peso de la solicitud a los controles que realmente cambiaron el resultado capturado.Los precios pueden ser más difíciles de razonar cuando el rastreo, la representación, la conversión y el comportamiento del proxy están agrupados.

control de costos de Markdown

Mantén el costo de página a Markdown asequible al igualar el peso de la solicitud con el comportamiento real del objetivo

Markdown en sí no debería hacer que una página pública simple se sienta pesada. La parte costosa suele ser el perfil de captura circundante: renderizado del navegador, esperas, sesiones, contexto regional, enrutamiento premium, capturas de pantalla, PDFs y reintentos. Úsalos cuando mejoren el resultado de Markdown o proporcionen la prueba necesaria.

Una solicitud HTML ligera que devuelve una respuesta simple
01

Obtención básica

Utiliza una obtención básica cuando el HTML público ya contiene los campos que necesitas.

Perfil de solicitud más ligero; mantenlo cuando la respuesta esté completa.

Renderizado de JavaScript produciendo un DOM completo
02

Renderización

Utiliza el renderizado cuando el HTML en bruto es una estructura y JavaScript completa la página.

Perfil más pesado; úsalo solo cuando la salida del navegador cambie el resultado.

Varios requests preservando cookies y estado del visitante
03

Sesión con estado

Usa sesiones cuando las cookies, el consentimiento, la localidad o la paginación cambien la respuesta.

Perfil de estado más pesado; conservalo solo cuando la continuidad sea importante.

Enrutamiento de requests a través de rutas geo y de mayor calidad
04

Enrutamiento y geo premium

Usa enrutamiento premium o geo solo cuando el origen, país, reputación o contenido regional cambien el resultado.

Perfil de enrutamiento más pesado; aplícalo solo a objetivos que demuestren que lo necesitan.

Qué puede hacer que la captura de Markdown sea más pesada

renderizado del navegador

Útil cuando JavaScript crea contenido que el HTML fuente no contiene.

Tiempo de espera

Útil cuando el objetivo carga secciones importantes después de que el navegador se inicia.

Sesión o encabezados

Útil cuando el contenido depende del consentimiento, idioma, continuidad o contexto de la solicitud.

Archivos visuales

Útil para QA o archivo, pero innecesario para pipelines de Markdown solo para máquinas.

Cómo mantener los flujos de trabajo de Markdown predecibles

Comienza desde la captura de origen

Usa el estado de la página en bruto cuando ya produzca Markdown completo.

Compara formatos antes de escalar

Prueba Markdown contra HTML y texto para confirmar que elimina el trabajo real posterior.

Renderiza por patrón de objetivo

No hagas que la ejecución del navegador sea el predeterminado para cada URL cuando solo algunas páginas lo necesiten.

Separa la prueba de la análisis

Usa capturas de pantalla y PDFs como evidencia visual, no como reemplazos para contenido legible por máquina.

Preguntas frecuentes sobre Markdown

Preguntas comunes sobre la conversión de páginas web a Markdown

Respuestas prácticas para equipos que deciden cuándo Markdown es el formato de respuesta correcto, cuándo vale la pena usar renderizado y cómo mantener la captura de contenido lista para IA útil sin sobrecargar el raspado.

FAQ DE MARKDOWN
FORMAT

Elegir Markdown

Utiliza Markdown cuando una estructura legible ayuda al flujo de trabajo posterior.

¿Cuándo es mejor Markdown que texto?

Markdown es mejor cuando los encabezados, listas y enlaces ayudan a la revisión, fragmentación, documentación, búsqueda o contexto de IA.

¿Cuándo sigue siendo mejor HTML?

HTML es mejor cuando los selectores, atributos, relaciones exactas del DOM o la estructura de la tabla son importantes para el parser.

RENDERING

Capturando el estado correcto de la página

Markdown solo puede convertir lo que la solicitud captura.

¿Debería cada solicitud de Markdown usar renderizado?

No. Comienza con la captura de la fuente y habilita el renderizado solo cuando JavaScript crea contenido que Markdown de otro modo no captura.

¿Pueden las esperas mejorar la salida de Markdown?

Sí, cuando las páginas de muestra demuestran que el contenido importante aparece después de un breve retraso en el navegador.

AI

Flujos de trabajo de IA y RAG

Markdown legible puede hacer que el contenido posterior sea más fácil de usar.

¿Es bueno Markdown para RAG?

A menudo sí. Puede preservar el flujo de secciones y enlaces mientras elimina gran parte del ruido HTML crudo que perjudica la ingestión.

¿Qué debo verificar antes de indexar Markdown?

Verifica el contenido principal, encabezados, enlaces, plantilla, URL final, estado, tamaño de respuesta, idioma y configuración de renderizado.

PROOF

Límites y alternativas

Markdown es útil, pero no es la única salida que un flujo de trabajo de producción puede necesitar.

¿Es Markdown lo mismo que la extracción de artículos?

No. Markdown es un formato de respuesta legible, no un extractor garantizado de artículos, autor, fecha, precio o esquema.

¿Puedo seguir solicitando capturas de pantalla o PDFs?

Sí. Usa archivos visuales cuando la apariencia, archivo, revisión o prueba de cumplimiento importen más que el contenido legible por máquina.

