






Fluxo de trabalho de inteligência de notícias
Capture evidências de notícias públicas antes que os alertas se tornem ruído
O monitoramento de notícias é útil apenas quando o registro da fonte é claro. Um título, menção ou alteração de artigo deve vir com evidências suficientes para entender onde apareceu, quando foi capturado, se a página redirecionou e qual formato sua equipe pode revisar ou processar a seguir.
ScraperFly oferece às equipes de monitoramento uma camada de solicitação prática para páginas de notícias públicas, páginas de editores, salas de imprensa, arquivos de artigos, blogs e páginas de resultados em estilo de busca. Comece com a captura mais leve, inspecione a resposta e, em seguida, adicione renderização, sessões, cabeçalhos, segmentação por país ou roteamento mais forte apenas quando a fonte provar que esses controles melhoram o resultado.
O que é uma API de scraping para monitoramento de notícias?
Uma API de scraping para monitoramento de notícias é uma camada de solicitação hospedada que busca páginas públicas de notícias e editores para que seu próprio sistema possa classificar, comparar, resumir, alertar ou arquivar o resultado. Em vez de manter trabalhadores de navegador, roteamento de proxy, tentativas, conversores e lógica de captura em cada projeto de monitoramento, sua aplicação envia uma URL de destino e recebe uma resposta utilizável.
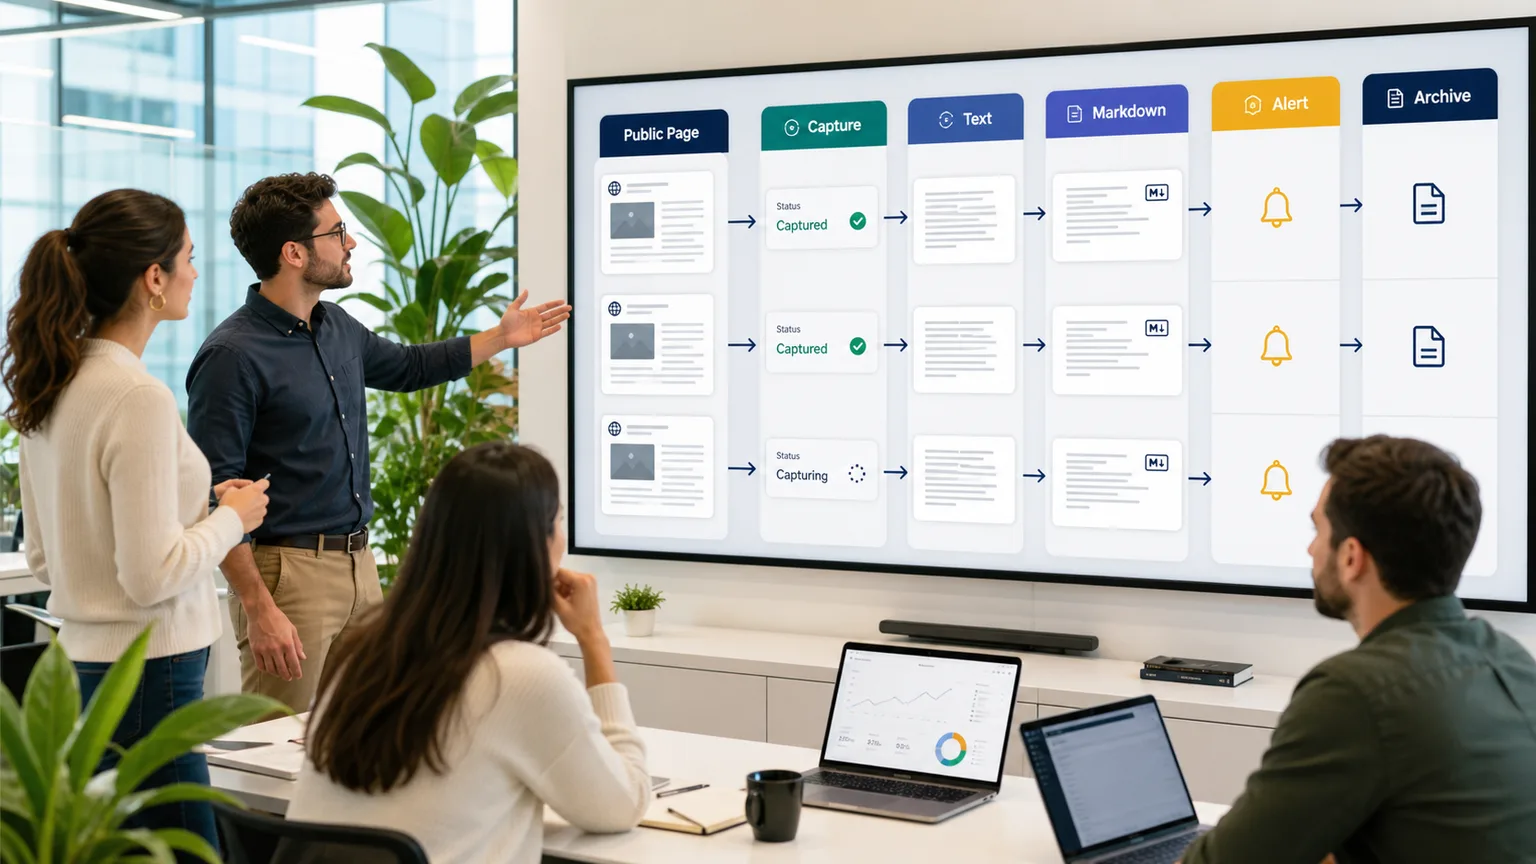
O ponto importante é o controle. Um fluxo de trabalho de monitoramento pode precisar de HTML bruto para descoberta de links, HTML renderizado quando o JavaScript constrói o corpo do artigo, texto limpo para correspondência rápida, Markdown para revisão de analistas ou ingestão de IA, metadados JSON para registro ou capturas de tela e PDFs para evidências visuais. ScraperFly mantém essas escolhas dentro de um único caminho de API para que as equipes possam testar a fonte antes de transformar uma lista de monitoramento em um trabalho de produção recorrente.
Resumo prático: trate o monitoramento de notícias como captura de fonte primeiro, depois deixe seu próprio produto decidir quais menções importam.
Quais fontes de notícias públicas as equipes podem monitorar?
O monitoramento de notícias raramente depende de um tipo de página. Uma equipe de inteligência de mercado pode observar páginas de categoria, comunicados de imprensa, blogs corporativos, páginas de editores locais, páginas de autores, páginas de resultados de busca e URLs de artigos individuais. Cada fonte se comporta de maneira diferente, então o scraping deve provar a forma alvo antes que o trabalho seja executado em volume.
| Tipo de fonte | O que capturar | Decisão a tomar |
|---|---|---|
| Páginas de artigos | Título, texto do corpo, data de publicação, URL canônica, autor, referências de imagem e status final. | Use texto ou Markdown quando o corpo do artigo estiver presente; use HTML renderizado quando o conteúdo útil aparecer após a execução do navegador. |
| Páginas de categoria de editores | Links de artigos novos, timestamps, resumos, paginação e padrões de layout repetidos. | Mantenha a solicitação leve quando a lista de links estiver no HTML da fonte; adicione esperas apenas quando a lista carregar tarde. |
| Salas de imprensa e blogs de empresas | Novos anúncios, páginas de atualização, postagens de mídia e lançamentos arquivados. | Armazene evidências de fonte estáveis antes da classificação a montante ou alertas de partes interessadas. |
| Páginas de busca e menção | Títulos de resultados, trechos, URLs, locais e estado de filtragem visível. | Inspecione redirecionamentos, comportamento regional e tamanho da resposta antes de escalar verificações recorrentes. |
| Páginas de evidências visuais | Estado da página renderizada, capturas de tela, capturas em PDF e registros prontos para revisão. | Gere saída visual apenas quando um revisor humano, processo de conformidade ou arquivo precisar de prova de aparência. |
Como um fluxo de trabalho de monitoramento deve escolher o formato da resposta?
A saída certa depende do consumidor. Um trabalho de deduplicação pode precisar apenas de texto limpo e metadados. Uma fila de revisão de analistas pode preferir Markdown porque cabeçalhos e links permanecem legíveis. Um arquivo legal, de conformidade ou de comunicações pode precisar de uma captura de tela ou PDF junto com conteúdo legível por máquina. Um crawler que descobre novas URLs de artigos pode precisar de HTML porque a estrutura DOM e os links importam.
Escolher um formato para cada fonte cria trabalho desnecessário. HTML em todos os lugares significa que cada sistema a montante precisa de analisadores e limpeza. Capturas de tela em todos os lugares dificultam a comparação e aumentam o peso da solicitação. Texto simples em todos os lugares pode remover a estrutura necessária para explicar por que uma menção foi correspondida. ScraperFly permite que as equipes testem a fonte e escolham a saída que se encaixa na decisão de monitoramento.
| Necessidade de monitoramento | Melhor saída inicial | Por que funciona |
|---|---|---|
| Correspondência rápida de palavras-chave ou entidades | Texto | Conteúdo compacto é fácil de comparar, indexar e roteirizar através de regras simples. |
| Resumos de IA e revisão de analistas | Markdown | Estrutura legível preserva cabeçalhos e links sem forçar revisores a passar por marcação bruta. |
| Descoberta de links e análise de fonte | HTML ou HTML renderizado | A estrutura DOM ajuda os analisadores a encontrar links canônicos, paginação, cartões de artigo e metadados. |
| Depuração operacional | Metadados JSON | Status, URL final, tipo de conteúdo e tamanho da resposta ajudam a explicar mudanças antes que os alertas sejam acionados. |
| Prova visual ou arquivo | Captura de tela ou PDF | Revisores humanos podem ver como a página pública parecia no momento da captura. |
Teste formatos no API Builder antes de se comprometer com um pipeline de monitoramento e compare o conjunto completo de saídas na página formatos de resposta da API de scraping da web.
Quando a renderização de JavaScript é importante para o monitoramento de notícias?
Muitas páginas públicas de notícias e editores ainda retornam HTML de fonte útil. Essas páginas devem permanecer em um caminho de captura simples porque é mais fácil inspecionar, mais rápido comparar e geralmente mais leve. A renderização é valiosa quando a resposta da fonte é uma casca fina, cartões de artigo carregam após a execução do lado do cliente, o estado de consentimento muda a página visível ou a equipe de monitoramento precisa de uma captura de tela da visualização renderizada.
O melhor fluxo de trabalho é baseado em evidências. Busque a página primeiro, compare o HTML da fonte com a saída renderizada, verifique o tamanho da resposta e a URL final e, em seguida, decida se o alvo precisa de execução do navegador. ScraperFly suporta esse caminho de escalonamento sem forçar cada fonte monitorada a entrar no mesmo perfil pesado. Para páginas que realmente precisam de um navegador, revise o fluxo de trabalho da API de renderização JavaScript.
Como as equipes mantêm o monitoramento recorrente confiável?
A captura de notícias recorrente não deve tratar cada artigo ausente como um evento crítico. Páginas mudam, redirecionamentos mudam, editores atualizam layouts, algumas regiões veem conteúdo diferente e respostas a montante podem ser temporárias. Um sistema de monitoramento estável registra evidências de fonte suficientes para separar uma verdadeira mudança de conteúdo de um problema de entrega.
Use status, URL final, tamanho da resposta, tipo de conteúdo e formato de captura como sinais operacionais. Mantenha sessões apenas quando a continuidade mudar o resultado. Use cabeçalhos quando linguagem, negociação de conteúdo ou contexto aceito importarem. Adicione roteamento por país quando o conteúdo público realmente diferir por região. Use backoff para falhas temporárias em vez de aumentar a pressão cegamente.
Resumo prático: um monitor de notícias confiável captura evidências de fonte, evita tentativas barulhentas e escalona controles de solicitação apenas quando a resposta prova que eles ajudam.
Como o ScraperFly ajuda a controlar o custo do monitoramento?
O monitoramento de notícias pode se tornar caro quando cada página monitorada é tratada como um trabalho de navegador com saída visual e roteamento premium. A maioria das fontes não precisa disso por padrão. ScraperFly se encaixa em um padrão mais prático: comece com a captura de fonte, mantenha páginas simples leves e reserve controles mais pesados para alvos que provem que precisam deles.
Isso é importante para equipes que testam novas listas de monitoramento, expandem a cobertura entre editores ou executam projetos desiguais para PR, risco, pesquisa, investimento ou inteligência competitiva. Use créditos gratuitos para validar o comportamento da fonte, pague conforme o uso para monitoramento baseado em projetos e mova trabalhos recorrentes previsíveis para créditos mensais apenas quando o volume estiver claro. A página de preços e o calculador de custo de crédito da API de scraping da web ajudam a mapear o peso da solicitação para o perfil de captura real.







