






Рабочий процесс новостной аналитики
Соберите публичные новостные данные, прежде чем оповещения станут шумом
Мониторинг новостей полезен только тогда, когда источник записи ясен. Заголовок, упоминание или изменение статьи должны сопровождаться достаточными доказательствами, чтобы понять, где оно появилось, когда было зафиксировано, перенаправлялась ли страница и в каком формате ваша команда может просмотреть или обработать данные далее.
ScraperFly предоставляет командам мониторинга практический уровень запросов для публичных новостных страниц, страниц издателей, пресс-центров, архивов статей, блогов и страниц результатов в стиле поиска. Начните с самого легкого захвата, проверьте ответ, затем добавьте рендеринг, сессии, заголовки, таргетинг по странам или более сильную маршрутизацию только тогда, когда источник докажет, что эти элементы улучшают результат.
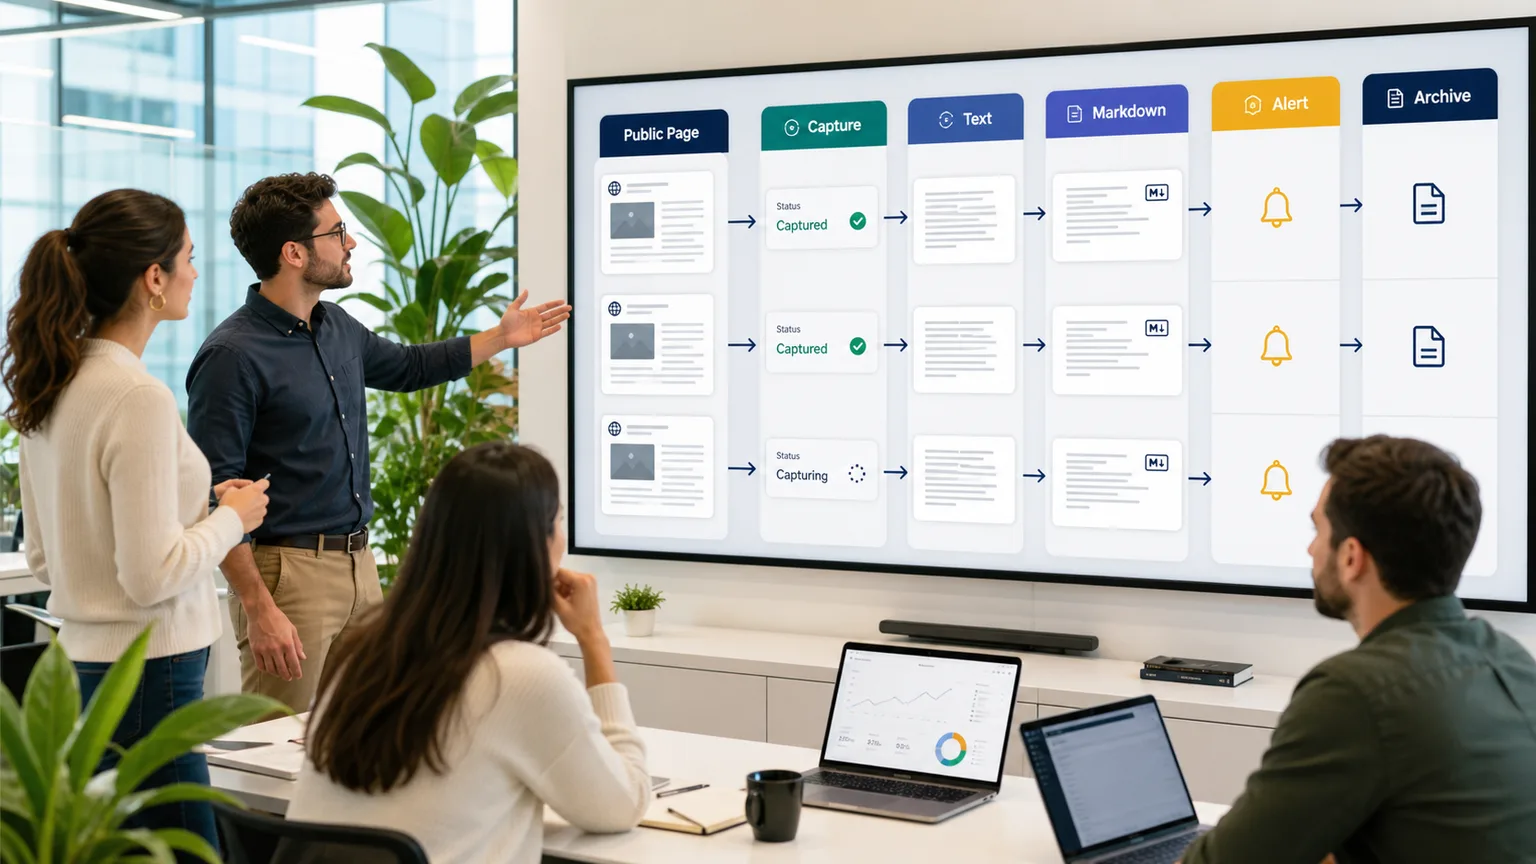
Что такое API для мониторинга новостей?
API для мониторинга новостей — это хостируемый уровень запросов, который извлекает публичные новостные и страницы издателей, чтобы ваша собственная система могла классифицировать, сравнивать, обобщать, оповещать или архивировать результат. Вместо того чтобы поддерживать браузерные рабочие процессы, маршрутизацию прокси, повторные попытки, конвертеры и логику захвата в каждом проекте мониторинга, ваше приложение отправляет целевой URL и получает пригодный для использования ответ.
Важный момент — это контроль. Рабочий процесс мониторинга может потребовать сырой HTML для обнаружения ссылок, рендеренный HTML, когда JavaScript формирует тело статьи, чистый текст для быстрого сопоставления, Markdown для анализа или AI, JSON-метаданные для ведения журнала или скриншоты и PDF для визуальных доказательств. ScraperFly сохраняет эти выборы внутри одного API-пути, чтобы команды могли протестировать источник, прежде чем превратить список наблюдений в повторяющуюся производственную задачу.
Практическое резюме: рассматривайте мониторинг новостей как захват источника в первую очередь, а затем позвольте вашему продукту решить, какие упоминания важны.
Какие публичные новостные источники могут мониторить команды?
Мониторинг новостей редко зависит от одного типа страницы. Команда рыночной аналитики может следить за категориями страниц, пресс-релизами, корпоративными блогами, страницами местных издателей, страницами авторов, страницами результатов поиска и отдельными URL статей. Каждый источник ведет себя по-разному, поэтому захват должен подтвердить целевую форму, прежде чем работа начнется в объеме.
| Тип источника | Что захватывать | Решение, которое нужно принять |
|---|---|---|
| Страницы статей | Заголовок, текст статьи, дата публикации, канонический URL, автор, ссылки на изображения и окончательный статус. | Используйте текст или Markdown, когда тело статьи присутствует; используйте рендеренный HTML, когда полезный контент появляется после выполнения браузера. |
| Страницы категорий издателей | Свежие ссылки на статьи, временные метки, резюме, пагинация и повторяющиеся шаблоны макета. | Сохраняйте запрос легким, когда список ссылок находится в исходном HTML; добавляйте ожидания только тогда, когда список загружается поздно. |
| Пресс-центры и корпоративные блоги | Новые объявления, страницы обновлений, медиа-посты и архивные релизы. | Сохраняйте стабильные доказательства источника перед последующей классификацией или оповещениями заинтересованных сторон. |
| Страницы поиска и упоминаний | Заголовки результатов, фрагменты, URL, местоположения и видимое состояние фильтрации. | Проверьте перенаправления, поведение региона и размер ответа перед масштабированием повторяющихся проверок. |
| Страницы визуальных доказательств | Состояние рендеренной страницы, скриншоты, захваты PDF и записи, готовые к обзору. | Генерируйте визуальный вывод только тогда, когда человеческому рецензенту, процессу соблюдения или архиву нужны доказательства появления. |
Как рабочий процесс мониторинга должен выбирать формат ответа?
Правильный вывод зависит от потребителя. Задача дедупликации может потребовать только чистого текста и метаданных. Очередь рецензирования аналитиков может предпочесть Markdown, потому что заголовки и ссылки остаются читаемыми. Юридический, комплаенс или архив коммуникаций могут потребовать скриншот или PDF наряду с машинно-читаемым контентом. Краулер, который обнаруживает новые URL статей, может потребовать HTML, потому что структура DOM и ссылки имеют значение.
Выбор одного формата для каждого источника создает ненужную работу. HTML повсюду означает, что каждой последующей системе нужны парсеры и очистка. Скриншоты повсюду усложняют сравнение и увеличивают вес запроса. Обычный текст повсюду может удалить структуру, необходимую для объяснения, почему упоминание было сопоставлено. ScraperFly позволяет командам протестировать источник и выбрать вывод, который соответствует решению мониторинга.
| Нужда в мониторинге | Лучший начальный вывод | Почему это работает |
|---|---|---|
| Быстрое сопоставление ключевых слов или сущностей | Текст | Компактный контент легко сравнивать, индексировать и маршрутизировать через простые правила. |
| AI-резюме и рецензирование аналитиков | Markdown | Читаемая структура сохраняет заголовки и ссылки, не заставляя рецензентов проходить через сырой разметку. |
| Обнаружение ссылок и парсинг источника | HTML или рендеренный HTML | Структура DOM помогает парсерам находить канонические ссылки, пагинацию, карточки статей и метаданные. |
| Оперативная отладка | JSON-метаданные | Статус, окончательный URL, тип контента и размер ответа помогают объяснить изменения перед срабатыванием оповещений. |
| Визуальное доказательство или архив | Скриншот или PDF | Человеческие рецензенты могут увидеть, как выглядела публичная страница в момент захвата. |
Тестируйте форматы в API Builder перед тем, как привязываться к мониторинговому конвейеру, и сравните полный набор выходных данных на странице форматов ответов API для веб-скрапинга.
Когда рендеринг JavaScript важен для мониторинга новостей?
Многие публичные новостные и страницы издателей все еще возвращают полезный исходный HTML. Эти страницы должны оставаться на простом пути захвата, потому что их легче проверять, быстрее сравнивать и обычно они легче. Рендеринг ценен, когда ответ источника является тонкой оболочкой, карточки статей загружаются после выполнения на стороне клиента, состояние согласия изменяет видимую страницу, или команде мониторинга нужен скриншот рендеренного вида.
Лучший рабочий процесс основан на доказательствах. Сначала получите страницу, сравните исходный HTML с рендеренным выводом, проверьте размер ответа и окончательный URL, а затем решите, нужно ли целевому объекту выполнение в браузере. ScraperFly поддерживает этот путь эскалации, не заставляя каждый мониторируемый источник следовать одному тяжелому профилю. Для страниц, которым действительно нужен браузер, ознакомьтесь с API рендеринга JavaScript.
Как команды поддерживают надежность повторяющегося мониторинга?
Повторяющийся захват новостей не должен рассматривать каждую отсутствующую статью как критическое событие. Страницы перемещаются, перенаправления меняются, издатели обновляют макеты, в некоторых регионах контент может отличаться, а ответы на верхнем уровне могут быть временными. Стабильная система мониторинга записывает достаточно доказательств источника, чтобы отделить реальное изменение контента от проблемы доставки.
Используйте статус, окончательный URL, размер ответа, тип контента и формат захвата в качестве операционных сигналов. Сохраняйте сессии только тогда, когда непрерывность изменяет результат. Используйте заголовки, когда язык, согласование контента или принятый контекст имеют значение. Добавляйте маршрутизацию по странам, когда публичный контент действительно отличается по регионам. Используйте откат для временных сбоев, вместо того чтобы слепо увеличивать давление.
Практическое резюме: надежный монитор новостей захватывает доказательства источника, избегает шумных повторных попыток и эскалирует управление запросами только тогда, когда ответ доказывает, что они помогают.
Как ScraperFly помогает контролировать стоимость мониторинга?
Мониторинг новостей может стать дорогим, когда каждая наблюдаемая страница рассматривается как работа браузера с визуальным выводом и премиум маршрутизацией. Большинство источников по умолчанию этого не требует. ScraperFly подходит для более практичного подхода: начните с захвата источника, сохраняйте простые страницы легкими и оставляйте более тяжелые элементы для целей, которые докажут, что они нужны.
Это важно для команд, которые тестируют новые списки наблюдений, расширяют охват среди издателей или ведут неравномерные проекты для PR, рисков, исследований, инвестиций или конкурентной аналитики. Используйте бесплатные кредиты для проверки поведения источника, платите по мере использования для мониторинга на основе проектов и переводите предсказуемую повторяющуюся работу на месячные кредиты только тогда, когда объем станет ясным. Страница цен и калькулятор стоимости кредитов API для веб-скрапинга помогут сопоставить вес запроса с фактическим профилем захвата.







