






Workflow für Nachrichtenintelligenz
Öffentliche Nachrichtenbeweise erfassen, bevor Warnungen zu Lärm werden
Die Überwachung von Nachrichten ist nur dann nützlich, wenn der Quellennachweis klar ist. Eine Überschrift, Erwähnung oder Artikeländerung sollte mit genügend Beweisen einhergehen, um zu verstehen, wo sie erschienen ist, wann sie erfasst wurde, ob die Seite umgeleitet wurde und in welchem Format Ihr Team die Informationen überprüfen oder verarbeiten kann.
ScraperFly bietet Überwachungsteams eine praktische Anforderungsschicht für öffentliche Nachrichten-Seiten, Verlagsseiten, Pressezimmer, Artikelarchive, Blogs und suchstilähnliche Ergebnisseiten. Beginnen Sie mit der leichtesten Erfassung, überprüfen Sie die Antwort und fügen Sie dann Rendering, Sitzungen, Header, Länderauswahl oder stärkere Routen nur hinzu, wenn die Quelle beweist, dass diese Kontrollen das Ergebnis verbessern.
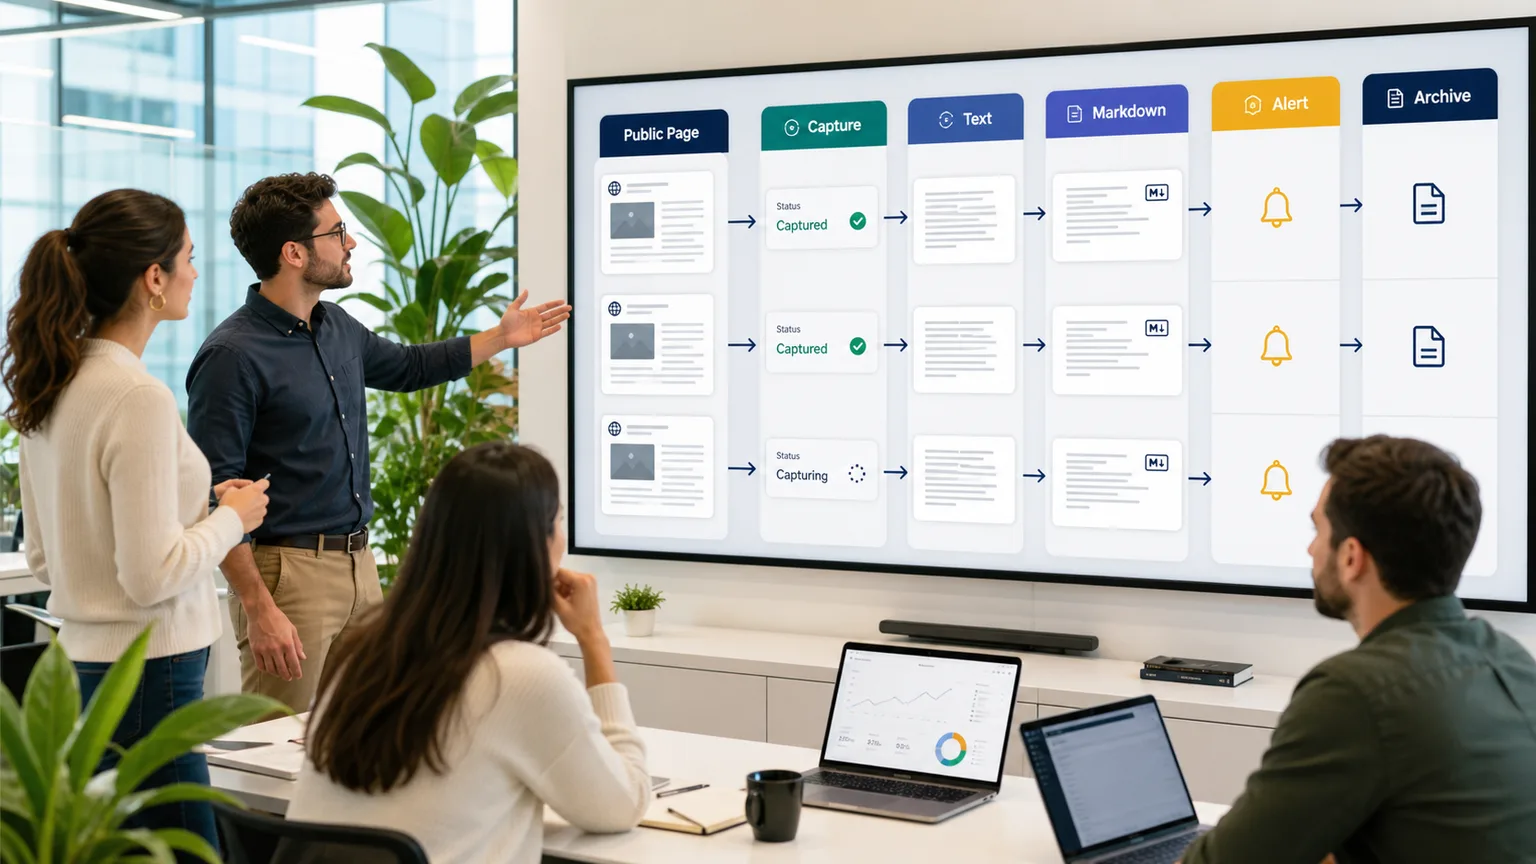
Was ist eine Nachrichtenüberwachungs-Scraping-API?
Eine Nachrichtenüberwachungs-Scraping-API ist eine gehostete Anforderungsschicht, die öffentliche Nachrichten- und Verlagsseiten abruft, damit Ihr eigenes System das Ergebnis klassifizieren, vergleichen, zusammenfassen, warnen oder archivieren kann. Anstatt Browser-Worker, Proxy-Routing, Wiederholungen, Konverter und Erfassungslogik in jedem Überwachungsprojekt zu pflegen, sendet Ihre Anwendung eine Ziel-URL und erhält eine verwendbare Antwort.
Der wichtige Punkt ist Kontrolle. Ein Überwachungsworkflow benötigt möglicherweise rohes HTML zur Linkentdeckung, gerendertes HTML, wenn JavaScript den Artikeltext aufbaut, sauberen Text für schnelles Matching, Markdown für die Überprüfung durch Analysten oder KI, JSON-Metadaten für das Logging oder Screenshots und PDFs als visuelle Beweise. ScraperFly hält diese Optionen innerhalb eines API-Pfades, sodass Teams die Quelle testen können, bevor sie eine Beobachtungsliste in einen wiederkehrenden Produktionsauftrag umwandeln.
Praktische Erkenntnis: Behandeln Sie die Nachrichtenüberwachung zuerst als Quellenerfassung und lassen Sie dann Ihr eigenes Produkt entscheiden, welche Erwähnungen wichtig sind.
Welche öffentlichen Nachrichtenquellen können Teams überwachen?
Die Nachrichtenüberwachung hängt selten von einem Seitentyp ab. Ein Marktintelligenzteam kann Kategorieseiten, Pressemitteilungen, Unternehmensblogs, lokale Verlagsseiten, Autoren-Seiten, Suchergebnisseiten und individuelle Artikel-URLs beobachten. Jede Quelle verhält sich unterschiedlich, daher sollte das Scraping die Zielstruktur beweisen, bevor der Job in großem Umfang ausgeführt wird.
| Quelltyp | Was zu erfassen ist | Zu treffende Entscheidung |
|---|---|---|
| Artikel-Seiten | Überschrift, Fließtext, Veröffentlichungsdatum, kanonische URL, Autor, Bildreferenzen und finaler Status. | Verwenden Sie Text oder Markdown, wenn der Artikeltext vorhanden ist; verwenden Sie gerendertes HTML, wenn der nützliche Inhalt nach der Ausführung im Browser erscheint. |
| Verlagskategorieseiten | Frische Artikel-Links, Zeitstempel, Zusammenfassungen, Paginierung und wiederholte Layoutmuster. | Halten Sie die Anfrage leicht, wenn die Linkliste im Quell-HTML enthalten ist; fügen Sie Wartezeiten nur hinzu, wenn die Liste spät geladen wird. |
| Pressezimmer und Unternehmensblogs | Neue Ankündigungen, Aktualisierungsseiten, Medienbeiträge und archivierte Veröffentlichungen. | Speichern Sie stabile Quellbeweise, bevor Sie eine nachgelagerte Klassifizierung oder Warnungen an Stakeholder durchführen. |
| Such- und Erwähnungsseiten | Ergebnisüberschriften, Snippets, URLs, Standorte und sichtbarer Filterstatus. | Überprüfen Sie Weiterleitungen, regionales Verhalten und Antwortgröße, bevor Sie wiederkehrende Prüfungen skalieren. |
| Visuelle Beweis-Seiten | Gerenderter Seitenstatus, Screenshots, PDF-Erfassungen und überprüfungsbereite Aufzeichnungen. | Generieren Sie visuelle Ausgaben nur, wenn ein menschlicher Prüfer, ein Compliance-Prozess oder ein Archiv einen Nachweis über das Erscheinungsbild benötigt. |
Wie sollte ein Überwachungsworkflow das Antwortformat wählen?
Die richtige Ausgabe hängt vom Verbraucher ab. Ein Duplikationsjob benötigt möglicherweise nur sauberen Text und Metadaten. Eine Analystenüberprüfung könnte Markdown bevorzugen, da Überschriften und Links lesbar bleiben. Ein rechtliches, Compliance- oder Kommunikationsarchiv benötigt möglicherweise einen Screenshot oder PDF zusammen mit maschinenlesbarem Inhalt. Ein Crawler, der neue Artikel-URLs entdeckt, benötigt möglicherweise HTML, da die DOM-Struktur und Links wichtig sind.
Die Wahl eines Formats für jede Quelle schafft unnötige Arbeit. HTML überall bedeutet, dass jedes nachgelagerte System Parser und Bereinigungen benötigt. Screenshots überall erschweren den Vergleich und erhöhen das Anfragegewicht. Reiner Text überall kann die Struktur entfernen, die benötigt wird, um zu erklären, warum eine Erwähnung übereinstimmte. ScraperFly ermöglicht es Teams, die Quelle zu testen und die Ausgabe zu wählen, die zur Überwachungsentscheidung passt.
| Überwachungsbedarf | Beste Ausgangsausgabe | Warum es funktioniert |
|---|---|---|
| Schnelles Keyword- oder Entitäts-Matching | Text | Kompakte Inhalte sind einfach zu vergleichen, zu indizieren und durch einfache Regeln zu routen. |
| KI-Zusammenfassungen und Analystenüberprüfung | Markdown | Lesbare Struktur bewahrt Überschriften und Links, ohne die Prüfer durch rohen Markup zu zwingen. |
| Linkentdeckung und Quellanalyse | HTML oder gerendertes HTML | Die DOM-Struktur hilft Parsern, kanonische Links, Paginierung, Artikelkarten und Metadaten zu finden. |
| Betriebsdebugging | JSON-Metadaten | Status, finale URL, Inhaltstyp und Antwortgröße helfen, Änderungen zu erklären, bevor Warnungen ausgelöst werden. |
| Visueller Nachweis oder Archiv | Screenshot oder PDF | Menschliche Prüfer können sehen, wie die öffentliche Seite zum Zeitpunkt der Erfassung aussah. |
Testen Sie Formate im API Builder, bevor Sie sich auf eine Überwachungs-Pipeline festlegen, und vergleichen Sie das gesamte Ausgabeset auf der Web Scraping API-Antwortformat-Seite.
Wann ist JavaScript-Rendering für die Nachrichtenüberwachung wichtig?
Viele öffentliche Nachrichten- und Verlagsseiten geben immer noch nützliches Quell-HTML zurück. Diese Seiten sollten auf einem einfachen Erfassungsweg bleiben, da es einfacher ist, sie zu inspizieren, schneller zu vergleichen und normalerweise leichter ist. Rendering ist wertvoll, wenn die Quellantwort eine dünne Hülle ist, Artikelkarten nach der clientseitigen Ausführung geladen werden, der Zustimmungsstatus die sichtbare Seite ändert oder das Überwachungsteam einen Screenshot der gerenderten Ansicht benötigt.
Der beste Workflow ist evidenzbasiert. Rufen Sie zuerst die Seite ab, vergleichen Sie das Quell-HTML mit der gerenderten Ausgabe, überprüfen Sie die Antwortgröße und die finale URL und entscheiden Sie dann, ob das Ziel eine Browserausführung benötigt. ScraperFly unterstützt diesen Eskalationspfad, ohne jede überwachte Quelle in dasselbe schwere Profil zu zwingen. Für Seiten, die wirklich einen Browser benötigen, überprüfen Sie den JavaScript Rendering API-Workflow.
Wie halten Teams die wiederkehrende Überwachung zuverlässig?
Wiederkehrende Nachrichtenaufnahmen sollten nicht jede fehlende Artikel als ein brechendes Ereignis behandeln. Seiten bewegen sich, Weiterleitungen ändern sich, Verlage aktualisieren Layouts, einige Regionen sehen unterschiedliche Inhalte und upstream-Antworten können vorübergehend sein. Ein stabiles Überwachungssystem zeichnet genügend Quellbeweise auf, um eine echte Inhaltsänderung von einem Lieferproblem zu trennen.
Verwenden Sie Status, finale URL, Antwortgröße, Inhaltstyp und Erfassungsformat als Betriebssignale. Halten Sie Sitzungen nur dann, wenn die Kontinuität das Ergebnis ändert. Verwenden Sie Header, wenn Sprache, Inhaltsverhandlung oder akzeptierter Kontext wichtig sind. Fügen Sie Länderrouting hinzu, wenn öffentliche Inhalte sich tatsächlich nach Region unterscheiden. Verwenden Sie Backoff für vorübergehende Fehler, anstatt den Druck blind zu erhöhen.
Praktische Erkenntnis: Ein zuverlässiger Nachrichtenmonitor erfasst Quellbeweise, vermeidet laute Wiederholungen und eskaliert Anfragekontrollen nur, wenn die Antwort beweist, dass sie helfen.
Wie hilft ScraperFly, die Überwachungskosten zu kontrollieren?
Die Nachrichtenüberwachung kann teuer werden, wenn jede überwachte Seite als Browser-Job mit visueller Ausgabe und Premium-Routing behandelt wird. Die meisten Quellen benötigen das standardmäßig nicht. ScraperFly passt in ein praktisches Muster: Beginnen Sie mit der Quellenerfassung, halten Sie einfache Seiten leicht und reservieren Sie schwerere Kontrollen für Ziele, die beweisen, dass sie benötigt werden.
Dies ist wichtig für Teams, die neue Beobachtungslisten testen, die Abdeckung über Verlage hinweg erweitern oder unregelmäßige Projekte für PR, Risiko, Forschung, Investitionen oder Wettbewerbsintelligenz durchführen. Verwenden Sie kostenlose Credits, um das Verhalten der Quelle zu validieren, zahlen Sie nach Bedarf für projektbasierte Überwachung und verschieben Sie vorhersehbare wiederkehrende Arbeiten nur dann auf monatliche Credits, wenn das Volumen klar ist. Die Preisseite und der Web Scraping API-Creditkostenrechner helfen, das Anfragegewicht auf das tatsächliche Erfassungsprofil abzubilden.







