






Flujo de trabajo de inteligencia de noticias
Captura evidencia de noticias públicas antes de que las alertas se conviertan en ruido
El monitoreo de noticias solo es útil cuando el registro de la fuente es claro. Un titular, mención o cambio de artículo debe venir con suficiente evidencia para entender dónde apareció, cuándo fue capturado, si la página redirigió y qué formato puede revisar o procesar su equipo a continuación.
ScraperFly proporciona a los equipos de monitoreo una capa de solicitud práctica para páginas de noticias públicas, páginas de editores, salas de prensa, archivos de artículos, blogs y páginas de resultados estilo búsqueda. Comience con la captura más ligera, inspeccione la respuesta y luego agregue renderizado, sesiones, encabezados, segmentación por país o enrutamiento más fuerte solo cuando la fuente demuestre que esos controles mejoran el resultado.
¿Qué es una API de scraping para monitoreo de noticias?
Una API de scraping para monitoreo de noticias es una capa de solicitud alojada que obtiene páginas de noticias públicas y de editores para que su propio sistema pueda clasificar, comparar, resumir, alertar o archivar el resultado. En lugar de mantener trabajadores de navegador, enrutamiento de proxy, reintentos, convertidores y lógica de captura en cada proyecto de monitoreo, su aplicación envía una URL objetivo y recibe una respuesta utilizable.
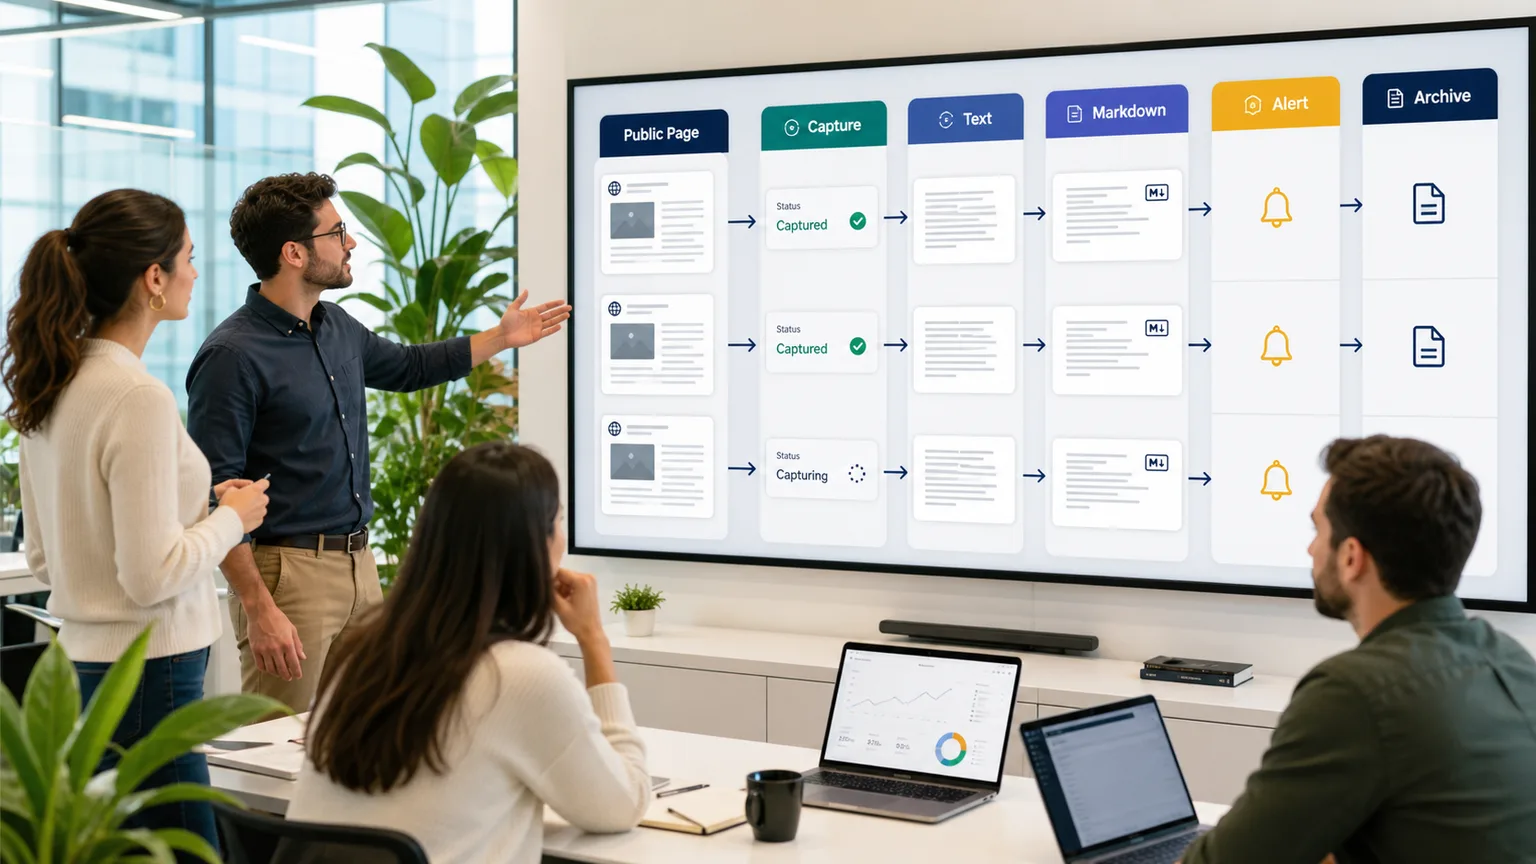
El punto importante es el control. Un flujo de trabajo de monitoreo puede necesitar HTML en bruto para el descubrimiento de enlaces, HTML renderizado cuando JavaScript construye el cuerpo del artículo, texto limpio para una coincidencia rápida, Markdown para revisión de analistas o ingestión de IA, metadatos JSON para registro, o capturas de pantalla y PDFs para evidencia visual. ScraperFly mantiene esas opciones dentro de una ruta de API para que los equipos puedan probar la fuente antes de convertir una lista de seguimiento en un trabajo de producción recurrente.
Conclusión práctica: trate el monitoreo de noticias como captura de fuente primero, luego deje que su propio producto decida qué menciones importan.
¿Qué fuentes de noticias públicas pueden monitorear los equipos?
El monitoreo de noticias rara vez depende de un solo tipo de página. Un equipo de inteligencia de mercado puede observar páginas de categoría, comunicados de prensa, blogs corporativos, páginas de editores locales, páginas de autores, páginas de resultados de búsqueda y URLs de artículos individuales. Cada fuente se comporta de manera diferente, por lo que el scraping debe demostrar la forma objetivo antes de que el trabajo se ejecute a gran escala.
| Tipo de fuente | Qué capturar | Decisión a tomar |
|---|---|---|
| Páginas de artículos | Titular, texto del cuerpo, fecha de publicación, URL canónica, autor, referencias de imagen y estado final. | Use texto o Markdown cuando el cuerpo del artículo esté presente; use HTML renderizado cuando el contenido útil aparezca después de la ejecución del navegador. |
| Páginas de categoría de editores | Enlaces a artículos frescos, marcas de tiempo, resúmenes, paginación y patrones de diseño repetidos. | Mantenga la solicitud ligera cuando la lista de enlaces esté en HTML de origen; agregue esperas solo cuando la lista se cargue tarde. |
| Salas de prensa y blogs de empresas | Nuevos anuncios, páginas de actualización, publicaciones de medios y comunicados archivados. | Almacene evidencia de fuente estable antes de la clasificación posterior o alertas de partes interesadas. |
| Páginas de búsqueda y mención | Títulos de resultados, fragmentos, URLs, ubicaciones y estado de filtrado visible. | Inspeccione redirecciones, comportamiento regional y tamaño de respuesta antes de escalar verificaciones recurrentes. |
| Páginas de evidencia visual | Estado de página renderizada, capturas de pantalla, capturas de PDF y registros listos para revisión. | Genere salida visual solo cuando un revisor humano, proceso de cumplimiento o archivo necesite prueba de aparición. |
¿Cómo debería un flujo de trabajo de monitoreo elegir el formato de respuesta?
La salida correcta depende del consumidor. Un trabajo de deduplicación puede necesitar solo texto limpio y metadatos. Una cola de revisión de analistas puede preferir Markdown porque los encabezados y enlaces se mantienen legibles. Un archivo legal, de cumplimiento o de comunicaciones puede necesitar una captura de pantalla o PDF junto con contenido legible por máquina. Un rastreador que descubre nuevas URLs de artículos puede necesitar HTML porque la estructura del DOM y los enlaces son importantes.
Elegir un formato para cada fuente crea trabajo innecesario. HTML en todas partes significa que cada sistema posterior necesita analizadores y limpieza. Capturas de pantalla en todas partes dificultan la comparación y aumentan el peso de la solicitud. Texto plano en todas partes puede eliminar la estructura necesaria para explicar por qué se coincidió una mención. ScraperFly permite a los equipos probar la fuente y elegir la salida que se ajuste a la decisión de monitoreo.
| Necesidad de monitoreo | Mejor salida inicial | Por qué funciona |
|---|---|---|
| Coincidencia rápida de palabras clave o entidades | Texto | El contenido compacto es fácil de comparar, indexar y enrutar a través de reglas simples. |
| Resúmenes de IA y revisión de analistas | Markdown | La estructura legible preserva encabezados y enlaces sin forzar a los revisores a través de marcado en bruto. |
| Descubrimiento de enlaces y análisis de fuente | HTML o HTML renderizado | La estructura del DOM ayuda a los analizadores a encontrar enlaces canónicos, paginación, tarjetas de artículos y metadatos. |
| Depuración operativa | Metadatos JSON | Estado, URL final, tipo de contenido y tamaño de respuesta ayudan a explicar cambios antes de que se envíen alertas. |
| Prueba visual o archivo | Captura de pantalla o PDF | Los revisores humanos pueden ver cómo se veía la página pública en el momento de la captura. |
Pruebe formatos en el API Builder antes de comprometerse a un pipeline de monitoreo, y compare el conjunto completo de salida en la página de formatos de respuesta de la API de scraping web.
¿Cuándo importa el renderizado de JavaScript para el monitoreo de noticias?
Muchas páginas de noticias públicas y de editores aún devuelven HTML de fuente útil. Esas páginas deben permanecer en un camino de captura simple porque es más fácil de inspeccionar, más rápido de comparar y generalmente más ligero. El renderizado es valioso cuando la respuesta de la fuente es una delgada capa, las tarjetas de artículos se cargan después de la ejecución del lado del cliente, el estado de consentimiento cambia la página visible, o el equipo de monitoreo necesita una captura de pantalla de la vista renderizada.
El mejor flujo de trabajo se basa en evidencia. Obtenga la página primero, compare el HTML de origen con la salida renderizada, verifique el tamaño de la respuesta y la URL final, y luego decida si el objetivo necesita ejecución del navegador. ScraperFly admite ese camino de escalación sin forzar cada fuente monitoreada en el mismo perfil pesado. Para páginas que realmente necesitan un navegador, revise el flujo de trabajo de API de renderizado de JavaScript.
¿Cómo mantienen los equipos el monitoreo recurrente confiable?
La captura recurrente de noticias no debe tratar cada artículo faltante como un evento crítico. Las páginas se mueven, las redirecciones cambian, los editores actualizan diseños, algunas regiones ven contenido diferente y las respuestas ascendentes pueden ser temporales. Un sistema de monitoreo estable registra suficiente evidencia de fuente para separar un cambio real de contenido de un problema de entrega.
Utilice estado, URL final, tamaño de respuesta, tipo de contenido y formato de captura como señales operativas. Mantenga sesiones solo cuando la continuidad cambie el resultado. Use encabezados cuando el idioma, la negociación de contenido o el contexto aceptado sean importantes. Agregue enrutamiento por país cuando el contenido público realmente difiera por región. Use retroceso para fallos temporales en lugar de aumentar la presión ciegamente.
Conclusión práctica: un monitor de noticias confiable captura evidencia de fuente, evita reintentos ruidosos y escala los controles de solicitud solo cuando la respuesta demuestra que ayudan.
¿Cómo ayuda ScraperFly a controlar el costo del monitoreo?
El monitoreo de noticias puede volverse costoso cuando cada página vigilada se trata como un trabajo de navegador con salida visual y enrutamiento premium. La mayoría de las fuentes no necesitan eso por defecto. ScraperFly se ajusta a un patrón más práctico: comience con la captura de fuente, mantenga las páginas sencillas ligeras y reserve controles más pesados para objetivos que demuestren que los necesitan.
Esto es importante para equipos que prueban nuevas listas de seguimiento, amplían la cobertura entre editores o ejecutan proyectos desiguales para relaciones públicas, riesgo, investigación, inversión o inteligencia competitiva. Use créditos gratuitos para validar el comportamiento de la fuente, pague a medida que avanza para el monitoreo basado en proyectos y mueva el trabajo recurrente predecible a créditos mensuales solo cuando el volumen esté claro. La página de precios y el calculador de costos de créditos de la API de scraping web ayudan a mapear el peso de la solicitud al perfil de captura real.







